Phần trước đo được cache nhanh hơn query database 30 đến 300 lần khi tính toán gốc đắt. Nhưng "thêm cache" không phải một nút bấm — nó là một mẫu code mà ứng dụng phải tự viết, và viết sai thì cache hoặc vô dụng, hoặc trả dữ liệu sai. Mẫu được dùng nhiều nhất, tới mức gần như mặc định, tên là cache-aside (còn gọi lazy loading). Bài này dựng nó bằng Go nối Redis và PostgreSQL, rồi đo xem nó thực sự tiết kiệm được bao nhiêu.
Cache-aside: ứng dụng tự lo cache, cache không biết gì về database
Điểm mấu chốt của cache-aside nằm ở chữ aside — cache nằm bên cạnh đường đi, không nằm trên đường đi. Redis không biết PostgreSQL tồn tại; PostgreSQL không biết Redis tồn tại. Chính ứng dụng là nơi nối hai thứ lại, theo đúng ba bước:
- Đọc cache. Có thì trả luôn (hit), không chạm database.
- Miss thì đọc nguồn sự thật — database.
- Điền kết quả vào cache kèm TTL, rồi trả về.
Hệ quả của thiết kế này là cache lười: một key chỉ vào cache khi có người hỏi tới nó lần đầu. Cache khởi động lạnh và nóng dần theo lưu lượng thật — đó chính là thứ sẽ đo ở phần sau.
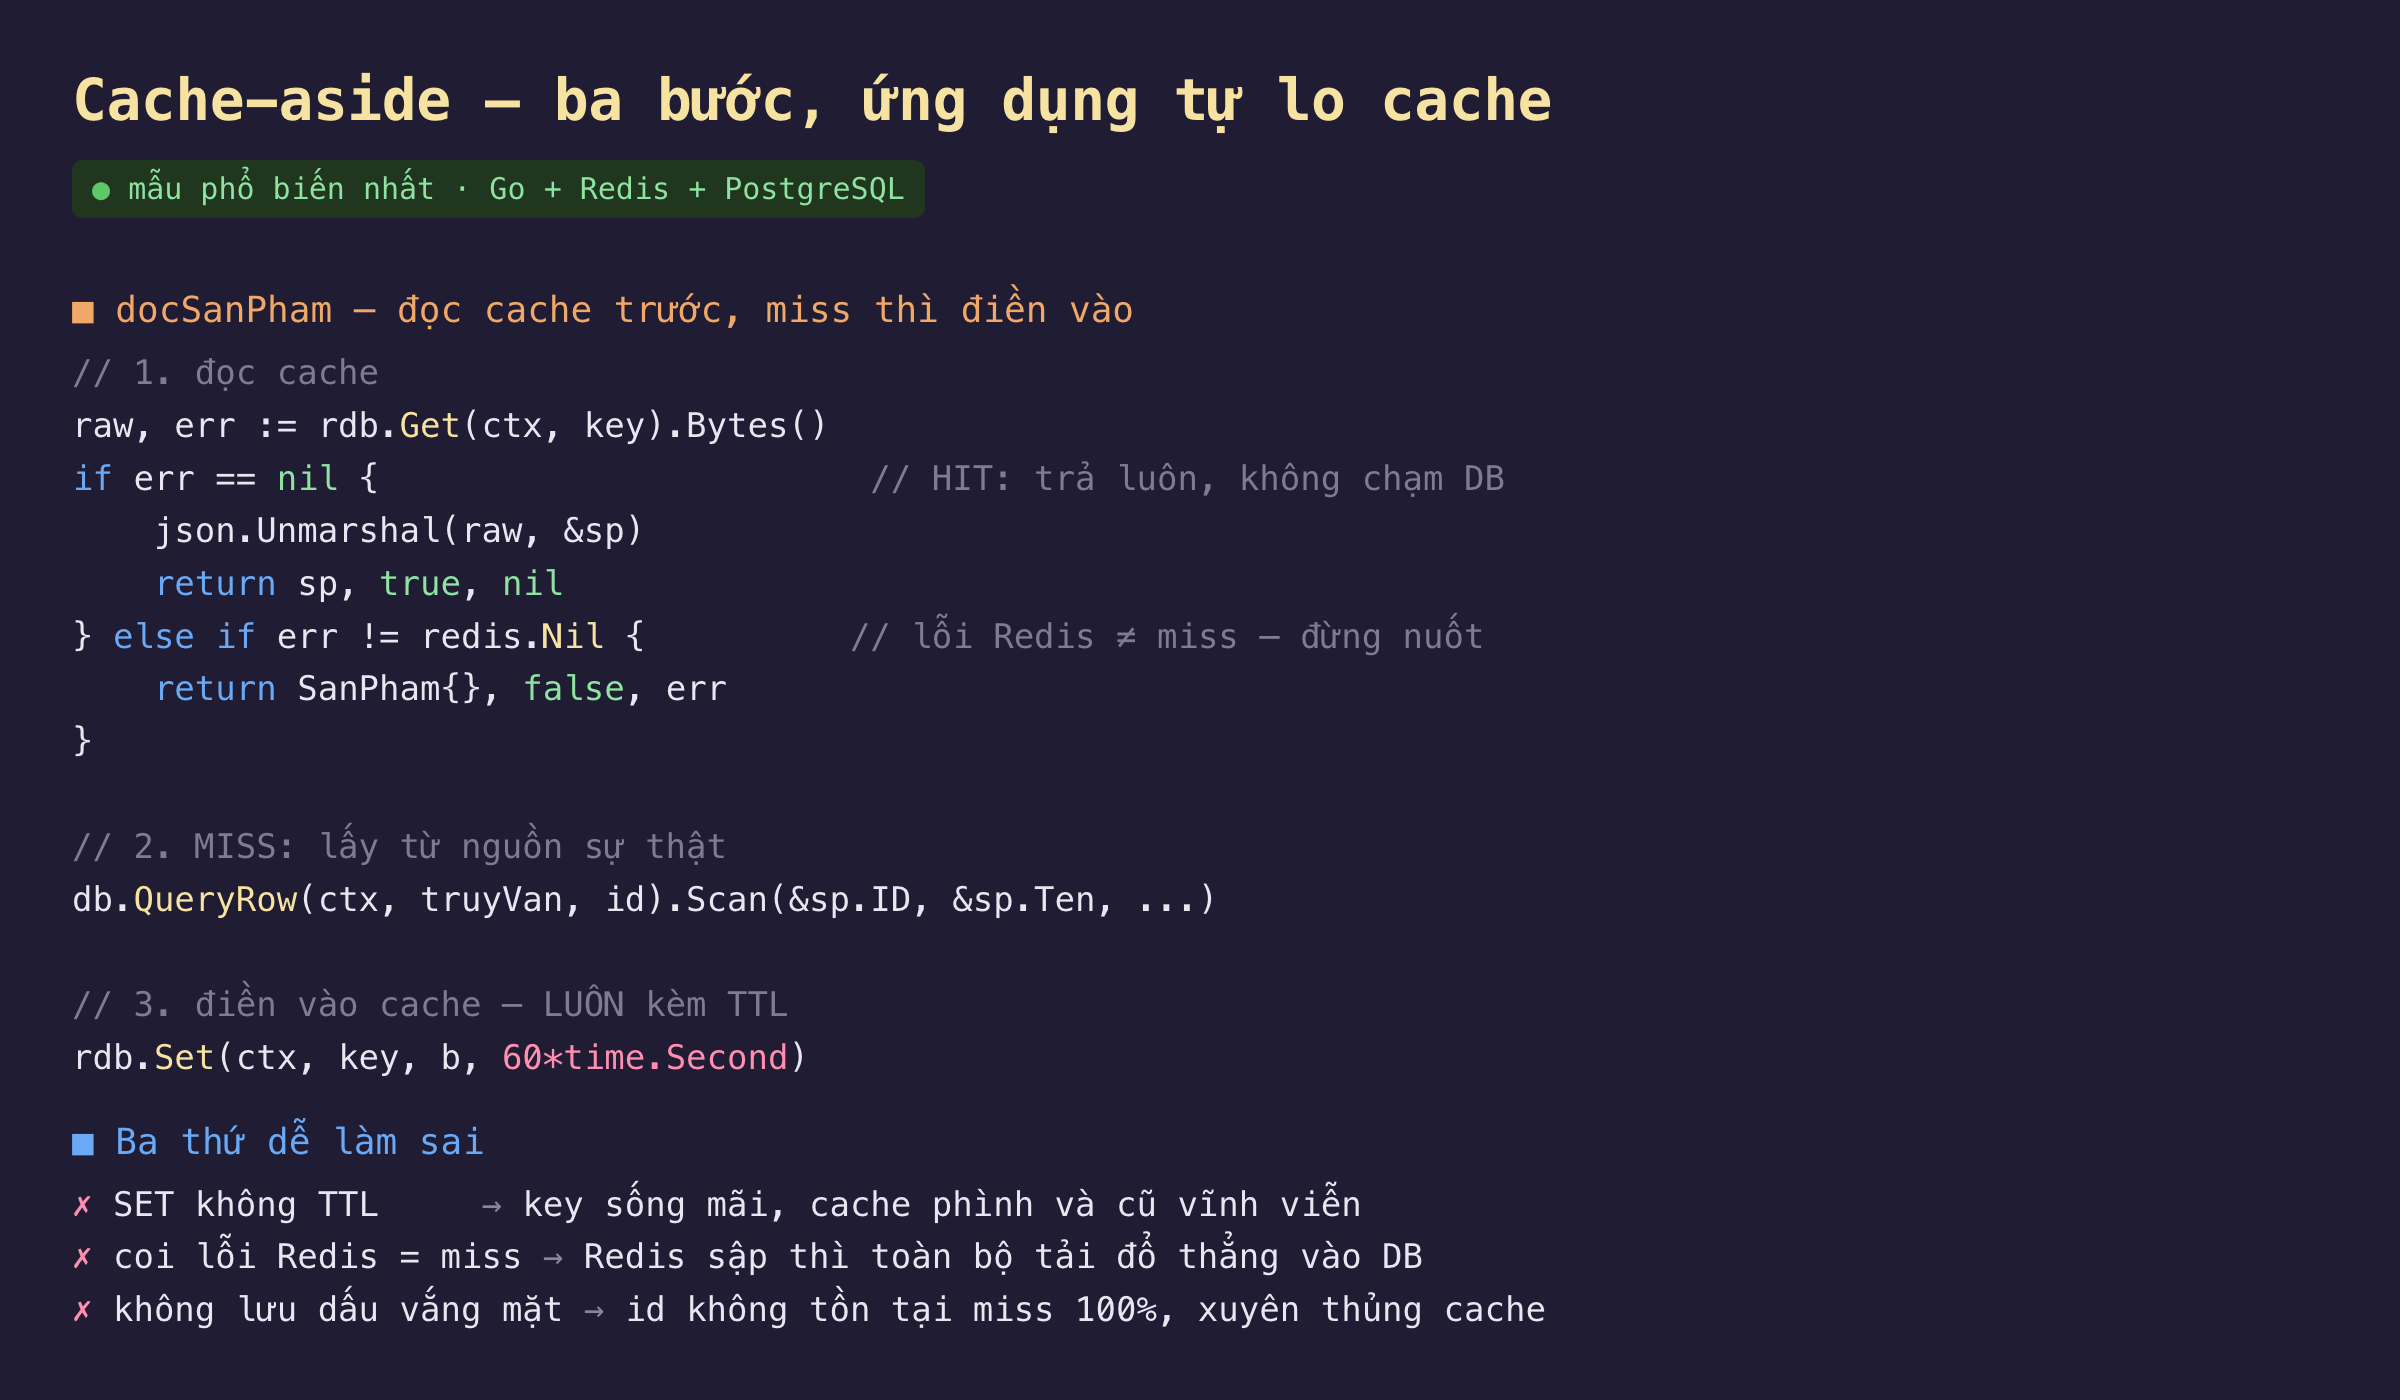
Hình 1: Ba bước của cache-aside trong Go. Chú ý hai chi tiết dễ bỏ qua: Set luôn kèm TTL, và lỗi Redis (err != redis.Nil) được phân biệt rõ với cache miss.
Hai chi tiết trong đoạn mã trên đáng dừng lại:
err != redis.Nil không phải miss. redis.Nil nghĩa là "key không có" — đó là miss thật, đi tiếp xuống database là đúng. Nhưng mọi lỗi khác (mất kết nối, timeout, Redis quá tải) lại là chuyện khác hẳn. Nếu code gộp chung hai thứ và coi mọi lỗi là miss, thì lúc Redis sập, 100% lưu lượng đổ thẳng vào database cùng một lúc — đúng khoảnh khắc bạn cần cache nhất. Gộp chung cho code ngắn hơn ba dòng, đổi lại một chế độ hỏng dây chuyền.
Set luôn kèm TTL. Quên TTL thì key sống mãi trong Redis: cache phình tới khi chạm maxmemory (chủ đề phần 4), và tệ hơn, dữ liệu cũ nằm lại vĩnh viễn nếu nhánh invalidation có bug. TTL là lưới an toàn cuối cùng cho tính đúng đắn — nó đặt trần cho mức độ cũ của dữ liệu kể cả khi mọi thứ khác hỏng.
Đo thật: hit ratio leo từ 37,6% lên 95%
Mình dựng bảng products 50.000 dòng và reviews 400.000 dòng trên pg-lab, một hàm đọc sản phẩm theo đúng ba bước trên, rồi bắn 20.000 request vào một tập làm việc 1.000 sản phẩm (chọn ngẫu nhiên, hạt giống cố định để chạy lại ra cùng số), TTL 60 giây:
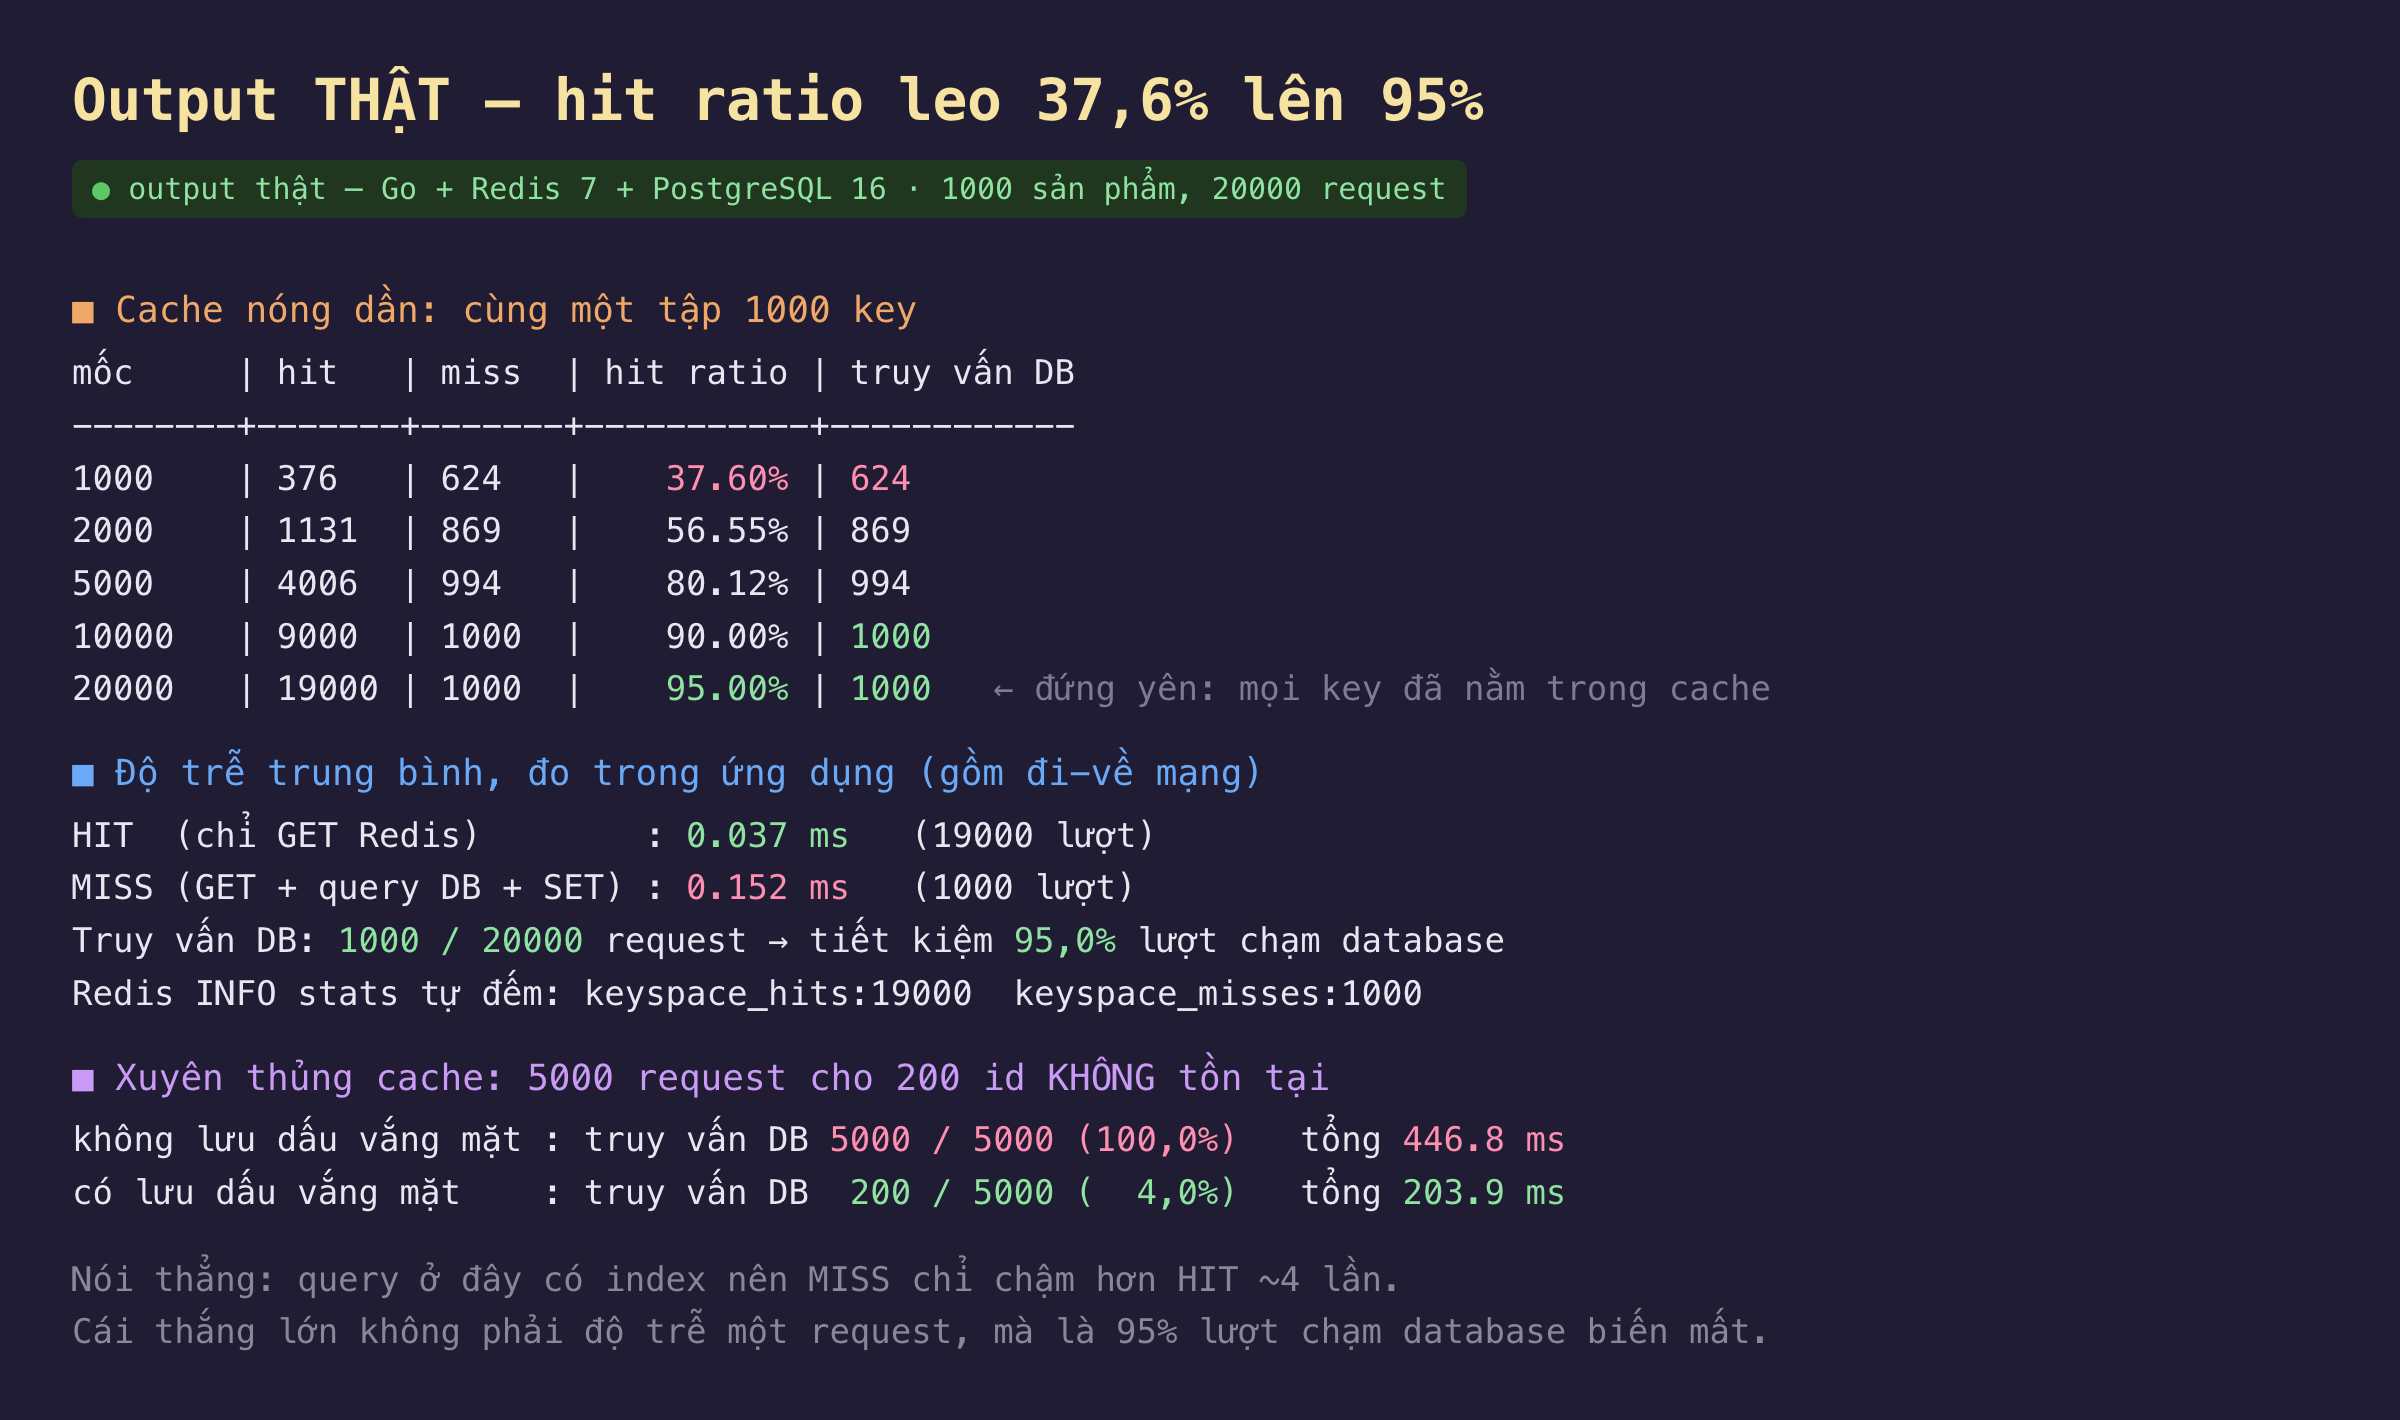
Hình 2: Kết quả thật. Hit ratio leo 37,60% → 56,55% → 80,12% → 90,00% → 95,00%, trong khi số truy vấn database dừng hẳn ở 1.000 từ mốc 10.000 request. Redis tự đếm khớp: keyspace_hits:19000, keyspace_misses:1000.
Đọc từng con số:
- Cột "truy vấn DB" là thứ đáng nhìn nhất. Nó leo 624 → 869 → 994 → 1.000 rồi đứng yên. Trần 1.000 không ngẫu nhiên: tập làm việc có đúng 1.000 sản phẩm, nên sau khi mỗi key bị hỏi lần đầu, database không còn việc gì. 19.000 request sau đó được Redis trả hoàn toàn.
- Hit ratio là tích luỹ, nên nó leo chậm. Ở mốc 1.000 request mới 37,60% — thấp, vì cache đang lạnh. Nhưng tới mốc 20.000 đã 95,00%, và nếu chạy tiếp nó sẽ tiệm cận 100% (chỉ bị TTL 60 giây kéo xuống). Con số 95% này không nói cache đang hoạt động ở mức 95%; nó nói trung bình cả quãng đã chạy là 95%. Phân biệt hit ratio tích luỹ với hit ratio hiện tại quan trọng khi giám sát — chủ đề phần 9.
- Redis tự đếm khớp với bộ đếm trong ứng dụng:
keyspace_hits:19000/keyspace_misses:1000. Hai nguồn độc lập cho cùng một con số, nên không phải lỗi đếm trong code. - HIT 0,037ms vs MISS 0,152ms — khoảng 4 lần. Đây là độ trễ đo trong ứng dụng, đã gồm đi-về mạng tới Redis và tới PostgreSQL.
Và đây là chỗ phải nói thẳng, vì nó dễ gây hiểu lầm nếu chỉ nhìn phần 1: tỉ lệ 4 lần này nhỏ hơn nhiều so với con số 30–300 lần ở bài trước. Lý do đơn giản — query ở đây lấy một sản phẩm theo khoá chính và gộp đánh giá theo index, EXPLAIN ANALYZE cho 0,127ms, tức là query vốn đã nhanh. Cache một query nhanh thì phần thắng về độ trễ cũng nhỏ. Nếu bạn đang cache để kéo p99 xuống mà query gốc vốn đã nhanh, cache-aside sẽ làm bạn thất vọng.
Cái thắng lớn nằm ở cột khác: 1.000 thay vì 20.000 lượt chạm database. Database không phải chạy 19.000 query, bất kể mỗi query nhanh hay chậm. Đây là lý do cache-aside đáng có ngay cả khi độ trễ chỉ cải thiện vài lần: nó bảo vệ dung lượng của tài nguyên khó scale nhất. Với 20.000 request, tiết kiệm 95% kết nối, 95% công planner, 95% buffer pool bị khuấy.
Lỗ hổng của cache-aside: id không tồn tại xuyên thẳng xuống database
Cache-aside có một lỗ hổng gắn liền với chính thiết kế lười của nó. Cache chỉ được điền khi database trả về dữ liệu. Vậy nếu database trả về không có gì thì sao? Đoạn code ở Hình 1 không ghi gì vào cache cả — nên lần sau hỏi cùng id đó, lại miss, lại chạm database. Mãi mãi.
Đây gọi là xuyên thủng cache (cache penetration), và nó không phải chuyện lý thuyết: một con bot quét id tuần tự, hoặc một client có bug gửi id cũ đã xoá, là đủ để biến cache thành vô dụng cho nhánh đó. Mình đo bằng 5.000 request hỏi 200 id chắc chắn không tồn tại (products chỉ có id 1–50.000, mình hỏi 900000+):
- Không lưu dấu vắng mặt: 5.000/5.000 request chạm database (100%), tổng 446,8ms. Cache đứng đó không làm gì.
- Có lưu dấu vắng mặt: 200/5.000 (4,0%), tổng 203,9ms. Đúng 200 — mỗi id ma chỉ chạm database một lần.
Cách sửa là ghi một dấu vắng mặt (tombstone / negative cache) vào cache khi database trả về rỗng:
if err.Error() == "no rows in result set" {
    // TTL NGẮN: id này có thể được tạo thật sau đó
    rdb.Set(ctx, key, "__KHONG_CO__", 30*time.Second)
    return
}
TTL của dấu vắng mặt phải ngắn hơn TTL dữ liệu thật (ở đây 30 giây so với 60 giây). Lý do: một id chưa tồn tại có thể được tạo ngay sau đó, và nếu bạn cache "không có" trong một giờ thì người dùng vừa tạo sản phẩm sẽ không thấy nó trong một giờ. Dấu vắng mặt đánh đổi tính mới lấy việc chặn xuyên thủng, nên hãy đánh đổi ít thôi.
Đánh đổi cần cân nhắc
Cache-aside luôn có một cửa sổ dữ liệu cũ, và đó là lựa chọn có chủ ý. Trong khoảng TTL 60 giây, nếu ai đó sửa giá sản phẩm trong database, cache vẫn trả giá cũ. Cache-aside không tự biết database đã đổi — nó chỉ biết TTL. Muốn hẹp hơn thì phải xoá key chủ động khi ghi (invalidation, phần 7) hoặc đổi sang write-through (phần 8), và cả hai đều thêm phức tạp. Với dữ liệu chịu được hơi cũ thì TTL là câu trả lời đủ tốt và rẻ nhất; với số dư tài khoản thì không.
Cache lạnh là trạng thái thật, không phải trạng thái bất thường. Hình 2 cho thấy hit ratio chỉ 37,6% ở nghìn request đầu. Mỗi lần deploy Redis mới, mỗi lần restart, mỗi lần FLUSHALL nhầm, hệ thống quay về đúng trạng thái đó — và lúc ấy database nhận gần như toàn bộ lưu lượng. Nếu database không gánh nổi tải không có cache, thì cache đang che giấu một vấn đề về dung lượng chứ không giải quyết nó. Đây cũng là lúc hiệu ứng stampede xuất hiện mạnh nhất (phần 5).
Số đo ở đây là micro-benchmark trong container cùng máy. HIT 0,037ms là độ trễ khi Redis ở ngay cạnh; production thường có 0,2–1ms độ trễ mạng tới Redis, và khi đó tỉ lệ HIT/MISS sẽ khác. Dữ liệu cũng nhỏ và nóng trong bộ nhớ PostgreSQL, nên query gốc 0,127ms là trường hợp tốt nhất cho database — ở production với buffer pool lạnh hơn, chênh lệch sẽ nghiêng về phía cache nhiều hơn. Cơ chế (3 bước, cache nóng dần, trần truy vấn DB bằng kích thước tập làm việc) thì đúng ở mọi quy mô; con số tuyệt đối phải đo lại ở hệ của bạn.
Ba ý mang về
- Cache-aside là ba bước và ứng dụng tự viết cả ba: đọc cache → miss thì đọc DB → điền vào cache kèm TTL. Hai chỗ dễ sai nằm ngay trong ba bước đó: coi lỗi Redis là cache miss (Redis sập thì toàn bộ tải đổ vào DB) và
Setquên TTL (mất lưới an toàn cuối cùng cho dữ liệu cũ). - Giá trị đo được nằm ở số truy vấn DB, không phải độ trễ một request: 20.000 request chỉ sinh 1.000 truy vấn (tiết kiệm 95%), trong khi độ trễ chỉ cải thiện ~4 lần (0,152ms → 0,037ms) vì query gốc vốn đã có index. Trần truy vấn DB bằng đúng kích thước tập làm việc.
- Cache-aside xuyên thủng với id không tồn tại — đo thật 5.000/5.000 request chạm DB. Dấu vắng mặt kéo xuống còn 200/5.000, nhưng TTL của nó phải ngắn hơn TTL dữ liệu thật để id vừa được tạo không bị giấu đi.
Nguồn
- Redis docs — Caching patterns & client-side caching: https://redis.io/docs/latest/develop/clients/patterns/
- go-redis — Getting started: https://redis.uptrace.dev/guide/go-redis.html
- Microsoft Azure Architecture Center — Cache-Aside pattern: https://learn.microsoft.com/en-us/azure/architecture/patterns/cache-aside
- PostgreSQL docs — Using EXPLAIN: https://www.postgresql.org/docs/current/using-explain.html
Phần sau ta mổ xẻ chính cái TTL vừa đặt bừa 60 giây ở đây: TTL quyết định dữ liệu cũ tới mức nào, đo thật mức độ lệch giữa cache và database theo từng giá trị TTL, và vì sao TTL đồng loạt lại tự tạo ra một cơn bão miss.
