Khi một API chậm, lời khuyên đầu tiên gần như luôn là "thêm cache". Nghe hợp lý — cache nằm trong RAM, database nằm trên đĩa, RAM nhanh hơn đĩa. Nhưng "nhanh hơn" là bao nhiêu, và khi nào thì cache thực sự đáng thêm? Trả lời bằng cảm tính dẫn tới hai sai lầm phổ biến: cache mọi thứ (thêm phức tạp cho những query vốn đã nhanh) hoặc không cache những chỗ đáng cache nhất. Để quyết định đúng, cần đo. Bài này (phần 1 loạt Caching) đo thật độ trễ đọc từ Redis so với query PostgreSQL cho cùng một dữ liệu, và chỉ ra cache thắng rõ nhất ở đâu.
Cache đổi "tính lại mỗi lần" lấy "đọc kết quả có sẵn"
Ý tưởng cốt lõi của cache rất đơn giản: thay vì tính lại một kết quả mỗi lần cần, lưu kết quả đã tính và đọc lại. Giá trị của cache tỉ lệ thuận với độ đắt của việc tính:
- Một query nặng — gộp (aggregate) hàng trăm nghìn dòng, join nhiều bảng, tính toán phức tạp — tốn nhiều mili-giây mỗi lần. Cache kết quả của nó là thắng lớn.
- Một query nhẹ — lấy một dòng theo khoá chính — vốn đã rất nhanh (database có index). Cache nó cũng giúp, nhưng chênh lệch nhỏ hơn nhiều.
-- query NẶNG: gộp 100k dòng mỗi lần gọi (~8ms)
SELECT region, sum(amount), avg(amount), count(*)
  FROM sales GROUP BY region;
# cache KẾT QUẢ đã tính vào Redis (một lần)
redis-cli SET agg:sales '{"bac":...,"nam":...}'
# các request sau: đọc thẳng từ RAM (~0.03ms, không tính lại)
redis-cli GET agg:sales
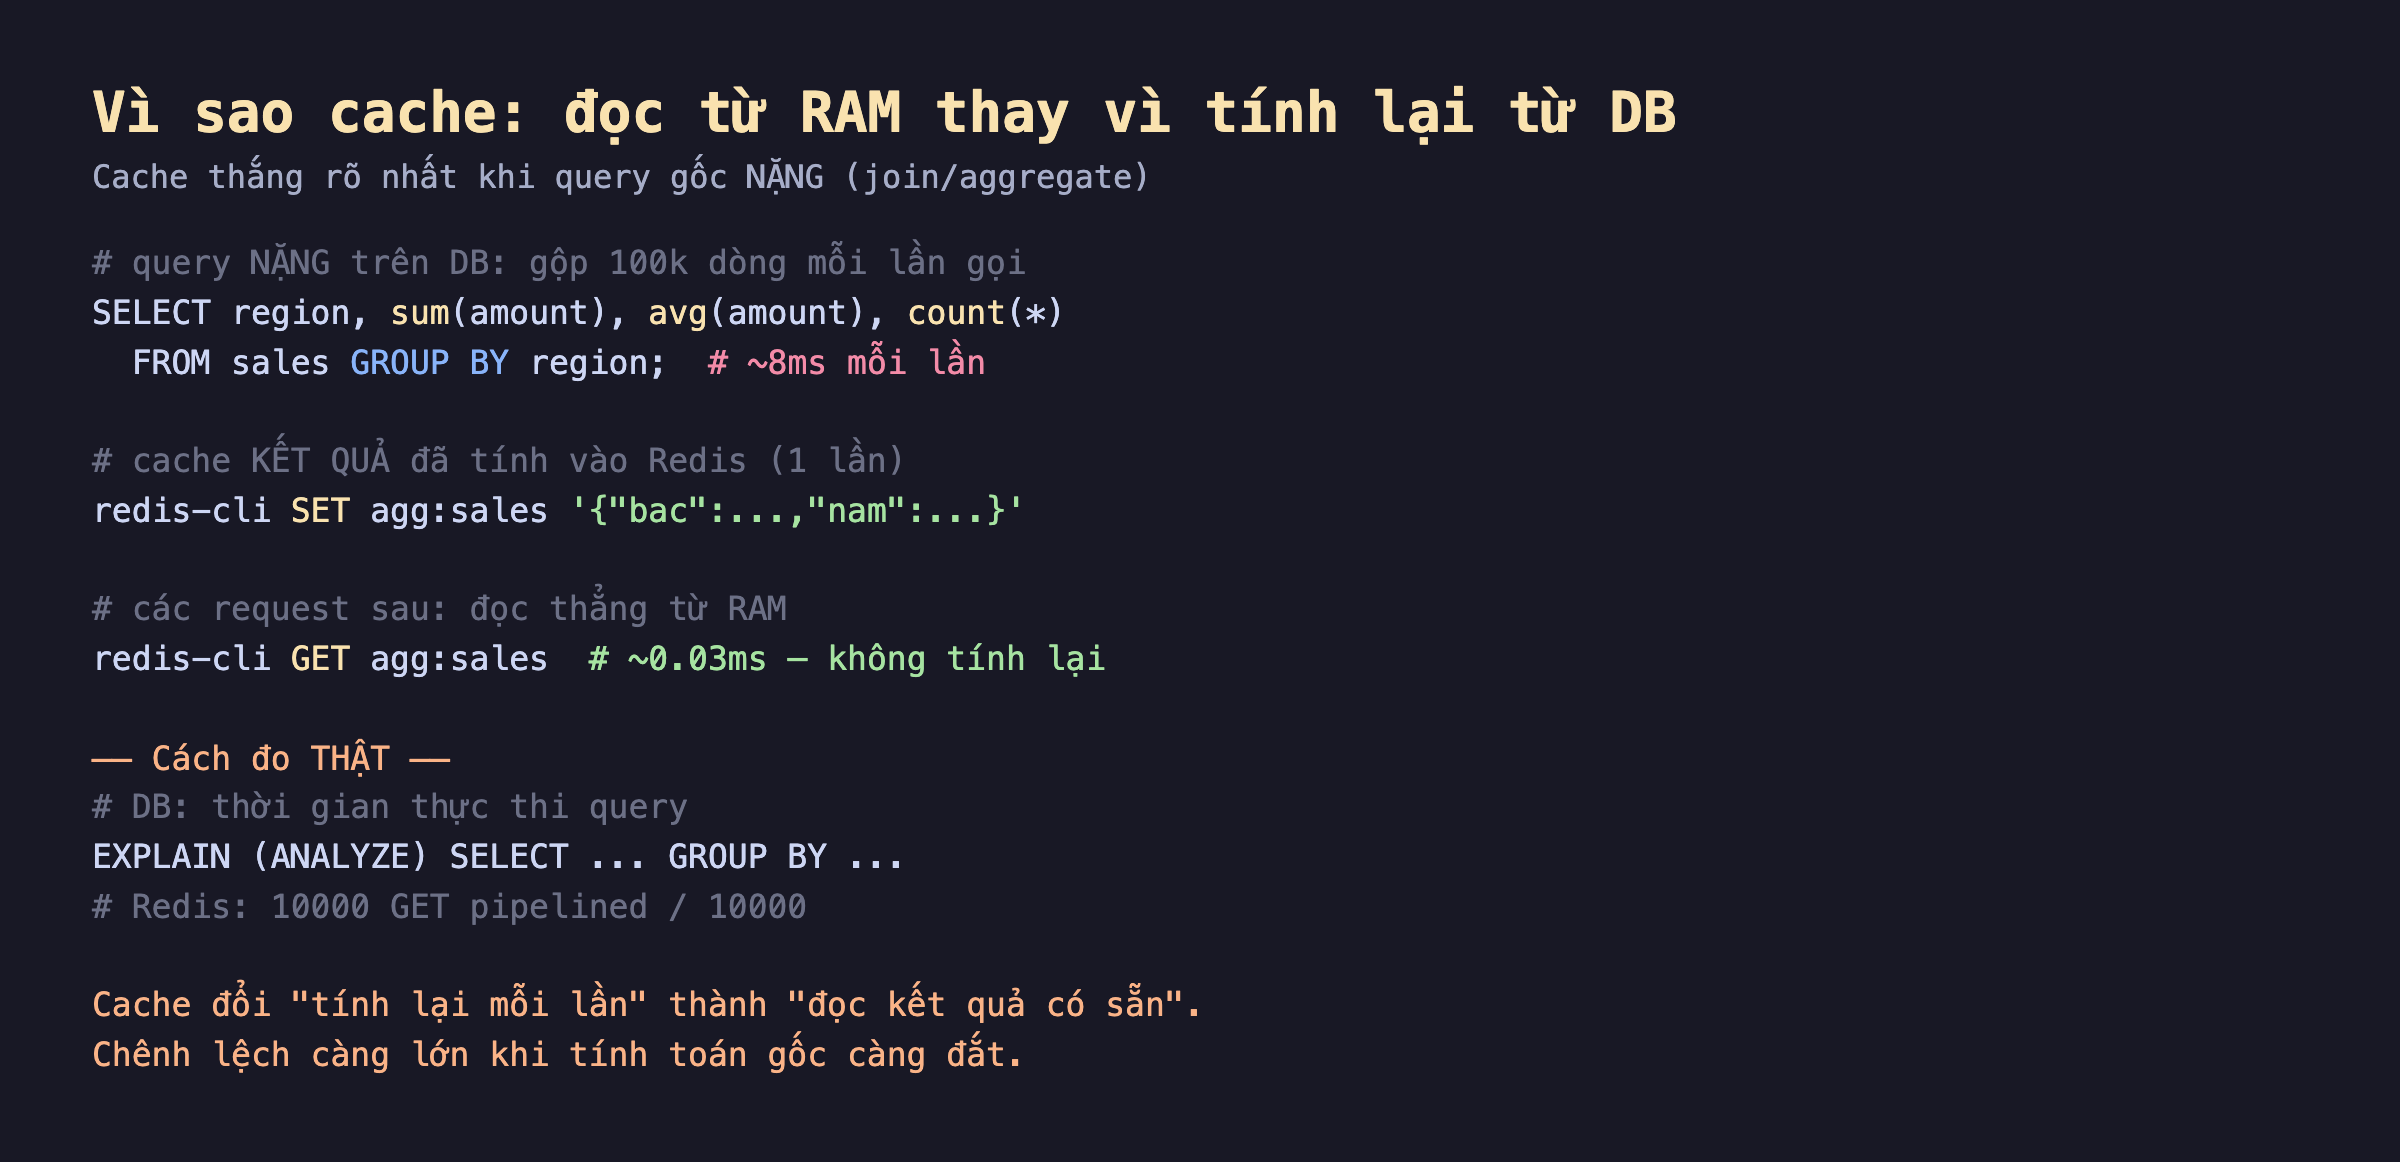
Hình 1: Cache đổi "tính lại từ DB mỗi lần" (query gộp 100k dòng ~8ms) lấy "đọc kết quả có sẵn từ RAM" (GET ~0.03ms). Đo DB bằng EXPLAIN ANALYZE, đo Redis bằng 10000 GET pipelined. Chênh lệch càng lớn khi tính toán gốc càng đắt.
Đo thật: 8.2ms vs 0.028ms
Mình tạo bảng sales 100.000 dòng trên pg-lab, một query gộp theo region, và đo thời gian thực thi; rồi cache kết quả vào redis-lab và đo GET:
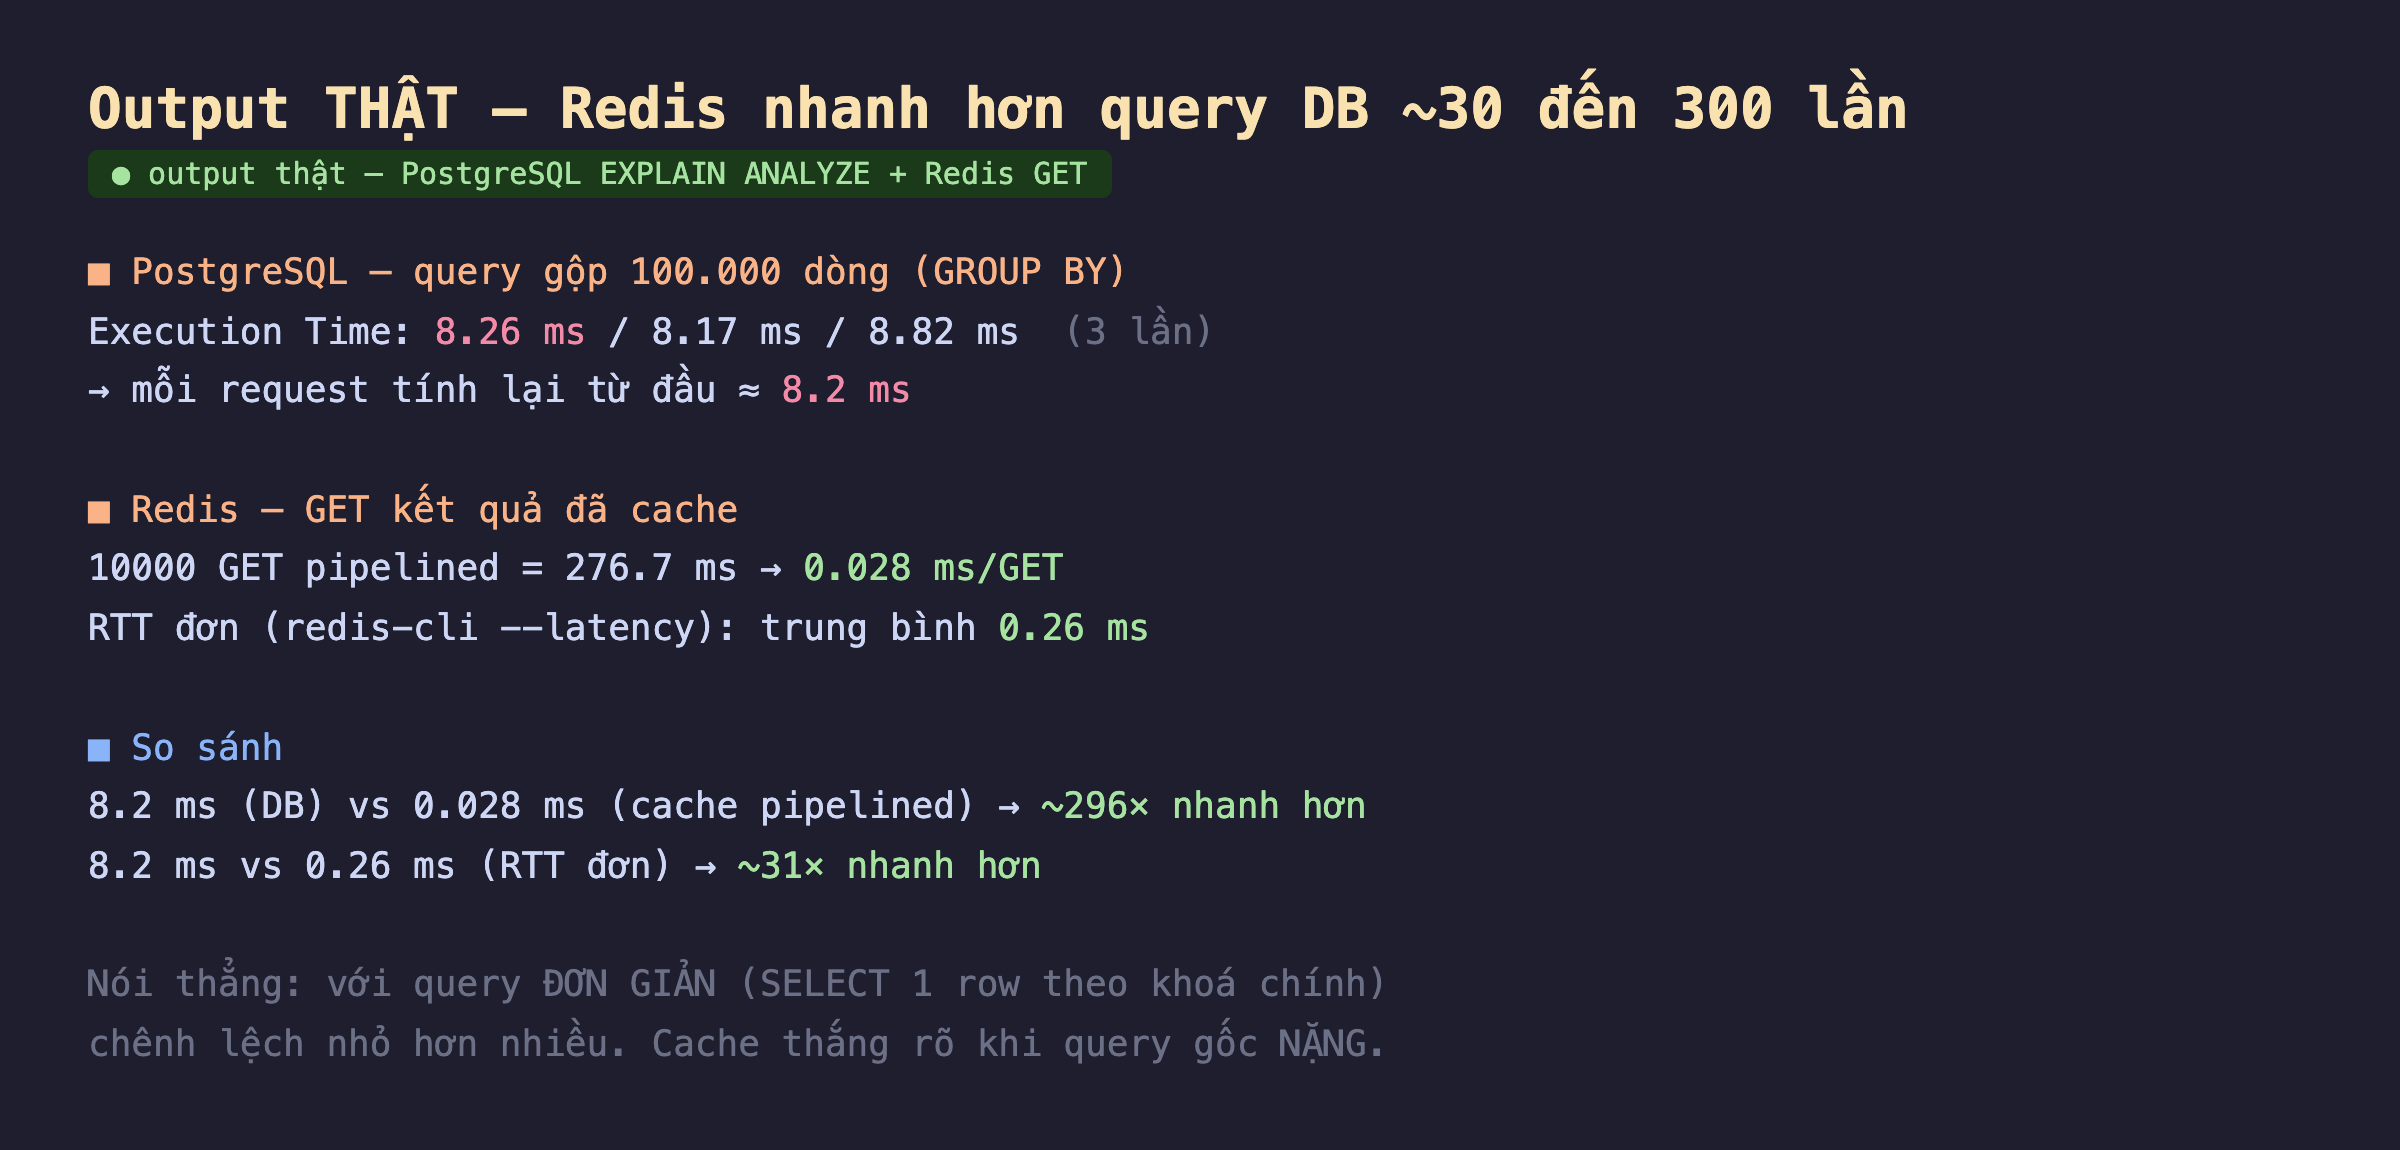
Hình 2: Kết quả thật. PostgreSQL query gộp 100.000 dòng: Execution Time 8.26/8.17/8.82ms (~8.2ms mỗi lần). Redis GET kết quả đã cache: 0.028ms/GET (pipelined) hoặc 0.26ms (round-trip đơn). So sánh: ~296× nhanh hơn (pipelined) hoặc ~31× (RTT đơn).
Đọc kết quả:
- PostgreSQL ~8.2ms mỗi query: đo bằng
EXPLAIN (ANALYZE)nên là thời gian thực thi thuần phía server (không tính overhead client/mạng). Ba lần đo nhất quán (8.26/8.17/8.82ms). Mỗi request gọi query này buộc database quét và gộp 100.000 dòng từ đầu — công việc lặp lại y hệt cho mọi request, dù kết quả không đổi. - Redis ~0.028ms/GET (pipelined): 10.000 GET nối ống (pipelined) hết 276.7ms → trung bình 0.028ms mỗi GET. Đây là throughput khi gửi nhiều lệnh liên tiếp.
- Redis ~0.26ms (round-trip đơn):
redis-cli --latencyđo round-trip từng lệnh riêng lẻ, trung bình 0.26ms — con số thực tế hơn cho một request đơn lẻ (gồm cả đi-về). - Chênh lệch 30–300×: tùy cách đo, Redis nhanh hơn query này 31× tới 296×. Dù lấy con số bảo thủ nhất (RTT đơn 0.26ms), cache vẫn nhanh hơn 31 lần — và quan trọng hơn, nó gỡ tải khỏi database (database không phải gộp 100k dòng cho mỗi request).
Nhưng phải nói thẳng một điều để không gây hiểu lầm: con số 300× này là cho query nặng. Với một query đơn giản — SELECT * FROM users WHERE id = 5 có index — database trả về trong khoảng vài chục micro-giây tới dư 1ms, và chênh lệch với Redis nhỏ hơn nhiều. Cache không phải phép màu nhân mọi thứ lên 300 lần; nó đặc biệt đáng khi việc tính toán gốc đắt.
Vì sao cache còn quan trọng hơn chỉ là tốc độ
Chênh lệch độ trễ là lý do dễ thấy nhất, nhưng không phải lý do quan trọng nhất. Giá trị lớn hơn của cache là giảm tải cho database. Query gộp 8.2ms kia, nếu có 1.000 request/giây cùng gọi, bắt database làm 8.200ms công việc mỗi giây chỉ cho một query — nhanh chóng bão hoà CPU database (nhớ saturation ở loạt Observability). Cache hứng phần lớn các request đó (chỉ một request thỉnh thoảng chạm database để làm mới), nên database rảnh tay cho việc khác. Database thường là tài nguyên khó scale nhất (scale ngang khó hơn app server); cache bảo vệ chính tài nguyên quý đó. Đây là lý do thực sự cache là xương sống của mọi hệ chịu tải cao — không chỉ vì nhanh, mà vì nó che chắn database.
Đánh đổi cần cân nhắc
Cache thêm một tầng, một điểm có thể sai. Thêm Redis nghĩa là thêm một hệ phải vận hành, giám sát, và — quan trọng nhất — giữ đồng bộ với database (chủ đề các bài sau: TTL, invalidation). Dữ liệu trong cache có thể cũ so với database; nếu không quản lý, bạn phục vụ dữ liệu sai. Với dữ liệu đổi liên tục và cần chính xác tuyệt đối (số dư tài khoản ngay lúc giao dịch), cache có thể hại nhiều hơn lợi. Cache hợp nhất cho dữ liệu đọc nhiều, đổi ít, chịu được hơi cũ.
Đo trước khi cache — đừng cache theo cảm tính. Như demo cho thấy, lợi ích cache phụ thuộc độ đắt của query gốc. Cache một query vốn đã 0.1ms để tiết kiệm 0.07ms là thêm phức tạp mà gần như vô ích. Trước khi thêm cache, đo query thật (EXPLAIN ANALYZE, slow query log) để biết chỗ nào đắt. Cache đúng chỗ đắt mang lại 90% giá trị với 10% phức tạp; cache bừa thì ngược lại.
Micro-benchmark không phản ánh hoàn toàn production. Số đo ở đây là trong container, cùng máy, dữ liệu nhỏ, cache nóng. Production có độ trễ mạng giữa app và Redis (thường 0.2–1ms), Redis có thể ở máy khác, dữ liệu lớn hơn, và cache miss (lần đầu) vẫn phải chạm database. Con số tuyệt đối sẽ khác; nhưng tỉ lệ (cache nhanh hơn nhiều với query nặng) và cơ chế (giảm tải DB) thì đúng ở mọi quy mô. Mang cơ chế vào, đo lại ở hệ của bạn.
Ba ý mang về
- Cache nhanh hơn query DB rõ rệt khi tính toán gốc đắt: đo thật query gộp 100.000 dòng tốn 8.2ms vs Redis GET 0.028ms (pipelined)/0.26ms (RTT đơn) → nhanh hơn 30–300×; cache đổi "tính lại mỗi lần" lấy "đọc kết quả có sẵn".
- Giá trị lớn nhất là giảm tải database, không chỉ tốc độ: cache hứng phần lớn request nên database — tài nguyên khó scale nhất — rảnh tay; đây là lý do cache là xương sống của hệ chịu tải cao.
- Đo trước khi cache, và quản lý tính cũ: lợi ích phụ thuộc độ đắt query gốc (query đơn giản chênh lệch nhỏ), nên đo (EXPLAIN ANALYZE) chọn đúng chỗ; và cache thêm một tầng phải giữ đồng bộ với DB — hợp dữ liệu đọc-nhiều-đổi-ít-chịu-được-hơi-cũ.
Nguồn
- Redis docs — Introduction & use cases: https://redis.io/docs/latest/develop/get-started/
- PostgreSQL docs — EXPLAIN & performance: https://www.postgresql.org/docs/current/using-explain.html
- Martin Kleppmann — Designing Data-Intensive Applications, ch.1 (caching & performance)
Phần sau ta dựng mẫu cache phổ biến nhất — cache-aside: đọc cache trước, miss thì lấy từ DB rồi điền vào cache; đo thật hit ratio tăng dần và số query DB tiết kiệm được.
