Phần trước dựng cache-aside và đặt TTL = 60 giây ở bước 3 mà không giải thích gì. Con số đó được chọn bừa — và chính chỗ đó mới là quyết định quan trọng nhất của cả mẫu. Vì cache-aside không xoá cache khi database đổi, TTL là thứ duy nhất kéo dữ liệu mới về. Chọn TTL tức là chọn thẳng một câu trả lời cho câu hỏi: người dùng được phép nhìn thấy dữ liệu cũ tới mức nào?
Bài này đo con số đó thay vì đoán.
TTL không phải "cache bao lâu" — nó là trần độ cũ
Cách nói quen thuộc "cache 60 giây" nghe như một quyết định về hiệu năng. Thực ra nó là một quyết định về tính đúng đắn: trong 60 giây đó, nếu database đổi, mọi người đọc đều nhận bản cũ và không ai biết.
Có một quy tắc nhẩm rất gọn cho chuyện này. Với các lượt đọc rải đều trong vòng đời một key, thời điểm đọc rơi ngẫu nhiên ở đâu đó giữa lúc key được nạp và lúc nó hết hạn — nên độ cũ trung bình ≈ TTL / 2, và độ cũ tối đa ≈ TTL. Quy tắc này chỉ có giá trị nếu kiểm chứng được, nên mình đo.
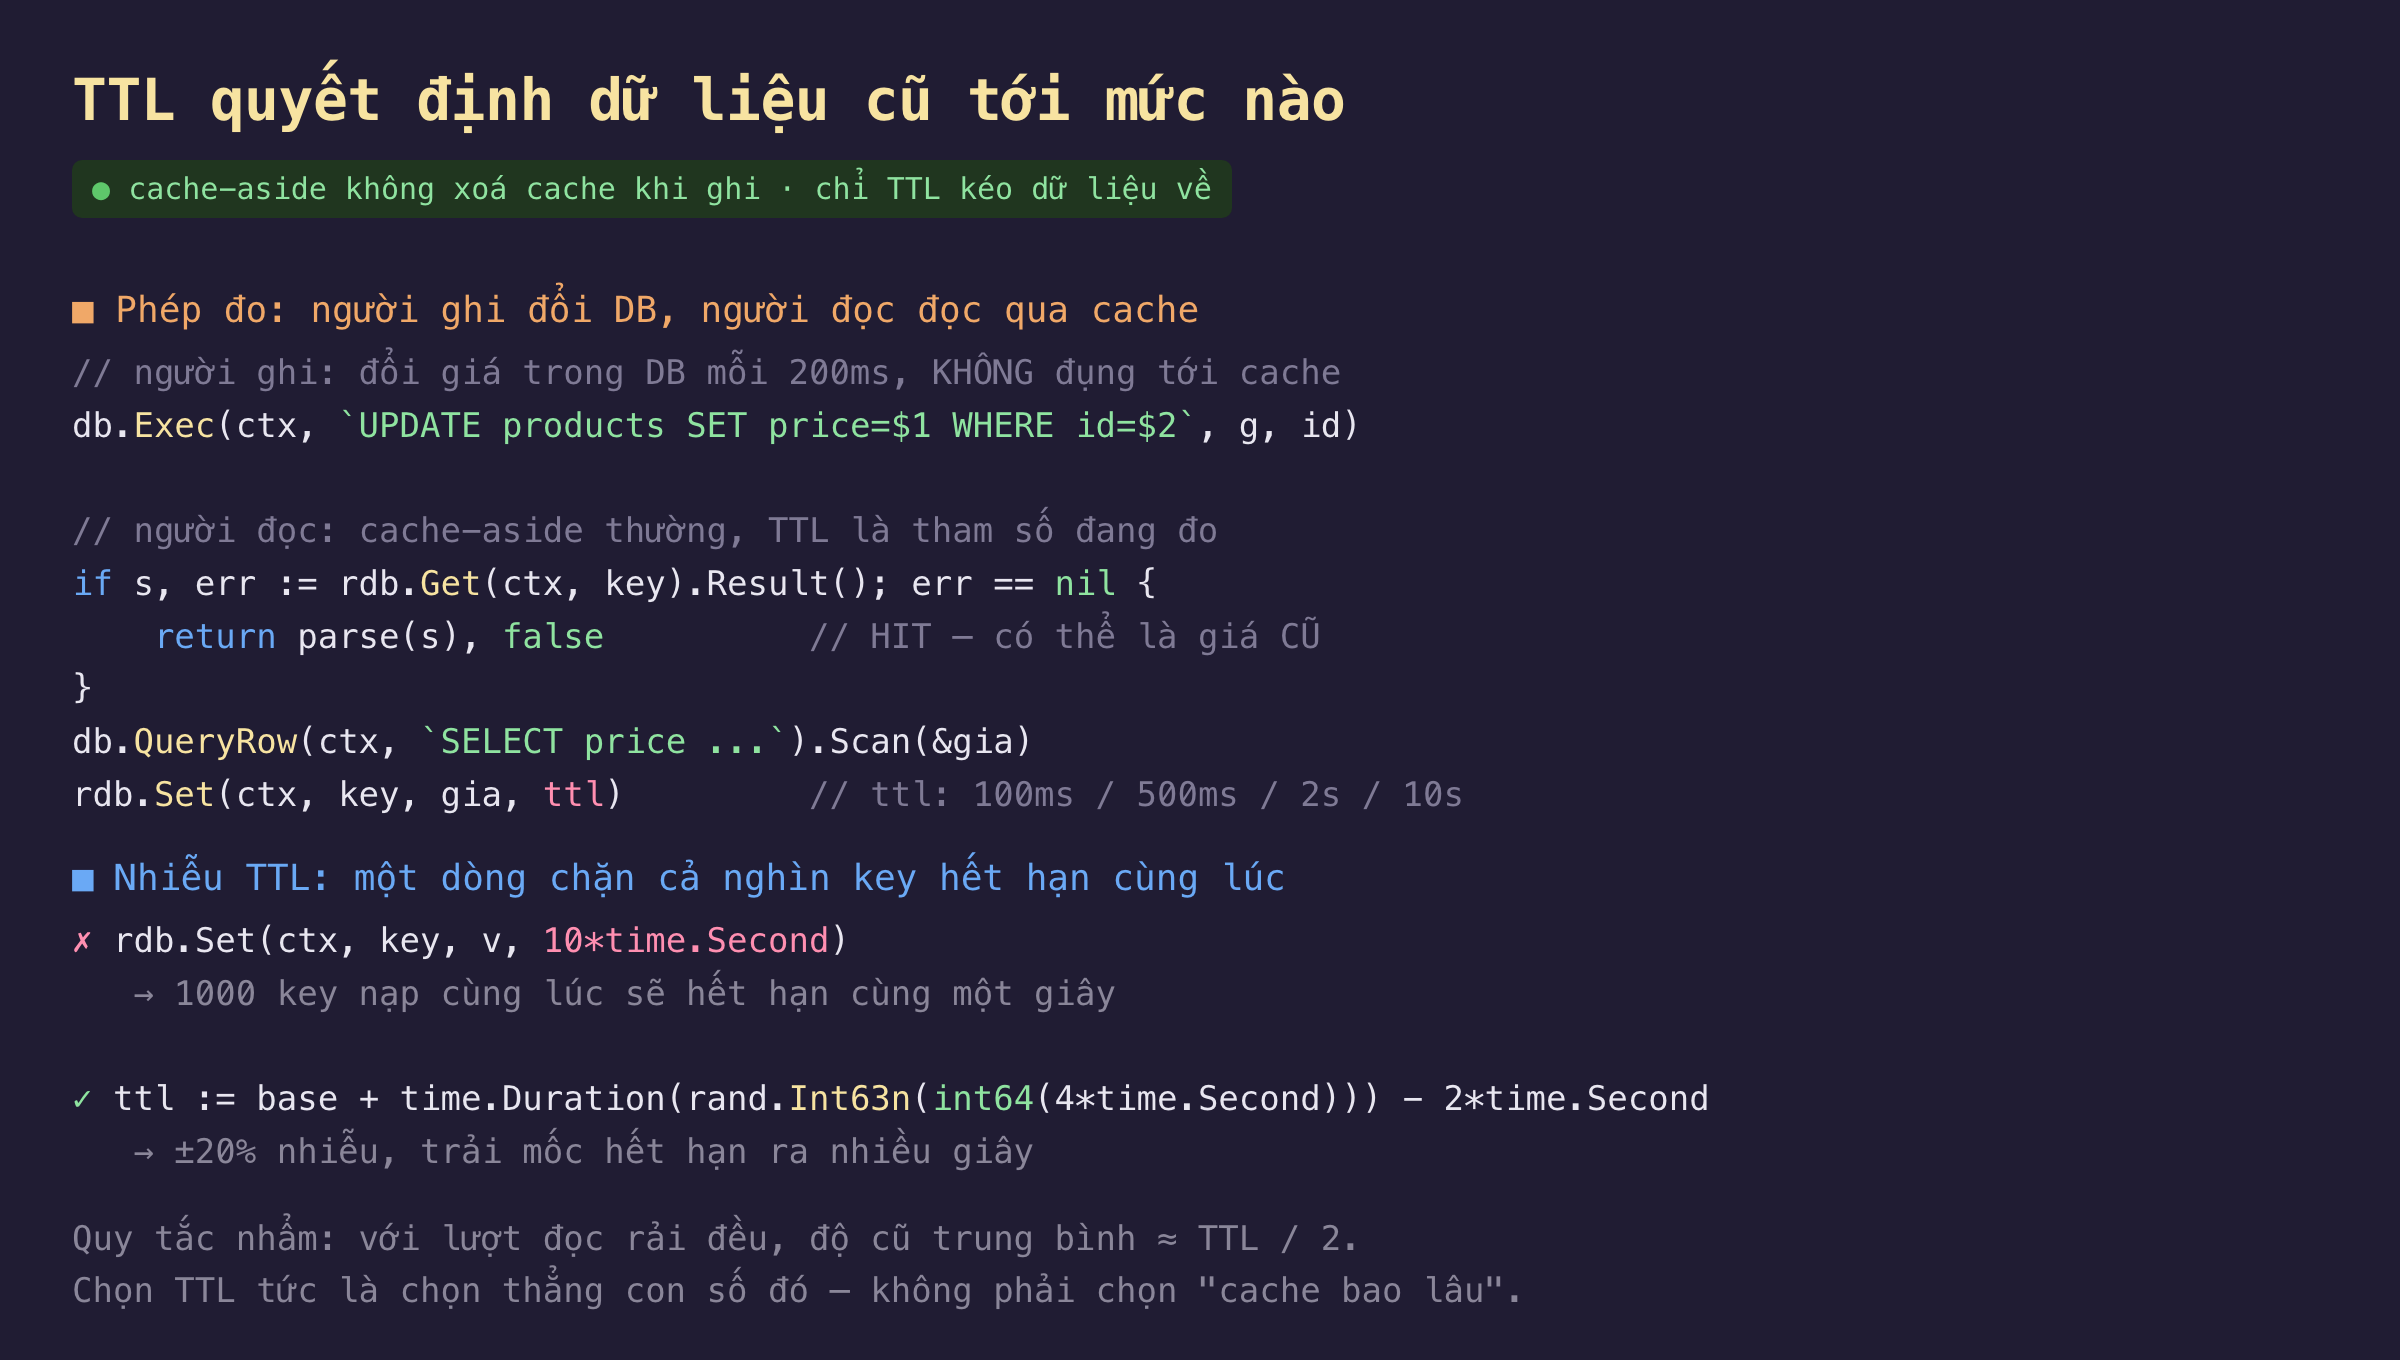
Hình 1: Phép đo. Người ghi đổi giá trong database mỗi 200ms và cố tình không đụng tới cache; người đọc đọc qua cache-aside mỗi 10ms. Chênh lệch giữa hai bên chính là độ cũ do TTL gây ra.
Thiết kế phép đo quan trọng ở một điểm: người ghi không xoá cache. Đó đúng là cache-aside thuần như ở phần 2 — không có invalidation, nên TTL phải gánh toàn bộ trách nhiệm về tính mới. Giá tăng đúng 1,00 đơn vị mỗi 200ms, nên độ lệch tính bằng đơn vị giá đổi thẳng được sang thời gian: lệch 25,04 đơn vị nghĩa là dữ liệu đang cũ khoảng 5,0 giây.
Đo thật: TTL 10s cho độ cũ 5 giây, TTL 100ms cho 97 lần chạm DB
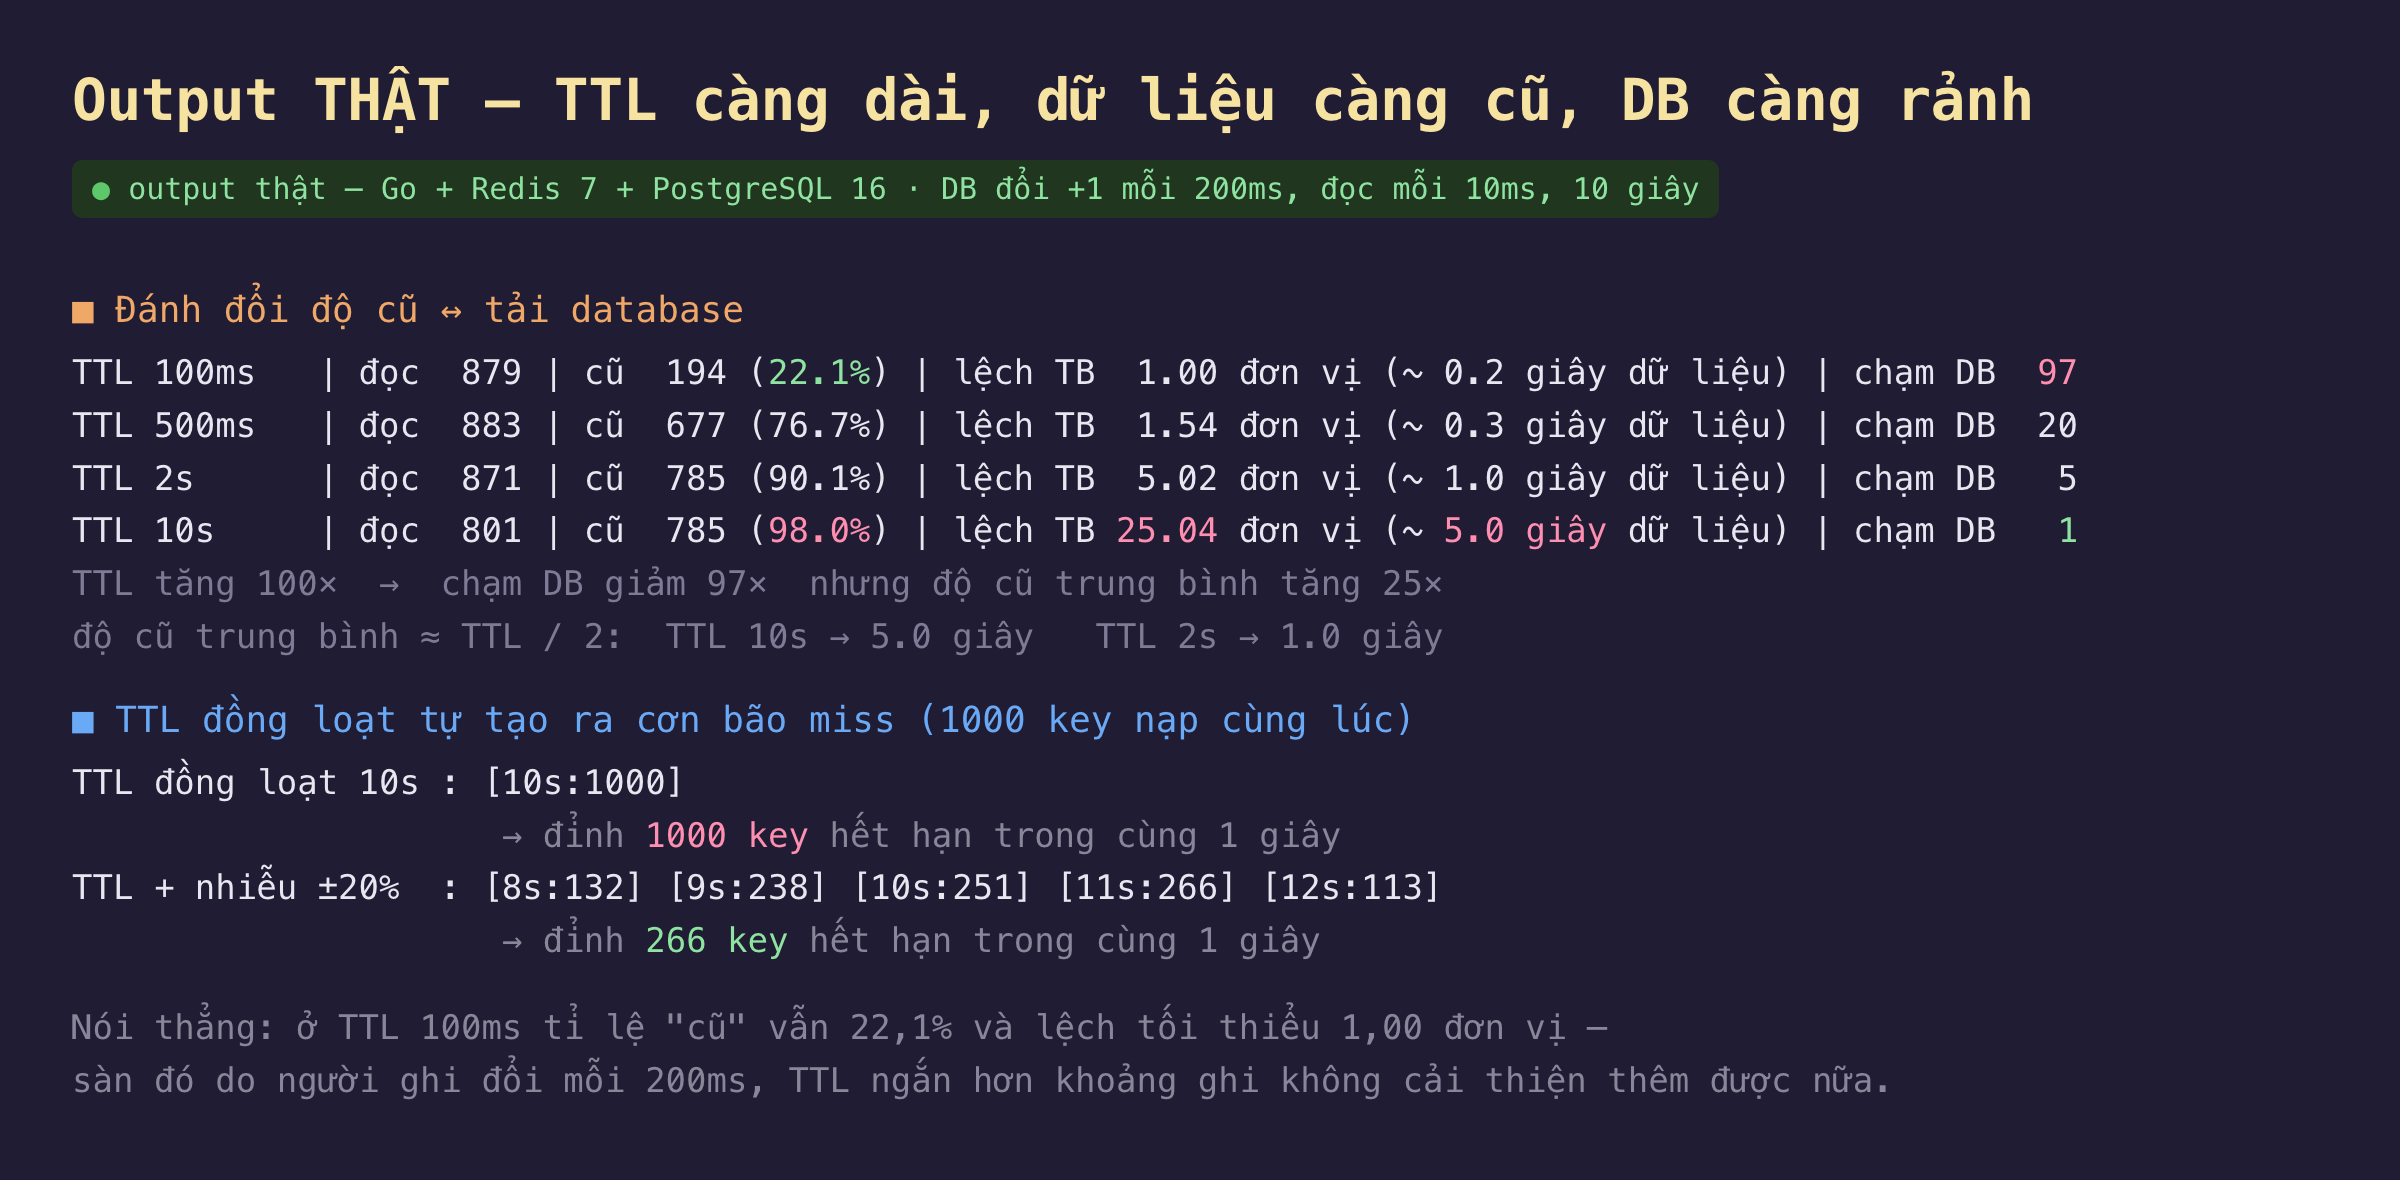
Hình 2: Kết quả thật. Bốn TTL, cùng một khối lượng đọc. Cột "lệch TB" quy ra giây là độ cũ trung bình thật; cột "chạm DB" là cái giá phải trả để có độ mới đó.
Đọc theo cặp, hai cột ngoài cùng là toàn bộ câu chuyện:
| TTL | độ cũ trung bình | số lần chạm DB trong 10 giây |
|---|---|---|
| 100ms | ~0,2 giây | 97 |
| 500ms | ~0,3 giây | 20 |
| 2s | ~1,0 giây | 5 |
| 10s | ~5,0 giây | 1 |
- Quy tắc TTL/2 đứng vững ở vùng TTL dài. TTL 10s → lệch 5,0 giây (đúng TTL/2). TTL 2s → 1,0 giây (đúng TTL/2). Không phải trùng hợp: đó là giá trị kỳ vọng của một điểm rơi ngẫu nhiên trong khoảng
[0, TTL]. - Đánh đổi không tuyến tính, và đó là tin tốt. Từ TTL 100ms lên 10s — dài gấp 100 lần — tải database giảm từ 97 xuống 1, tức 97 lần, nhưng độ cũ chỉ tăng từ 0,2 lên 5,0 giây, tức 25 lần. Phần lớn lợi ích về tải đến ở đoạn TTL ngắn (100ms → 500ms đã cắt 97 → 20, gần 5 lần, mà độ cũ gần như không đổi). Hệ quả thực dụng: nếu đang không cache gì cả, thêm một TTL rất ngắn — vài trăm mili-giây — đã lấy được phần lớn lợi ích mà hầu như không phải nhượng bộ gì về tính mới. "TTL 1 giây có đáng không?" — đáng, đáng hơn người ta tưởng nhiều.
- Cột "cũ %" dễ gây hiểu lầm, đừng dùng nó một mình. TTL 500ms cho 76,7% lượt đọc là "cũ", nghe rất tệ. Nhưng cũ bao nhiêu? 1,54 đơn vị — tức 0,3 giây. Một phần trăm lớn các lượt đọc lệch một chút hoàn toàn khác với một phần trăm nhỏ lệch rất nhiều. Khi giám sát cache, đo độ lớn của sự cũ, đừng chỉ đếm số lượt cũ.
Và một chỗ phải nói thẳng: TTL 100ms vẫn cho 22,1% lượt đọc cũ, lệch tối thiểu đúng 1,00 đơn vị, không nhỏ hơn được. Vì người ghi đổi giá mỗi 200ms, luôn tồn tại một cửa sổ mà cache đã cũ nhưng chưa hết hạn. Hạ TTL xuống dưới chu kỳ ghi không mua thêm được gì — chỉ tốn thêm lượt chạm database. Sàn của độ cũ là tần suất ghi, không phải TTL. Muốn xuống dưới sàn đó thì phải đổi cơ chế: xoá cache khi ghi (phần 7), chứ không phải vặn TTL nhỏ hơn nữa.
Cái bẫy thứ hai: TTL đồng loạt tự tạo ra cơn bão miss
Có một hệ quả của TTL mà không ai nghĩ tới lúc gõ Set(key, v, 10*time.Second): TTL được đếm từ lúc key được nạp. Nếu một nghìn key được nạp gần như cùng lúc — sau một lần deploy, sau khi Redis restart, sau một job làm nóng cache — thì chúng cũng hết hạn gần như cùng lúc.
Đo thật bằng cách nạp 1.000 key rồi đọc TTL của từng key và đếm xem chúng rơi vào giây nào:
- TTL đồng loạt 10s: cả 1.000 key dồn vào đúng mốc
10s. Đỉnh 1.000 key hết hạn trong cùng một giây. - TTL có nhiễu ±20%: trải ra 5 mốc —
8s:132,9s:238,10s:251,11s:266,12s:113. Đỉnh còn 266.
Khi 1.000 key hết hạn cùng lúc, 1.000 request tiếp theo đều miss và đều đi thẳng xuống database trong cùng một giây. Đó là một cú sốc tải tự gây ra, lặp lại đều đặn mỗi 10 giây — biểu đồ tải database sẽ có răng cưa mà không ai giải thích nổi nếu chỉ nhìn code. Cách chữa chỉ là một dòng: cộng nhiễu ngẫu nhiên vào TTL.
// ±20% nhiễu quanh TTL cơ sở
ttl := base + time.Duration(rand.Int63n(int64(4*time.Second))) - 2*time.Second
rdb.Set(ctx, key, v, ttl)
Nhiễu ±20% giảm đỉnh từ 1.000 xuống 266 — gần 4 lần — và không tốn gì: độ cũ trung bình vẫn xấp xỉ TTL/2 như cũ, vì nhiễu đối xứng quanh giá trị cơ sở. Đây là một trong những thay đổi rẻ nhất trong toàn bộ loạt bài này.
Lưu ý nhiễu không xoá được vấn đề, chỉ trải nó ra. Khi nhiều request cùng miss cùng một key, nhiễu không giúp gì cả — đó là bài toán khác tên stampede, chủ đề phần 5 và 6.
Đánh đổi cần cân nhắc
TTL dài hơn không phải lúc nào cũng "bẩn hơn", nó phụ thuộc dữ liệu đổi nhanh ra sao. Phép đo này cố tình chọn trường hợp khắc nghiệt: giá đổi 5 lần mỗi giây. Với dữ liệu thực tế đổi vài lần một ngày (mô tả sản phẩm, cấu hình, danh mục), TTL 10 phút vẫn cho độ cũ thực tế bằng 0 trong phần lớn thời gian, vì giữa hai lần ghi chẳng có gì để cũ. Công thức TTL/2 cho độ cũ tối đa có thể, không phải độ cũ điển hình. Chọn TTL theo tần suất ghi thật của chính dữ liệu đó, đừng theo một con số chung cho mọi key.
TTL cũng là lưới an toàn, nên đừng bỏ nó kể cả khi đã có invalidation. Phần 7 sẽ thêm cơ chế xoá cache chủ động khi ghi, và lúc đó dễ nghĩ "đã xoá chủ động thì cần gì TTL". Nhưng invalidation là code, và code có bug: một nhánh ghi quên gọi xoá, một message bị mất, một service khác sửa thẳng vào database. Khi đó TTL là thứ duy nhất đặt trần cho thiệt hại — không có nó, dữ liệu sai nằm trong cache vĩnh viễn. TTL dài vẫn tốt hơn không TTL rất nhiều.
Phép đo này chạy trong container cùng máy, một key, một người đọc. Con số chạm DB (97/20/5/1) tỉ lệ thuận với thời lượng 10 giây và một key duy nhất; với N key và lưu lượng thật, con số tuyệt đối sẽ khác hẳn. Thứ mang đi được là hình dạng của đánh đổi (lợi ích tải giảm dần khi TTL dài ra, độ cũ tăng tuyến tính) và sàn độ cũ bằng tần suất ghi. Cả hai đúng ở mọi quy mô; con số thì phải đo lại trên dữ liệu của bạn.
Ba ý mang về
- TTL là trần độ cũ, không phải tham số hiệu năng: đo thật cho độ cũ trung bình ≈ TTL/2 (TTL 10s → 5,0 giây; TTL 2s → 1,0 giây). Chọn TTL là trả lời thẳng câu "người dùng được nhìn thấy dữ liệu cũ tới mức nào".
- Phần lớn lợi ích nằm ở đoạn TTL rất ngắn: 100ms → 10s (dài gấp 100 lần) giảm tải DB 97 lần nhưng đã làm dữ liệu cũ hơn 25 lần; riêng đoạn 100ms → 500ms cắt tải gần 5 lần mà độ cũ gần như không đổi. Và sàn của độ cũ là tần suất ghi — TTL ngắn hơn chu kỳ ghi không mua thêm được gì.
- TTL đồng loạt tự tạo cơn bão miss: 1.000 key nạp cùng lúc hết hạn dồn vào đúng một giây; cộng nhiễu ±20% hạ đỉnh xuống 266 (gần 4 lần) mà không đổi độ cũ trung bình. Một dòng code, nên làm mặc định.
Nguồn
- Redis docs — Key expiration (EXPIRE, TTL): https://redis.io/docs/latest/commands/expire/
- Redis docs — How Redis expires keys: https://redis.io/docs/latest/develop/use/keyspace/
- AWS Builders' Library — Caching challenges and strategies: https://aws.amazon.com/builders-library/caching-challenges-and-strategies/
- PostgreSQL docs — UPDATE: https://www.postgresql.org/docs/current/sql-update.html
Phần sau ta bỏ giả định cache luôn đủ chỗ: khi Redis chạm maxmemory, key bị đá ra trước khi TTL hết. Đo thật các chính sách allkeys-lru, allkeys-lfu và noeviction — cái nào giữ đúng key nóng, cái nào làm ứng dụng ngã.
