Ba phần trước đều nói về một key rời khỏi cache: hết TTL (phần 3) hoặc bị đá vì hết chỗ (phần 4). Cả hai lần, mình mô tả hậu quả bằng một câu nhẹ nhàng: "request tiếp theo sẽ miss và điền lại". Câu đó đúng khi có một request tiếp theo.
Nhưng key nóng thì không có "một request tiếp theo" — nó có hàng trăm, trong cùng một phần nghìn giây. Tất cả cùng miss. Tất cả cùng đi tiếp. Hiện tượng này tên là cache stampede (hay thundering herd, dog-piling), và nó là cách cache giết chết database vì chính nó biến mất trong một khoảnh khắc.
Chỗ hở nằm giữa hai dòng code
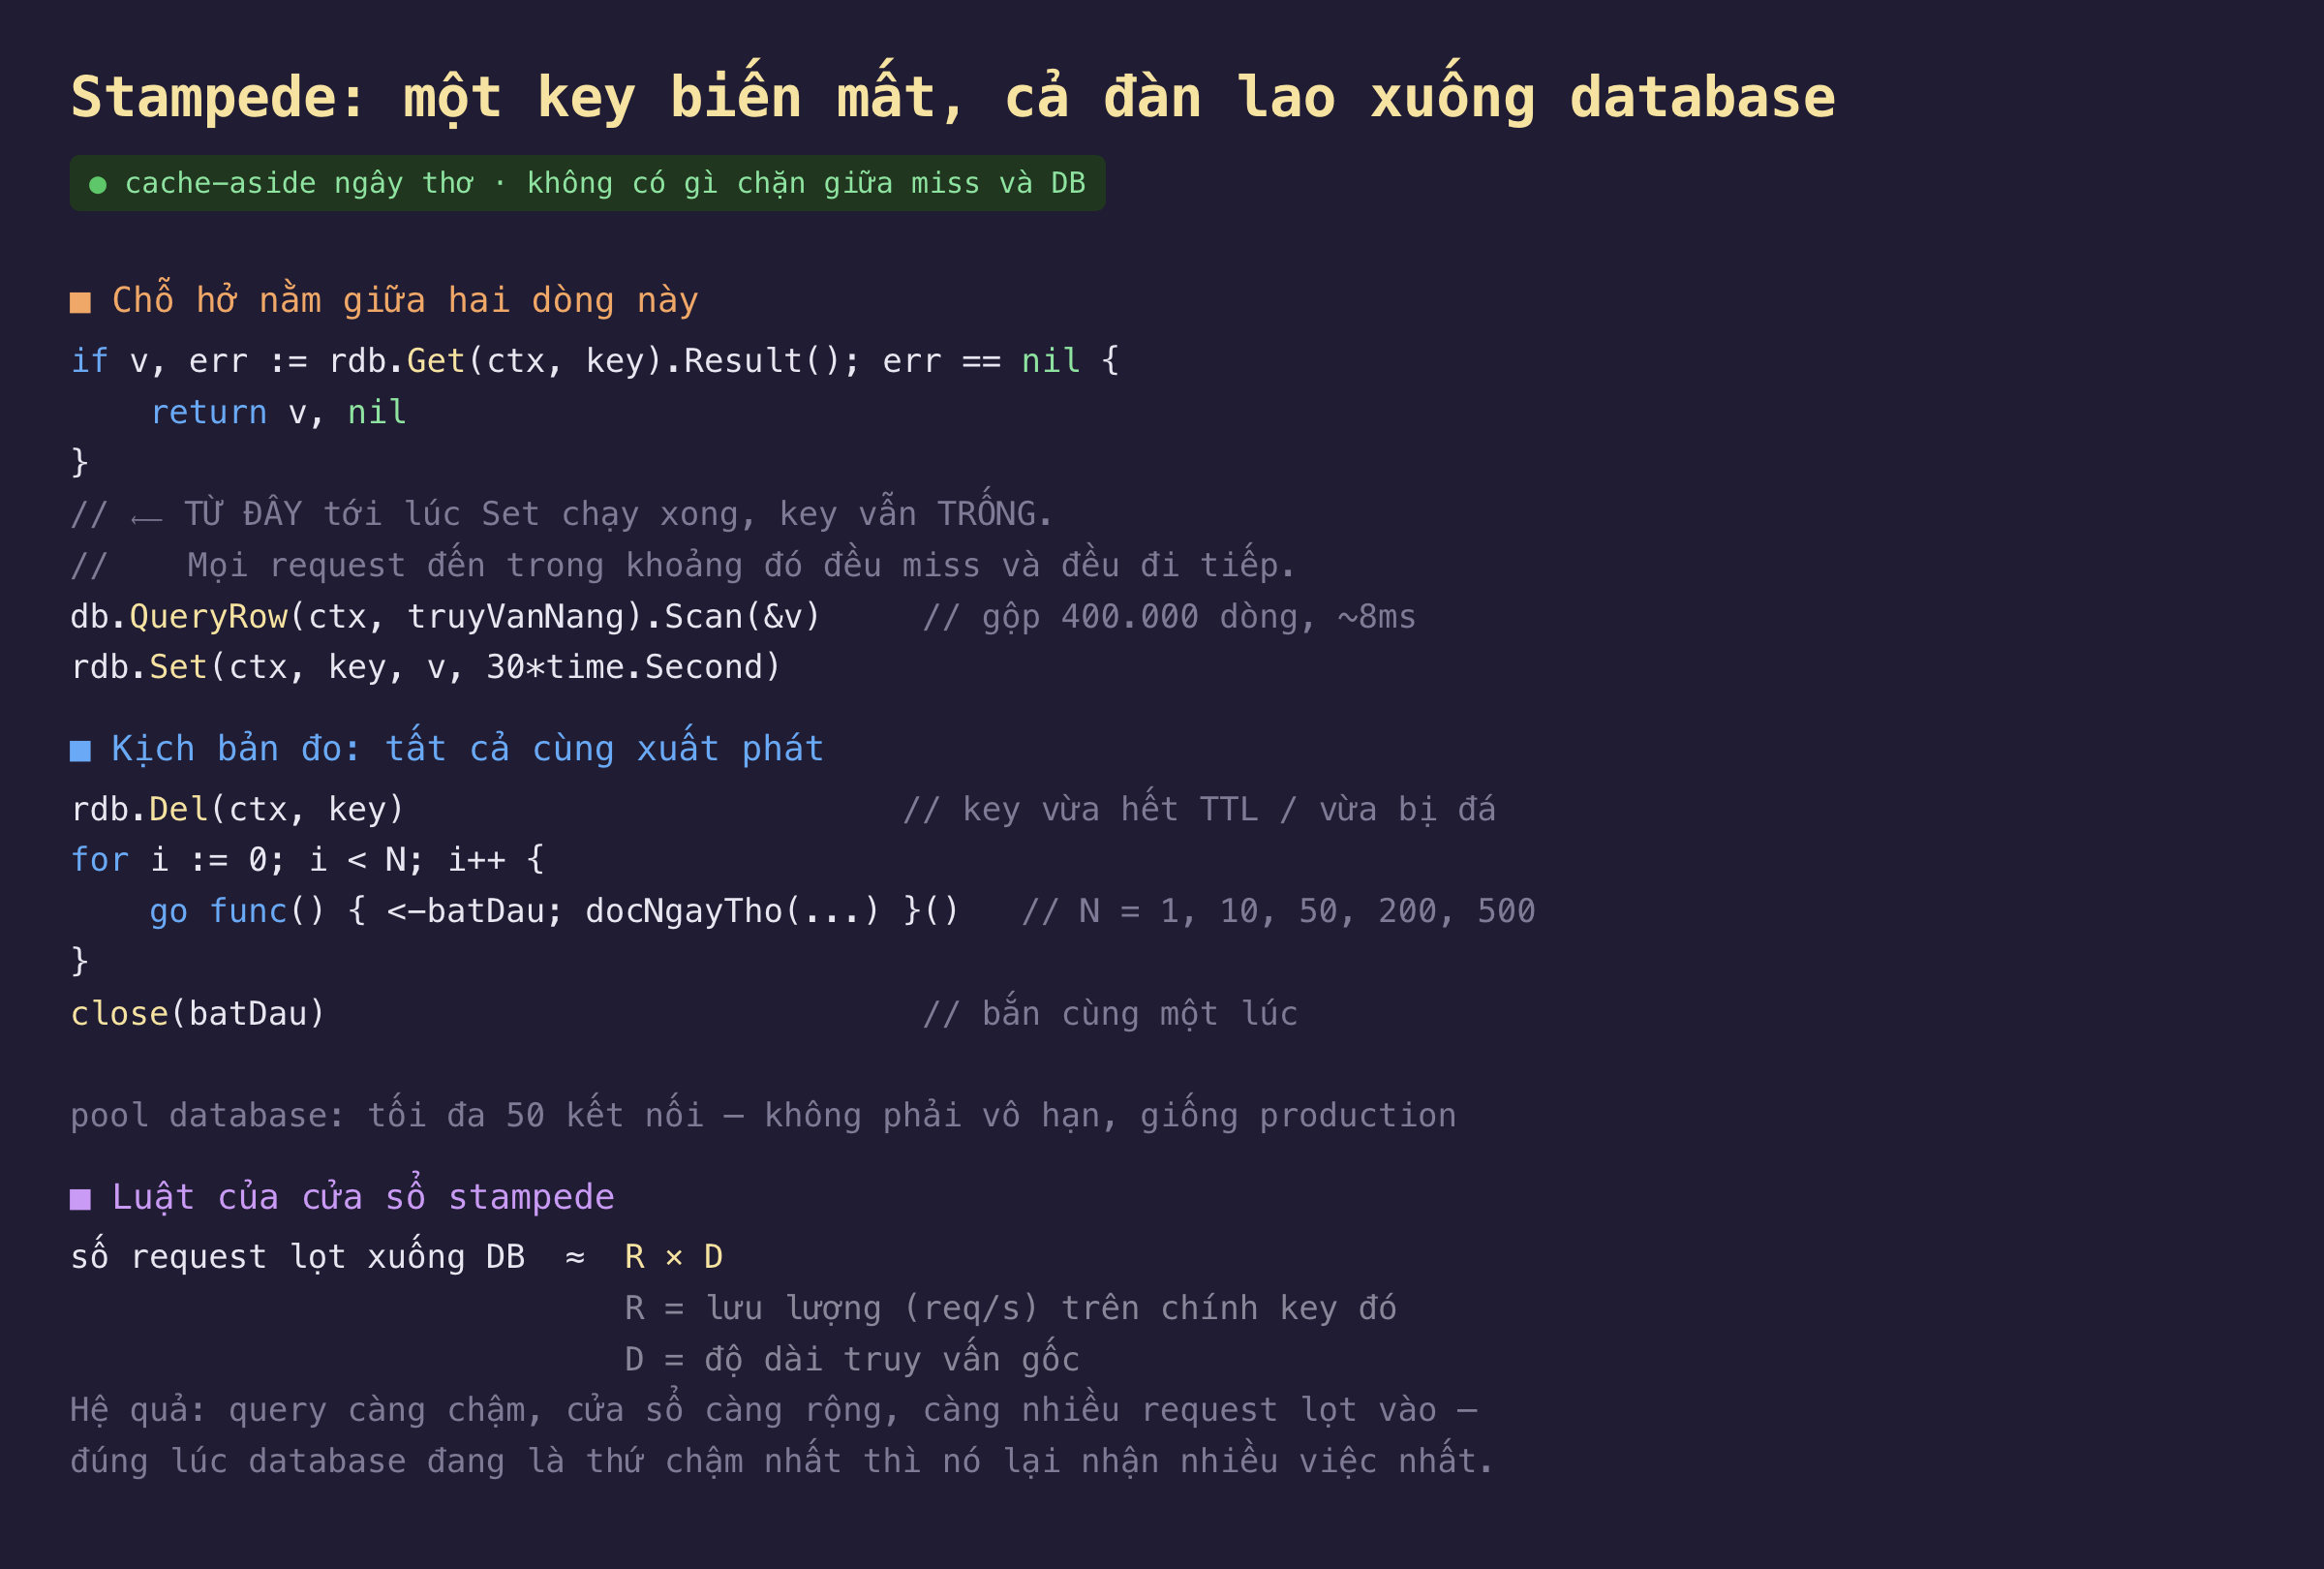
Hình 1: Chỗ hở là khoảng giữa Get trả về miss và Set ghi xong. Trong suốt khoảng đó — dài đúng bằng thời gian chạy truy vấn gốc — cache vẫn trống với mọi người đến sau.
Đoạn code ở Hình 1 chính là cache-aside từ phần 2, không sửa gì. Vấn đề không nằm ở một dòng viết sai; nó nằm ở chỗ mẫu cache-aside không có khái niệm "đã có người đang đi lấy". Mỗi request tự quyết định một mình, và tất cả cùng đưa ra đúng một quyết định tại cùng một thời điểm.
Từ đó rút ra được một luật đơn giản, đoán trước được số request sẽ lọt xuống database:
số request lọt xuống DB ≈ R × D, với R là lưu lượng (req/s) trên chính key đó và D là độ dài truy vấn gốc.
Luật này có một hệ quả khó chịu: truy vấn càng chậm, càng nhiều request lọt vào. Đúng lúc database đang là thứ chậm nhất trong hệ thống thì nó lại nhận về nhiều việc nhất. Đó là vòng xoáy, không phải sự cố tuyến tính.
Đo thật: 6,2ms khi một mình, 1119,1ms trong cơn stampede
Mình lấy đúng truy vấn gộp 400.000 dòng đánh giá, xoá key, rồi cho N goroutine cùng xuất phát bằng một channel đóng lại. Pool database giới hạn 50 kết nối — con số thật của một ứng dụng thật, không phải vô hạn.
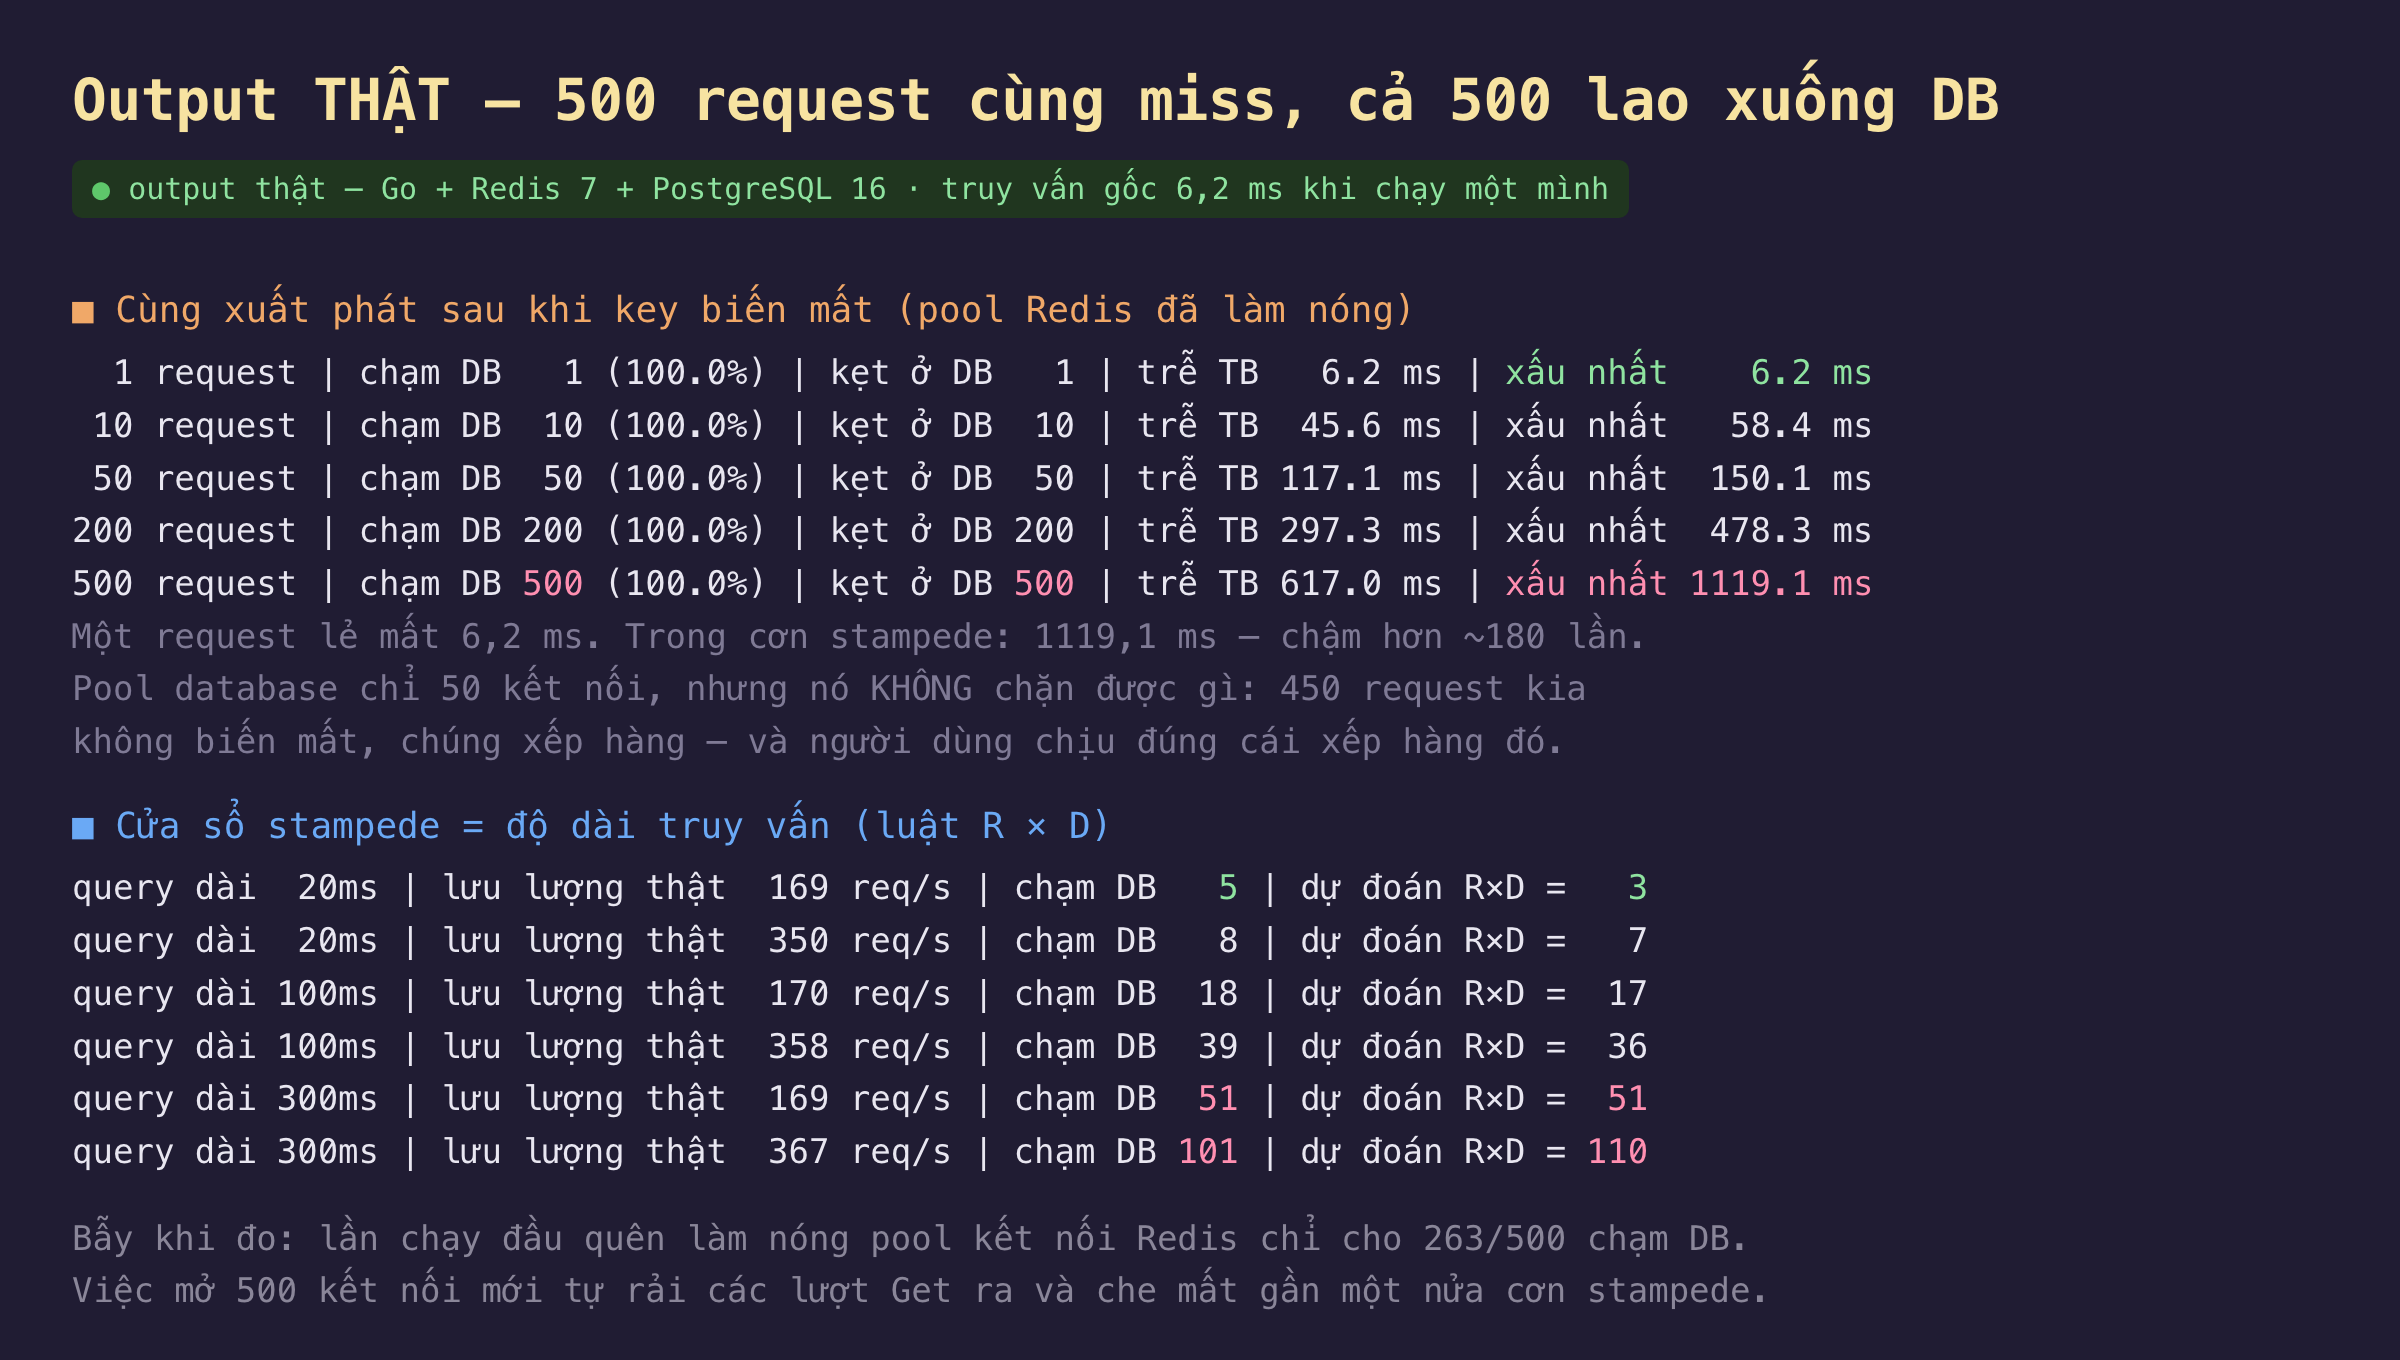
Hình 2: Kết quả thật. Hàng đầu là đường cơ sở — một request lẻ mất 6,2ms. Hàng cuối là cùng công việc đó dưới 500 request đồng thời: cả 500 đều chạm database và request xấu nhất chờ 1119,1ms.
- Tỉ lệ lọt xuống database là 100% ở mọi mức. Không có gì trong cache-aside ngăn request thứ hai đi tiếp khi request thứ nhất còn đang chạy — nên 500 request miss thì đúng 500 truy vấn giống hệt nhau đổ xuống database. Mười truy vấn giống nhau vẫn là mười lần quét 400.000 dòng; database không giảm giá cho bản sao.
- Chi phí không chia đều, nó nhân lên. Một request lẻ: 6,2ms. 10 request cùng lúc: trung bình đã 45,6ms — chậm hơn 7 lần chỉ với 10 người. 500 request: trung bình 617,0ms.
- Request xấu nhất chịu thiệt nhất: 1119,1ms so với 6,2ms — chậm hơn ~180 lần. Đây mới là con số người dùng cảm nhận. Phân bố lệch nặng: người đến sau xếp hàng sau cả pool kết nối lẫn CPU database.
Và đây là chỗ phải nói thẳng, vì nó phản bác một trực giác rất phổ biến: pool database 50 kết nối không hề chặn được stampede. Dễ nghĩ rằng giới hạn pool sẽ chặn ở 50 truy vấn. Không — nó chặn 50 truy vấn đồng thời, nhưng 450 request còn lại không biến mất, chúng xếp hàng rồi lần lượt chạy đúng truy vấn ấy. Tổng công việc database phải làm vẫn là 500 lần gộp 400.000 dòng; pool chỉ đổi "database quá tải" thành "request chậm", và 1119,1ms chính là cái giá của hàng đợi đó.
Một cái bẫy khi đo, đáng kể lại vì nó suýt dẫn mình tới kết luận sai. Lần chạy đầu tiên cho kết quả hiền lành hơn nhiều: chỉ 263/500 request chạm database, trễ xấu nhất 609,5ms, và mình đã tưởng pool database có công hãm bớt. Nguyên nhân thật nằm ở chỗ khác hẳn: pool kết nối của client Redis chưa được làm nóng. 500 goroutine cùng gọi Get buộc thư viện mở 500 kết nối TCP mới, và chính việc mở kết nối đó rải các lượt Get ra theo thời gian — tới lượt nhiều goroutine thì key đã được điền lại rồi. Thêm một vòng Ping làm nóng trước khi đo, con số nhảy lên đúng 100%. Bài học chung cho mọi phép đo đồng thời: thứ bạn chưa làm nóng sẽ âm thầm trở thành bộ điều tiết lưu lượng, và nó che mất chính hiện tượng bạn định đo.
Luật R × D, kiểm chứng bằng số
Phần đo thứ hai thay kiểu "tất cả cùng xuất phát" bằng mô hình thật hơn: request đến đều đặn theo một lưu lượng, key bị xoá ở thời điểm 0, truy vấn gốc có độ dài đặt trước bằng pg_sleep. Rồi đếm có bao nhiêu request lọt xuống database và so với dự đoán R × D:
| độ dài truy vấn | lưu lượng thật | chạm DB (đo) | R × D (dự đoán) |
|---|---|---|---|
| 20ms | 169 req/s | 5 | 3 |
| 20ms | 350 req/s | 8 | 7 |
| 100ms | 170 req/s | 18 | 17 |
| 100ms | 358 req/s | 39 | 36 |
| 300ms | 169 req/s | 51 | 51 |
| 300ms | 367 req/s | 101 | 110 |
Dự đoán bám sát số đo trên cả dải. Điều đó biến stampede từ "một chuyện xui rủi thỉnh thoảng xảy ra" thành một đại lượng tính được trước khi lên production. Nếu một key nhận 2.000 req/s và truy vấn gốc mất 200ms, bạn biết chắc là sẽ có khoảng 400 truy vấn đồng thời đổ xuống database mỗi lần key đó hết hạn — không cần đợi sự cố để biết con số ấy.
Luật này cũng chỉ thẳng hai hướng sửa, và đó chính là nội dung phần sau: giảm R (chỉ cho một request đi lấy, số còn lại chờ hoặc dùng bản cũ) hoặc giảm D (làm truy vấn gốc nhanh hơn). Hướng thứ nhất hiệu quả hơn rất nhiều vì nó kéo R từ hàng trăm xuống 1.
Đánh đổi cần cân nhắc
Nhiễu TTL ở phần 3 không chữa được stampede. Rất dễ nhầm hai thứ. Nhiễu TTL giải quyết việc nhiều key khác nhau hết hạn cùng lúc — nó trải các mốc hết hạn ra. Stampede ở đây là nhiều request trên cùng một key: dù key đó hết hạn vào lúc nào, vẫn có đúng chừng ấy request đang hỏi nó tại thời điểm ấy. Hai vấn đề, hai cách chữa, và cần cả hai.
Giới hạn pool kết nối không phải phương án chống stampede. Phép đo cho thấy pool 50 vẫn để cả 500 truy vấn chạy, chỉ là tuần tự hoá chúng. Hãm bằng hàng đợi đổi "database quá tải" thành "request chậm"; nếu hàng đợi không có giới hạn thì còn đổi tiếp thành "hết bộ nhớ ứng dụng". Pool là thứ phải có để bảo vệ database khỏi sập, nhưng nó không giảm được một đơn vị công việc nào. Phòng thủ thật phải nằm trước database, ở tầng cache.
Stampede chỉ đáng lo với key nóng và truy vấn đắt. Nếu một key chỉ nhận 2 req/s, R × D cho 0,02 — tức gần như không bao giờ có hai request cùng miss. Thêm cơ chế chống stampede cho mọi key là thêm phức tạp vào 99% chỗ không cần. Tính R × D cho từng nhóm key trước, rồi chỉ bảo vệ những nhóm có tích số lớn.
Số đo ở đây là một tiến trình, một máy. Production thường có nhiều instance ứng dụng, nên stampede cộng dồn qua các instance — 10 instance mỗi cái 50 request đồng thời là 500 truy vấn, trong khi mỗi instance nhìn vào log của mình chỉ thấy 50. Hệ quả quan trọng cho phần sau: một sync.Mutex hay singleflight trong tiến trình chỉ gom được stampede trong một instance; muốn gom toàn cụm phải dùng khoá nằm ở Redis.
Ba ý mang về
- Cache-aside không biết "đã có người đang đi lấy": giữa lúc
Gettrả miss và lúcSetghi xong, key vẫn trống với mọi người đến sau — đo thật 500 request cùng miss thì cả 500 chạm database, và request xấu nhất mất 1119,1ms so với 6,2ms khi chạy một mình (~180 lần). - Quy mô stampede tính trước được bằng R × D (lưu lượng trên key × độ dài truy vấn): đo 51 so với dự đoán 51, 101 so với 110, 18 so với 17. Query càng chậm cửa sổ càng rộng — database nhận nhiều việc nhất đúng lúc nó yếu nhất.
- Giới hạn pool kết nối không chặn được stampede, chỉ xếp hàng nó lại: pool 50 vẫn để cả 500 truy vấn chạy, chỉ là lần lượt — tổng công việc database không đổi, còn người dùng chịu đủ 1119,1ms. Phòng thủ thật phải nằm ở tầng cache, trước database.
Nguồn
- Redis docs — Client-side caching & cache patterns: https://redis.io/docs/latest/develop/clients/patterns/
- AWS Builders' Library — Caching challenges and strategies (phần thundering herd): https://aws.amazon.com/builders-library/caching-challenges-and-strategies/
- Vattani, Chierichetti, Lowenstein — Optimal Probabilistic Cache Stampede Prevention (VLDB 2015)
- PostgreSQL docs — pg_sleep: https://www.postgresql.org/docs/current/functions-datetime.html
Phần sau ta chặn chính cơn stampede vừa đo: khoá trong tiến trình bằng singleflight, và khoá toàn cụm bằng SET NX trên Redis. Đo lại cùng kịch bản 500 request để xem con số 500 lượt chạm database rút xuống còn bao nhiêu.
