Phần trước kết luận hit ratio là thước đo mù trước nhiều chuyện. Đây là chuyện mù nhất: một key duy nhất hút phần lớn lưu lượng. Hit ratio vẫn 100% — key đó luôn có trong cache. Miss trên giây vẫn bằng 0. Tải database vẫn bằng 0. Mọi biểu đồ đều xanh. Mà một node Redis nóng rực, độ trễ p99 leo thang, còn các node khác trong cụm ngồi chơi.
Vì sao một key nóng không chia tải được
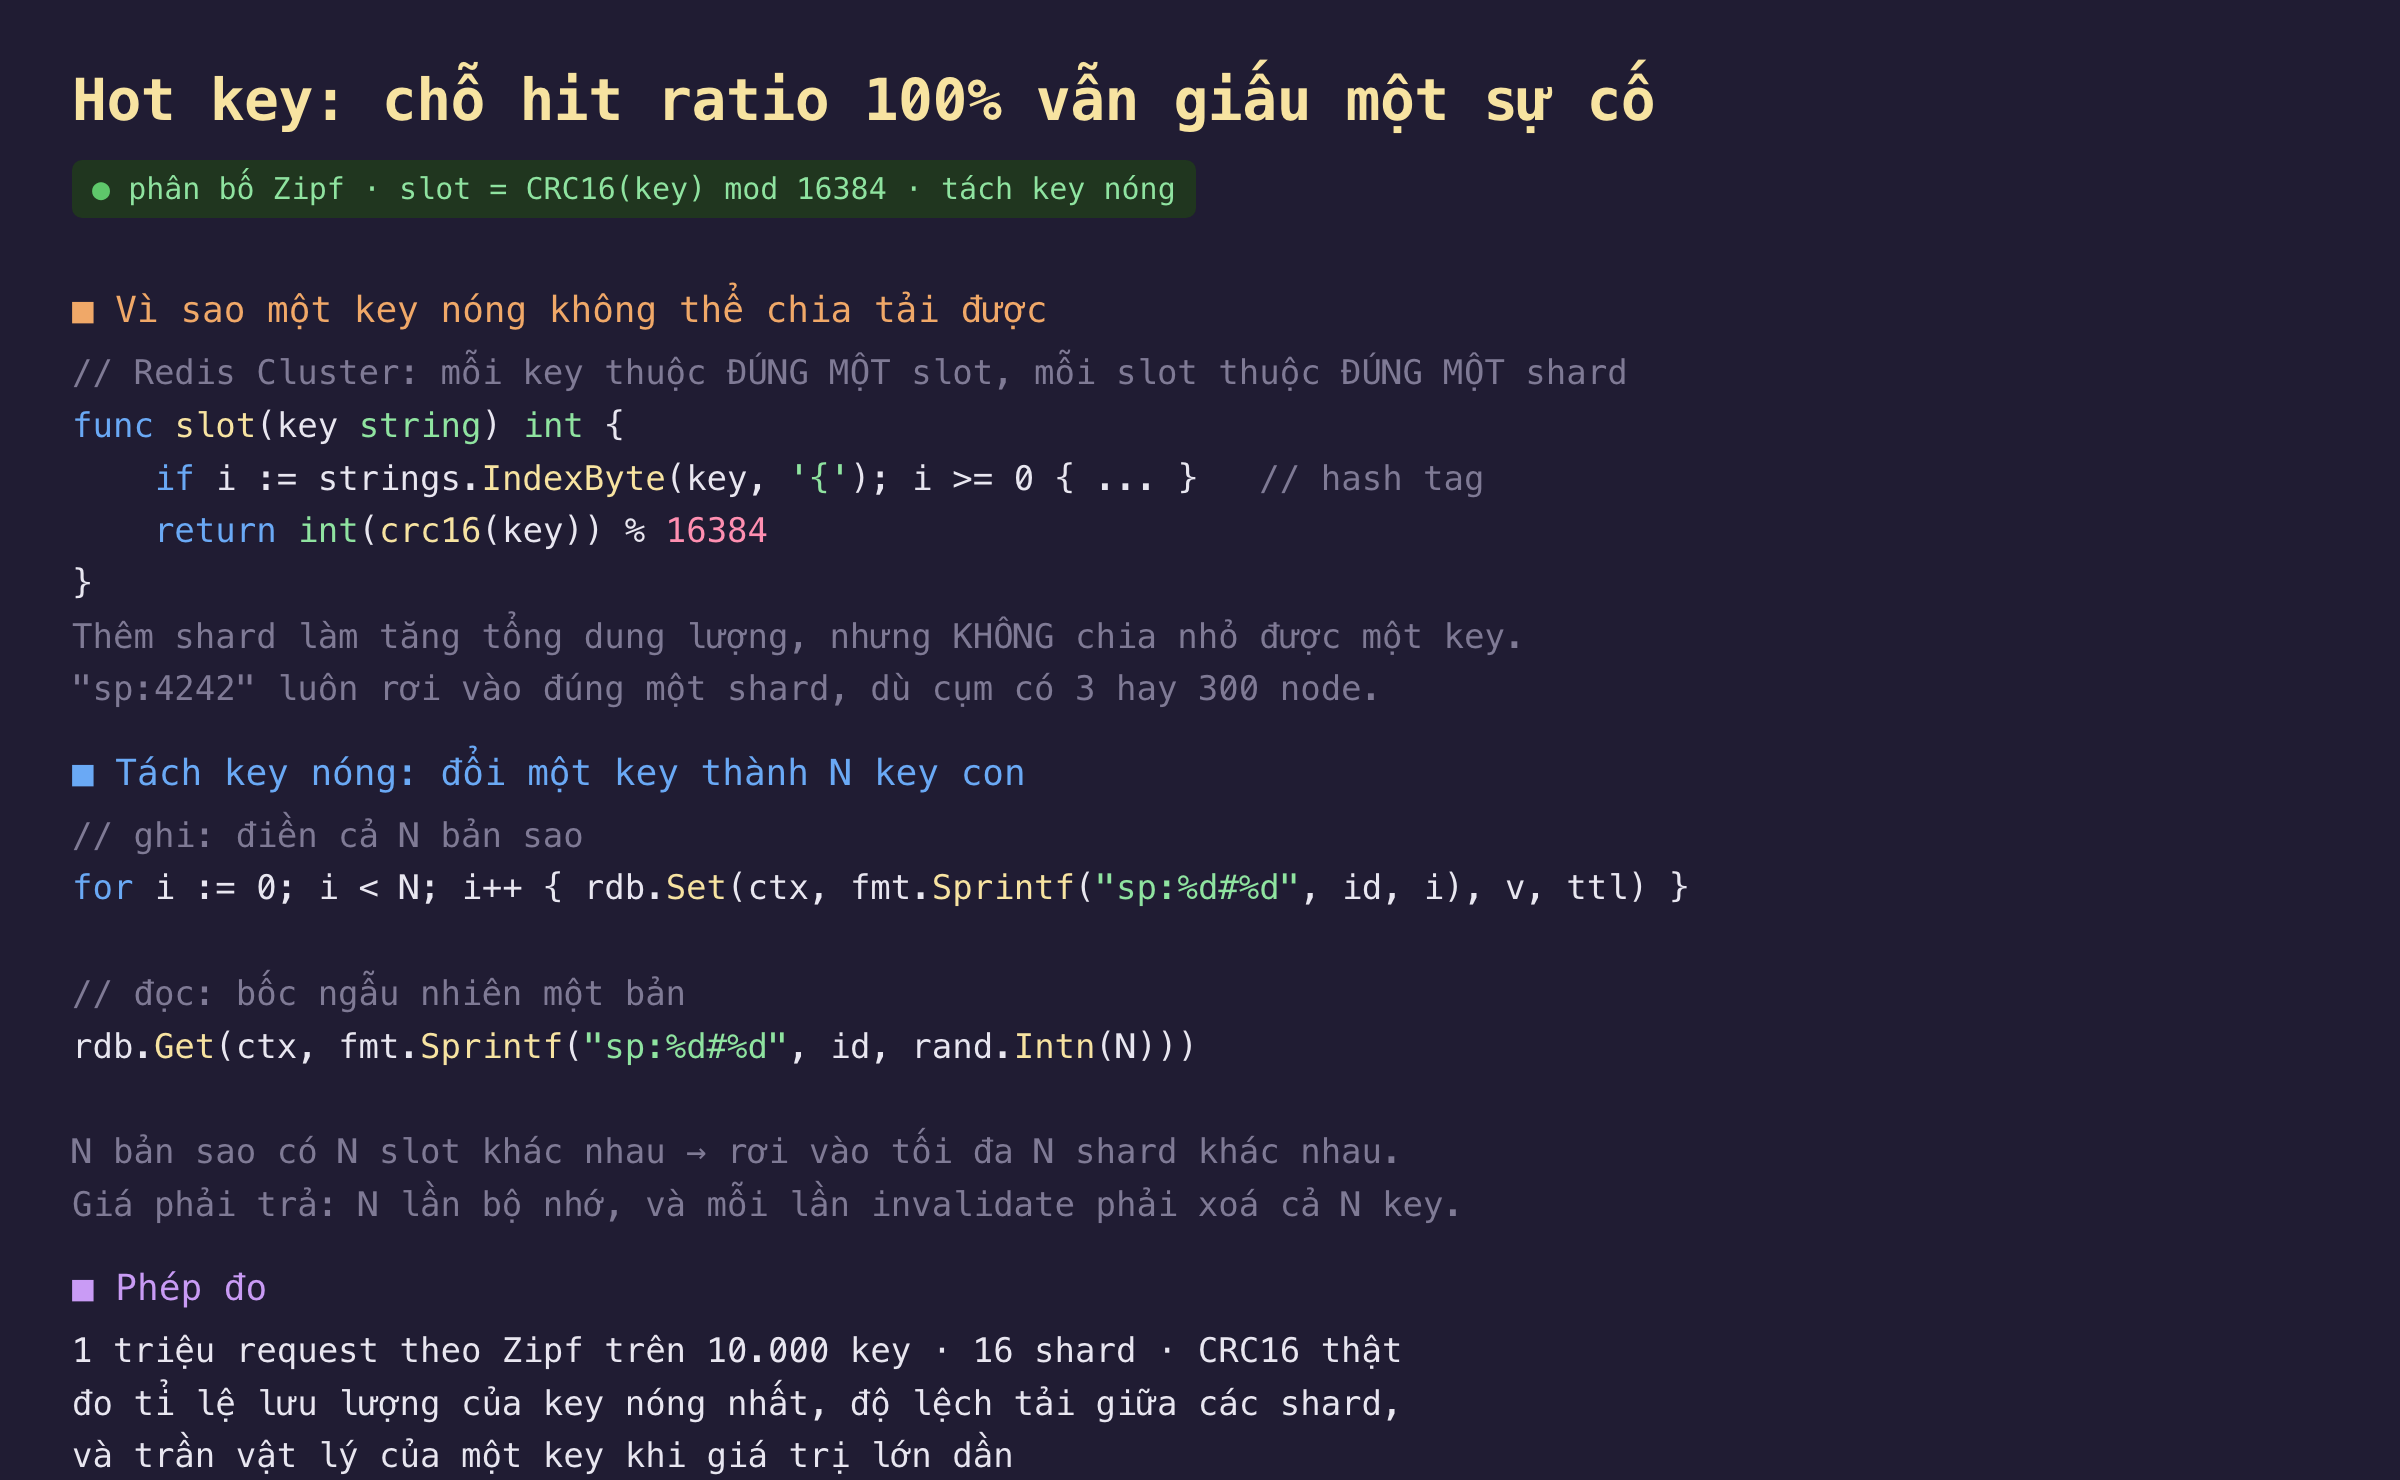
Hình 1: Cơ chế gán key vào shard, và cách tách key nóng. slot ở đây là đúng thuật toán Redis Cluster dùng — CRC16-CCITT rồi chia dư 16384, có xử lý hash tag {...}.
Cơ chế này là nguồn gốc của vấn đề. Redis Cluster băm key thành một trong 16.384 slot, mỗi slot thuộc về đúng một shard. Hệ quả: thêm shard làm tăng tổng dung lượng nhưng không chia nhỏ được một key. Cụm 3 node hay 300 node thì sp:4242 vẫn nằm trên đúng một node, và node đó là trần của cả hệ thống cho key ấy.
Đây là lý do hot key khác hẳn mọi vấn đề dung lượng khác trong loạt bài này: nó không giải được bằng cách thêm máy.
Đo thật: 20,81% lưu lượng vào một key, 4,44× tải lên một shard
Lưu lượng thật không bao giờ rải đều. Mình sinh 1 triệu request theo phân bố Zipf — mô hình chuẩn cho lượt truy cập web, và cũng là thứ đứng sau mọi "bài viết bỗng lên top" — rồi tính slot thật của từng key:
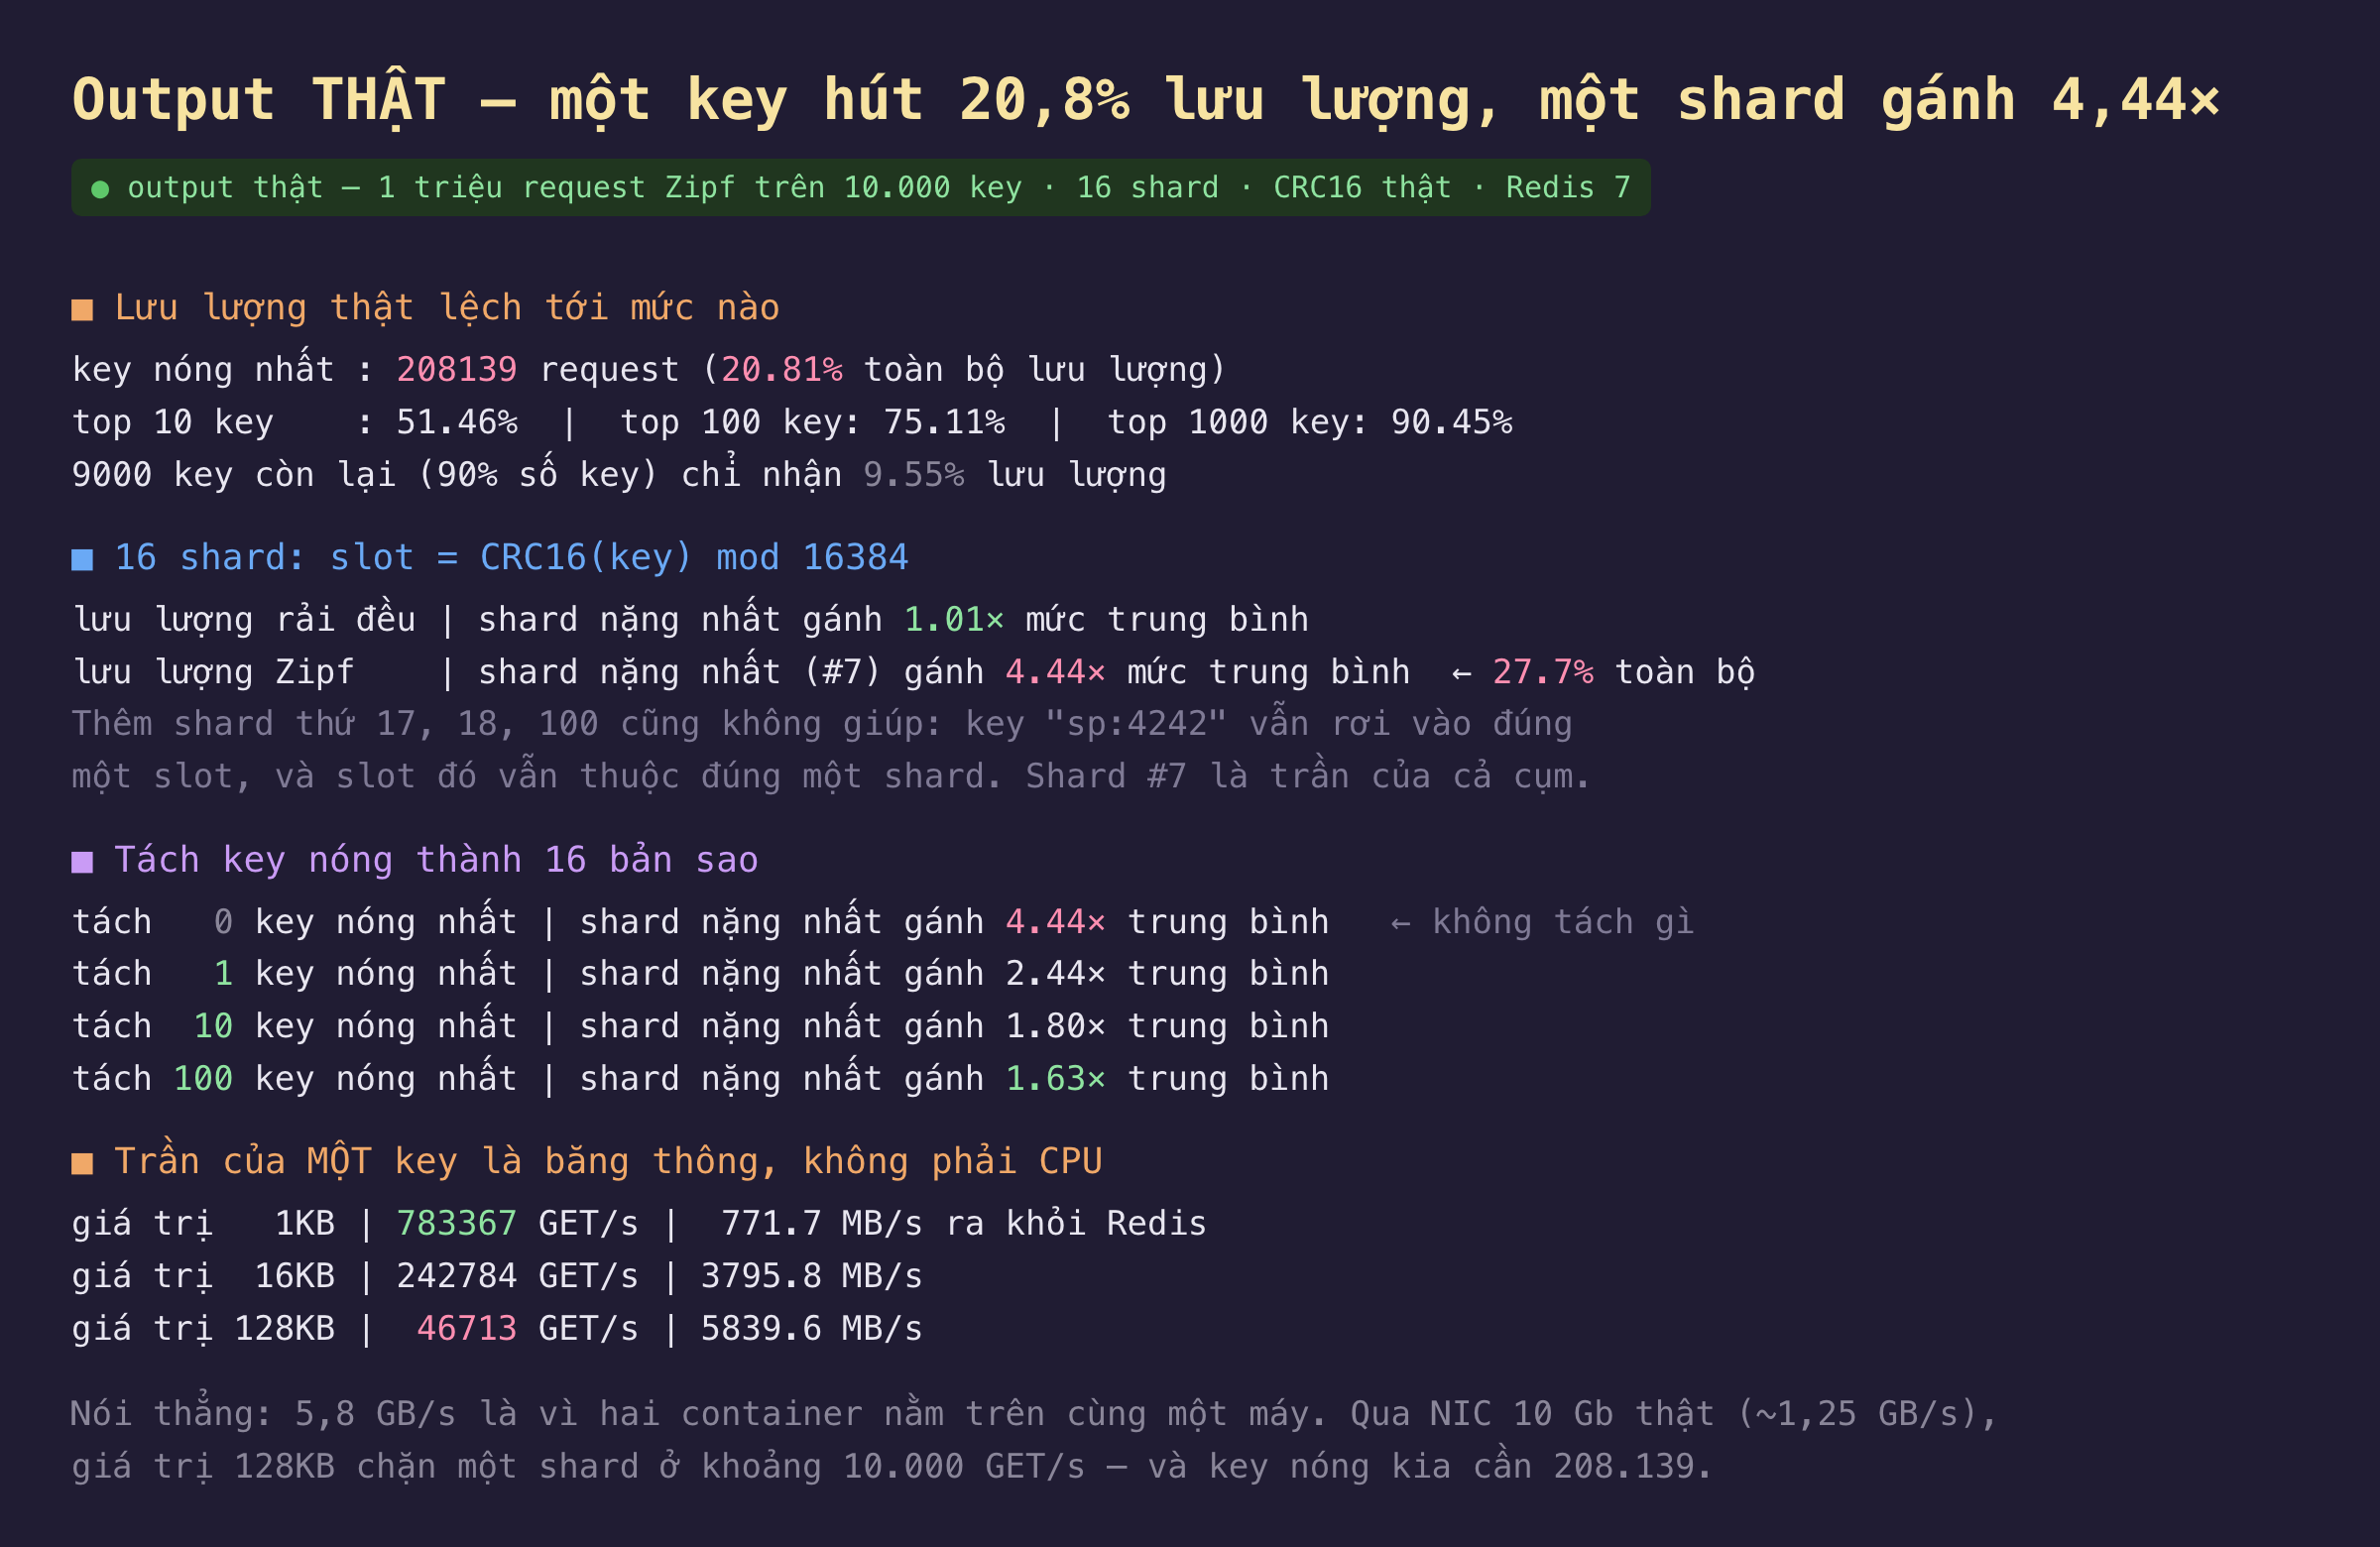
Hình 2: Kết quả thật. Ba tầng của cùng một vấn đề: lưu lượng lệch, lệch đó dồn vào một shard, và shard đó có trần vật lý.
Lưu lượng lệch nhiều hơn người ta tưởng. Key nóng nhất nhận 208.139/1.000.000 request — 20,81% toàn bộ lưu lượng vào đúng một key. Top 10 key chiếm 51,46%, tức mười key gánh hơn nửa hệ thống. Còn 9.000 key ở đuôi — 90% số key — chia nhau vỏn vẹn 9,55%. Đây không phải trường hợp bệnh lý; đây là hình dạng bình thường của lưu lượng thật.
Độ lệch đó không bị san phẳng khi chia shard. Với lưu lượng rải đều, 16 shard cân nhau gần như hoàn hảo: shard nặng nhất gánh 1,01× mức trung bình — CRC16 băm rất tốt. Với lưu lượng Zipf, shard nặng nhất gánh 4,44× mức trung bình và ôm 27,7% toàn bộ request. Cùng một hàm băm, cùng một cách chia slot; khác biệt nằm hoàn toàn ở phân bố lưu lượng, thứ mà hàm băm không biết gì về nó.
Chi tiết đáng nhớ: băm key rất đều và tải rất lệch là hai chuyện độc lập. Hàm băm chia đều số lượng key, không chia đều số lượng request.
Trần của một shard là băng thông, không phải CPU. Bảng cuối đo thông lượng GET trên một key duy nhất với ba cỡ giá trị: 1KB cho 783.367 GET/s, 16KB cho 242.784, 128KB chỉ còn 46.713. Thông lượng lệnh giảm 17 lần trong khi lượng byte ra khỏi Redis vẫn tăng — tức là cái chạm trần là đường truyền, không phải sức tính.
Và phải nói thẳng con số 5,8 GB/s kia: nó cao như vậy vì hai container nằm trên cùng một máy, đi qua loopback. Qua một NIC 10 Gb thật (~1,25 GB/s), giá trị 128KB chặn một shard ở khoảng 10.000 GET/s. Key nóng trong phép đo cần 208.139. Khoảng cách đó không đóng được bằng phần cứng nhanh hơn — chỉ bằng cách không gửi từng ấy byte.
Tách key nóng: hiệu quả, nhưng giảm dần
Cách chữa trực tiếp nhất là biến một key nóng thành N key con sp:4242#0 … sp:4242#15, ghi cả N bản, đọc một bản ngẫu nhiên. N bản có N slot khác nhau nên trải ra tối đa N shard.
| tách | shard nặng nhất gánh |
|---|---|
| không tách | 4,44× |
| 1 key nóng nhất × 16 bản | 2,44× |
| 10 key nóng nhất × 16 bản | 1,80× |
| 100 key nóng nhất × 16 bản | 1,63× |
Tách đúng một key đã cắt gần một nửa độ lệch (4,44× → 2,44×) — hợp lý, vì key đó chiếm 20,81% lưu lượng. Nhưng dừng ở đó thì key nóng thứ hai trở thành vấn đề mới, nên phải tách 10 key mới xuống 1,80×.
Và tách tới 100 key chỉ còn cải thiện được tới 1,63% — hiệu quả giảm dần rõ rệt. Lý do: phân bố Zipf không có điểm cắt tự nhiên; sau 100 key nóng vẫn còn 900 key tương đối nóng. Đuổi theo đuôi đó là công việc không có điểm dừng, và mỗi key tách ra lại nhân chi phí bộ nhớ lẫn chi phí invalidation lên 16 lần. Tách vài key nóng nhất lấy phần lớn lợi ích; tách tiếp là trả giá nhiều hơn nhận.
Đánh đổi cần cân nhắc
Tách key nhân chi phí invalidation lên N lần, và mở lại khe hở của phần 7. Xoá một key nóng giờ là xoá 16 key, và 16 lệnh Del đó không nguyên tử: giữa lệnh thứ 3 và thứ 4, một số người đọc thấy giá mới, số khác thấy giá cũ. Với dữ liệu chịu được hơi cũ thì không sao; với dữ liệu cần nhất quán thì tách key là một đánh đổi về tính đúng đắn, không chỉ về bộ nhớ.
Cách chữa tốt hơn cho hầu hết trường hợp là đừng gửi request tới Redis. Một key chiếm 20,81% lưu lượng cũng có nghĩa là cùng một giá trị được gửi qua mạng 208.139 lần. Giữ nó trong bộ nhớ tiến trình với TTL vài giây thì lưu lượng tới Redis cho key đó giảm xuống gần bằng số instance — rẻ hơn tách key rất nhiều, và không đụng tới chuyện invalidation nhiều bản. Đó chính là chủ đề phần sau.
Hash tag là con dao hai lưỡi. Redis Cluster cho phép ép nhiều key vào cùng một slot bằng {...} — tiện khi cần MGET nhiều key trong một lệnh, vì lệnh đa key chỉ chạy được trong cùng một slot. Nhưng hash tag cũng là cách tự tạo ra hot shard: gom user:{123}:* vào một slot nghĩa là mọi lưu lượng của người dùng đó dồn vào một node. Dùng hash tag khi cần gom lệnh, và biết rằng mình vừa từ bỏ việc chia tải cho nhóm key đó.
Số đo ở đây là mô phỏng phân bố và tính slot, không phải một cụm Redis Cluster thật. Hàm slot dùng đúng CRC16-CCITT và phép chia dư 16384 của Redis, và cách chia dải slot cho 16 shard là cách redis-cli --cluster create chia mặc định — nên bản đồ key → shard là thật. Nhưng độ lệch thực tế trên một cụm thật còn phụ thuộc replica đọc, client routing và việc di chuyển slot. Riêng bảng thông lượng ở mục cuối là đo trên Redis 7 thật, chỉ là qua loopback.
Ba ý mang về
- Lưu lượng thật lệch tới mức một key chiếm 20,81% và top 10 key chiếm 51,46% — trong khi 90% số key chia nhau 9,55%. Hàm băm chia đều số key, không chia đều số request, nên 16 shard vẫn có shard gánh 4,44× mức trung bình.
- Hot key không giải được bằng cách thêm máy: một key thuộc đúng một slot, slot thuộc đúng một shard, nên shard đó là trần của cả cụm. Và trần của nó là băng thông: đo thật 783.367 GET/s với giá trị 1KB nhưng chỉ 46.713 với giá trị 128KB.
- Tách key nóng hiệu quả nhưng giảm dần: 4,44× → 2,44× khi tách một key, → 1,80× khi tách 10, → 1,63× khi tách 100. Lấy vài key nóng nhất là đủ; mỗi key tách ra nhân bộ nhớ và chi phí invalidation lên N lần, và 16 lệnh
Delkhông nguyên tử.
Nguồn
- Redis docs — Cluster specification (CRC16, 16384 slot, hash tag): https://redis.io/docs/latest/operate/oss_and_stack/reference/cluster-spec/
- Redis docs — INFO (total_net_output_bytes): https://redis.io/docs/latest/commands/info/
- Lada Adamic, Bernardo Huberman — Zipf's law and the Internet (2002)
- Facebook — Scaling Memcache at Facebook (NSDI'13), phần hot key và replication
Phần sau ta làm đúng cái gợi ý ở trên: thêm một tầng cache trong bộ nhớ tiến trình trước Redis. Đo thật độ trễ tầng local so với Redis, lưu lượng Redis giảm bao nhiêu, và cái giá của việc mỗi instance có một bản dữ liệu riêng có thể lệch nhau.
