Phần trước kết thúc bằng một gợi ý: cách rẻ nhất để chữa một key nóng không phải là tách nó ra, mà là đừng gửi request tới Redis. Một key chiếm 20,81% lưu lượng nghĩa là cùng một giá trị bị kéo qua mạng hai trăm nghìn lần. Bài này làm đúng chuyện đó — thêm một tầng cache trong bộ nhớ tiến trình — và đo xem nó đáng tới đâu.
L1 là một map có TTL, không cần gì hơn
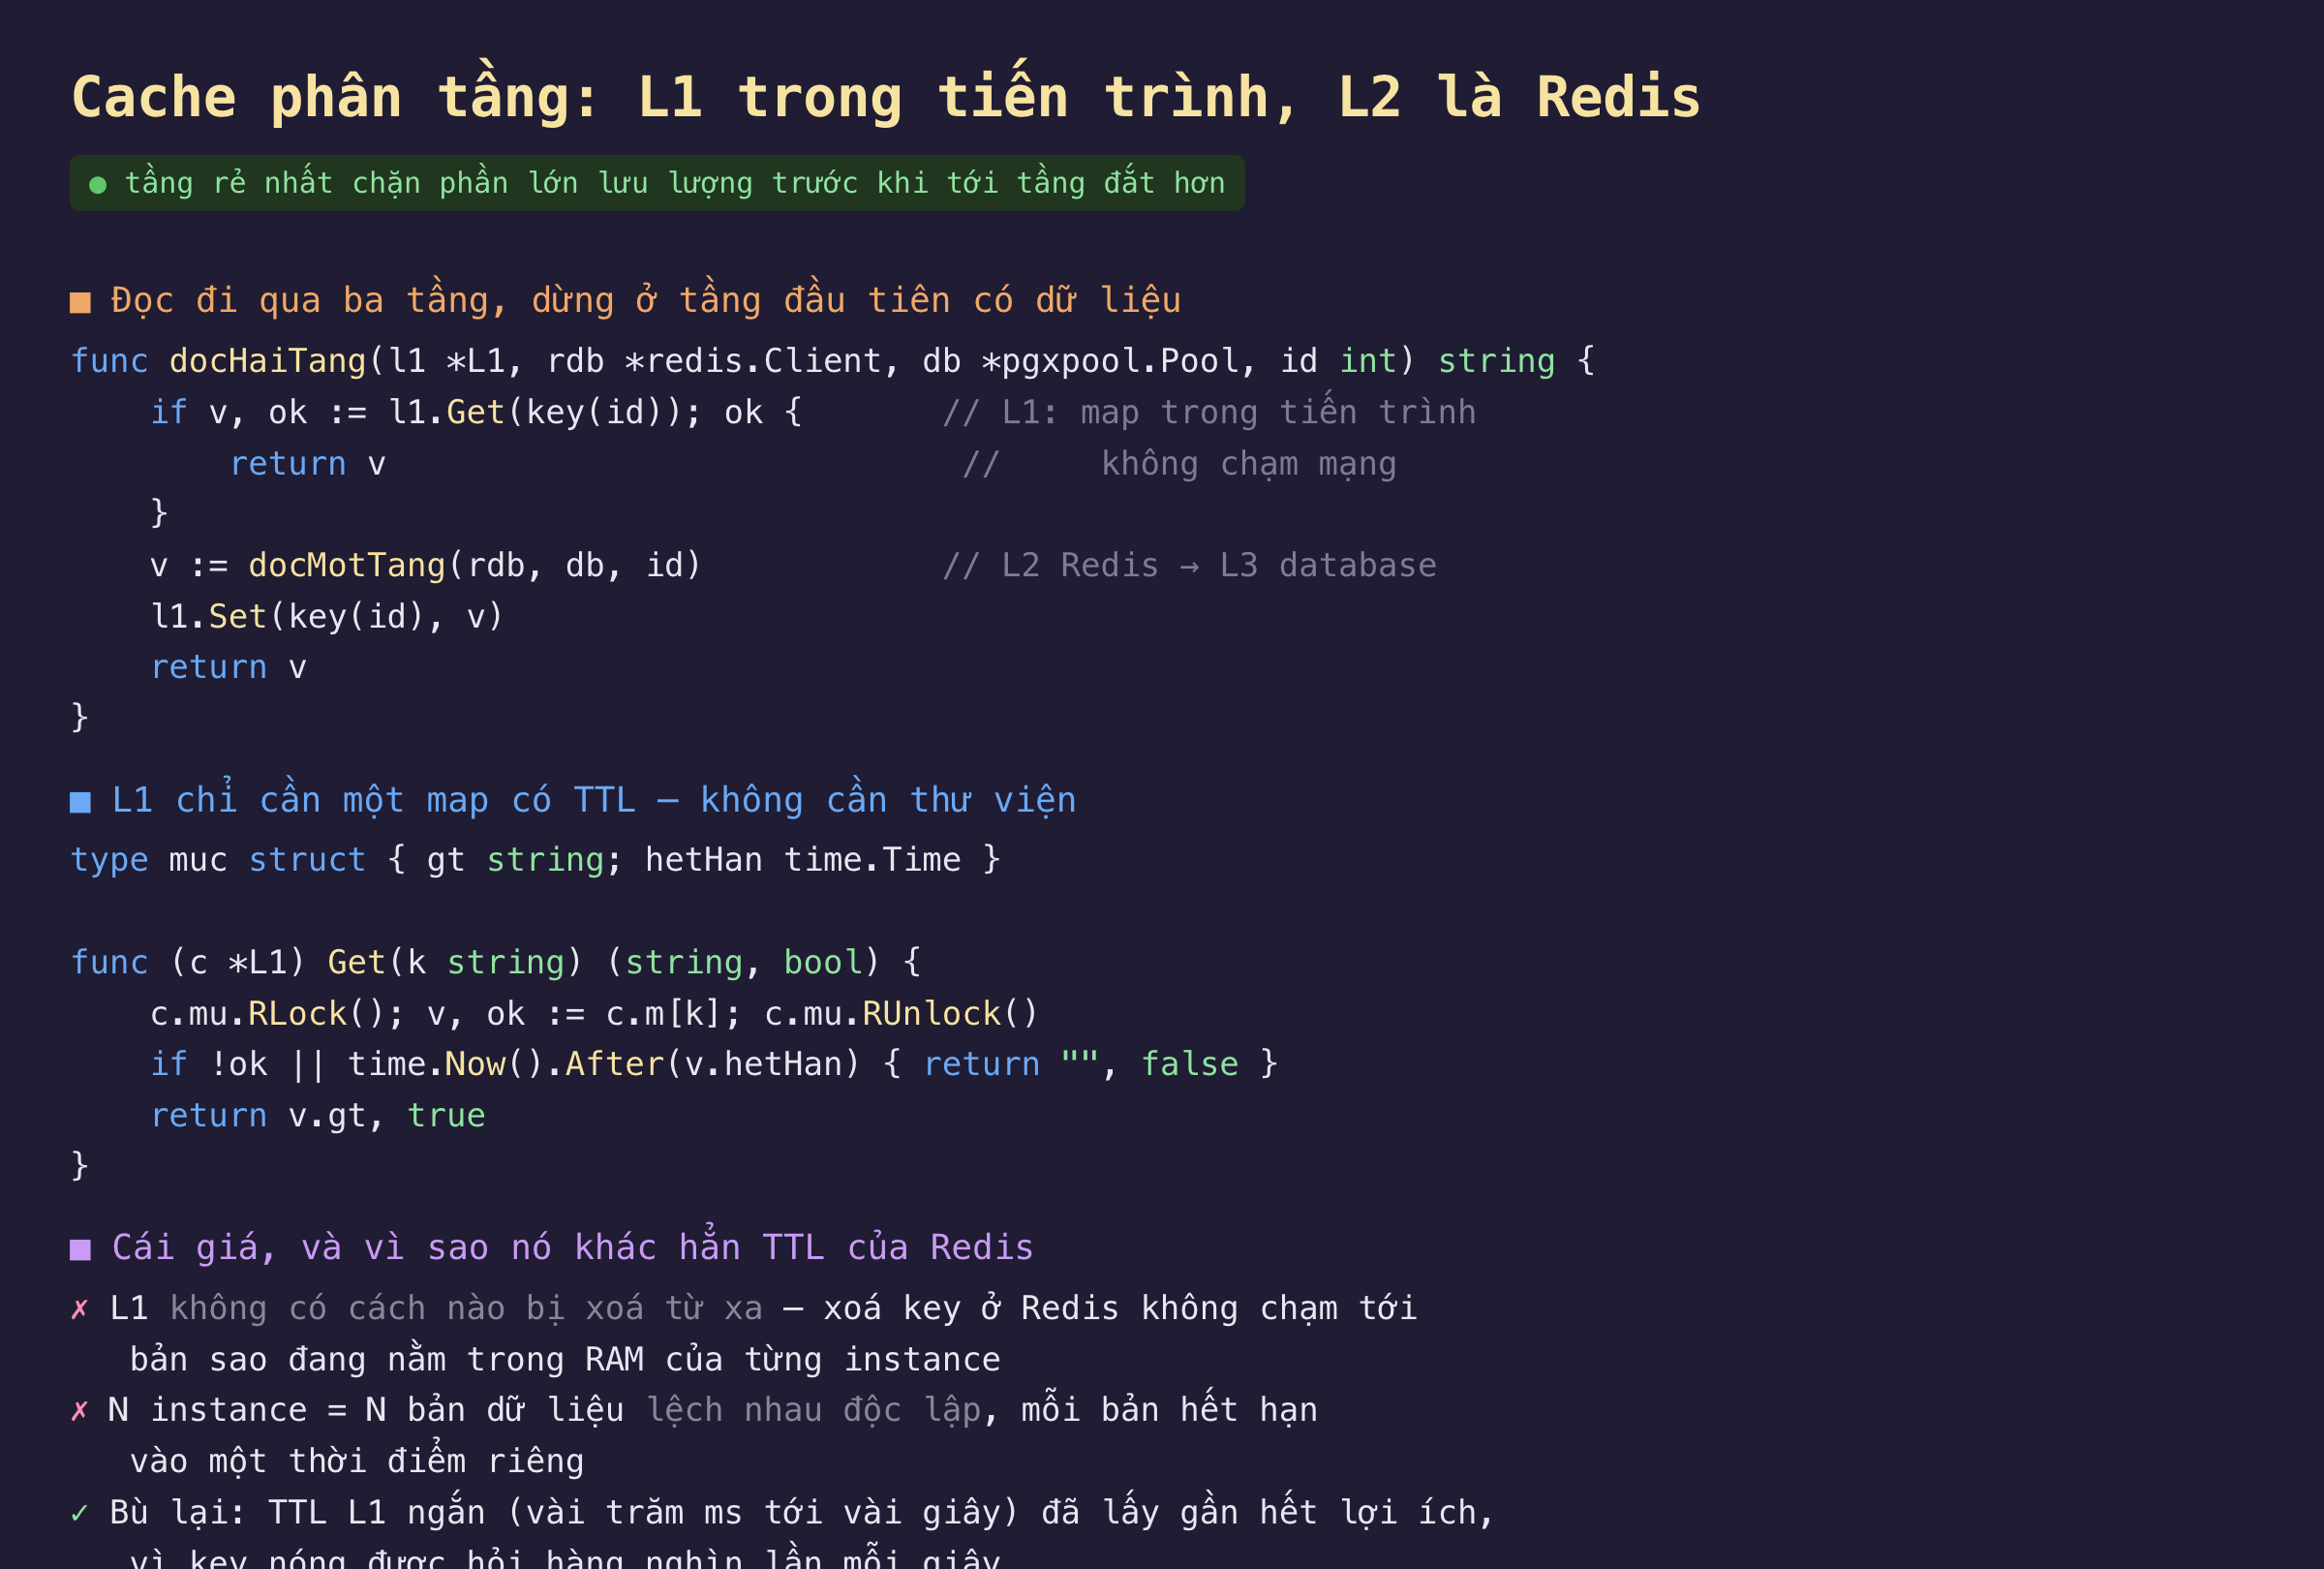
Hình 1: Tầng L1 và cái giá của nó. Toàn bộ L1 là một map[string]muc có RWMutex và mốc hết hạn — không cần thư viện, không cần cấu hình.
Nguyên tắc của cache phân tầng giống hệt nguyên tắc chống stampede ở phần 6: tầng rẻ nhất chặn phần lớn lưu lượng trước khi nó tới tầng đắt hơn. Ở đây "đắt hơn" không có nghĩa tốn tiền hơn, mà là phải vượt qua ranh giới mạng.
Và đó cũng là chỗ L1 khác hẳn Redis về bản chất, không chỉ về tốc độ: không ai xoá được L1 từ xa. Xoá key trên Redis không chạm tới bản sao đang nằm trong RAM của từng instance. Với N instance, bạn có N bản dữ liệu độc lập, mỗi bản hết hạn vào một thời điểm riêng. Toàn bộ cơ chế invalidation dựng công phu ở phần 7 không với tới tầng này.
Đo thật: 300.000 lượt tới Redis còn 7.438
Mình dùng lại đúng lưu lượng của phần 10 — 300.000 request phân bố Zipf trên 10.000 key — và cho mỗi biến thể bắt đầu từ Redis trống để so cho công bằng:
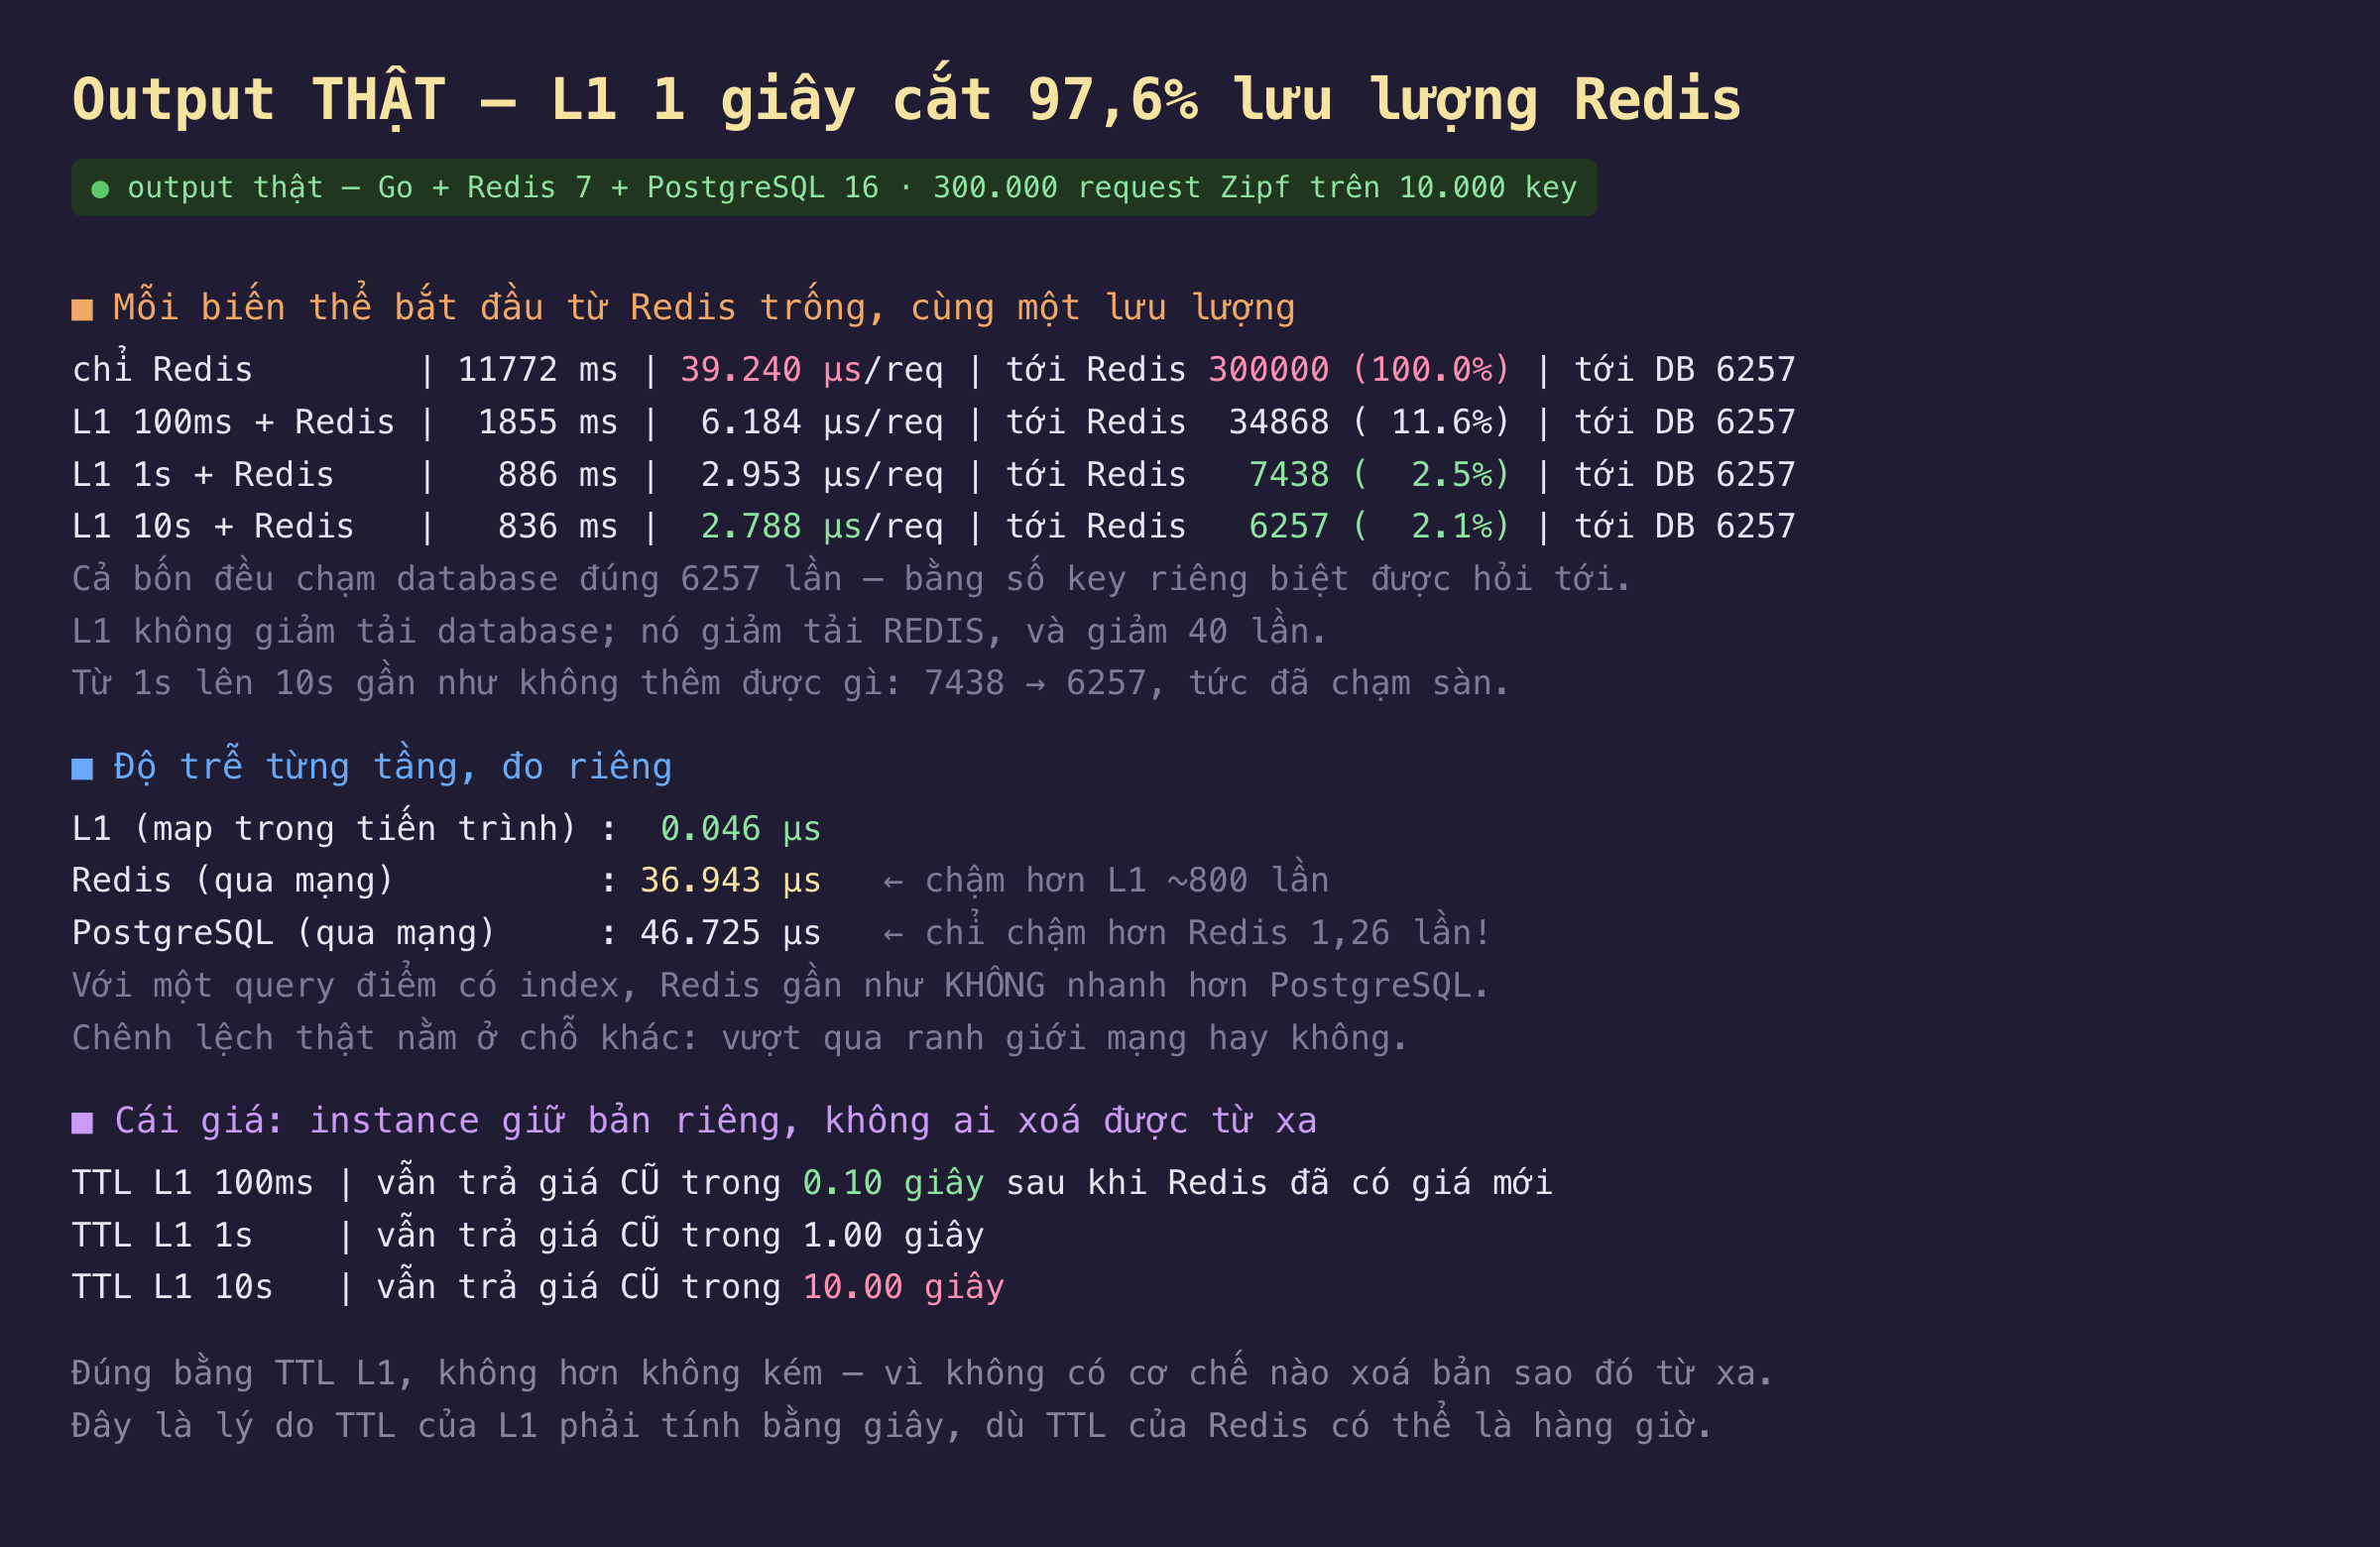
Hình 2: Kết quả thật. Ba bảng: lưu lượng Redis giảm bao nhiêu, mỗi tầng nhanh chậm ra sao, và cái giá phải trả tính bằng giây.
L1 với TTL 1 giây cắt 97,6% lưu lượng Redis — từ 300.000 xuống 7.438 lượt — và kéo độ trễ trung bình từ 39,240µs xuống 2,953µs, tức nhanh hơn 13 lần. Với TTL chỉ 100ms, con số đã là 11,6% (giảm gần 9 lần). Lý do TTL ngắn vẫn hiệu quả nằm ở chính độ lệch của lưu lượng: key nóng được hỏi hàng nghìn lần mỗi giây, nên cache nó trong một giây đã gom được hàng nghìn lượt.
Nhưng L1 không giảm tải database — cả bốn biến thể đều chạm database đúng 6.257 lần. Con số đó bằng số key riêng biệt được hỏi tới, và nó không đổi vì mỗi key vẫn phải được nạp một lần đầu tiên từ nguồn. Đây là điểm dễ hiểu sai nhất: L1 bảo vệ Redis, Redis bảo vệ database. Thêm L1 vào một hệ đang quá tải database sẽ không giúp gì cả.
Từ TTL 1s lên 10s gần như không thêm được gì: 7.438 → 6.257 lượt tới Redis, mà 6.257 chính là sàn (số key riêng biệt). Nói cách khác, TTL 1 giây đã lấy gần hết lợi ích, trong khi cái giá — thời gian trả dữ liệu cũ — tăng gấp 10. Đây là một trong những đánh đổi rõ ràng nhất trong cả loạt bài: chọn 1 giây, đừng chọn 10.
Chuyện bất ngờ: Redis chỉ nhanh hơn PostgreSQL 1,26 lần
Bảng thứ hai đo riêng từng tầng cho một lượt đọc:
| tầng | độ trễ |
|---|---|
| L1 (map trong tiến trình) | 0,046 µs |
| Redis (qua mạng) | 36,943 µs |
| PostgreSQL (qua mạng) | 46,725 µs |
Hai quan sát, và cả hai đều quan trọng:
L1 nhanh hơn Redis khoảng 800 lần. Không phải vì map của Go thần kỳ, mà vì nó không rời khỏi tiến trình: không đóng gói giao thức, không syscall, không chờ gói tin quay về. Khoảng cách giữa "trong bộ nhớ" và "qua mạng" lớn hơn khoảng cách giữa bất kỳ hai hệ thống nào cùng ở bên kia ranh giới mạng.
Và đây là chỗ phải nói thẳng: Redis chỉ nhanh hơn PostgreSQL 1,26 lần. 36,9µs so với 46,7µs, cho một truy vấn điểm theo khoá chính có index. Con số này nghe mâu thuẫn với phần 1, nơi Redis nhanh hơn 30–300 lần — nhưng ở đó truy vấn gốc là một phép gộp 100.000 dòng. Khi truy vấn gốc rẻ, phần lớn độ trễ của cả hai bên là chi phí đi qua mạng, và chi phí đó gần như nhau. "Redis nhanh vì nằm trong RAM" chỉ đúng khi so với công việc tính toán đắt; nó không đúng khi so với một lần SELECT theo index.
Hệ quả thực dụng: nếu bạn thêm Redis trước một query điểm có index chỉ để giảm độ trễ, phép đo này nói rằng bạn sẽ thất vọng. Lý do đúng để thêm Redis vẫn là gỡ tải cho database (phần 2), còn lý do đúng để thêm L1 là gỡ tải cho Redis và giảm độ trễ thật sự.
Cái giá, đo bằng giây
Bảng cuối đo chính xác điều đáng lo nhất: sau khi Redis đã có giá mới, một instance còn trả giá cũ trong bao lâu?
- TTL L1 100ms → 0,10 giây
- TTL L1 1s → 1,00 giây
- TTL L1 10s → 10,00 giây
Đúng bằng TTL của L1, không hơn không kém. Không có dao động, không có hội tụ sớm — vì không có cơ chế nào xoá bản sao đó từ xa. So với phần 7, nơi xoá cache kéo cửa sổ sai xuống vài mili-giây, tầng L1 đưa cửa sổ đó trở lại đúng bằng TTL. Đây là lý do TTL của L1 phải tính bằng giây, dù TTL của Redis có thể là hàng giờ: hai tầng có hai cơ chế làm mới khác hẳn nhau, nên không thể dùng chung một con số.
Đánh đổi cần cân nhắc
N instance = N nguồn sự thật tạm thời, và chúng lệch nhau. Hai người dùng gọi cùng một API cùng một lúc, rơi vào hai instance khác nhau, có thể thấy hai giá trị khác nhau trong suốt TTL của L1. Với giá sản phẩm hiển thị thì không sao; với số lượng tồn kho ngay trước nút "Đặt hàng" thì đó là một trải nghiệm tệ và một ca hỗ trợ khách hàng. Dùng L1 cho dữ liệu mà lệch vài giây giữa hai người dùng là chấp nhận được, không phải cho mọi thứ.
L1 ăn bộ nhớ của chính ứng dụng, và không có maxmemory. Map ở Hình 1 không bao giờ xoá key hết hạn — nó chỉ bỏ qua chúng khi đọc. Chạy vài giờ với tập key lớn là rò rỉ bộ nhớ chậm rãi, và lần này nạn nhân là heap của ứng dụng chứ không phải Redis. Bản dùng thật cần giới hạn số phần tử và một chính sách đá key (toàn bộ phần 4 áp dụng lại ở đây, lần này do bạn tự viết), hoặc một thư viện LRU có sẵn.
Có cách rút ngắn cửa sổ lệch, nhưng nó kéo theo một hệ thống khác. Redis có cơ chế client-side caching (CLIENT TRACKING, RESP3) để server chủ động báo cho client khi key đổi, và nhiều hệ dùng pub/sub để phát tín hiệu xoá L1. Cả hai đổi "cửa sổ bằng TTL" lấy "cửa sổ bằng độ trễ truyền tin", nhưng thêm một đường dẫn có thể hỏng — mất một thông báo nghĩa là một instance giữ dữ liệu sai vô thời hạn. Nếu làm, vẫn giữ TTL L1 làm lưới an toàn, đúng như lý lẽ ở phần 3.
Số đo ở đây là một tiến trình, một luồng, Redis và PostgreSQL cùng máy. Độ trễ Redis 36,9µs là qua loopback; qua mạng thật thường 200–1000µs, và khi đó lợi ích của L1 lớn hơn nhiều so với con số 13 lần ở đây. Ngược lại, tỉ lệ cắt lưu lượng (97,6%) phụ thuộc độ lệch Zipf và TTL, không phụ thuộc phần cứng — đó là phần mang đi được.
Ba ý mang về
- L1 trong tiến trình cắt 97,6% lưu lượng Redis với TTL chỉ 1 giây (300.000 → 7.438 lượt), và TTL 1s đã chạm gần sàn — lên 10s chỉ còn 6.257 trong khi cửa sổ dữ liệu cũ tăng gấp 10. Chọn TTL L1 bằng giây, không bằng phút.
- L1 bảo vệ Redis, không bảo vệ database: cả bốn biến thể đều chạm database đúng 6.257 lần. Thêm L1 vào một hệ đang quá tải database không giúp gì; mỗi tầng chỉ gỡ tải cho tầng ngay sau nó.
- Khoảng cách thật là ranh giới mạng, không phải RAM hay đĩa: L1 nhanh hơn Redis ~800 lần, trong khi Redis chỉ nhanh hơn PostgreSQL 1,26 lần cho query điểm có index. Và cái giá của L1 đúng bằng TTL của nó — 10,00 giây với TTL 10s — vì không ai xoá được bản sao đó từ xa.
Nguồn
- Redis docs — Client-side caching (CLIENT TRACKING, RESP3): https://redis.io/docs/latest/develop/clients/client-side-caching/
- Go docs — sync.RWMutex: https://pkg.go.dev/sync#RWMutex
- Facebook — Scaling Memcache at Facebook (NSDI'13), phần cache phân tầng
- Netflix — EVCache (cache phân tầng trong thực tế): https://netflixtechblog.com/announcing-evcache-distributed-in-memory-datastore-for-cloud-c26a698c27f7
Phần sau là phần cuối: gom mười một phép đo thành một khung quyết định — khi nào nên cache, chọn mẫu nào, đặt TTL bao nhiêu, bảo vệ cái gì — kèm checklist rà soát trước khi đưa một tầng cache lên production.
