Mười hai phần, một câu hỏi: máy kia không trả lời, giờ sao? Mỗi phần đo một cách trả lời — timeout, đồng hồ, khoá, bầu chủ, Raft, sao chép, băm, 2PC, CRDT, phát hiện lỗi, chia mảnh, phân vùng — trên container thật, với số thật. Phần cuối này làm ba việc: gom các con số vào một bảng để nhìn cùng lúc, chạy một dịch vụ nhỏ đi qua ba cái bẫy phổ biến nhất để thấy chúng cộng dồn thế nào, và để lại một khung quyết định cùng danh sách kiểm tra.
Mười hai phần trong một bảng
| # | chủ đề | con số đáng nhớ | bài học một dòng |
|---|---|---|---|
| 1 | Mạng không đáng tin | mất gói 30%: 10/75 request "lỗi" đã được server làm | Gọi qua mạng có kết quả thứ ba: không biết |
| 2 | Đồng hồ và thứ tự | lệch 1 ms đủ xếp ngược 300/900 cặp; LWW lệch 20 ms đè bản mới 200/200 | Đồng hồ tường để hiển thị, đồng hồ logic để xếp thứ tự |
| 3 | Khoá phân tán | treo 500 ms với TTL 300 ms: mất 100/100 cập nhật; fencing chặn 100/100 | Khoá theo thời gian không an toàn nếu không có fencing ở kho |
| 4 | Bầu chủ | chết đột ngột chờ đúng TTL 10,01 s; từ nhiệm 1 ms; leader cũ ghi 50/50 | Chỉ Txn có điều kiện mới chặn được leader cũ |
| 5 | Raft | mất leader 1,07 s; mất quorum 0/20 ghi nhưng 20/20 đọc serializable | Mất quorum là dừng, không phải sai |
| 6 | Sao chép PostgreSQL | lag p99 52,67 ms khi bận; đọc ngay sau ghi sai 500/500 | Chờ LSN lấy sau commit, hoặc trả giá remote_apply |
| 7 | Băm nhất quán | thêm node 11: modulo dời 90,9%, vòng băm 9%; FNV thô lệch 3× | Cần đủ node ảo và hàm băm trộn tốt |
| 8 | 2PC và saga | 2PC đắt 1,5×, điều phối chết là khoá vô thời hạn; saga 34,6% thời gian lệch | Cả hai đều có trạng thái dở; khác nhau ai thấy nó |
| 9 | CRDT | G-Counter đúng 30.000 sau 2 vòng; merge-max mất 20.000; OR-Set 34× | Hội tụ không có nghĩa là đúng; giá là lịch sử đi kèm |
| 10 | Phát hiện lỗi | timeout 300 ms báo oan 9 lần/phút; phi 157 → 831 ms | Nhanh hay ít báo oan, không có cả hai |
| 11 | Chia mảnh | Zipf: khoảng lệch 3,75, hash lệch 1,54; mod N dời 80%, đọc kép 0 trượt | Hash rải khoá, không rải dòng |
| 12 | Phân vùng thật | thiểu số 1/21 ghi nhưng serializable cũ 20 s; lease mất 0,71 s trước khi người giữ hay | Nguy hiểm là thứ không báo lỗi |
Đọc dọc cột "bài học" thấy một mẫu lặp lại: lỗi nguy hiểm không nằm ở chỗ hệ thống từ chối, mà ở chỗ nó trả lời bình thường với dữ liệu sai. Phần 3 mất 100/100 cập nhật không log; phần 6 sai 500/500 với mã thành công; phần 12 trả dữ liệu cũ 20 giây với 200 OK. Thí nghiệm cuối gom ba cái đó lại.
Một dịch vụ đặt hàng đi qua ba cái bẫy
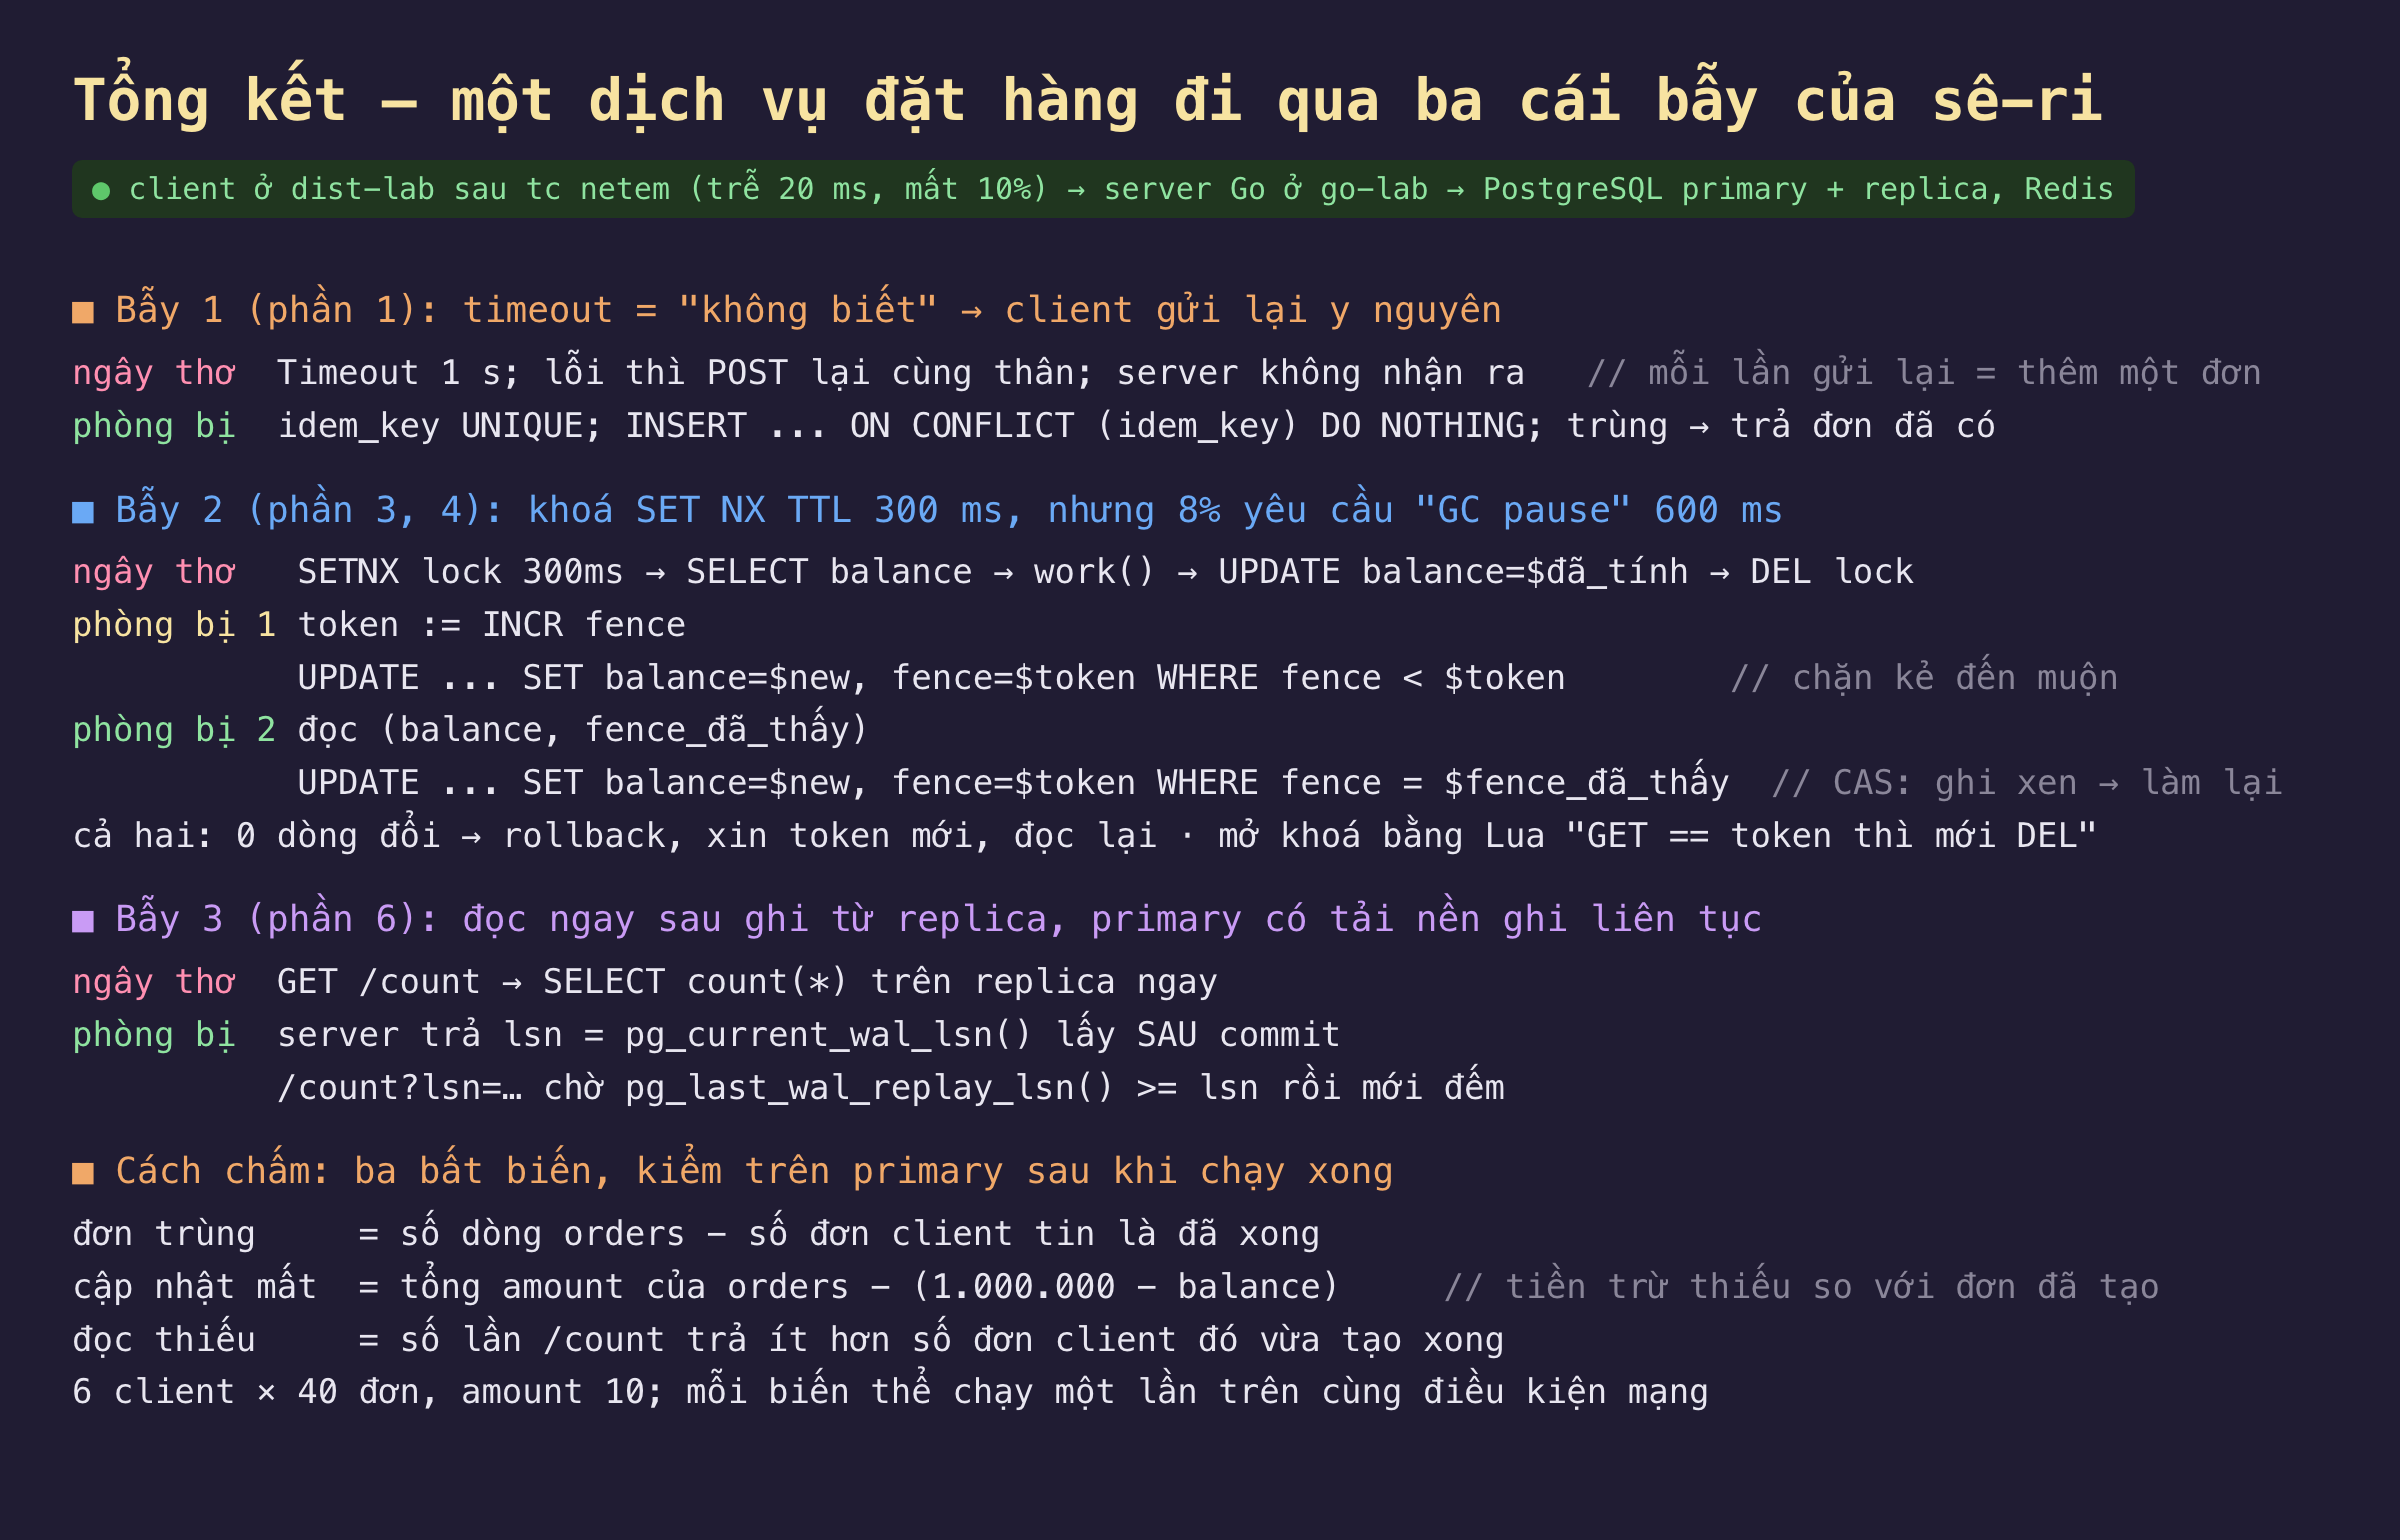
Hình 1: Cùng một dịch vụ, ba chỗ khác nhau giữa bản ngây thơ và bản phòng bị. Cách chấm là ba bất biến kiểm sau khi chạy, không phải mã trả về.
Dịch vụ: nhận đơn, trừ ví, ghi đơn, rồi client đọc lại số đơn của mình. Client đứng sau tc netem (trễ 20 ms, mất 10% gói), timeout 1 s, hết timeout thì gửi lại tối đa ba lần. Server khoá ví bằng Redis SET NX TTL 300 ms, và 8% yêu cầu bị "GC pause" 600 ms — dài hơn TTL, đúng kịch bản phần 3. Primary có một tiến trình ghi liên tục để replica phải đuổi theo như phần 6.
Ba biến thể:
- Ngây thơ: gửi lại y nguyên; đọc số dư, tính, ghi đè;
DELkhoá không so chủ; đọc replica ngay. - Phòng bị 1: idempotency key có ràng buộc UNIQUE; fencing token từ
INCR, ghi với điều kiệnfence < token; mở khoá bằng Lua so chủ; đọc replica sau khi chờ tới LSN lấy sau commit. - Phòng bị 2: như trên nhưng điều kiện ghi là CAS:
fence = giá trị đã đọc— chỉ ghi nếu không ai ghi xen kể từ lúc mình đọc.
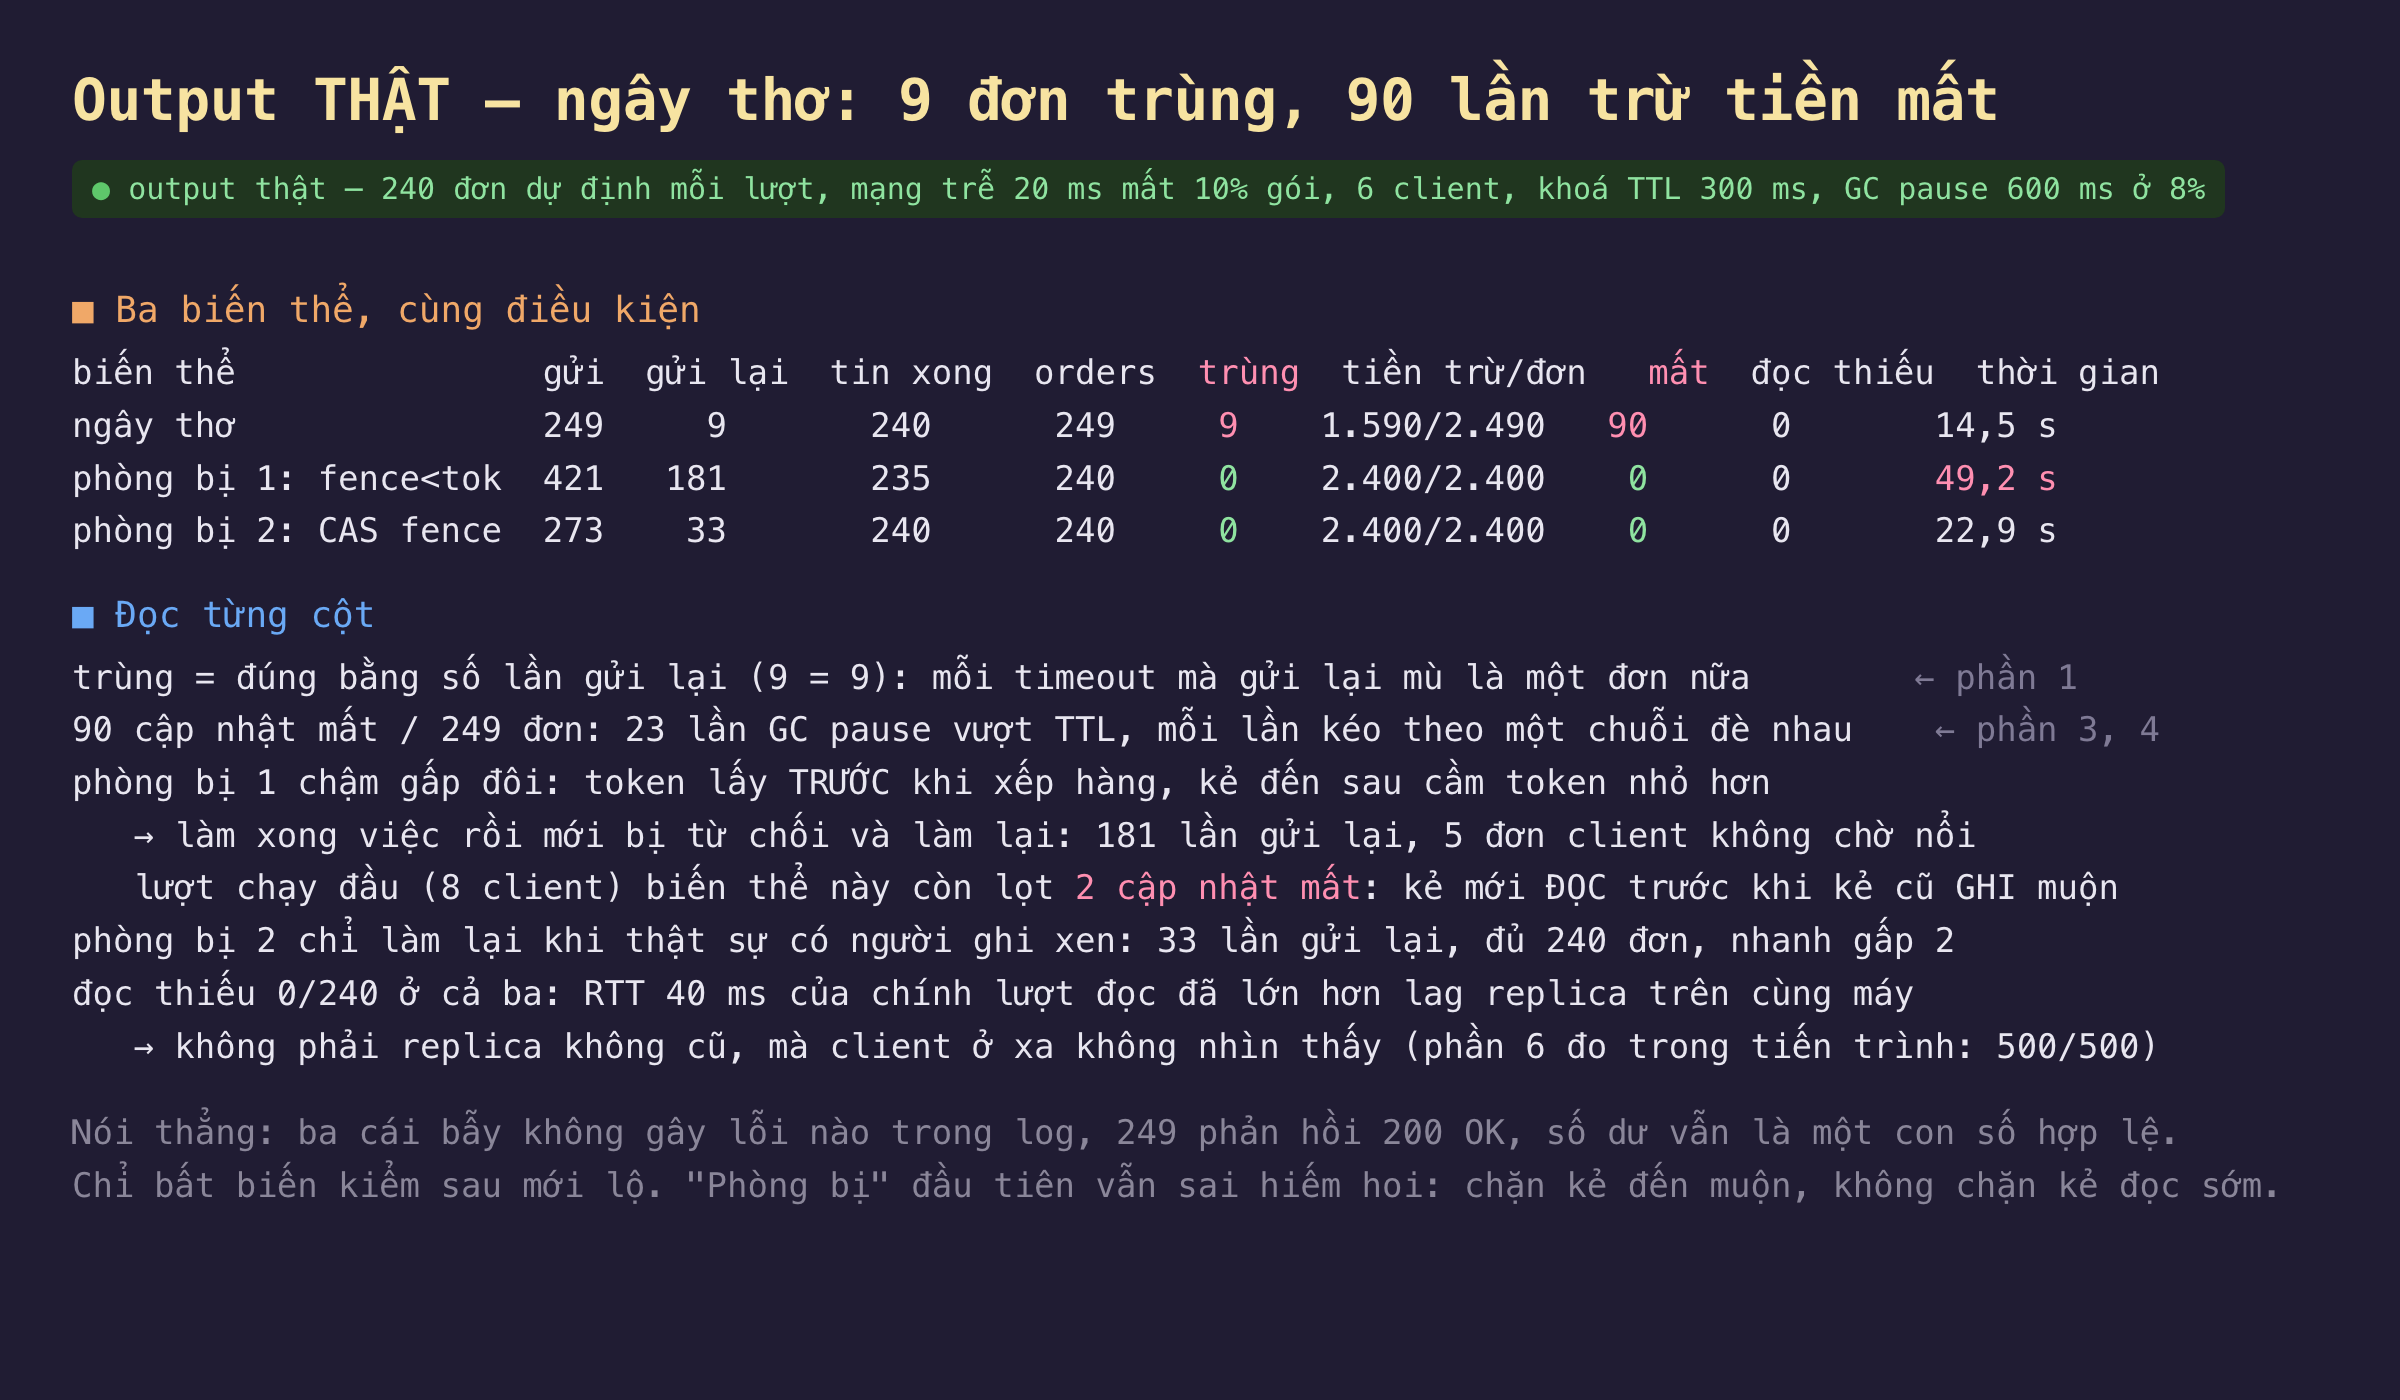
Hình 2: Kết quả thật. Cột "trùng" và "mất" là hai bất biến bị vi phạm; cột "thời gian" là giá của từng cách phòng bị.
| biến thể | đơn trùng | cập nhật mất | đọc thiếu | thời gian |
|---|---|---|---|---|
| ngây thơ | 9 | 90 | 0 | 14,5 s |
phòng bị 1: fence < token |
0 | 0 (lượt đầu: 2) | 0 | 49,2 s |
| phòng bị 2: CAS trên fence | 0 | 0 | 0 | 22,9 s |
Đơn trùng bằng đúng số lần gửi lại: 9 = 9. Mỗi timeout là một lần "không biết", và mỗi lần gửi lại mù là một đơn nữa — server đã làm xong đơn trước đó rồi, chỉ là phản hồi không về tới. Không một phản hồi nào khác 200. Idempotency key biến cả 181 lẫn 33 lần gửi lại của hai bản phòng bị thành đúng 240 đơn.
90 cập nhật số dư mất trên 249 đơn. 23 lần GC pause vượt TTL; mỗi lần, khoá hết hạn trong khi người giữ vẫn cầm số dư cũ trong tay, người kế tiếp vào, rồi hai bên ghi đè nhau, rồi DEL trần xoá luôn khoá của người thứ ba — một lần treo kéo theo một chuỗi. Số dư cuối vẫn là một con số hợp lệ, không âm, không lỗi. Chỉ phép kiểm "tổng đơn đã tạo so với tiền đã trừ" mới lộ.
Phòng bị 1 đúng về đơn, nhưng chậm gấp đôi và từng để lọt. Điều kiện fence < token chặn kẻ đến muộn (token nhỏ ghi sau token lớn): đó là ca phần 3 đo. Nó không chặn kẻ đọc sớm: B lấy khoá sau khi khoá của A hết hạn, đọc số dư trước khi A tỉnh dậy ghi muộn; A ghi qua được vì fence lúc đó còn nhỏ hơn token của A; rồi B ghi đè bằng số dư đã cũ, hợp lệ vì token B lớn hơn. Ở lượt chạy đầu với 8 client, lọt 2 cập nhật; lượt sau 0 — cửa sổ hẹp, nhưng có thật. Cái giá thứ hai: token được cấp trước khi xếp hàng chờ khoá, nên người xếp hàng lâu cầm token nhỏ hơn, làm xong việc mới bị từ chối và phải làm lại: 181 lần gửi lại, 49 giây, 5 đơn client bỏ cuộc.
Phòng bị 2 — CAS — đúng và chỉ trả giá khi có xung đột thật. Điều kiện "fence vẫn bằng giá trị tôi đã đọc" gói đọc và ghi thành một đơn vị: bất kỳ ai ghi xen giữa hai bước đều làm điều kiện sai. 33 lần gửi lại, đủ 240 đơn, 22,9 giây. Bài học không nằm trong sê-ri cho tới thí nghiệm này: fencing token so sánh một chiều là chưa đủ cho đọc-sửa-ghi; cần so sánh bằng.
Đọc thiếu 0/240 ở cả ba — và đó không phải tin tốt. Replica ở cùng máy, lag vài mili-giây; lượt đọc của client đi qua netem mất ít nhất 40 ms, nên đến nơi thì replica đã đuổi kịp. Phần 6 đo trong cùng tiến trình, không RTT, thấy sai 500/500. Cùng một replica, cùng một lag — client ở xa thì không thấy, client ở gần thì thấy toàn bộ. Nếu bạn kiểm thử đọc-sau-ghi từ máy khác và kết luận "replica đủ nhanh", bạn đang đo khoảng cách của mình tới replica, không đo replica.
Khung quyết định: đồng thuận hay sẵn sàng
Mọi phần trong sê-ri rơi vào một trong hai phía, và hai phía không trộn được trong cùng một thao tác:
| câu hỏi | nếu có | nếu không |
|---|---|---|
| Hai bản sao ghi mâu thuẫn nhau là chấp nhận được, miễn sau này hợp nhất ra một kết quả? | CRDT, LWW có chủ ý, saga (9, 8) — ghi khi mất mạng, hội tụ sau | cần một nơi quyết định thứ tự: Raft, khoá có fencing, 2PC (5, 3, 8) |
| Khi mất quorum, dừng phục vụ ghi là chấp nhận được? | đồng thuận: etcd từ chối 0/20 và đó là tính năng (12) | phải chọn phía sẵn sàng, và chấp nhận hợp nhất xung đột sau |
| Đọc dữ liệu cũ vài giây có gây quyết định sai? | đọc từ leader hoặc chờ LSN (6); không dùng serializable của nút không rõ còn thấy leader (12) | đọc replica, serializable, cache — rẻ hơn nhiều |
| Hành động sau khi "nhận ra máy kia chết" có đắt không (chuyển chủ, dời dữ liệu)? | ngưỡng cao, đòi nhiều bên cùng nghi, tách nghi ngờ khỏi kết luận (10) | ngưỡng thấp, phát hiện nhanh, chấp nhận báo oan |
| Phép toán trên dữ liệu có cần nhìn toàn cục (không âm, duy nhất, tổng)? | ràng buộc ở một nơi: một mảnh, một leader, một khoá có fencing (11) | chia nhỏ tự do, đếm cục bộ rồi cộng |
Hai nguyên tắc xuyên suốt: mọi lời hứa đều có giá đo được (Raft 0,37 so với 0,15 ms; remote_apply 0,24 so với 0,07 ms; 2PC 1,5×; OR-Set 34×), và không có cấu hình nào mua được cả hai phía — phi accrual chỉ dịch điểm cân bằng, không xoá nó.
Danh sách kiểm tra trước khi lên production
- Mọi thao tác ghi qua mạng có idempotency key chưa, và key đó có ràng buộc UNIQUE ở kho dữ liệu chứ không chỉ kiểm trong bộ nhớ?
- Client gặp timeout thì làm gì — gửi lại cùng key, hay gửi lại mù? Có đo được tỉ lệ "không biết" không (1)?
- Có chỗ nào dùng đồng hồ tường để xếp thứ tự giữa hai máy không? Nếu có, lệch bao nhiêu thì sai, và NTP của bạn hứa được bao nhiêu (2)?
- Mỗi khoá phân tán có fencing token đi tới tận kho dữ liệu không, và điều kiện ghi là so sánh bằng (CAS) hay chỉ so sánh lớn hơn?
- Tiến trình giữ khoá hoặc lease bị dừng lâu hơn TTL thì chuyện gì xảy ra? Đã thử bằng
SIGSTOPchưa (3, 4)? - Service bầu chủ có bắt tín hiệu dừng và từ nhiệm trước khi thoát không? Không thì mỗi lần deploy là một TTL không có chủ.
- Đọc nào đi replica, và trong số đó đọc nào là đọc-sau-ghi của chính người dùng? Chỗ đó có chờ LSN lấy sau commit không (6)?
- Thêm một node vào cụm thì bao nhiêu phần trăm khoá dời? Đã đo với hàm băm thật, không phải hàm băm trong ví dụ (7, 11)?
- Giao dịch chạm hai kho dữ liệu: ai dọn trạng thái dở khi bước giữa hỏng, và người ngoài thấy trạng thái dở đó trong bao lâu (8)?
- Phân bố khoá thật có Zipf không? Đã kiểm chia mảnh bằng mẫu production chứ không phải dữ liệu sinh đều (11)?
- Ngưỡng phát hiện lỗi chọn theo giá của hành động đi sau hay theo cảm tính? Mạng xấu lên thì báo oan bao nhiêu lần một phút (10)?
- Đã cắt mạng thật giữa các node (iptables, không phải tắt tiến trình) và đọc từ phía thiểu số chưa? Thứ nó trả về có mã lỗi hay có 200 OK với dữ liệu cũ (12)?
Câu trả lời cho 12 câu trên không phải "có/không" — là một con số đo được trên hệ của bạn. Toàn bộ sê-ri chỉ chứng minh một điều: những con số đó đo được, bằng vài container và vài trăm dòng Go, trước khi production đo hộ.
Ba ý mang về
- Lỗi phân tán nguy hiểm không báo lỗi: 249 phản hồi 200 OK che 9 đơn trùng và 90 lần trừ tiền mất; thiểu số trả dữ liệu cũ 20 giây với mã thành công. Kiểm bất biến (tổng đơn so với tiền trừ, số lượng so với kỳ vọng), đừng kiểm mã trả về.
- Ba cái bẫy chồng nhau cần ba cái chốt riêng: idempotency key có UNIQUE cho retry, CAS trên fence (không chỉ
fence < token) cho đọc-sửa-ghi dưới khoá có TTL, chờ LSN lấy sau commit cho đọc-sau-ghi. Thiếu một là lọt một. - Đồng thuận và sẵn sàng là hai phía của một đánh đổi có giá đo được; chọn theo từng thao tác bằng khung ở trên, và chạy 12 câu kiểm tra trên hệ của mình với container thật trước khi tin bất kỳ con số nào trong sê-ri này.
Nguồn
- Martin Kleppmann — Designing Data-Intensive Applications (2017), phần II: Distributed Data
- Kyle Kingsbury — Jepsen analyses: https://jepsen.io/analyses
- Peter Bailis, Kyle Kingsbury — The Network is Reliable (ACM Queue, 2014): https://queue.acm.org/detail.cfm?id=2655736
- Martin Kleppmann — How to do distributed locking (2016): https://martin.kleppmann.com/2016/02/08/how-to-do-distributed-locking.html
- Diego Ongaro, John Ousterhout — In Search of an Understandable Consensus Algorithm (2014): https://raft.github.io/raft.pdf
- Mã đo của cả sê-ri chạy trên Docker với Go 1.23, PostgreSQL 16, Redis 7, etcd 3.5.16,
tc netemvàiptables; mỗi phần ghi rõ cấu hình và điều kiện đo của riêng nó.
