Phần trước là khoá: nhiều người xin, một người được, rồi thả. Bầu chủ là khoá giữ lâu: trong N bản sao của một service, đúng một bản chạy cron, tiêu thụ hàng đợi, hay điều phối việc — và khi bản đó chết, một bản khác phải lên thay. Câu hỏi của bài này là bao lâu ("chết" mất bao lâu để hệ thống biết) và có bao nhiêu leader (leader cũ có thật sự biết mình đã mất chức không). Cả hai đều đo được trên một cụm etcd thật.
Session, Election, và một giao dịch có điều kiện
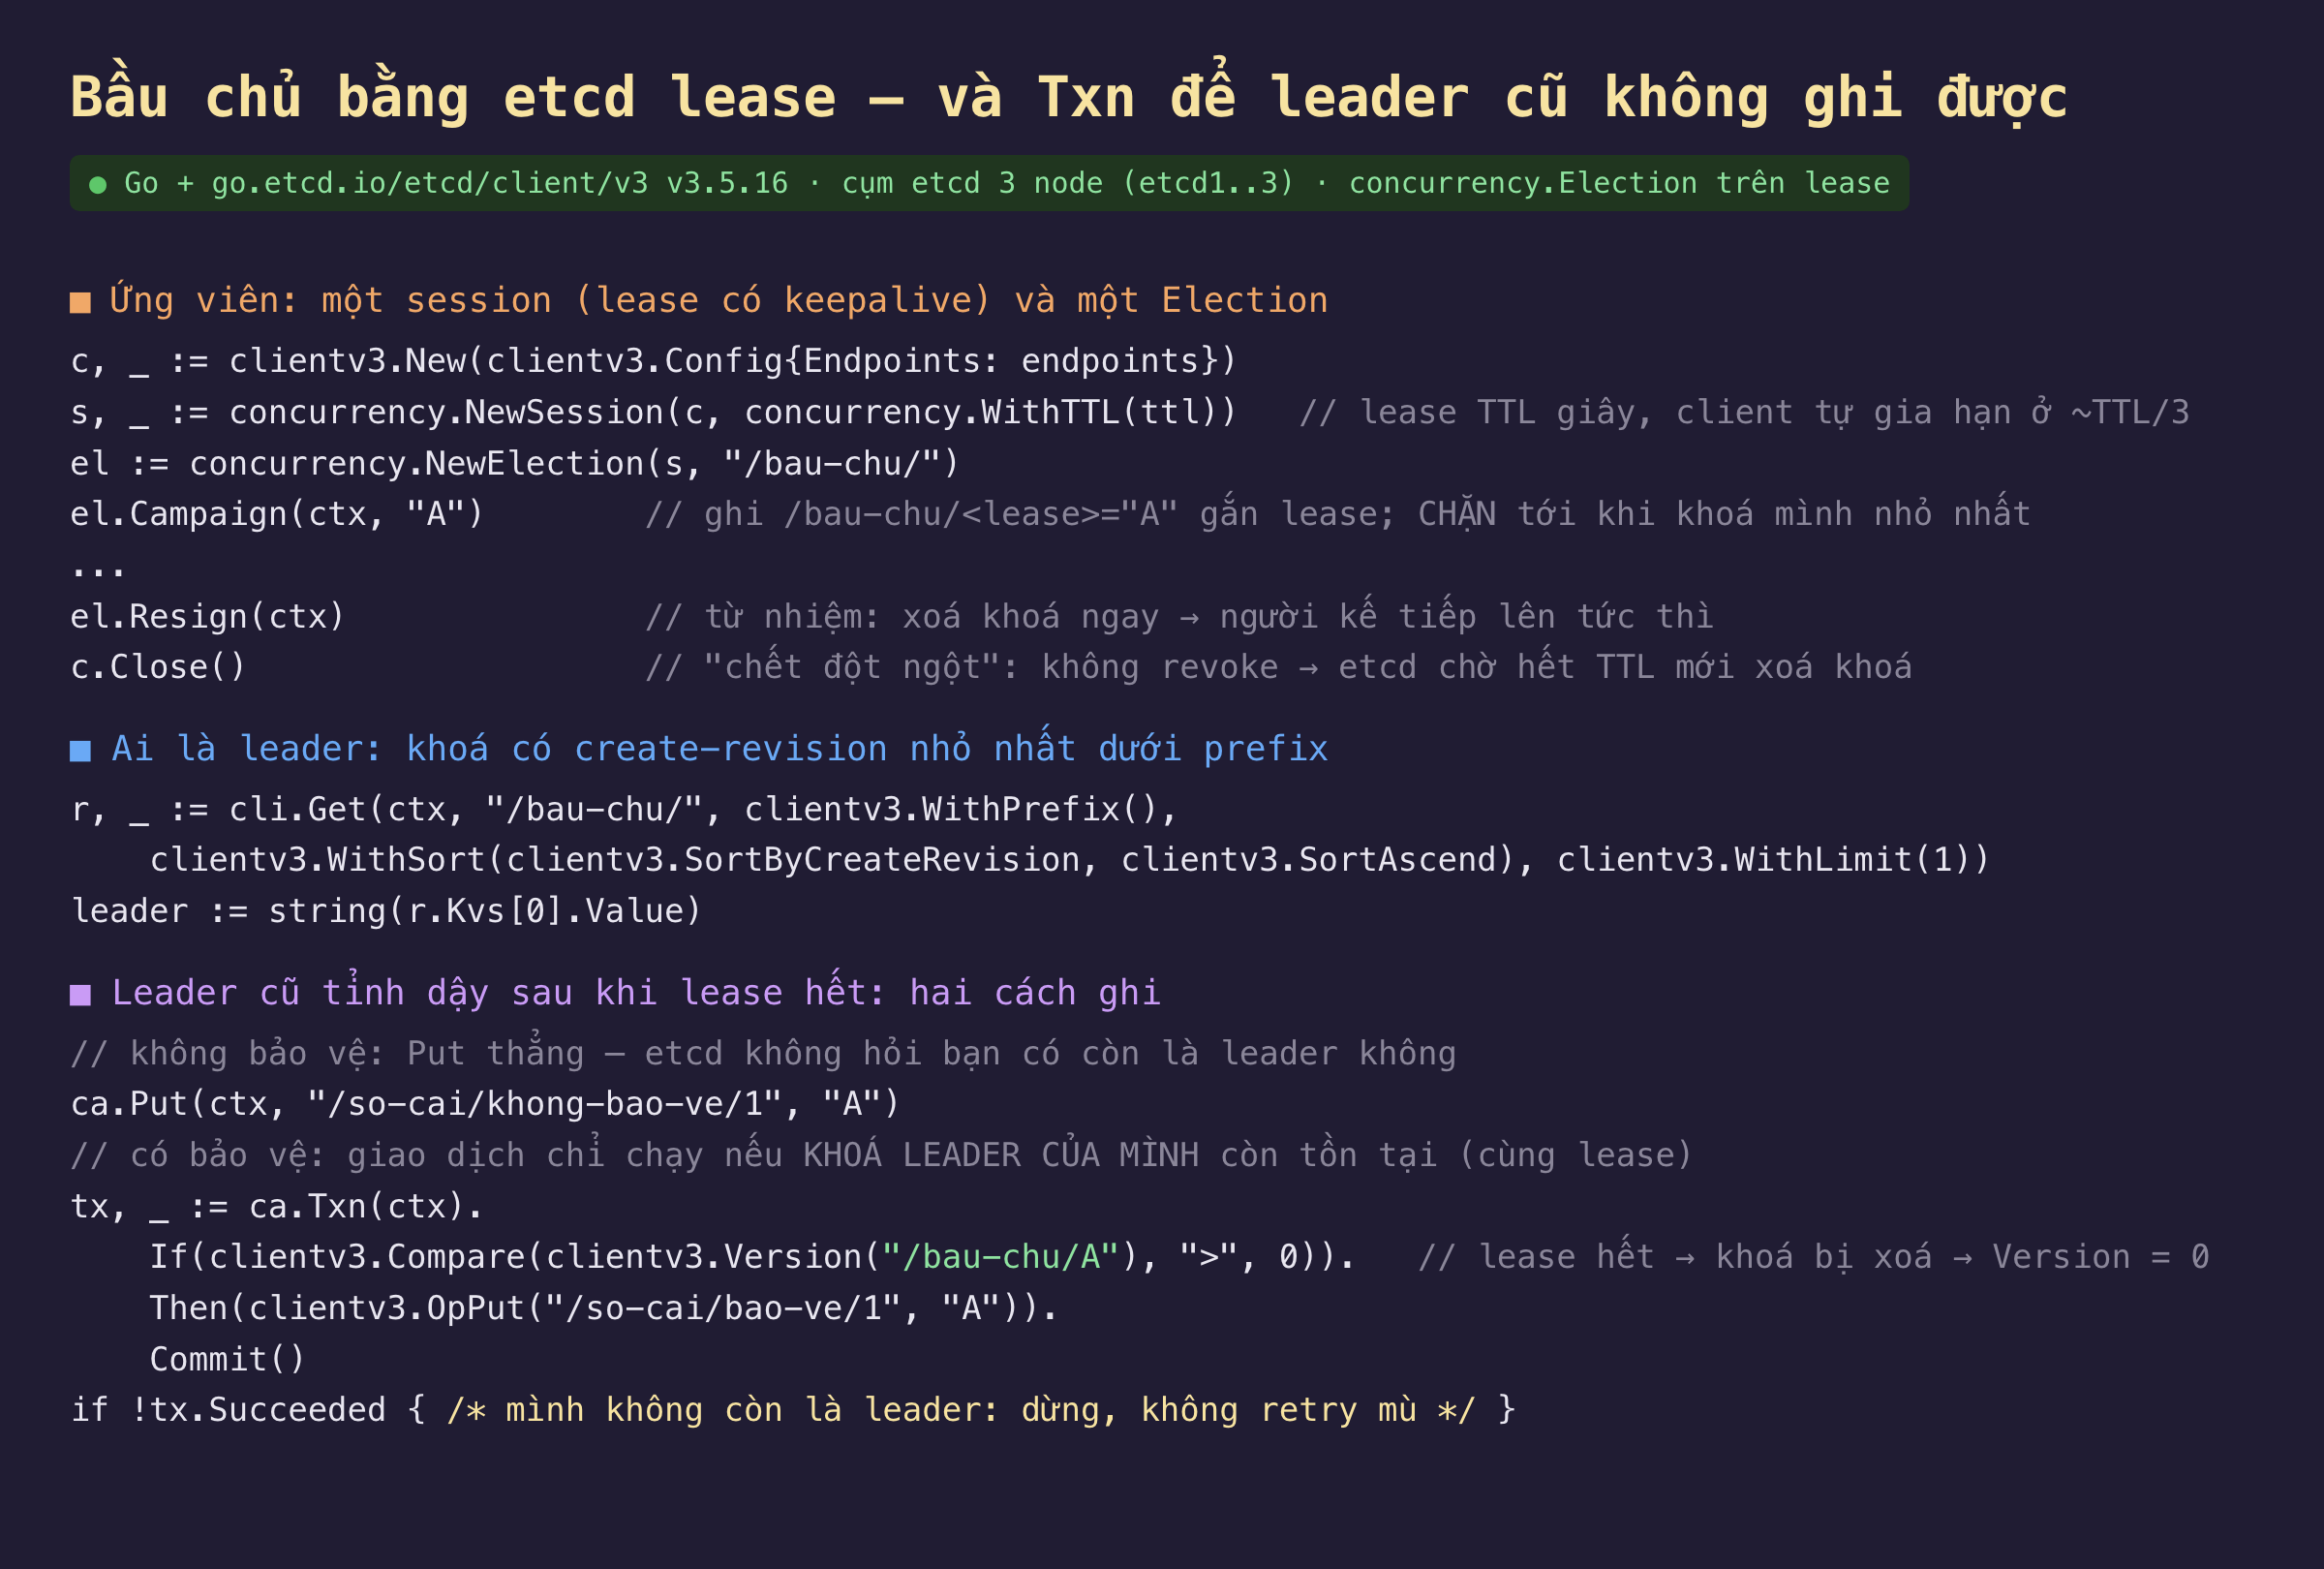
Hình 1: Ứng viên là một session trên lease. Leader là khoá có revision nhỏ nhất. Cách ghi an toàn là một giao dịch có điều kiện "khoá của tôi còn tồn tại".
Cơ chế của etcd gọn: mỗi ứng viên tạo một lease (có TTL, client tự gia hạn ở khoảng TTL/3) và ghi một khoá dưới /bau-chu/ gắn với lease đó. Khoá có create-revision nhỏ nhất là leader — revision của etcd là bộ đếm toàn cục tăng dần, nên "ai ghi trước" được xác định bởi log đã đồng thuận, không bởi đồng hồ nào (phần 2 đã đo vì sao điều đó quan trọng). Lease hết hạn thì khoá tự biến mất và người kế tiếp trong hàng thành leader.
Mảnh thứ ba là thứ ít tài liệu nói: leader ghi dữ liệu như thế nào. Put thẳng thì etcd không kiểm tra gì. Txn với điều kiện Version("/bau-chu/A") > 0 — khoá leader của tôi còn tồn tại — thì cả kiểm tra lẫn ghi diễn ra trong một giao dịch nguyên tử ở etcd; lease hết là khoá bị xoá là điều kiện sai là không ghi. Đây là fencing token của phần 3 trong dạng etcd cấp sẵn.
Đo thật: chết thì chờ TTL, từ nhiệm thì 1 ms
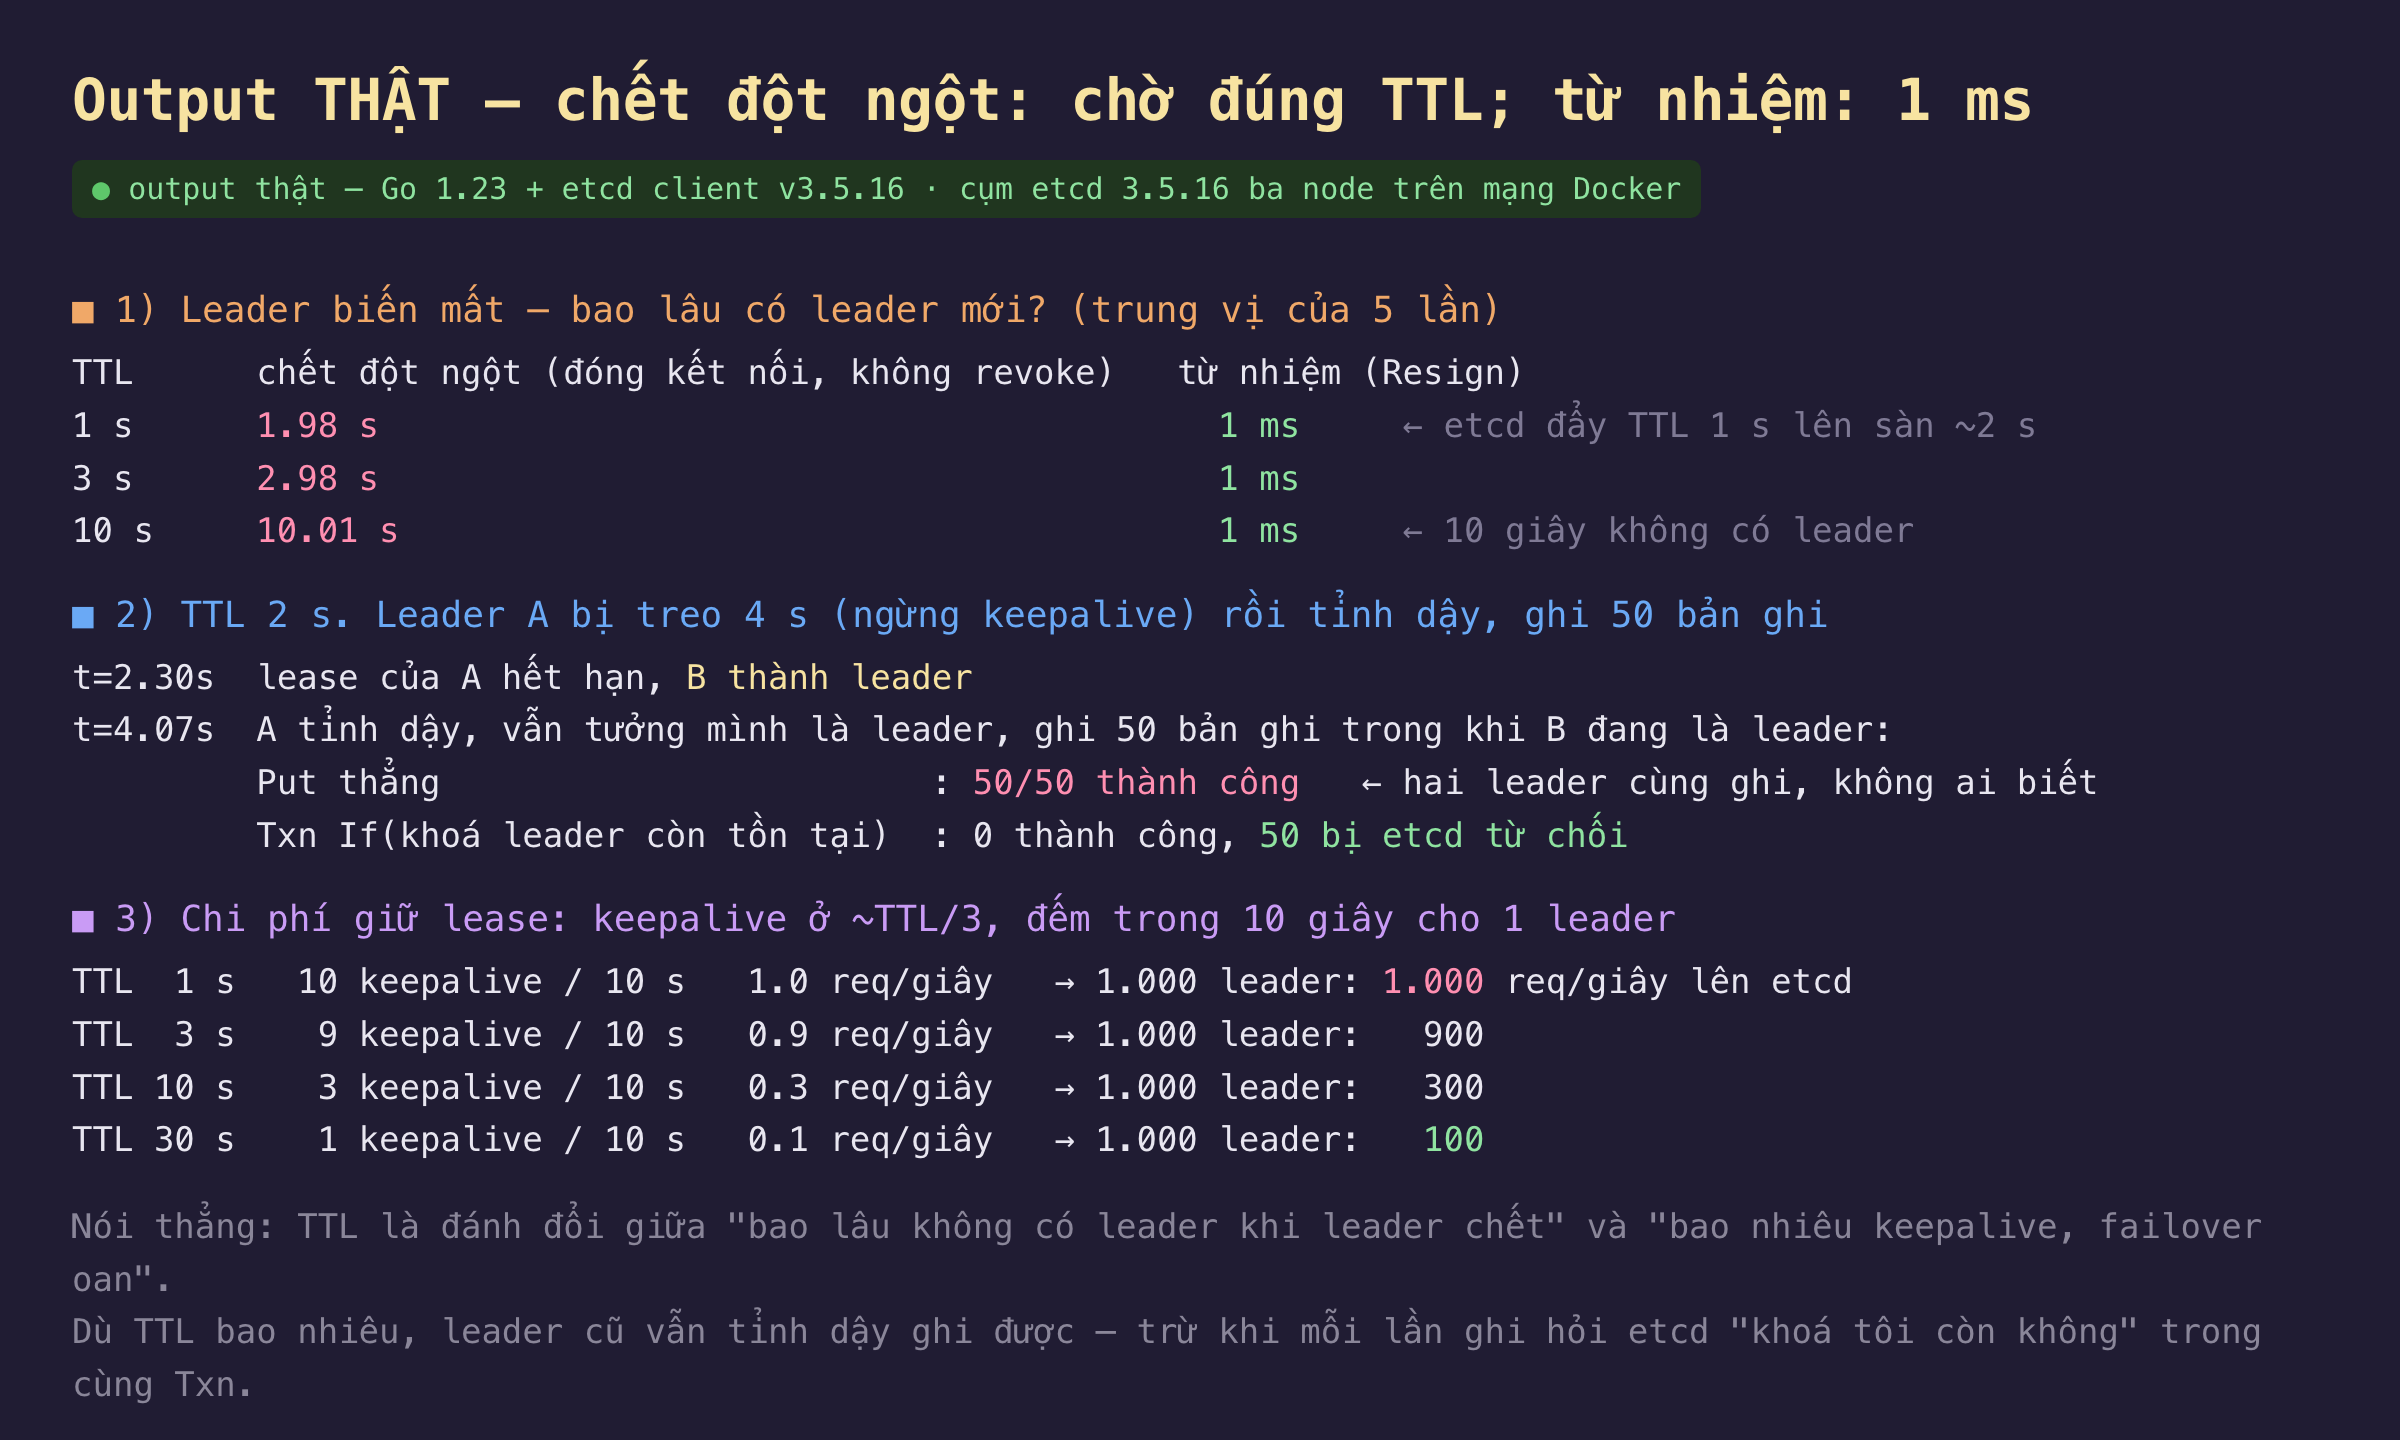
Hình 2: Kết quả thật trên cụm etcd ba node. Mục 1 là thời gian chuyển giao, mục 2 là hai leader cùng lúc, mục 3 là chi phí.
| TTL | chết đột ngột | từ nhiệm |
|---|---|---|
| 1 s | 1,98 s | 1 ms |
| 3 s | 2,98 s | 1 ms |
| 10 s | 10,01 s | 1 ms |
Chết đột ngột thì chờ đúng TTL, không hơn không kém. Đóng kết nối mà không revoke lease — tương đương tiến trình bị kill -9, máy mất điện, mạng đứt — thì etcd không có tín hiệu nào ngoài "keepalive không tới nữa", và nó chỉ dám kết luận sau TTL. Với TTL 10 s, hệ thống không có leader trong 10 giây: cron không chạy, hàng đợi không được tiêu thụ. Với TTL 1 s, etcd đẩy lên sàn khoảng 2 s — etcd ràng buộc TTL tối thiểu theo election timeout của Raft để lease không hết hạn oan trong lúc chính cụm etcd đang bầu lại leader của nó.
Từ nhiệm có chủ ý thì 1 ms. Resign xoá khoá ngay, người kế tiếp trong hàng lên tức thì. Đây là lý do mọi service có bầu chủ phải bắt SIGTERM và từ nhiệm trước khi thoát: khác biệt giữa triển khai bản mới mất 1 ms không có leader và mất 10 s là một lời gọi hàm.
Mục 2 — leader cũ không biết mình đã mất chức. TTL 2 s. A là leader, bị "treo" 4 s (ngừng gửi keepalive — GC pause, VM tạm dừng, hay đơn giản là một vòng lặp quá dài trong cùng goroutine với keepalive). Lúc 2,30 s lease hết, B lên. Lúc 4,07 s A tỉnh dậy và tiếp tục làm việc như chưa có gì, vì không có ai gọi A để báo. A ghi 50 bản ghi bằng Put thẳng: 50/50 thành công. Trong gần hai giây, hai tiến trình đều tin mình là leader và đều ghi — đúng kịch bản mà bầu chủ được dựng để tránh.
Cùng 50 bản ghi qua Txn có điều kiện: 0 thành công, 50 bị từ chối. etcd kiểm tra "khoá /bau-chu/A còn không" và ghi trong cùng một giao dịch; khoá đã biến mất cùng lease nên điều kiện sai. A nhận Succeeded = false và biết phải dừng. Không có cách nào để A biết sớm hơn — nhưng có cách để A không gây hại khi biết muộn.
Mục 3 — chi phí của TTL ngắn. Client gia hạn ở khoảng TTL/3: TTL 1 s là 1 keepalive mỗi giây mỗi leader; 1.000 service có bầu chủ là 1.000 request/giây lên etcd chỉ để nói "tôi còn sống". TTL 30 s giảm xuống 100. Và TTL ngắn còn một cái giá không hiện trong bảng: GC pause 1,5 s với TTL 1 s là một lần failover oan — leader còn sống, khoẻ, chỉ bận — kéo theo đúng kịch bản hai leader ở mục 2.
Đánh đổi cần cân nhắc
TTL là một con số phải chọn, và không có con số đúng. Ngắn: phát hiện nhanh, keepalive dày, failover oan khi leader chỉ chậm. Dài: hiếm oan, ít keepalive, nhưng mỗi lần chết thật là từng ấy giây không có leader. Kubernetes dùng lease 15 s với gia hạn mỗi 10 s cho controller-manager; etcd mặc định session TTL 60 s. Cả hai đều chọn dài, chấp nhận chuyển giao chậm, vì failover oan đắt hơn vài giây chờ.
Txn có điều kiện phải đi kèm mọi lần ghi, và chỉ bảo vệ dữ liệu trong etcd. Leader ghi vào PostgreSQL, gửi email, gọi API thanh toán thì etcd không kiểm được. Lúc đó quay về phần 3: mang revision của khoá leader làm fencing token sang kho dữ liệu đích, hoặc chấp nhận tác vụ của leader là idempotent và trùng cũng không sao.
Kiểm "tôi còn là leader không" bằng cách hỏi, không bằng cách nhớ. Lỗi phổ biến là đọc session.Done() hoặc một biến isLeader cập nhật từ watch — những tín hiệu đó đến sau khi lease hết, và trong khoảng trễ đó code vẫn ghi. Giao dịch có điều kiện đẩy câu hỏi vào đúng thời điểm ghi, nơi duy nhất câu trả lời có nghĩa.
Một cụm etcd ba node, mọi thứ cùng máy. Chuyển giao 1 ms khi từ nhiệm là qua loopback ảo; qua mạng thật là vài ms, vẫn không đáng kể so với TTL. Con số đáng tin nhất trong bài là dạng của nó: chết đột ngột = TTL, từ nhiệm = một round-trip, treo = hai leader cho tới khi leader cũ bị từ chối.
Ba ý mang về
- Leader chết đột ngột thì không có leader trong đúng TTL (10,01 s với TTL 10 s); từ nhiệm có chủ ý thì 1 ms — nên mọi service bầu chủ phải bắt tín hiệu dừng và
Resigntrước khi thoát. - Leader cũ không biết mình đã mất chức: treo 4 s với TTL 2 s là hai leader cùng ghi,
Putthẳng 50/50 thành công. ChỉTxncó điều kiện "khoá leader của tôi còn tồn tại" — kiểm và ghi trong một giao dịch — mới chặn được (50/50 bị từ chối), và phải đi kèm mọi lần ghi. - TTL ngắn mua phát hiện nhanh bằng keepalive và failover oan: 1 keepalive/giây mỗi leader ở TTL 1 s, và một GC pause dài hơn TTL là một lần chuyển giao không cần thiết. Hệ thống thật chọn TTL 15–60 s và chấp nhận chờ.
Nguồn
- etcd docs — Lease API và concurrency package (Election, Session): https://etcd.io/docs/v3.5/learning/api/#lease-api
- etcd — Why etcd? và so sánh với ZooKeeper/Consul về lease và fencing: https://etcd.io/docs/v3.5/learning/why/
- Kubernetes — Leases (leader election của controller): https://kubernetes.io/docs/concepts/architecture/leases/
- Martin Kleppmann — How to do distributed locking (fencing, áp cho leader): https://martin.kleppmann.com/2016/02/08/how-to-do-distributed-locking.html
- Diego Ongaro, John Ousterhout — In Search of an Understandable Consensus Algorithm (Raft, election timeout): https://raft.github.io/raft.pdf
Phần sau đi xuống một tầng: chính etcd giữ được những khoá và lease này ra sao khi một trong ba node của nó chết — Raft, quorum, và đo độ trễ ghi khi mất một node, mất hai node, và theo số node.
