Hai phần trước dùng etcd như một dịch vụ khoá và bầu chủ đáng tin. Phần này hỏi: đáng tin tới đâu, và vì sao? Câu trả lời là Raft — thuật toán đồng thuận mà etcd dùng để ba node hành xử như một — và cách kiểm tra câu trả lời đó không phải đọc bài báo, mà là dừng từng node và đo. Bài này dừng một follower, giết leader giữa lúc ghi, dừng hai trong ba node, rồi bật lại, và ghi số cho từng bước.
Công cụ đo và cách điều phối
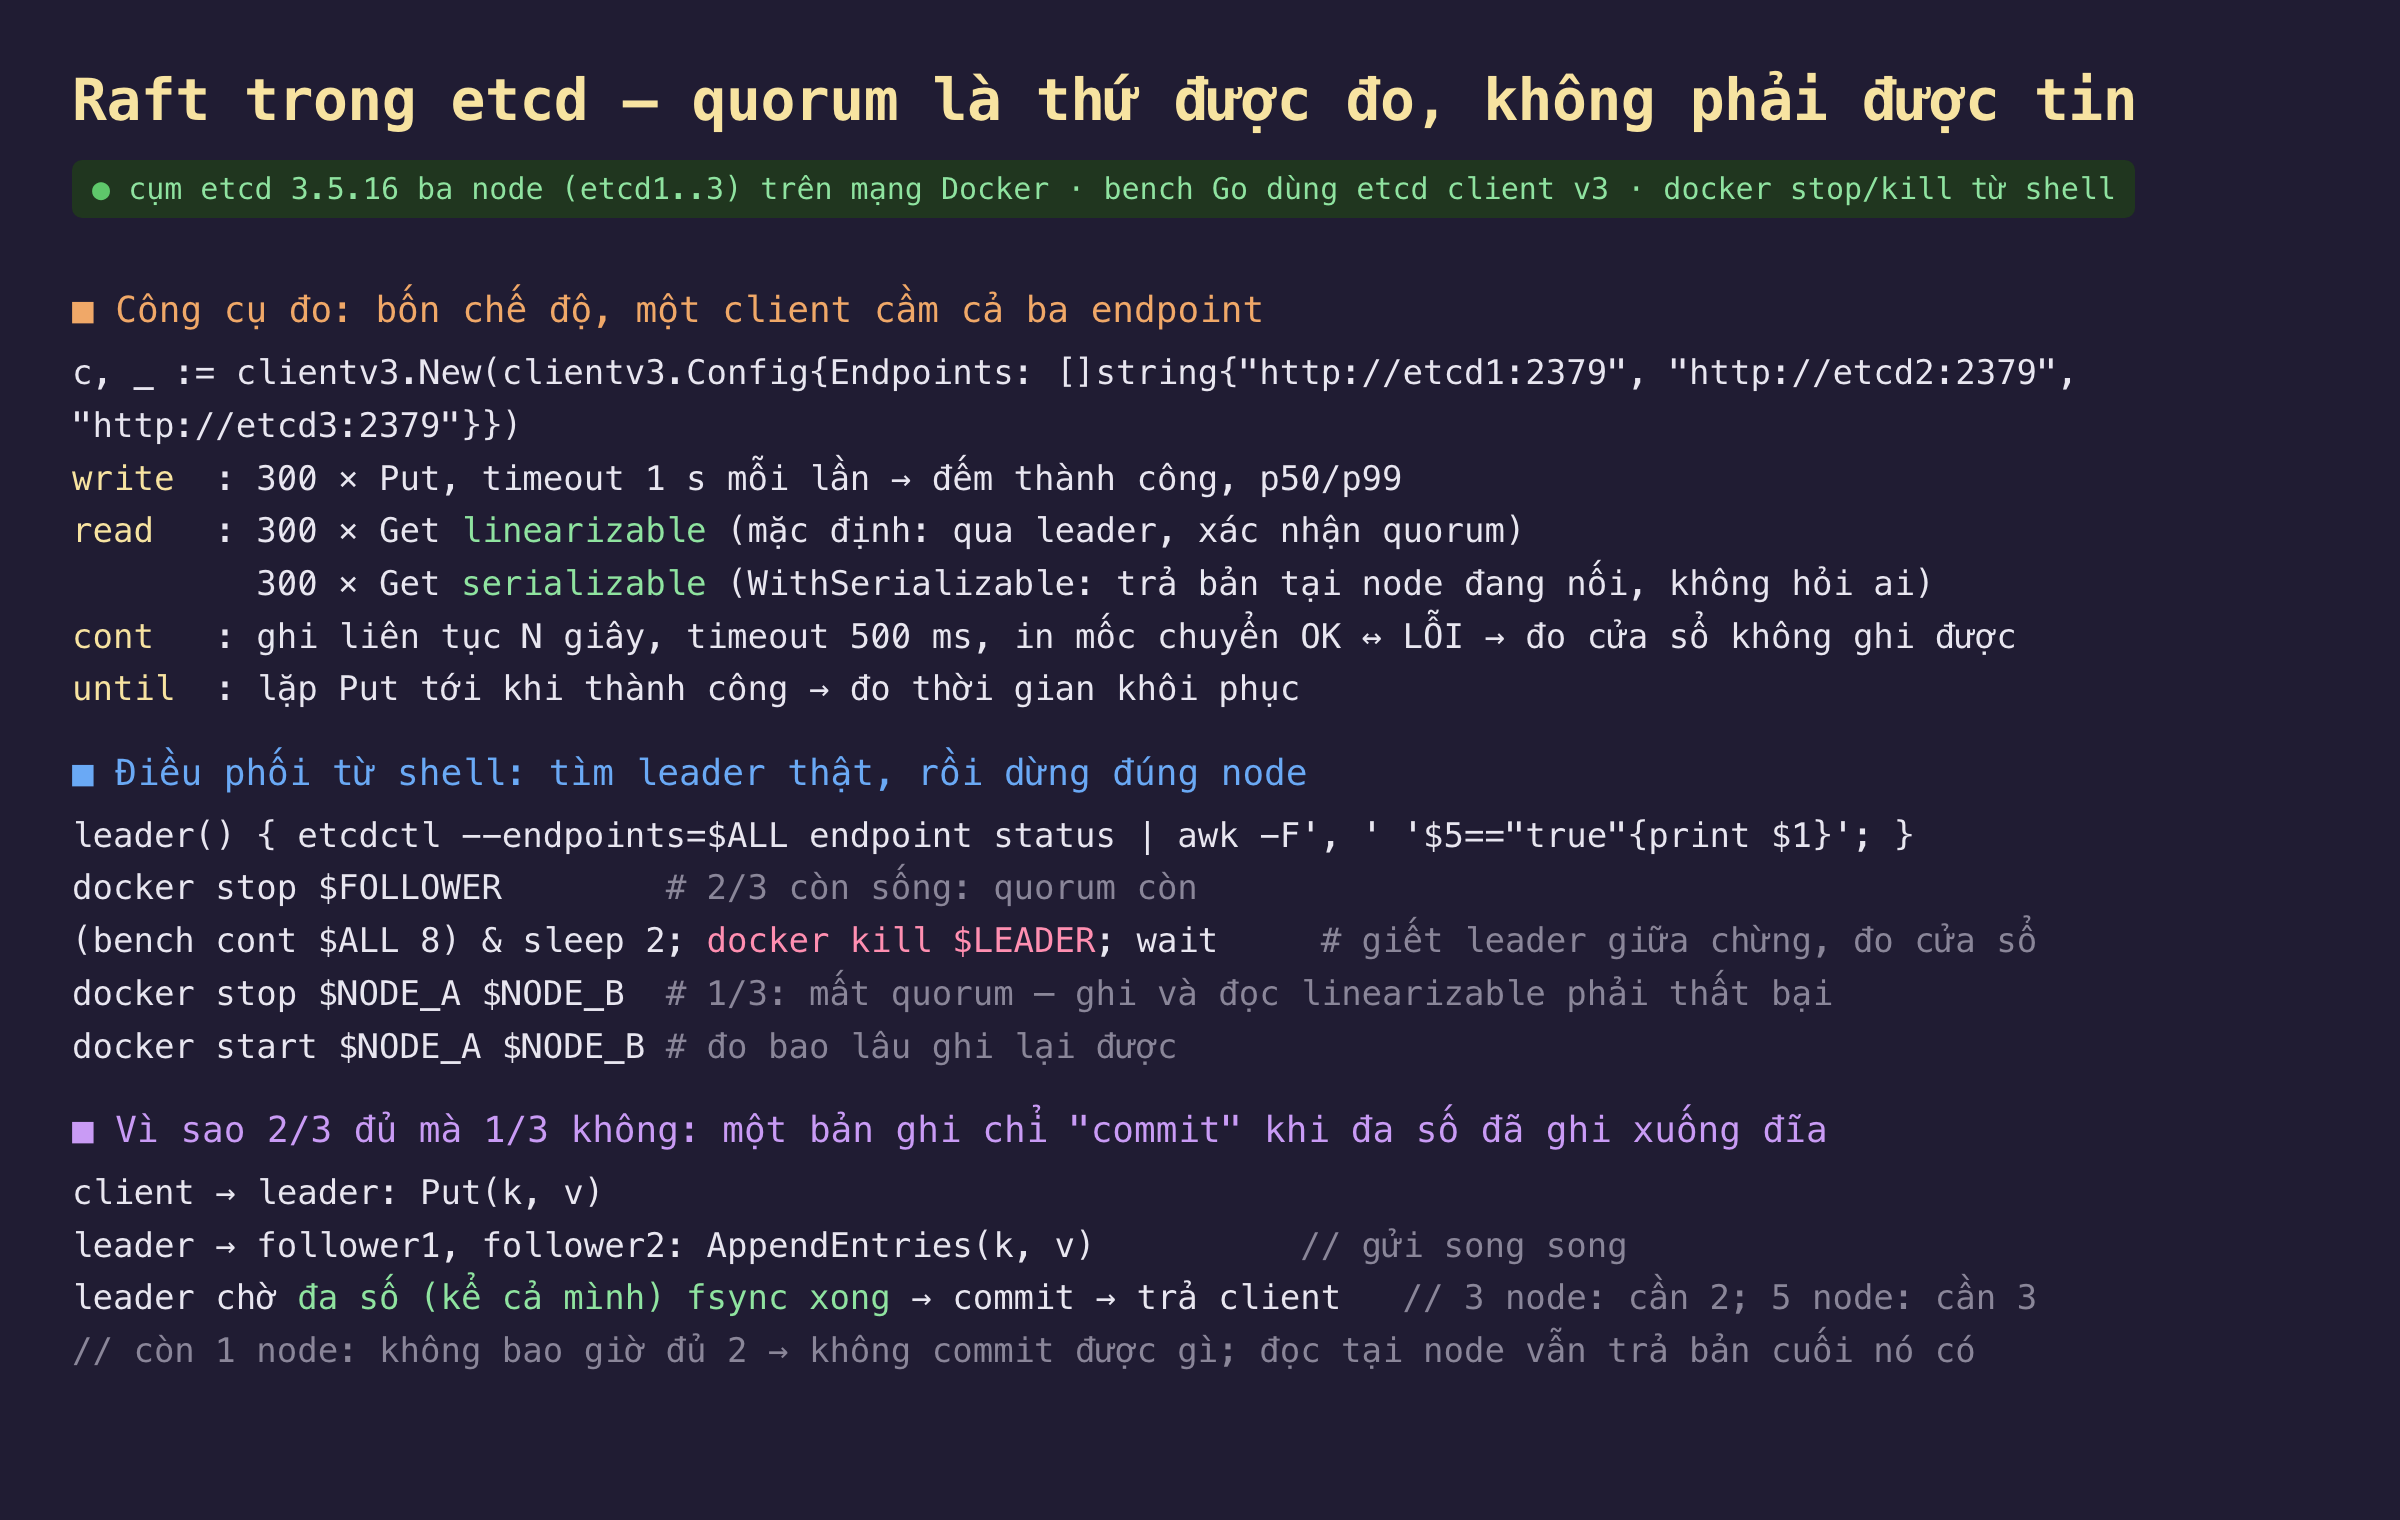
Hình 1: Bench Go bốn chế độ, điều phối bằng shell, và sơ đồ một lần ghi trong Raft — commit chỉ xảy ra khi đa số đã fsync.
Raft trong một đoạn: cụm có một leader, mọi ghi đi qua nó. Leader gắn bản ghi vào log của mình, gửi cho các follower, và chỉ commit — rồi mới trả lời client — khi đa số node (kể cả nó) đã ghi bản đó xuống đĩa bền. Ba node thì đa số là hai; năm node là ba. Khi leader biến mất, các follower chờ hết election timeout (etcd mặc định 1 giây) rồi tự ứng cử, và node nào gom được đa số phiếu thành leader mới. Mọi con số bên dưới là hệ quả trực tiếp của hai quy tắc "đa số" đó.
Đọc có hai kiểu: linearizable (mặc định) đi qua leader và xác nhận leader vẫn được đa số công nhận trước khi trả — nên bạn không bao giờ đọc được bản cũ; serializable trả thẳng bản node đang nối có — rẻ hơn, nhưng node đó có thể đang tụt lại.
Đo thật: sáu bước
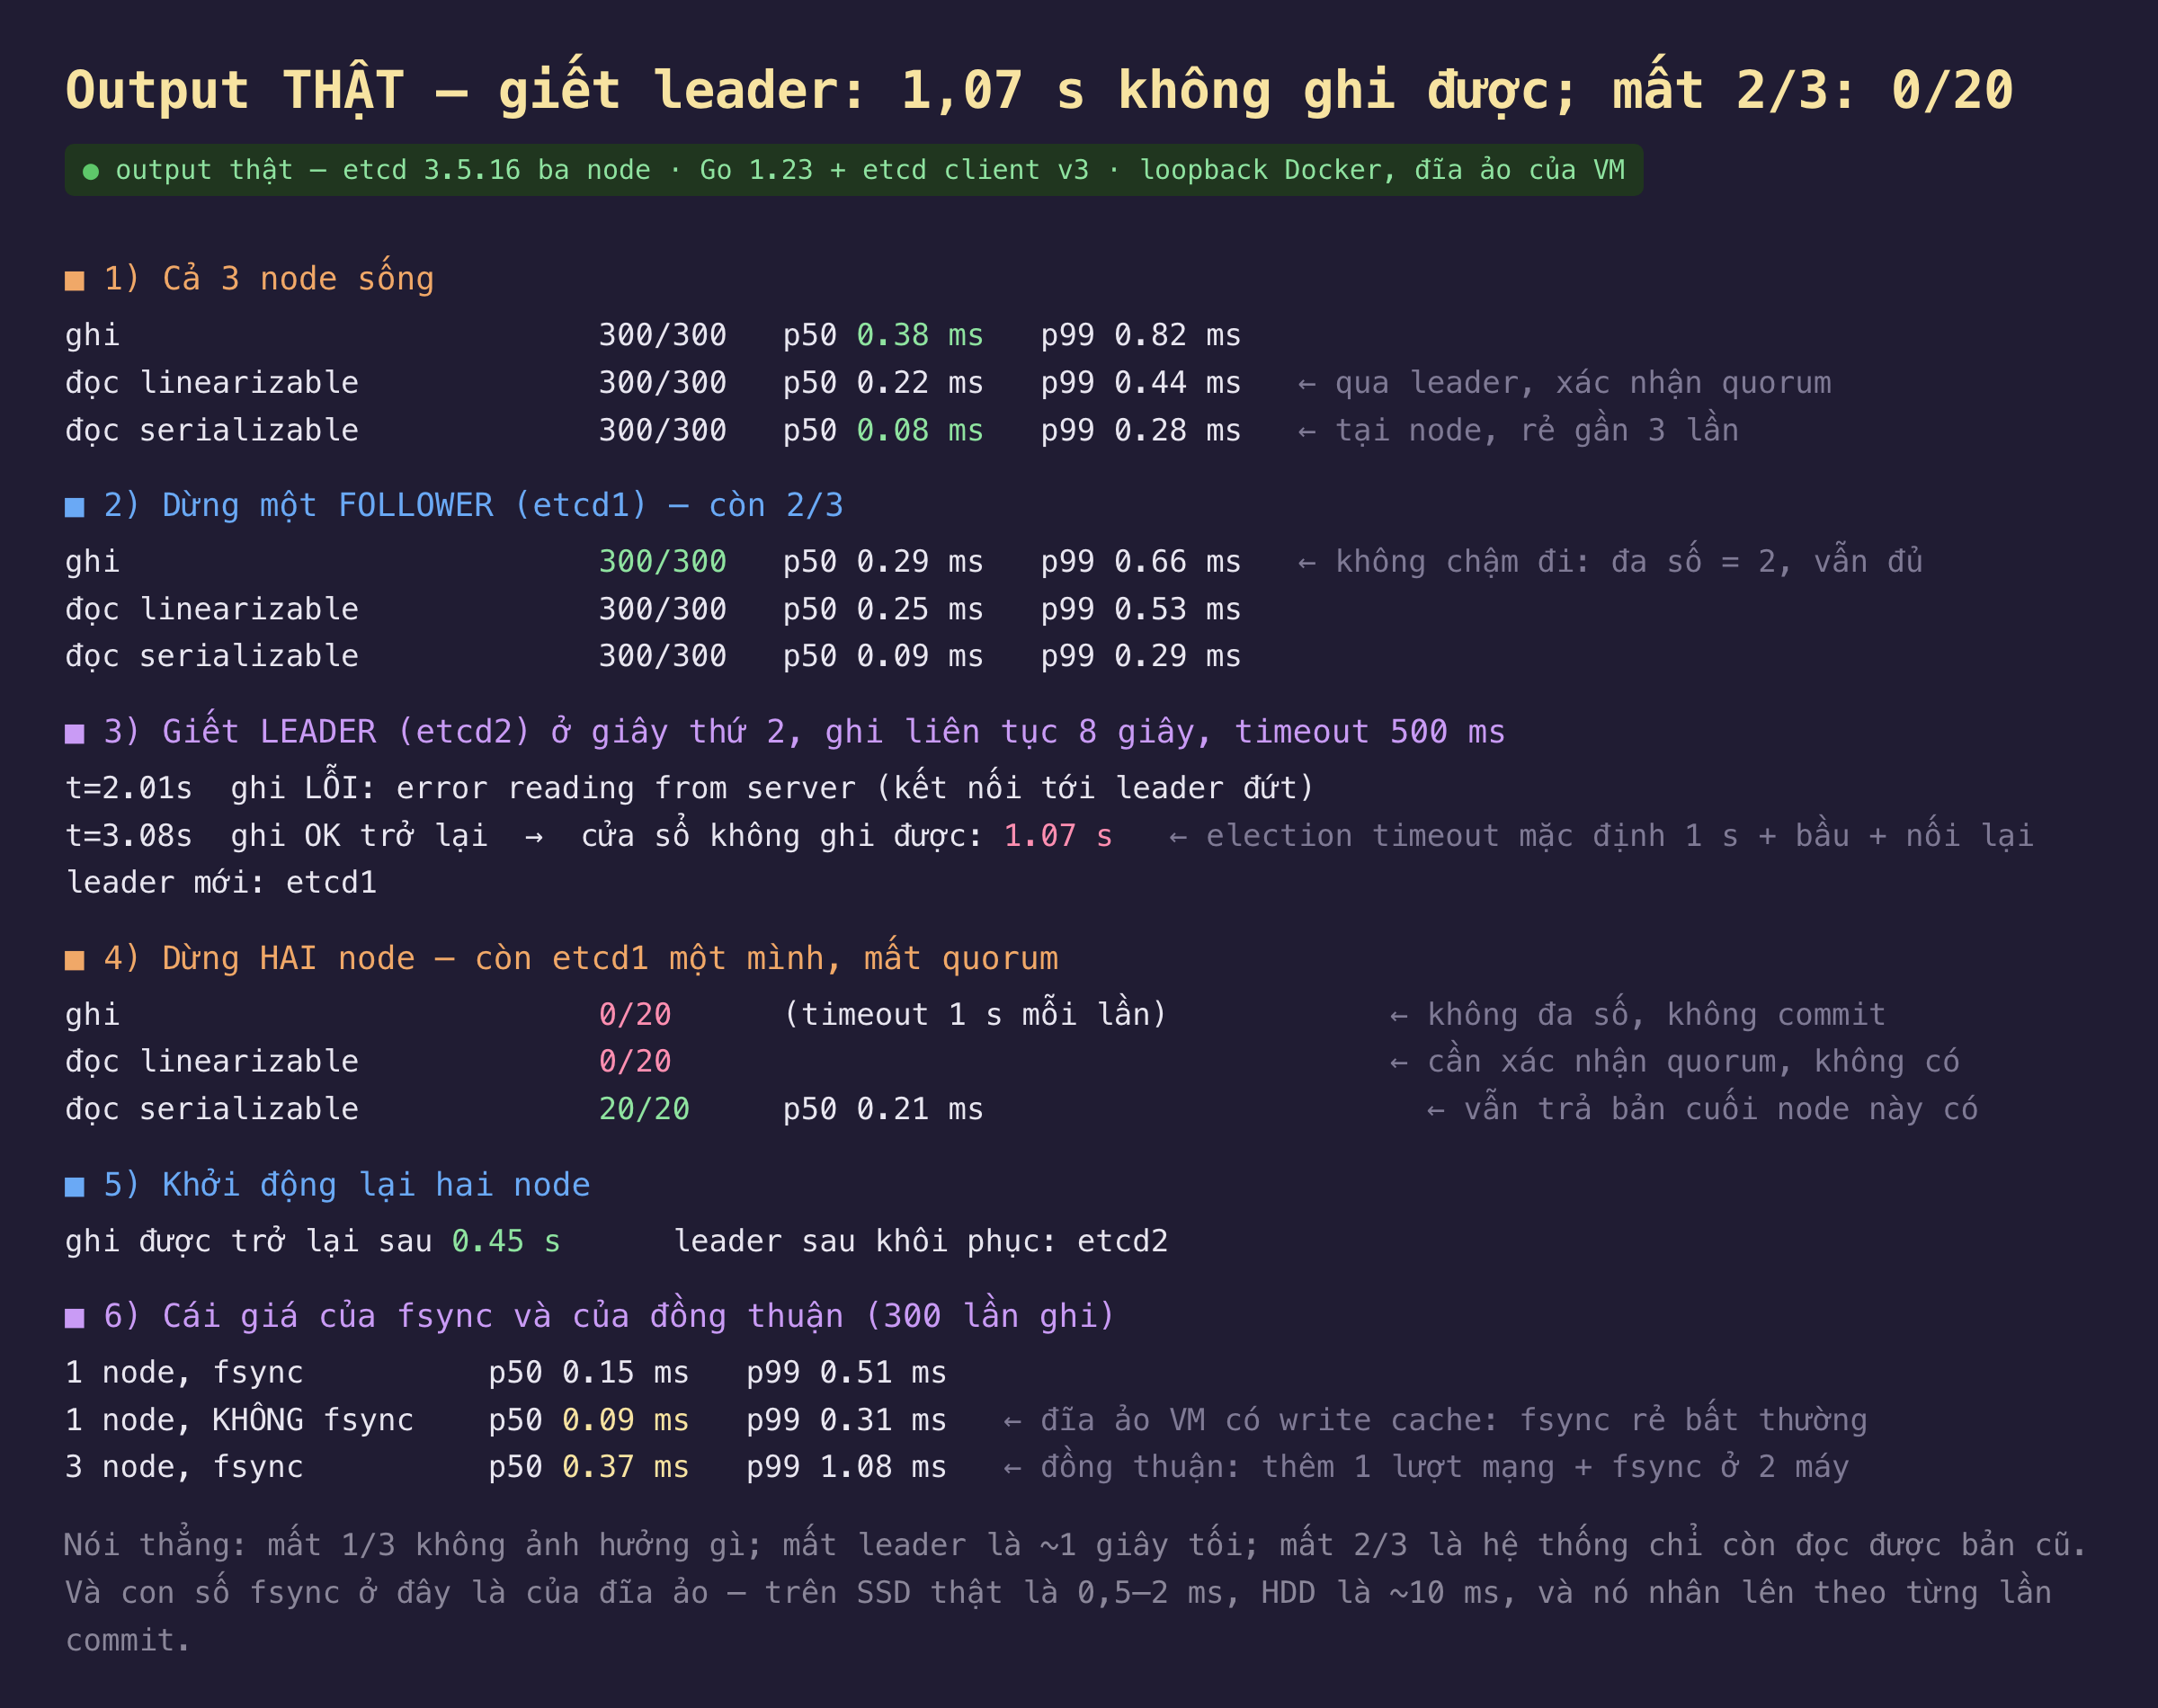
Hình 2: Kết quả thật qua sáu bước. Mỗi bước là một câu hỏi "chuyện gì xảy ra nếu" được trả lời bằng số thay vì bằng sơ đồ.
| trạng thái cụm | ghi | đọc linearizable | đọc serializable |
|---|---|---|---|
| 3/3 sống | 300/300, p50 0,38 ms | 300/300, 0,22 ms | 300/300, 0,08 ms |
| 2/3 (mất follower) | 300/300, 0,29 ms | 300/300 | 300/300 |
| giết leader | 1,07 s không ghi được, rồi tự hồi | — | — |
| 1/3 (mất hai node) | 0/20 | 0/20 | 20/20 |
| bật lại hai node | ghi được sau 0,45 s | — | — |
Mất một follower: không ảnh hưởng gì. 300/300 lần ghi thành công, p50 còn hơi nhanh hơn (0,29 so với 0,38 ms) vì leader chỉ cần chờ một follower thay vì chọn nhanh nhất trong hai. Đây là lời hứa cốt lõi của Raft ba node: một máy chết là chuyện bình thường, không phải sự cố. Và cũng là lý do cụm thường có số lẻ: bốn node vẫn chỉ chịu được một node chết (đa số là ba), tốn thêm một máy mà không thêm khả năng chịu lỗi.
Giết leader: 1,07 giây tối. Lúc 2,01 s kết nối tới leader đứt và lần ghi đầu tiên lỗi. Các follower chờ election timeout (1 giây mặc định) để chắc leader thật sự im lặng chứ không chỉ chậm — chính câu hỏi "chết hay chậm" của phần 3 — rồi bầu, etcd1 thắng, client nối lại, và lúc 3,08 s ghi OK. Cửa sổ 1,07 s gần như toàn bộ là election timeout; chỉnh nó xuống 200 ms là cửa sổ ngắn đi năm lần, với giá là mạng chậm 200 ms cũng gây bầu lại oan.
Mất hai node: không ghi được gì, và không đọc linearizable được gì. Node sót lại không thể gom đa số nên không commit — 0/20 lần ghi, mỗi lần chờ hết 1 giây timeout. Đọc linearizable cũng 0/20, vì nó cần leader xác nhận với đa số rằng mình còn là leader. Nhưng đọc serializable 20/20: node sót lại trả bản cuối cùng nó có, không hỏi ai. Đây là cách etcd — và mọi hệ Raft — hành xử khi mất quorum: từ chối ghi và từ chối hứa, nhưng vẫn cho đọc nếu bạn chấp nhận có thể cũ. Không có bản ghi nào bị mất hay bị tách đôi; hệ thống chọn dừng thay vì chọn sai. Phần 12 sẽ cắt mạng thật thay vì dừng tiến trình để xem lời hứa đó có giữ khi cả hai phía đều sống.
Bật lại: 0,45 giây. Hai node khởi động, bắt kịp log từ node sót lại (hoặc ngược lại), bầu leader, nhận ghi. Nhanh hơn giết leader vì không phải chờ election timeout để phát hiện — node mới lên biết ngay là mình cần bầu.
Cái giá của đồng thuận. Một node etcd đơn ghi ở 0,15 ms; ba node ở 0,37 ms — thêm một lượt mạng tới follower và một fsync ở máy khác, nhân 2,5 lần. Tắt fsync trên node đơn chỉ đưa 0,15 xuống 0,09 ms: đĩa ảo của máy ảo Docker có write cache nên fsync gần như miễn phí ở đây. Trên SSD thật fsync là 0,5–2 ms, HDD khoảng 10 ms, và nó nằm trên đường găng của mỗi commit — đó là lý do etcd khuyến nghị SSD và cảnh báo khi fsync vượt 10 ms.
Đánh đổi cần cân nhắc
Ba hay năm node. Ba chịu được một node chết; năm chịu được hai, nhưng mỗi commit phải chờ ba fsync thay vì hai và leader phải gửi cho bốn follower. etcd khuyến nghị tối đa năm; bảy thì chậm hơn mà hiếm khi cần. Và số node chẵn là lãng phí thuần tuý.
Election timeout là nút chỉnh duy nhất cho "tối bao lâu". Mặc định 1 s (heartbeat 100 ms) hợp với mạng trong một trung tâm dữ liệu. Cụm trải nhiều vùng cần tăng lên (etcd gợi ý 5 s cho liên lục địa) — tức mất leader là 5 giây không ghi — vì hạ xuống là RTT cao kích hoạt bầu lại liên tục, và mỗi lần bầu là một lần tối.
Serializable read là đánh đổi có ý thức, không phải tối ưu hoá miễn phí. Rẻ gần ba lần và sống sót khi mất quorum, nhưng mục 4 cho thấy nó trả lời kể cả khi không ai dám hứa đó là bản mới nhất. Dùng cho dashboard, cache, cấu hình đọc nhiều; không dùng để quyết định "khoá còn của tôi không" — chuyện đó phải là linearizable, hoặc tốt hơn là Txn của phần 4.
Raft hứa an toàn, không hứa sẵn sàng. Mọi con số 0/20 ở mục 4 là Raft làm đúng việc: thà không phục vụ còn hơn phục vụ sai. Nếu ứng dụng của bạn cần "luôn ghi được, kể cả khi tách mạng" thì Raft là công cụ sai — phần 9 về CRDT là phía bên kia của đánh đổi đó.
Loopback, đĩa ảo, một máy. 0,38 ms ghi là trong mạng Docker trên cùng host; qua mạng thật là RTT cộng fsync thật, thường 2–10 ms. Các tỉ lệ (mất follower không chậm, mất leader tối ~election timeout, mất quorum = 0) không đổi.
Ba ý mang về
- Raft ba node coi một node chết là chuyện thường: mất follower vẫn 300/300 và không chậm đi; mất leader là đúng một election timeout tối (1,07 s) rồi tự hồi. Số node lẻ, và nút chỉnh "tối bao lâu" chính là election timeout.
- Mất quorum là dừng, không phải sai: 0/20 ghi, 0/20 đọc linearizable, nhưng 20/20 đọc serializable — hệ thống từ chối hứa thay vì hứa bừa, và vẫn cho đọc nếu bạn chấp nhận bản có thể cũ.
- Đồng thuận có giá bằng một lượt mạng và fsync ở đa số máy: 0,37 ms so với 0,15 ms ở đây, và fsync trên đĩa thật là 0,5–10 ms trên đường găng của mọi commit — SSD không phải tuỳ chọn cho etcd.
Nguồn
- Diego Ongaro, John Ousterhout — In Search of an Understandable Consensus Algorithm (Extended Version): https://raft.github.io/raft.pdf
- etcd docs — Tuning (heartbeat, election timeout, đĩa): https://etcd.io/docs/v3.5/tuning/
- etcd docs — Linearizability and Serializability trong API guarantees: https://etcd.io/docs/v3.5/learning/api_guarantees/
- etcd docs — Failure modes (mất thiểu số, mất đa số, mất leader): https://etcd.io/docs/v3.5/op-guide/failures/
- The Raft Consensus Algorithm — trực quan hoá: https://raft.github.io/
Phần sau rời đồng thuận để sang sao chép kiểu phổ biến hơn trong backend: PostgreSQL primary–replica. Không quorum, không bầu — chỉ một primary ghi và các replica chép theo, và câu hỏi là chép theo chậm bao nhiêu, đo bằng mili-giây, và chuyện gì xảy ra khi bạn đọc từ replica ngay sau khi ghi vào primary.
