Phần trước là đồng thuận: mọi ghi chờ đa số. Phần này là kiểu sao chép mà hầu hết backend thật sự chạy: một primary PostgreSQL nhận ghi, một hay nhiều replica chép theo WAL, và ứng dụng đẩy đọc sang replica để gỡ tải. Không quorum, không bầu, và không có gì chờ ai — đó vừa là lý do nó nhanh, vừa là lý do nó trả về dữ liệu cũ. Câu hỏi của bài là cũ bao nhiêu, đo bằng mili-giây, và hai cách chữa đổi lấy gì.
Dựng và đo
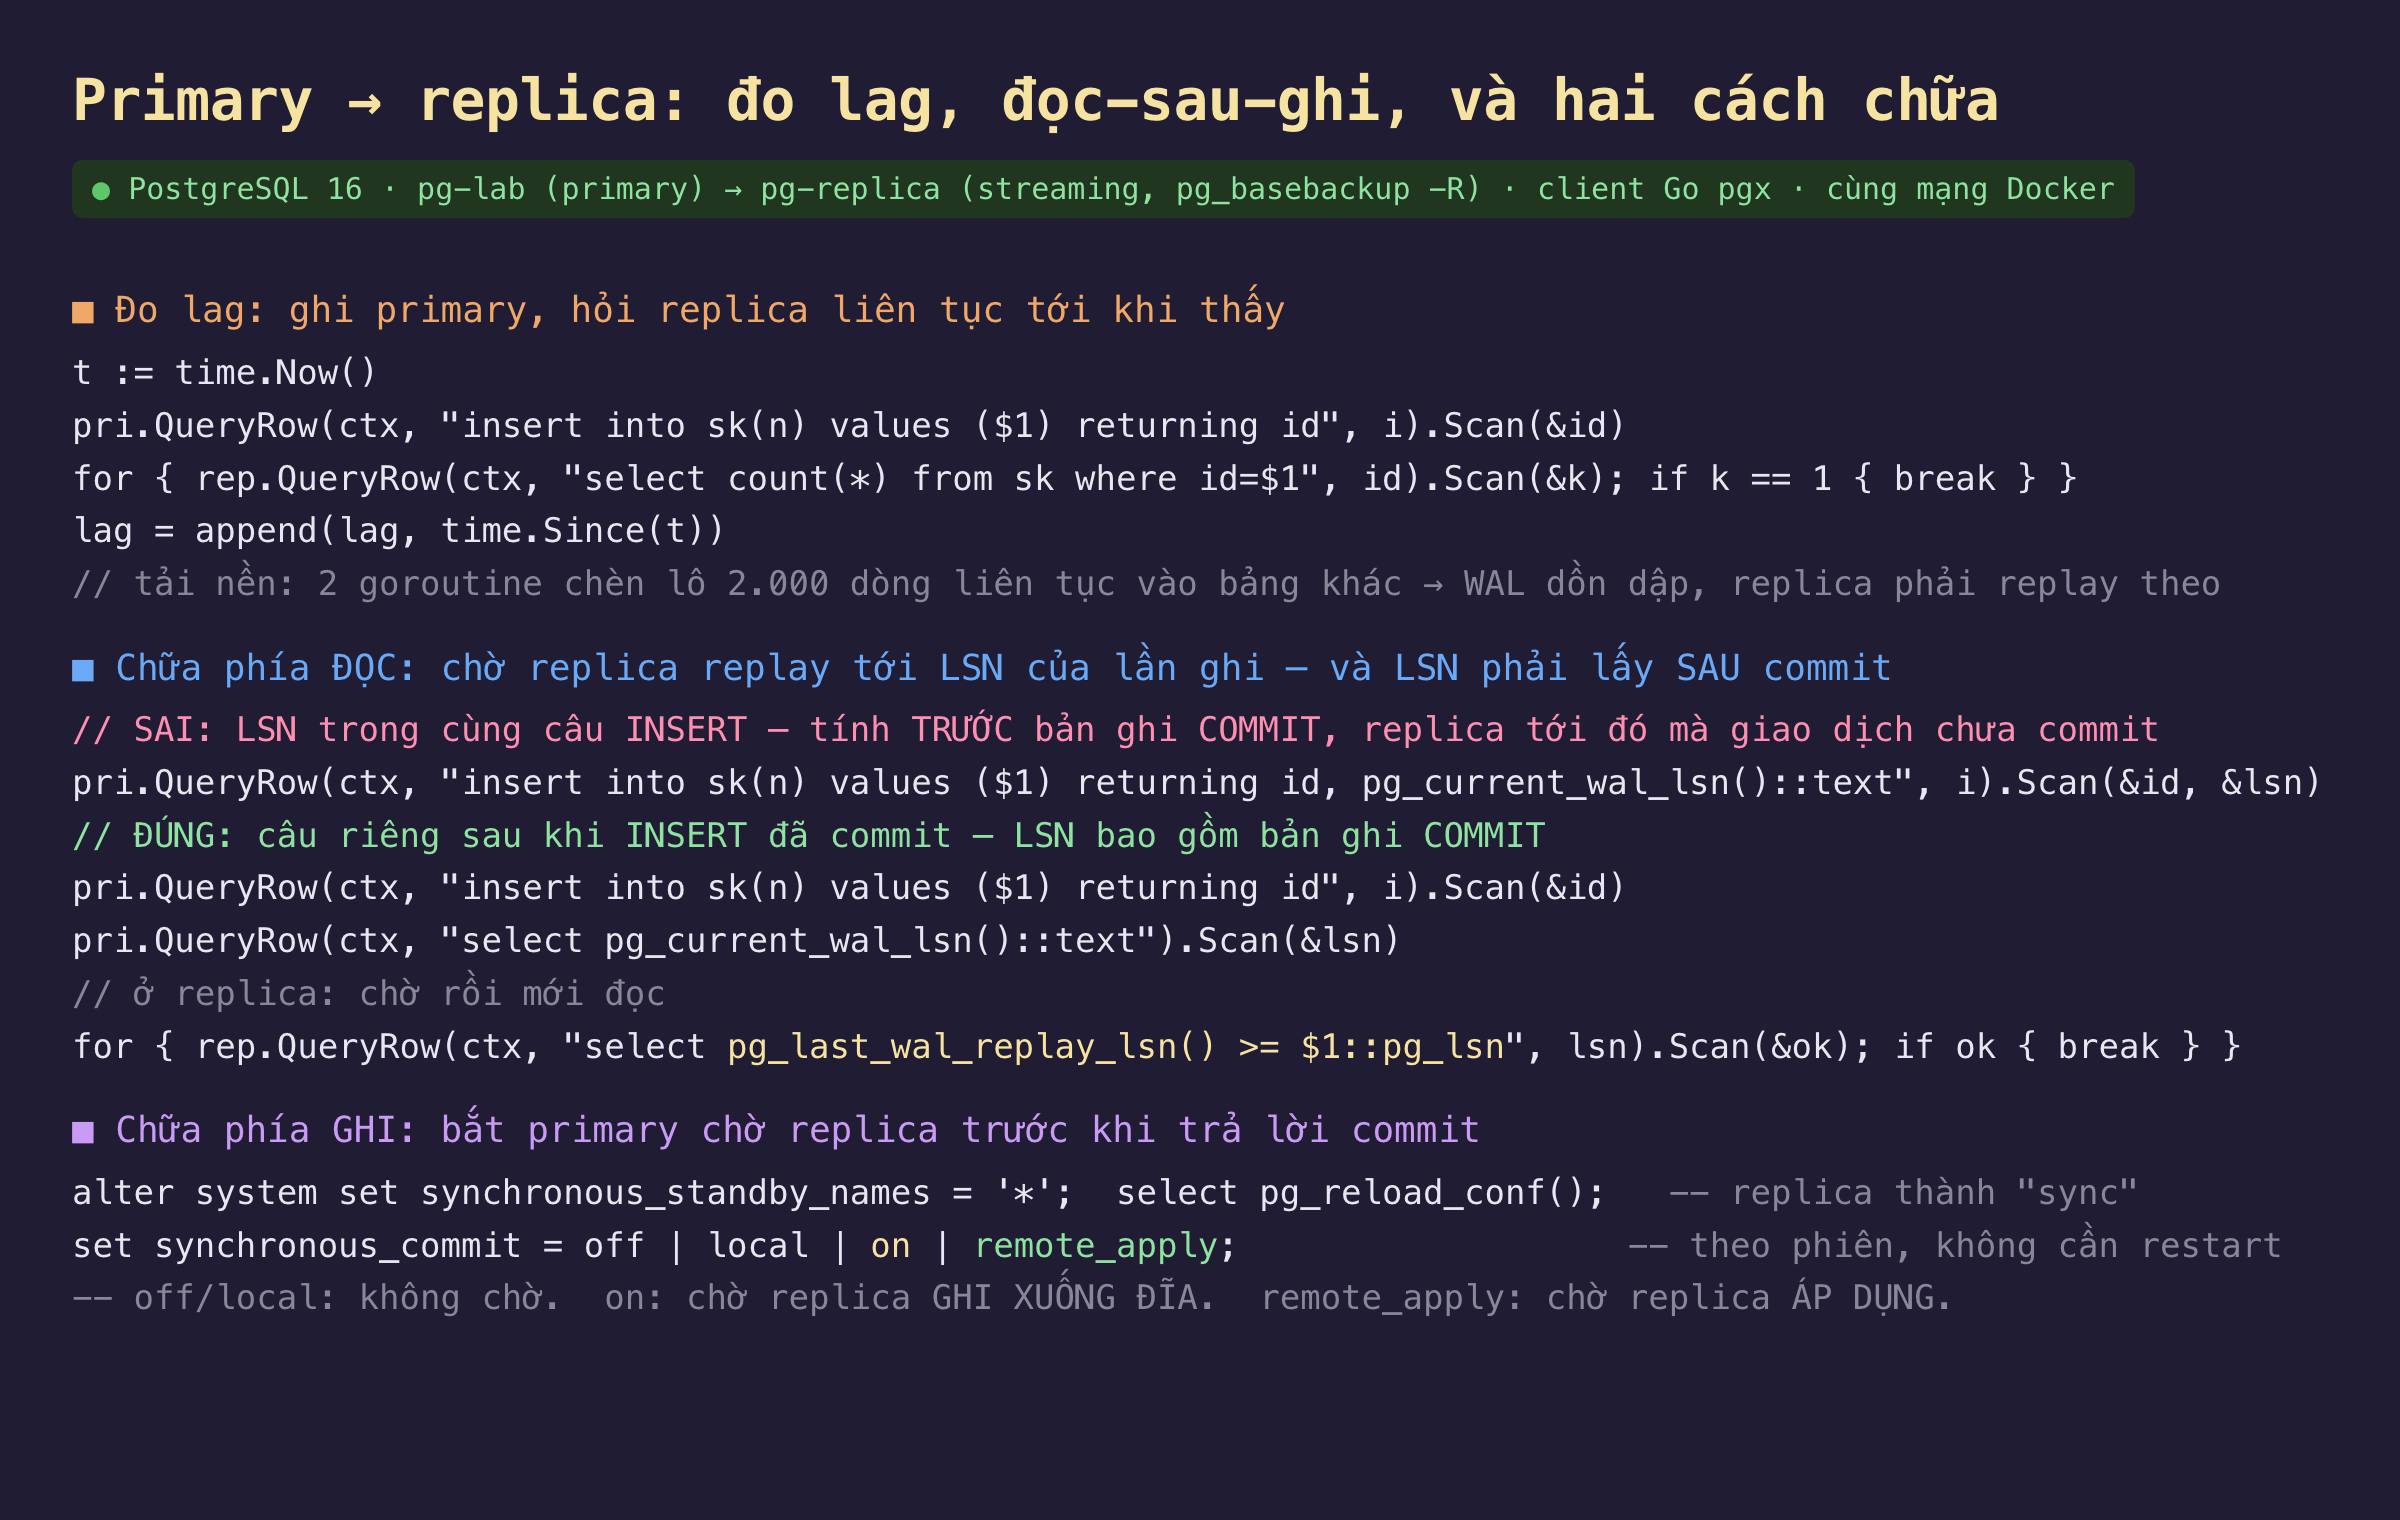
Hình 1: Đo lag bằng cách ghi rồi poll. Chữa phía đọc bằng LSN — với một bẫy về thời điểm lấy LSN. Chữa phía ghi bằng synchronous_commit.
Replica dựng bằng pg_basebackup -R từ primary rồi khởi động: nó nối tới primary, nhận WAL theo luồng và replay. Mặc định là bất đồng bộ — primary trả lời commit ngay khi ghi WAL xuống đĩa của mình, không đợi replica. Client Go dùng hai pool, một tới mỗi bên, và tải nền là hai goroutine chèn lô 2.000 dòng liên tục vào một bảng khác để tạo WAL dồn dập.
Đo thật: lag, đọc-sau-ghi, hai cách chữa
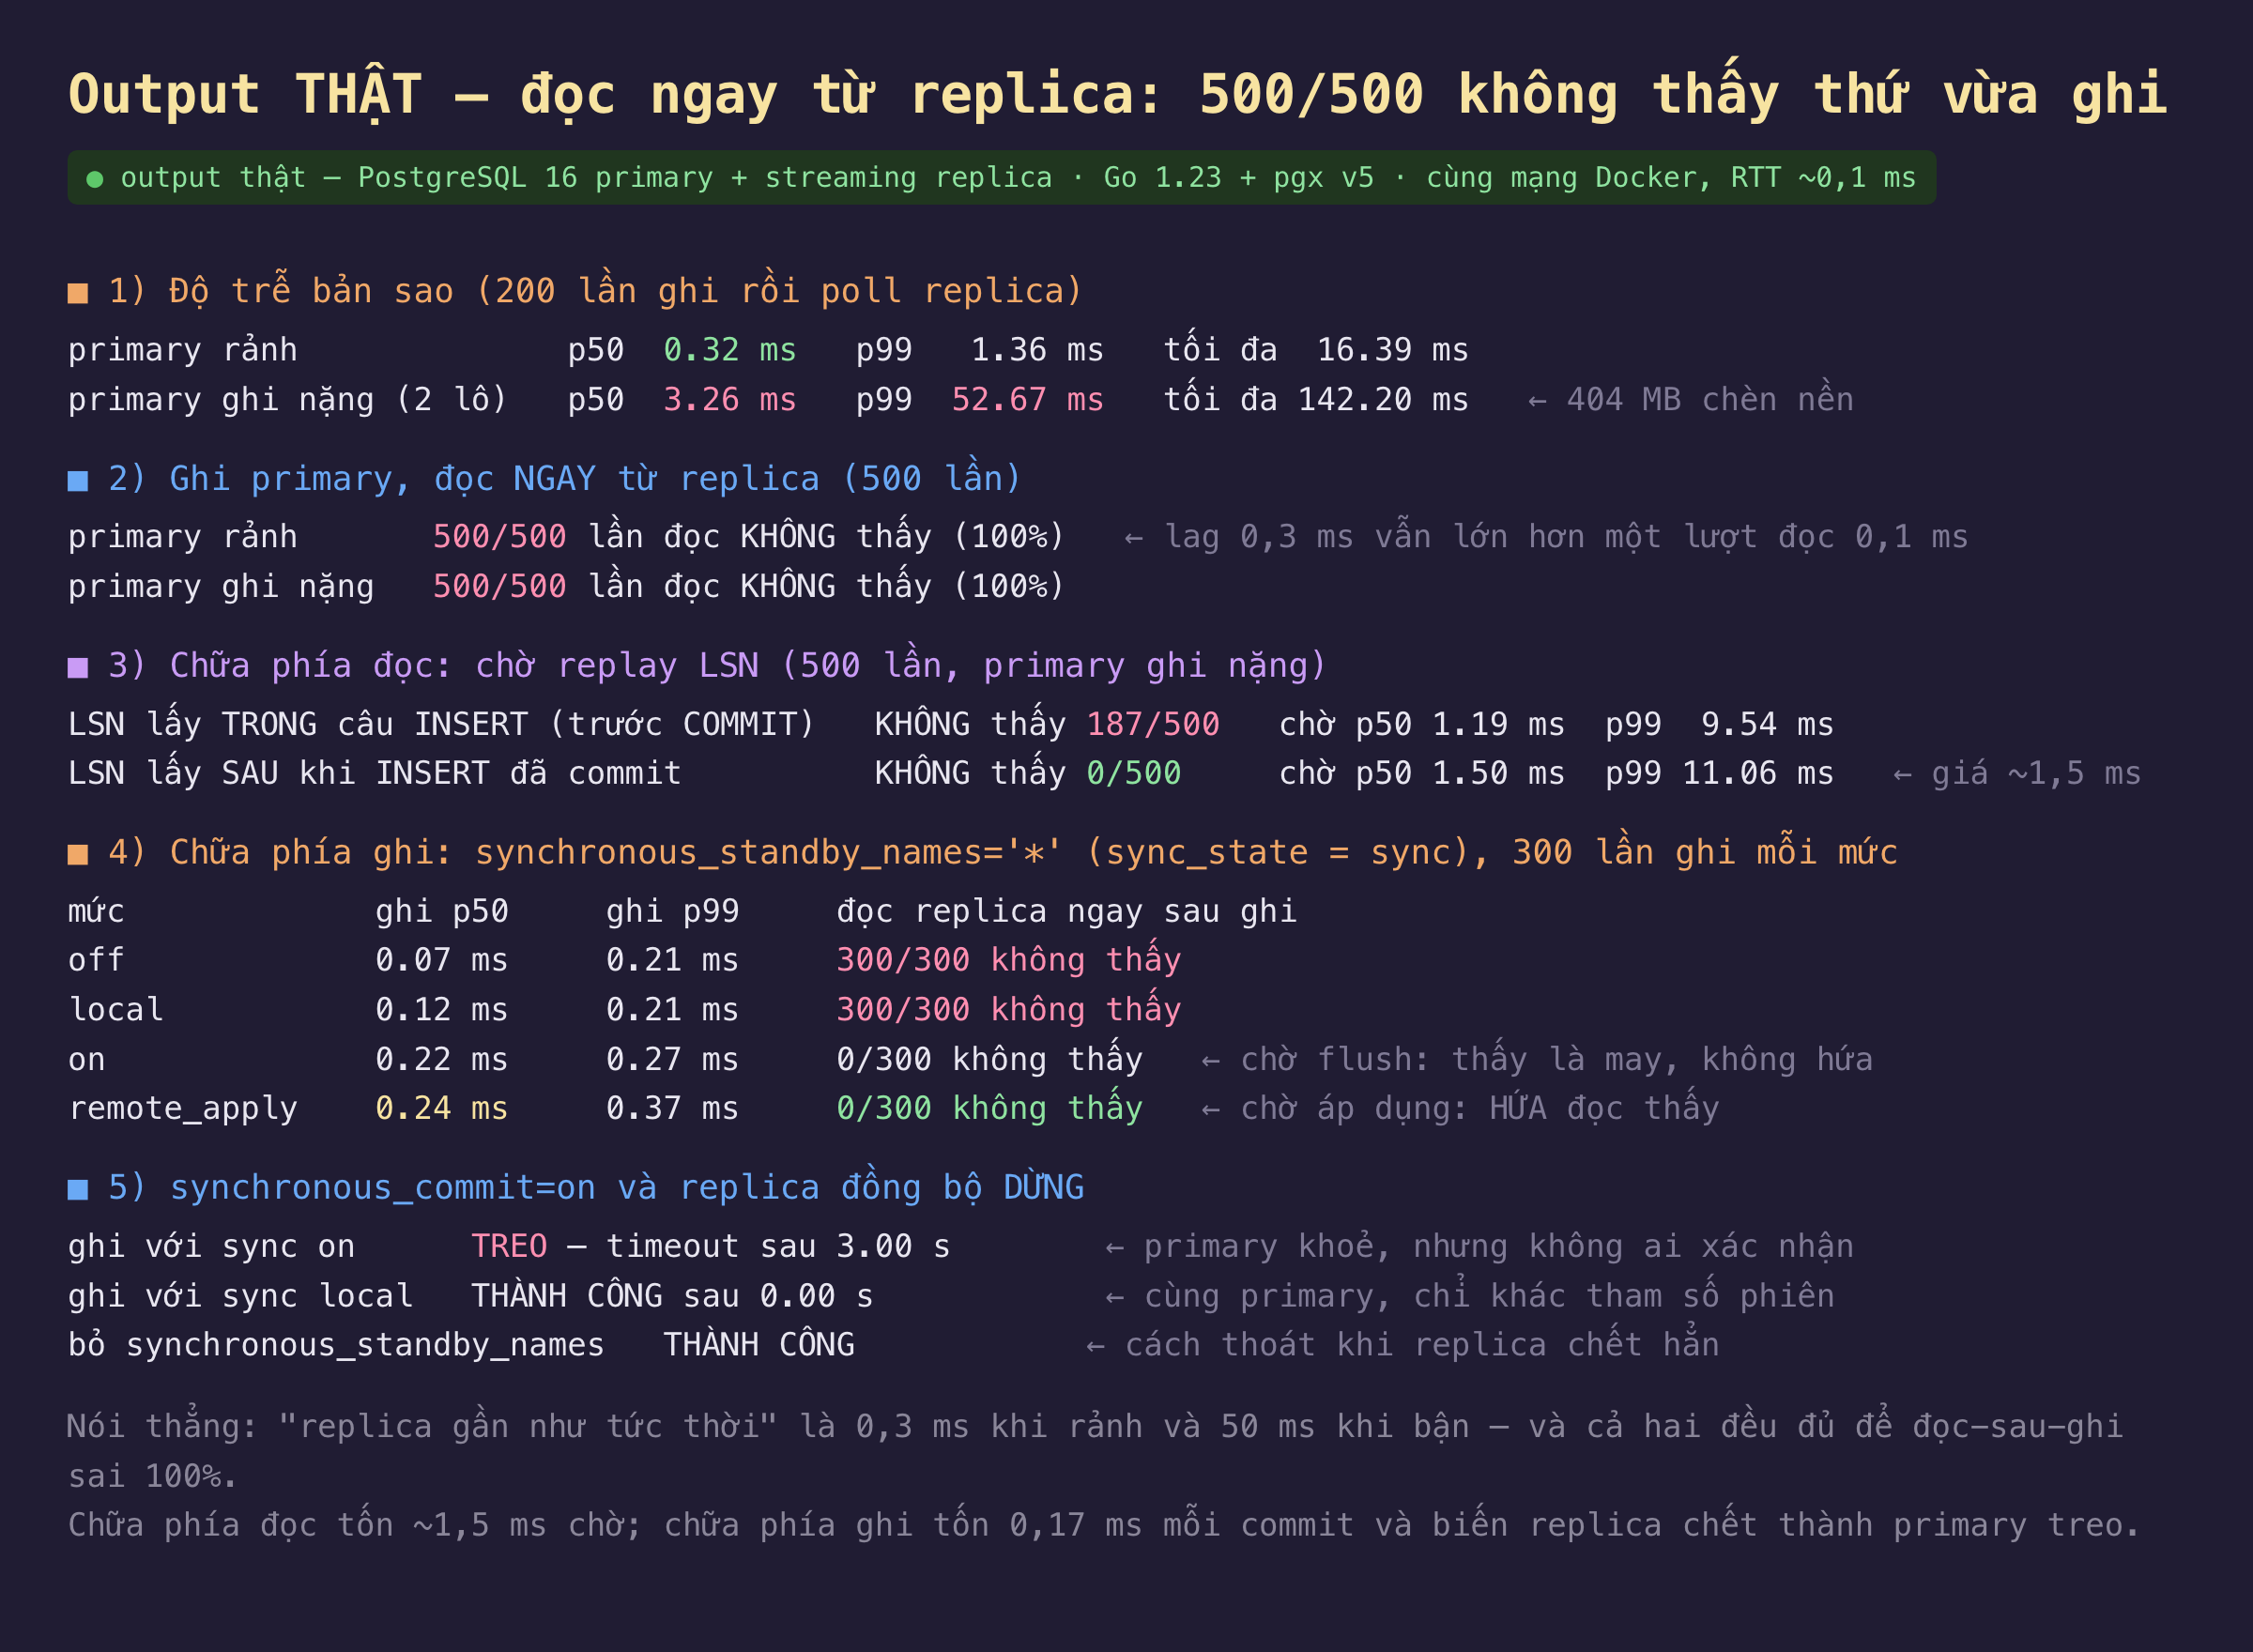
Hình 2: Kết quả thật. Mục 2 là lỗi mà mọi hệ "đọc từ replica" đều có; mục 3 và 4 là hai cách chữa, mỗi cách một hoá đơn.
Lag: 0,32 ms khi rảnh, 52,67 ms p99 khi bận. Lúc primary không làm gì khác, một dòng ghi xuất hiện ở replica sau khoảng một phần ba mili-giây — gần như tức thời theo cảm nhận. Bật hai luồng chèn lô (404 MB trong vài giây), replica phải replay toàn bộ WAL đó theo một tiến trình đơn luồng, và lag p50 nhảy lên 3,26 ms, p99 lên 52,67 ms, tối đa 142 ms. Replica luôn tụt lại đúng vào lúc primary bận nhất — tức là lúc bạn cần gỡ tải nhất.
Đọc-sau-ghi: 500/500 không thấy, kể cả khi rảnh. Kịch bản kinh điển: người dùng bấm lưu (ghi vào primary), trang tải lại (đọc từ replica), và không thấy thứ vừa lưu. Với lag 0,3 ms, có vẻ như xác suất xảy ra phải rất nhỏ — nhưng một lượt đọc qua loopback chỉ tốn 0,1 ms, nhanh hơn lag, nên nó luôn đến trước. 100% chứ không phải "thỉnh thoảng". Qua mạng thật, lượt đọc chậm hơn và tỉ lệ giảm xuống, nhưng không về 0 — và tỉ lệ nhỏ còn khó hơn, vì nó thành lỗi "không tái hiện được".
Chữa phía đọc: chờ LSN, 0/500 — với một bẫy. PostgreSQL đánh số mọi byte WAL bằng LSN. Sau khi ghi, hỏi primary pg_current_wal_lsn(); ở replica, chờ pg_last_wal_replay_lsn() vượt qua số đó rồi mới đọc. Kết quả: 0/500 sai, giá là 1,50 ms chờ p50 (11 ms p99) dưới tải nặng. Nhưng lần đo đầu tiên của mình cho 187/500 vẫn sai — vì lấy LSN trong cùng câu INSERT (RETURNING pg_current_wal_lsn()). Lúc đó bản ghi COMMIT chưa được viết, LSN trỏ vào giữa giao dịch; replica replay tới đó, giao dịch vẫn chưa commit ở phía nó, dòng chưa thấy. Lấy LSN bằng một câu riêng sau khi INSERT đã commit mới đúng. Đây là kiểu lỗi qua được test đơn giản (lúc rảnh, replica kịp cả hai) và chỉ lộ dưới tải.
Chữa phía ghi: synchronous_commit. Khai synchronous_standby_names = '*' để replica thành đồng bộ, rồi chọn mức theo từng phiên:
| mức | ghi p50 | đọc replica ngay sau ghi |
|---|---|---|
off |
0,07 ms | 300/300 không thấy |
local |
0,12 ms | 300/300 không thấy |
on |
0,22 ms | 0/300 |
remote_apply |
0,24 ms | 0/300 |
off và local không chờ replica nên không chữa gì. on chờ replica ghi WAL xuống đĩa — đảm bảo bền, không đảm bảo thấy; 0/300 ở đây là vì replay theo sát flush trên loopback, không phải lời hứa. remote_apply chờ replica áp dụng xong, và đó mới là lời hứa đọc-sau-ghi. Giá: 0,24 so với 0,07 ms, gấp 3,4 lần mỗi commit, cộng mọi mili-giây mạng thật giữa hai máy.
Và cái giá thật sự của đồng bộ: replica chết thì primary treo. Mục 5 dừng replica trong khi synchronous_commit = on: lần ghi treo cho tới timeout 3 giây. Primary hoàn toàn khoẻ, đĩa trống, không khoá — nó chỉ chờ một xác nhận không bao giờ tới. Cùng primary, cùng lúc, phiên khác đặt local thì ghi xong ngay. Cách thoát là bỏ synchronous_standby_names — tức là có người trực phải vào sửa, hoặc một công cụ tự động (Patroni, pg_auto_failover) làm việc đó. Hệ thống đồng bộ với một replica là hệ thống có hai điểm chết thay vì một.
Đánh đổi cần cân nhắc
Chữa phía đọc hay phía ghi. Chờ LSN đặt gánh lên những lượt đọc cần mới (1,5 ms, và chỉ khi người đọc vừa ghi), để mọi lượt đọc khác vẫn hưởng replica rẻ. remote_apply đặt gánh lên mọi lượt ghi, kể cả khi không ai đọc lại ngay. Phần lớn ứng dụng web chọn cách một: ghi xong, nhớ LSN trong session hoặc cookie, và trong vài giây tiếp theo đọc từ primary hoặc chờ replica đuổi kịp LSN đó. Cách hai dành cho dữ liệu mà mất một commit khi primary chết là không chấp nhận được — và lúc đó nên có hai replica đồng bộ để một cái chết không treo primary.
Lag là của một tiến trình replay. Replica áp dụng WAL tuần tự, một luồng, nên nó không đuổi kịp một primary nhiều luồng ghi dồn dập. Lag 52 ms p99 ở đây là với 400 MB; một job nhập liệu lớn hay một VACUUM FULL có thể đẩy lag lên hàng phút. Phải giám sát pg_stat_replication.replay_lag hoặc hiệu pg_last_xact_replay_timestamp(), và định tuyến đọc phải biết rút replica tụt quá ngưỡng ra khỏi vòng.
on không phải remote_apply. Nhiều người bật synchronous_commit = on rồi tin là đọc replica sẽ thấy. Nó chỉ hứa WAL đã nằm trên đĩa replica; replay là bước sau. Bảng ở mục 4 cho 0/300 với on là do loopback — đừng mang con số đó vào production.
Số đo loopback, đĩa ảo. 0,07 ms cho một commit là nhờ fsync rẻ trên đĩa ảo (như phần 5 đã nói). Qua mạng thật, remote_apply cộng thêm một RTT đầy đủ, thường 0,5–2 ms trong cùng trung tâm dữ liệu và hàng chục ms liên vùng — lúc đó chênh lệch với off không còn là 0,17 ms.
Ba ý mang về
- Replica luôn cũ, và cũ nhiều nhất đúng lúc bận nhất: 0,32 ms khi rảnh, 52,67 ms p99 dưới tải, và đọc ngay sau ghi sai 500/500 lần vì một lượt đọc nhanh hơn lag. "Gần như tức thời" không phải là "tức thời".
- Chữa phía đọc bằng LSN là rẻ và có chọn lọc (1,5 ms, chỉ cho người vừa ghi), nhưng LSN phải lấy sau commit — lấy trong câu INSERT vẫn sai 187/500 và chỉ lộ dưới tải.
- Chữa phía ghi bằng
remote_applylà lời hứa thật với giá mỗi commit (0,24 so với 0,07 ms) và với một điểm chết mới: replica đồng bộ dừng là primary treo cho tới khi có người đổi tham số.onkhông phảiremote_apply.
Nguồn
- PostgreSQL docs — Streaming Replication và Synchronous Replication: https://www.postgresql.org/docs/16/warm-standby.html#SYNCHRONOUS-REPLICATION
- PostgreSQL docs — synchronous_commit (các mức và ý nghĩa): https://www.postgresql.org/docs/16/runtime-config-wal.html#GUC-SYNCHRONOUS-COMMIT
- PostgreSQL docs — pg_stat_replication, pg_last_wal_replay_lsn: https://www.postgresql.org/docs/16/monitoring-stats.html#MONITORING-PG-STAT-REPLICATION-VIEW
- Martin Kleppmann — Designing Data-Intensive Applications, chương 5 Replication, mục Reading Your Own Writes
- Patroni — Replication modes (đồng bộ và failover tự động): https://patroni.readthedocs.io/en/latest/replication_modes.html
Phần sau đổi câu hỏi: không phải "bản sao có kịp không" mà "dữ liệu này nằm ở máy nào" — consistent hashing, và đo trên một triệu khoá xem thêm một node thì bao nhiêu khoá phải chuyển chỗ.
