Hai phần trước nói mạng không tin được và đồng hồ không tin được. Phần này ghép cả hai vào một công cụ mà hầu như ai cũng từng viết trong mười phút: khoá phân tán bằng SET key value NX PX ttl. Nó đúng — cho tới khi tiến trình giữ khoá không chết mà chỉ chậm: GC dừng vài trăm mili-giây, máy ảo bị tạm dừng, một breakpoint trong debugger. Khoá hết hạn, người khác lấy, rồi tiến trình đầu tỉnh dậy và tiếp tục như chưa có gì. Bài này đo chuyện đó xảy ra bao nhiêu lần, và thứ duy nhất chặn được nó không nằm ở Redis.
Khoá, mở khoá, và token
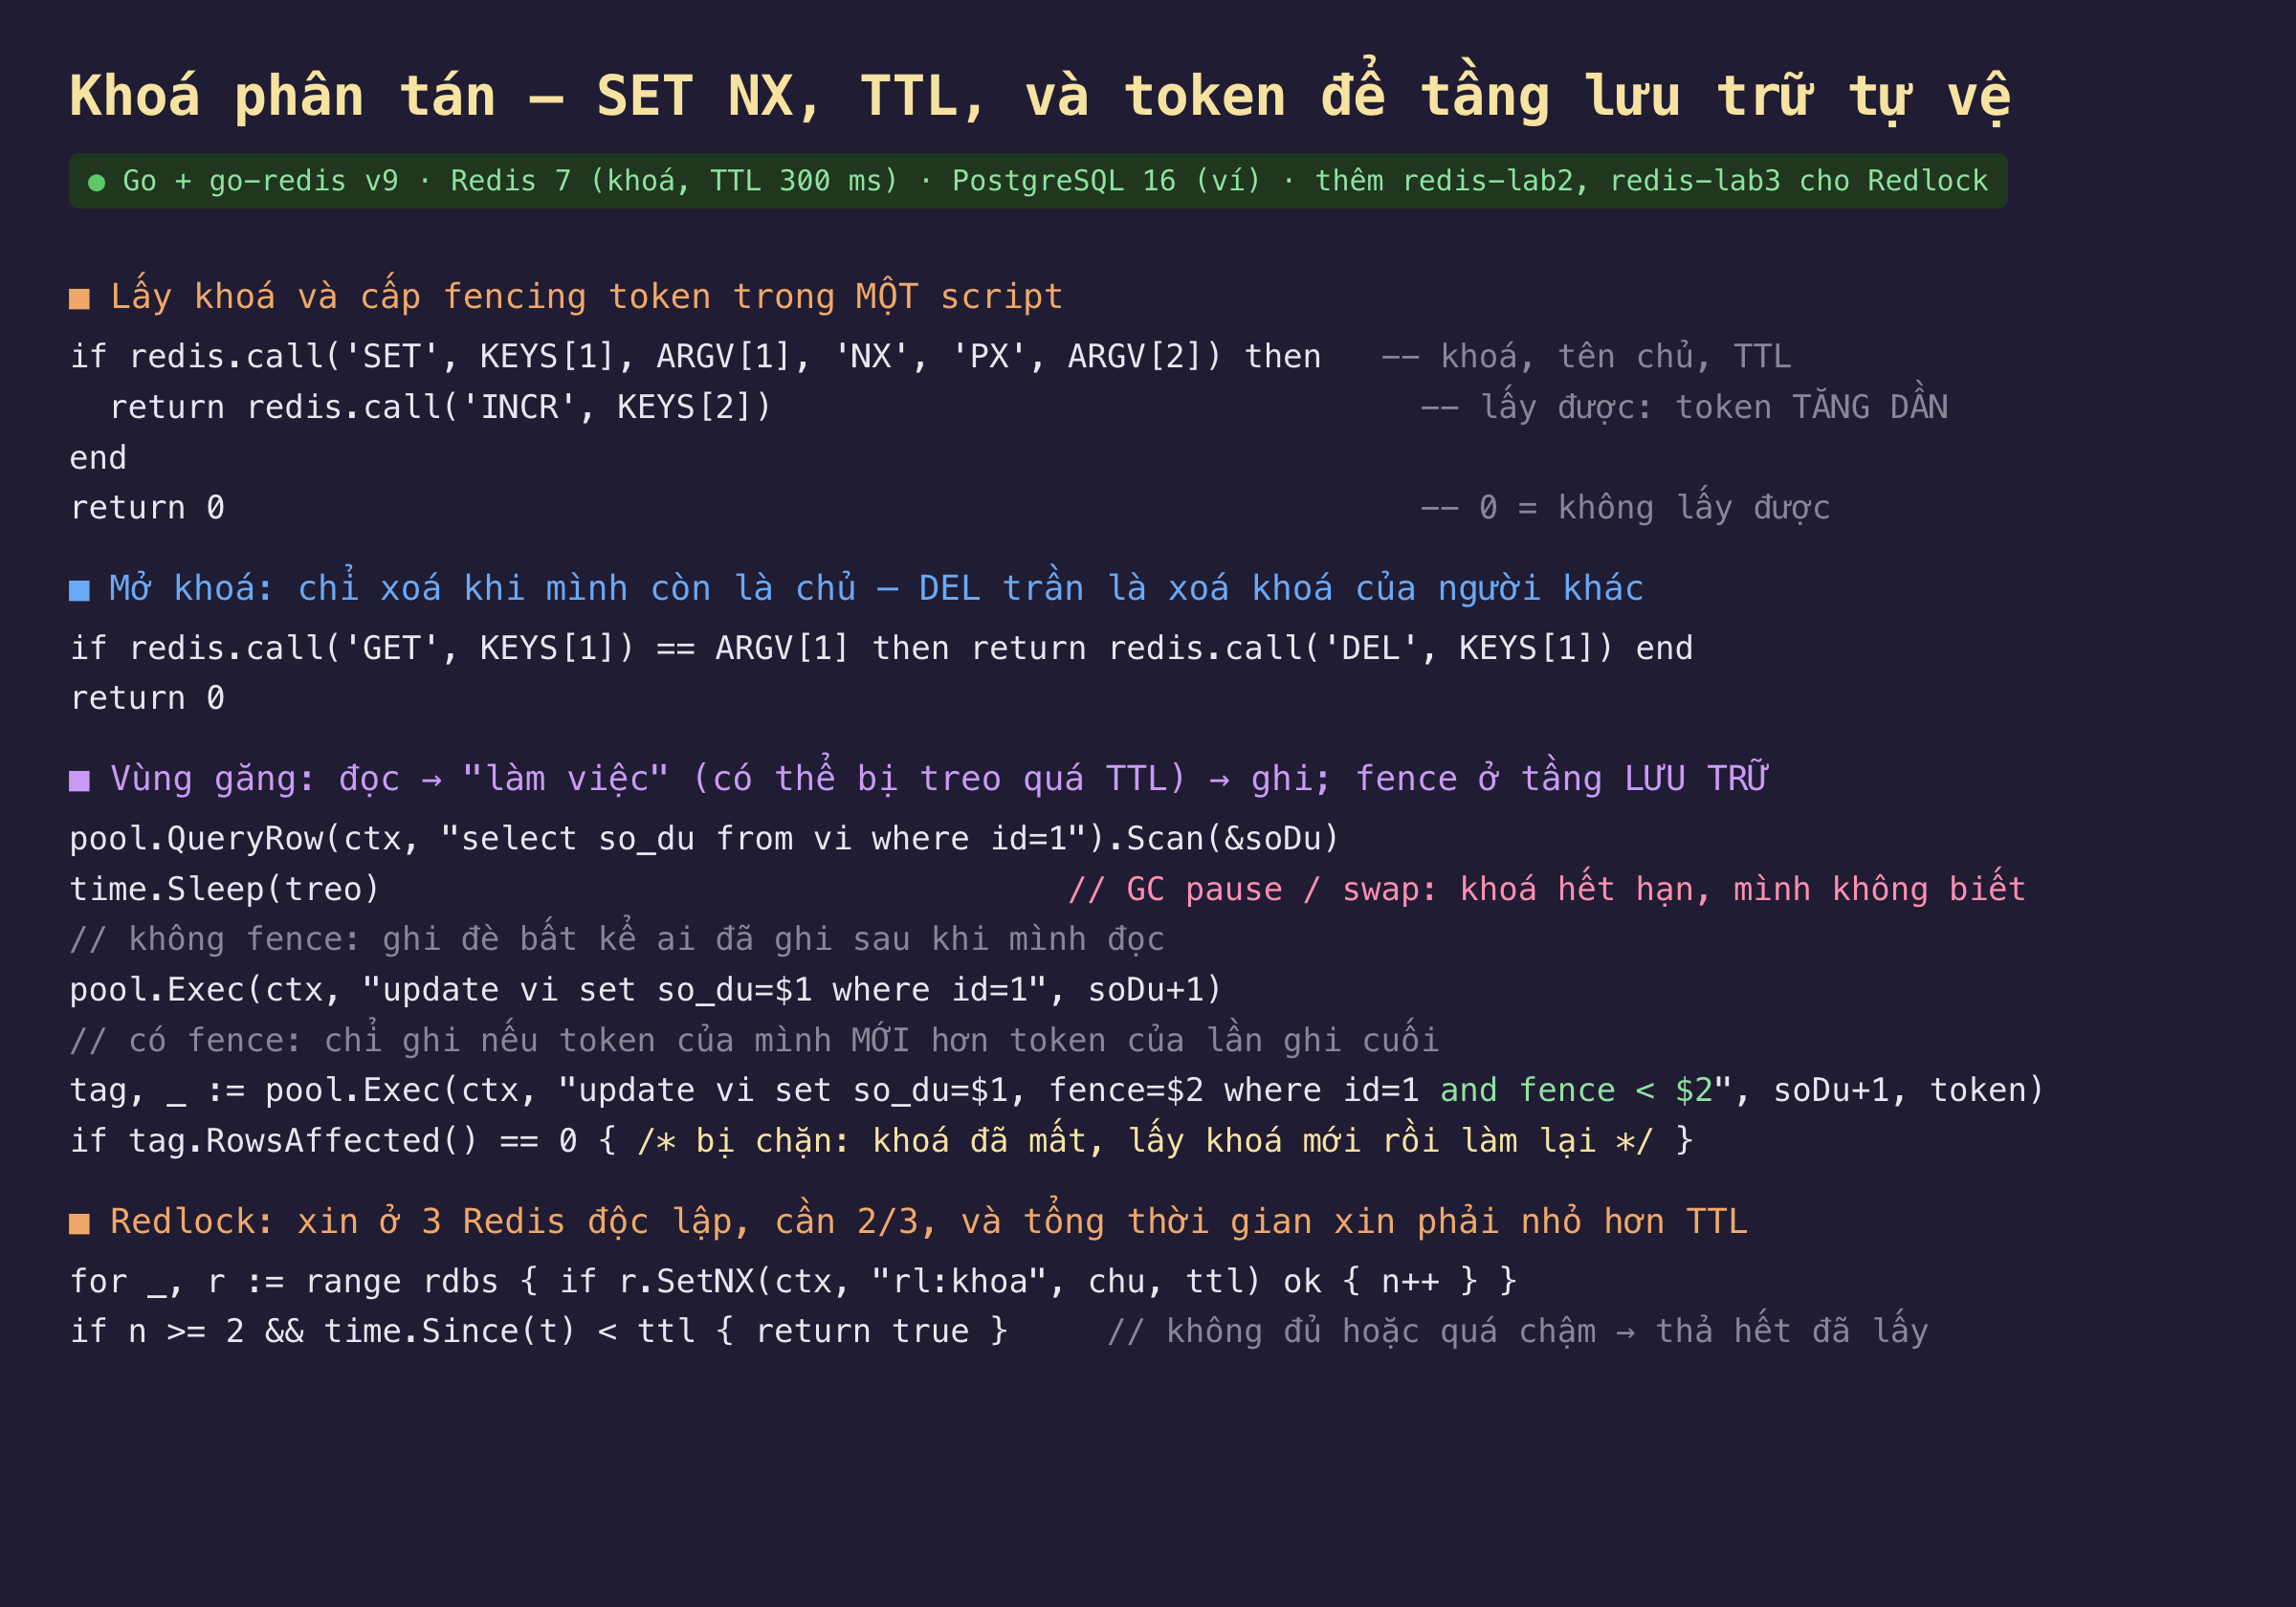
Hình 1: Khoá và token cấp trong một script. Mở khoá so chủ trước khi xoá. Fence kiểm ở tầng lưu trữ, không phải ở Redis. Redlock xin ở ba Redis độc lập.
Ba mảnh, và mảnh nào cũng là cách chữa một lỗi cụ thể:
- Lấy khoá và cấp token trong một script Lua.
SET NX PXgiữ chỗ; nếu được thìINCRmột bộ đếm và trả về. Token tăng dần qua mọi lần lấy khoá — người lấy khoá sau luôn có token lớn hơn người lấy trước. Ở phần 2, đây chính là một đồng hồ logic: nó xếp thứ tự "ai giữ khoá sau ai" mà không cần đồng hồ tường. - Mở khoá chỉ khi mình còn là chủ.
GETrồi so với tên mình rồi mớiDEL, trong một script để không ai chen vào giữa.DELtrần thì xoá bất kể khoá đang là của ai. - Fence ở tầng lưu trữ. Mỗi lần ghi mang theo token, và câu
UPDATEchỉ chạy khi token mới hơn token của lần ghi cuối (WHERE fence < $2). Redis không tham gia bước này — nó chỉ cấp số.
Đo thật: ba cách khoá hỏng
Khoá TTL 300 ms. Vùng găng: đọc số dư ví trong PostgreSQL, cộng 1, ghi lại. Mỗi kịch bản 100 vòng:
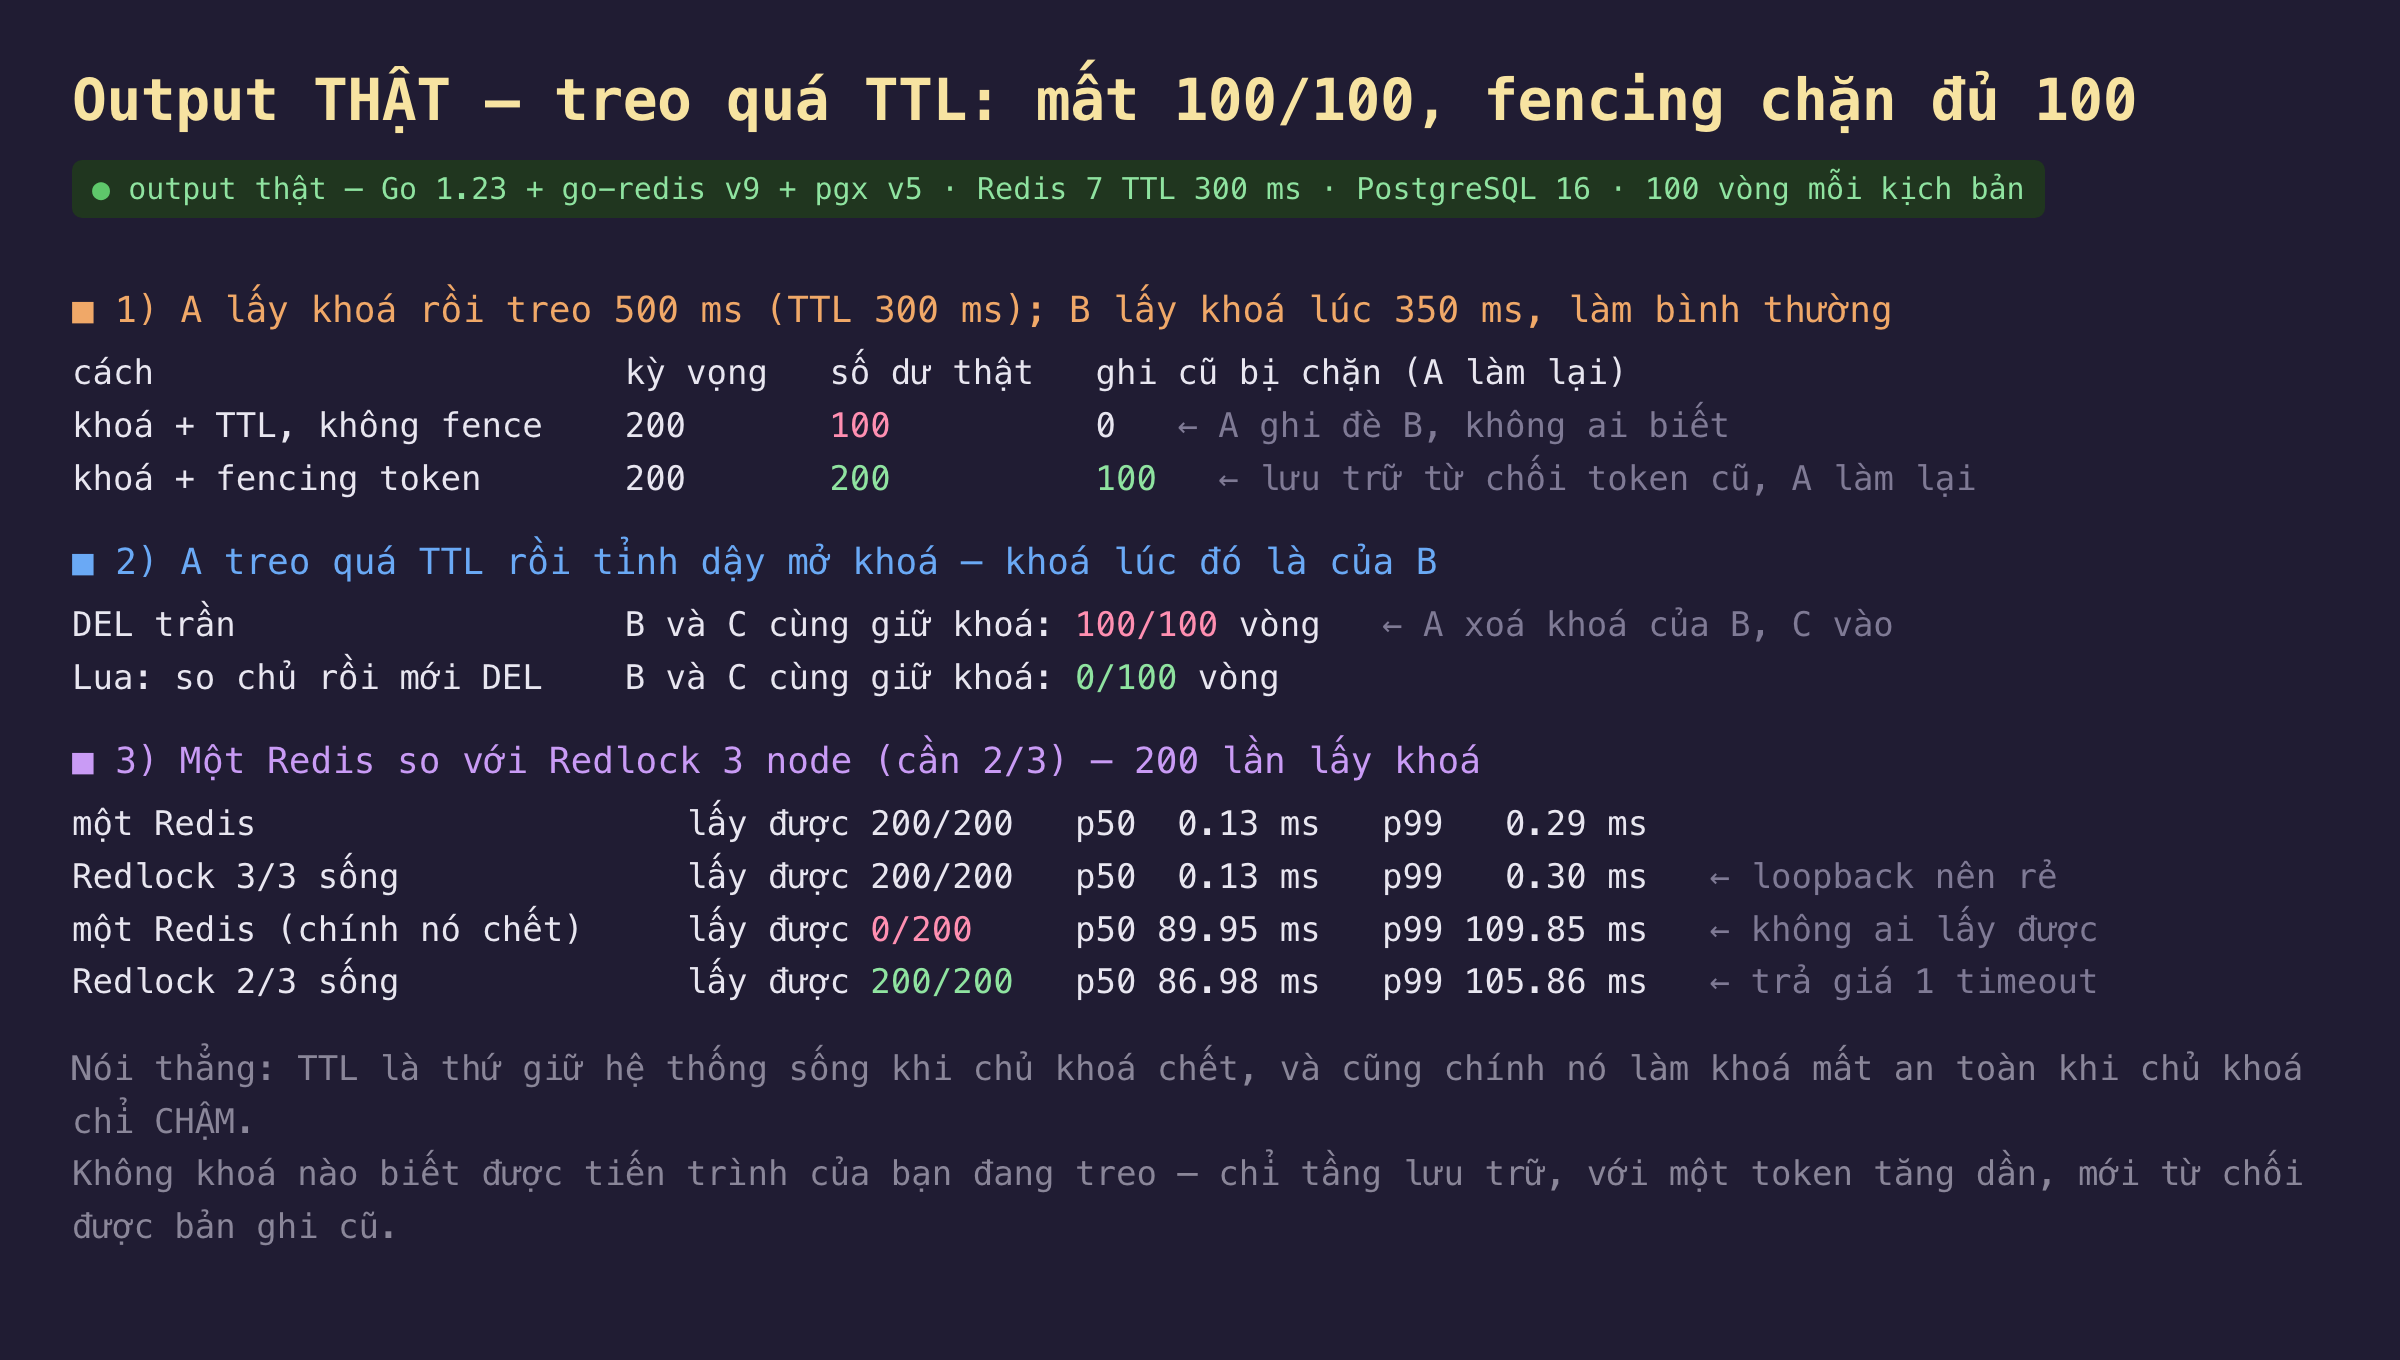
Hình 2: Kết quả thật. Mục 1 là lỗi im lặng nhất, mục 2 là lỗi dễ mắc nhất, mục 3 là câu hỏi "một Redis có đủ không".
Mục 1 — treo quá TTL. A lấy khoá, đọc số dư, rồi treo 500 ms (giả lập bằng Sleep, nhưng GC pause hay VM bị tạm dừng cho đúng hiệu ứng này). Lúc 300 ms khoá hết hạn. Lúc 350 ms B lấy được khoá, đọc, cộng 1, ghi, thả khoá. Lúc 500 ms A tỉnh dậy, không hề biết khoá đã mất, ghi số dư nó đọc từ trước cộng 1 — đè lên bản của B. 100 vòng, 100 cập nhật của B biến mất, số dư 100 thay vì 200. Không exception, không log, không 409: với A mọi thứ thành công.
Thêm fencing token: B lấy khoá sau A nên token của B lớn hơn; B ghi kèm token, cột fence giờ là token của B. A tỉnh dậy, UPDATE ... WHERE fence < token_của_A — không khớp dòng nào, RowsAffected = 0. A biết mình đã mất khoá, lấy khoá mới (token mới, lớn hơn), đọc lại, ghi lại. 100 bản ghi cũ bị chặn, số dư đúng 200. Điểm mấu chốt: Redis không thể chặn chuyện này vì Redis không biết A đang treo — chỉ tầng lưu trữ, nơi bản ghi cuối cùng hạ cánh, mới có đủ thông tin để từ chối.
Mục 2 — mở khoá bằng DEL trần. A treo quá TTL, B lấy khoá và đang làm việc, A tỉnh dậy và "dọn dẹp" bằng DEL. Khoá của B biến mất. C xin khoá ngay sau đó và được — trong khi B vẫn đang trong vùng găng. 100/100 vòng hai bên cùng giữ khoá. Script so chủ trước khi xoá: 0/100. Lỗi này nằm trong gần như mọi bản khoá tự viết, và nó không cần GC pause dài — chỉ cần vùng găng thỉnh thoảng lâu hơn TTL.
Mục 3 — một Redis hay Redlock. Khi cả ba Redis sống, Redlock (xin ở ba, cần hai) tốn như một Redis trên loopback: 0,13 ms. Khi một Redis chết: Redis đơn — nếu đó là nó — cho 0/200, không ai lấy được khoá nữa và mọi vùng găng dừng; Redlock vẫn 200/200, với giá mỗi lần lấy khoá ăn một timeout 100 ms chờ node chết. Redlock mua tính sẵn sàng của việc lấy khoá, không mua tính đúng đắn: nó vẫn dựa vào TTL và vẫn cần fencing token như mục 1.
Vì sao TTL vừa cứu vừa hại
Không có TTL, tiến trình giữ khoá chết là khoá bị giữ mãi, cả hệ thống dừng. TTL là cách nói "nếu quá lâu không thả thì coi như chết". Nhưng Redis — hay bất kỳ dịch vụ khoá nào — không phân biệt được chết với chậm: cả hai đều là "quá TTL không thấy gì". Khi tiến trình chỉ chậm, TTL trả khoá cho người khác trong lúc chủ cũ vẫn tin mình đang giữ. Đây không phải lỗi cài đặt, là giới hạn của bất kỳ khoá nào dựa trên thời gian — phần 1 đã đo: không có cách nào biết bên kia đang làm gì ngoài việc chờ.
Fencing token thoát khỏi giới hạn đó bằng cách không cần biết ai đang giữ khoá. Tầng lưu trữ chỉ cần biết thứ tự: bản ghi mang số nhỏ hơn số đã thấy thì từ chối. Thứ tự đó là thứ tự lấy khoá, không phải thứ tự theo đồng hồ, nên nó miễn nhiễm với mọi thứ phần 2 đã đo.
Đánh đổi cần cân nhắc
Fencing đòi tầng lưu trữ hợp tác. PostgreSQL thì dễ: một cột và một điều kiện WHERE. Lưu trữ không có so-sánh-rồi-ghi (một API bên thứ ba, một file trên S3 không có If-Match) thì không làm được, và lúc đó khoá chỉ là tối ưu hoá để giảm xung đột, không phải cơ chế để ngăn xung đột. Nên thiết kế với giả định xung đột vẫn xảy ra.
Token phải tăng dần qua mọi lần cấp, kể cả khi Redis khởi động lại. INCR trong demo nằm trong Redis; Redis mất dữ liệu (không bật persistence, hoặc failover sang bản sao chưa đồng bộ) là bộ đếm quay về 0 và token mới nhỏ hơn token cũ — tầng lưu trữ sẽ từ chối người giữ khoá hợp lệ. Hệ thống khoá nghiêm túc (ZooKeeper, etcd) cấp token từ log đã đồng thuận; phần 4 sẽ dùng etcd lease, nơi revision của etcd chính là fencing token miễn phí.
TTL dài hay ngắn. Ngắn (300 ms như demo) thì khoá bị mất oan khi vùng găng thỉnh thoảng chậm; dài (30 giây) thì tiến trình chết thật làm cả hệ thống chờ 30 giây. Cách thường dùng là TTL vừa phải kèm gia hạn định kỳ (watchdog) trong lúc còn làm việc — và chấp nhận rằng watchdog cũng bị treo cùng tiến trình, nên fencing vẫn cần.
Redlock có tranh cãi, và tranh cãi đó đúng chỗ. Lập luận của Martin Kleppmann: Redlock không an toàn khi đồng hồ nhảy hoặc tiến trình treo, và mục 1 ở đây là chính xác kịch bản đó. Lập luận của Salvatore Sanfilippo: Redlock giải quyết tính sẵn sàng khi một node Redis chết, không hứa gì hơn. Cả hai đúng. Dùng Redlock khi khoá là hiệu quả (tránh hai worker làm trùng việc, làm trùng cũng không hỏng); dùng khoá có fencing — hoặc giao dịch trong chính kho dữ liệu — khi khoá là đúng đắn.
Số đo loopback, treo bằng Sleep. 500 ms treo là cố ý để chắc chắn vượt TTL. GC pause thật của Go hiếm khi quá vài ms; của JVM có thể vài giây; VM live-migrate có thể hàng chục giây. Con số 100/100 là của một kịch bản chắc chắn xảy ra; xác suất ngoài đời thấp hơn nhiều — nhưng mỗi lần xảy ra là một cập nhật mất không dấu vết.
Ba ý mang về
- Khoá có TTL mất an toàn khi chủ khoá chỉ chậm, không chết: A treo 500 ms với TTL 300 ms là 100/100 cập nhật của B bị đè, không lỗi, không log. Redis không phân biệt được chậm với chết, và không khoá dựa trên thời gian nào làm được.
- Fencing token ở tầng lưu trữ là thứ duy nhất chặn được: token tăng dần cấp cùng lúc với khoá,
UPDATE ... WHERE fence < tokentừ chối 100/100 bản ghi cũ và A biết để làm lại — số dư đúng 200. Nó cần kho dữ liệu có so-sánh-rồi-ghi. - Mở khoá phải so chủ, và Redlock chỉ mua sẵn sàng:
DELtrần xoá khoá của người khác 100/100 lần; Redlock cho lấy khoá 200/200 khi một Redis chết (Redis đơn: 0/200) nhưng vẫn cần TTL và fencing như mọi khoá khác.
Nguồn
- Martin Kleppmann — How to do distributed locking (fencing token): https://martin.kleppmann.com/2016/02/08/how-to-do-distributed-locking.html
- Salvatore Sanfilippo — Is Redlock safe? (phản hồi): http://antirez.com/news/101
- Redis docs — Distributed Locks with Redis (Redlock): https://redis.io/docs/latest/develop/use/patterns/distributed-locks/
- Redis docs — SET (NX, PX) và EVAL: https://redis.io/docs/latest/commands/set/
- Martin Kleppmann — Designing Data-Intensive Applications, chương 8, mục Fencing tokens
Phần sau chuyển từ "ai giữ khoá" sang "ai là chủ": bầu leader bằng etcd lease, giết leader rồi đo thời gian tới khi có leader mới, và vì sao revision của etcd chính là fencing token miễn phí.
