Mọi thứ khó trong hệ thống phân tán bắt đầu từ một câu nghe tầm thường: gọi hàm qua mạng không giống gọi hàm trong tiến trình. Gọi hàm trong tiến trình có đúng hai kết quả: trả về, hoặc ném lỗi. Gọi qua mạng có kết quả thứ ba: không biết. Request có thể chưa tới, có thể tới và server đã làm nhưng phản hồi không về, có thể đang trên đường. Mọi kỹ thuật trong sê-ri này — idempotency, đồng thuận, khoá phân tán, phát hiện lỗi — đều là cách sống chung với kết quả thứ ba đó.
Bài này không nói lý thuyết. Nó làm hỏng mạng giữa hai container bằng tc netem rồi đo xem "không biết" trông như thế nào bằng số.
Làm hỏng mạng có chủ đích
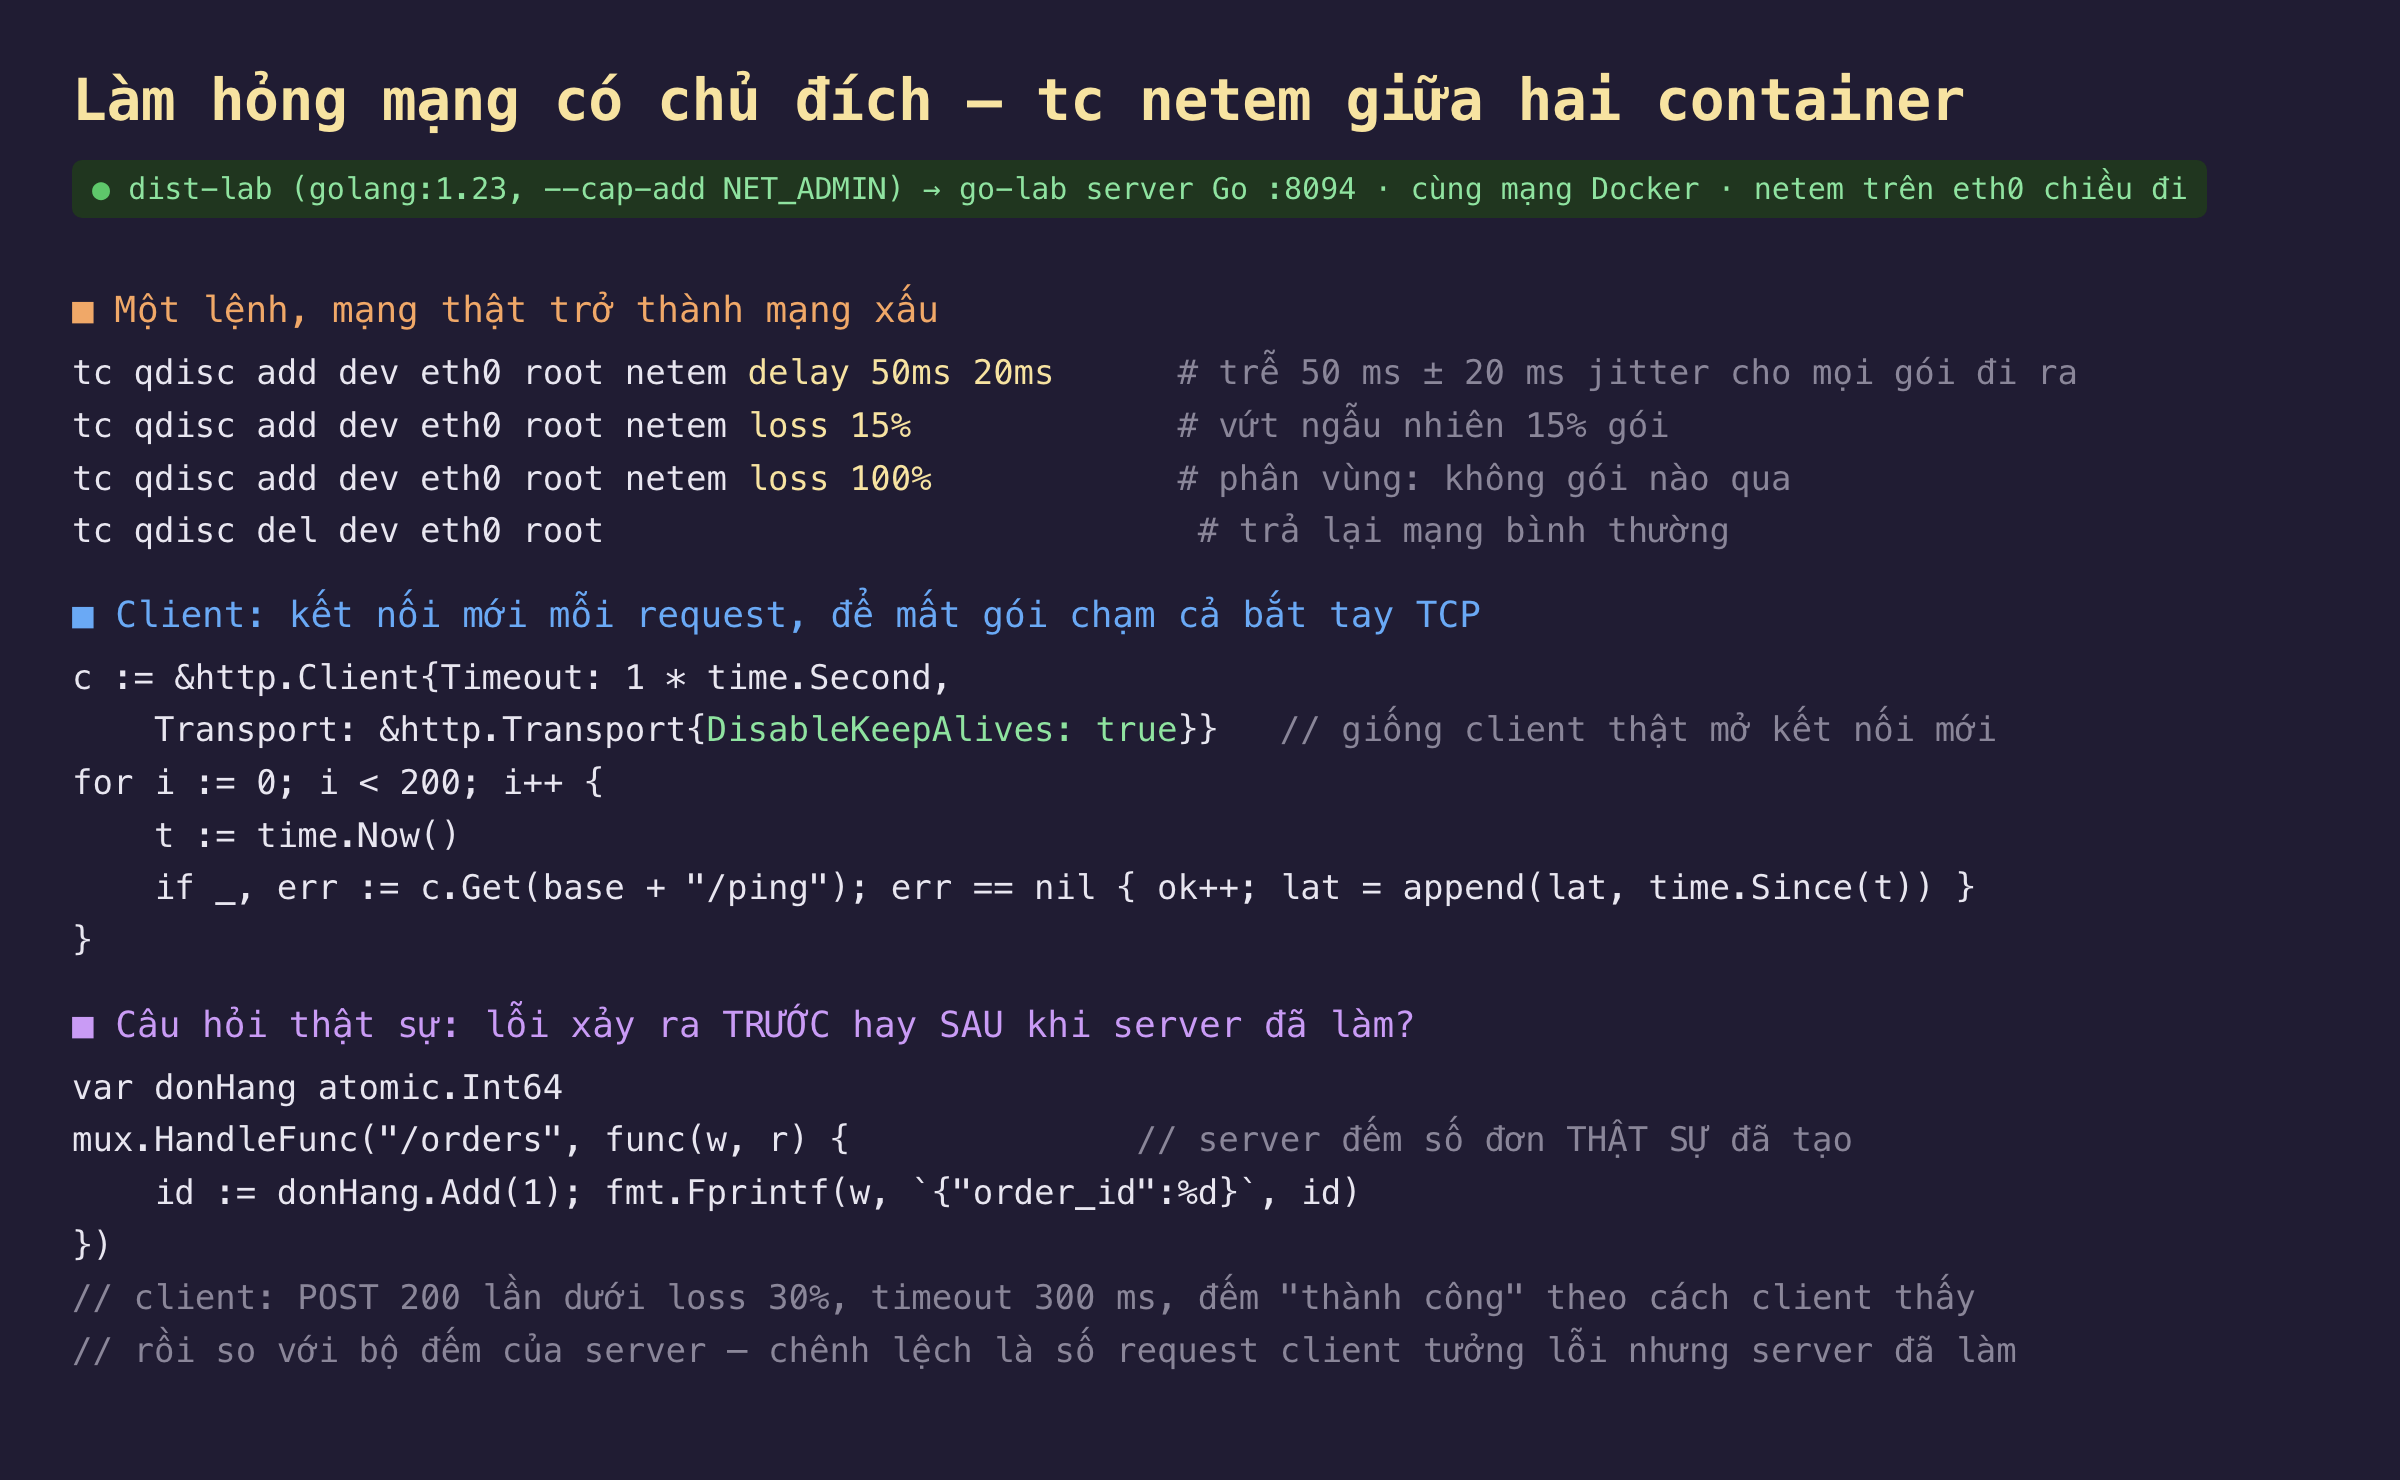
Hình 1: tc netem thêm trễ, jitter, mất gói hoặc cắt hẳn trên giao diện mạng của container client. Server đếm số đơn thật sự tạo để so với thứ client nhìn thấy.
Hai container trên cùng mạng Docker: dist-lab chạy client Go và có quyền NET_ADMIN để dùng tc; go-lab chạy server Go với ba endpoint — /ping nhỏ, /orders tạo đơn và đếm, /big trả 1 MB. RTT nền giữa hai container là 0,2 ms, tức là mọi con số bên dưới gần như hoàn toàn do netem gây ra.
Client cố ý mở kết nối mới cho mỗi request. Giữ kết nối sống (keep-alive) che được phần lớn mất gói lúc bắt tay; client thật — trình duyệt mở tab mới, service vừa khởi động, pool kết nối vừa bị dọn — thì không có may mắn đó.
Đo thật: trễ cộng dồn, mất gói thành độ trễ
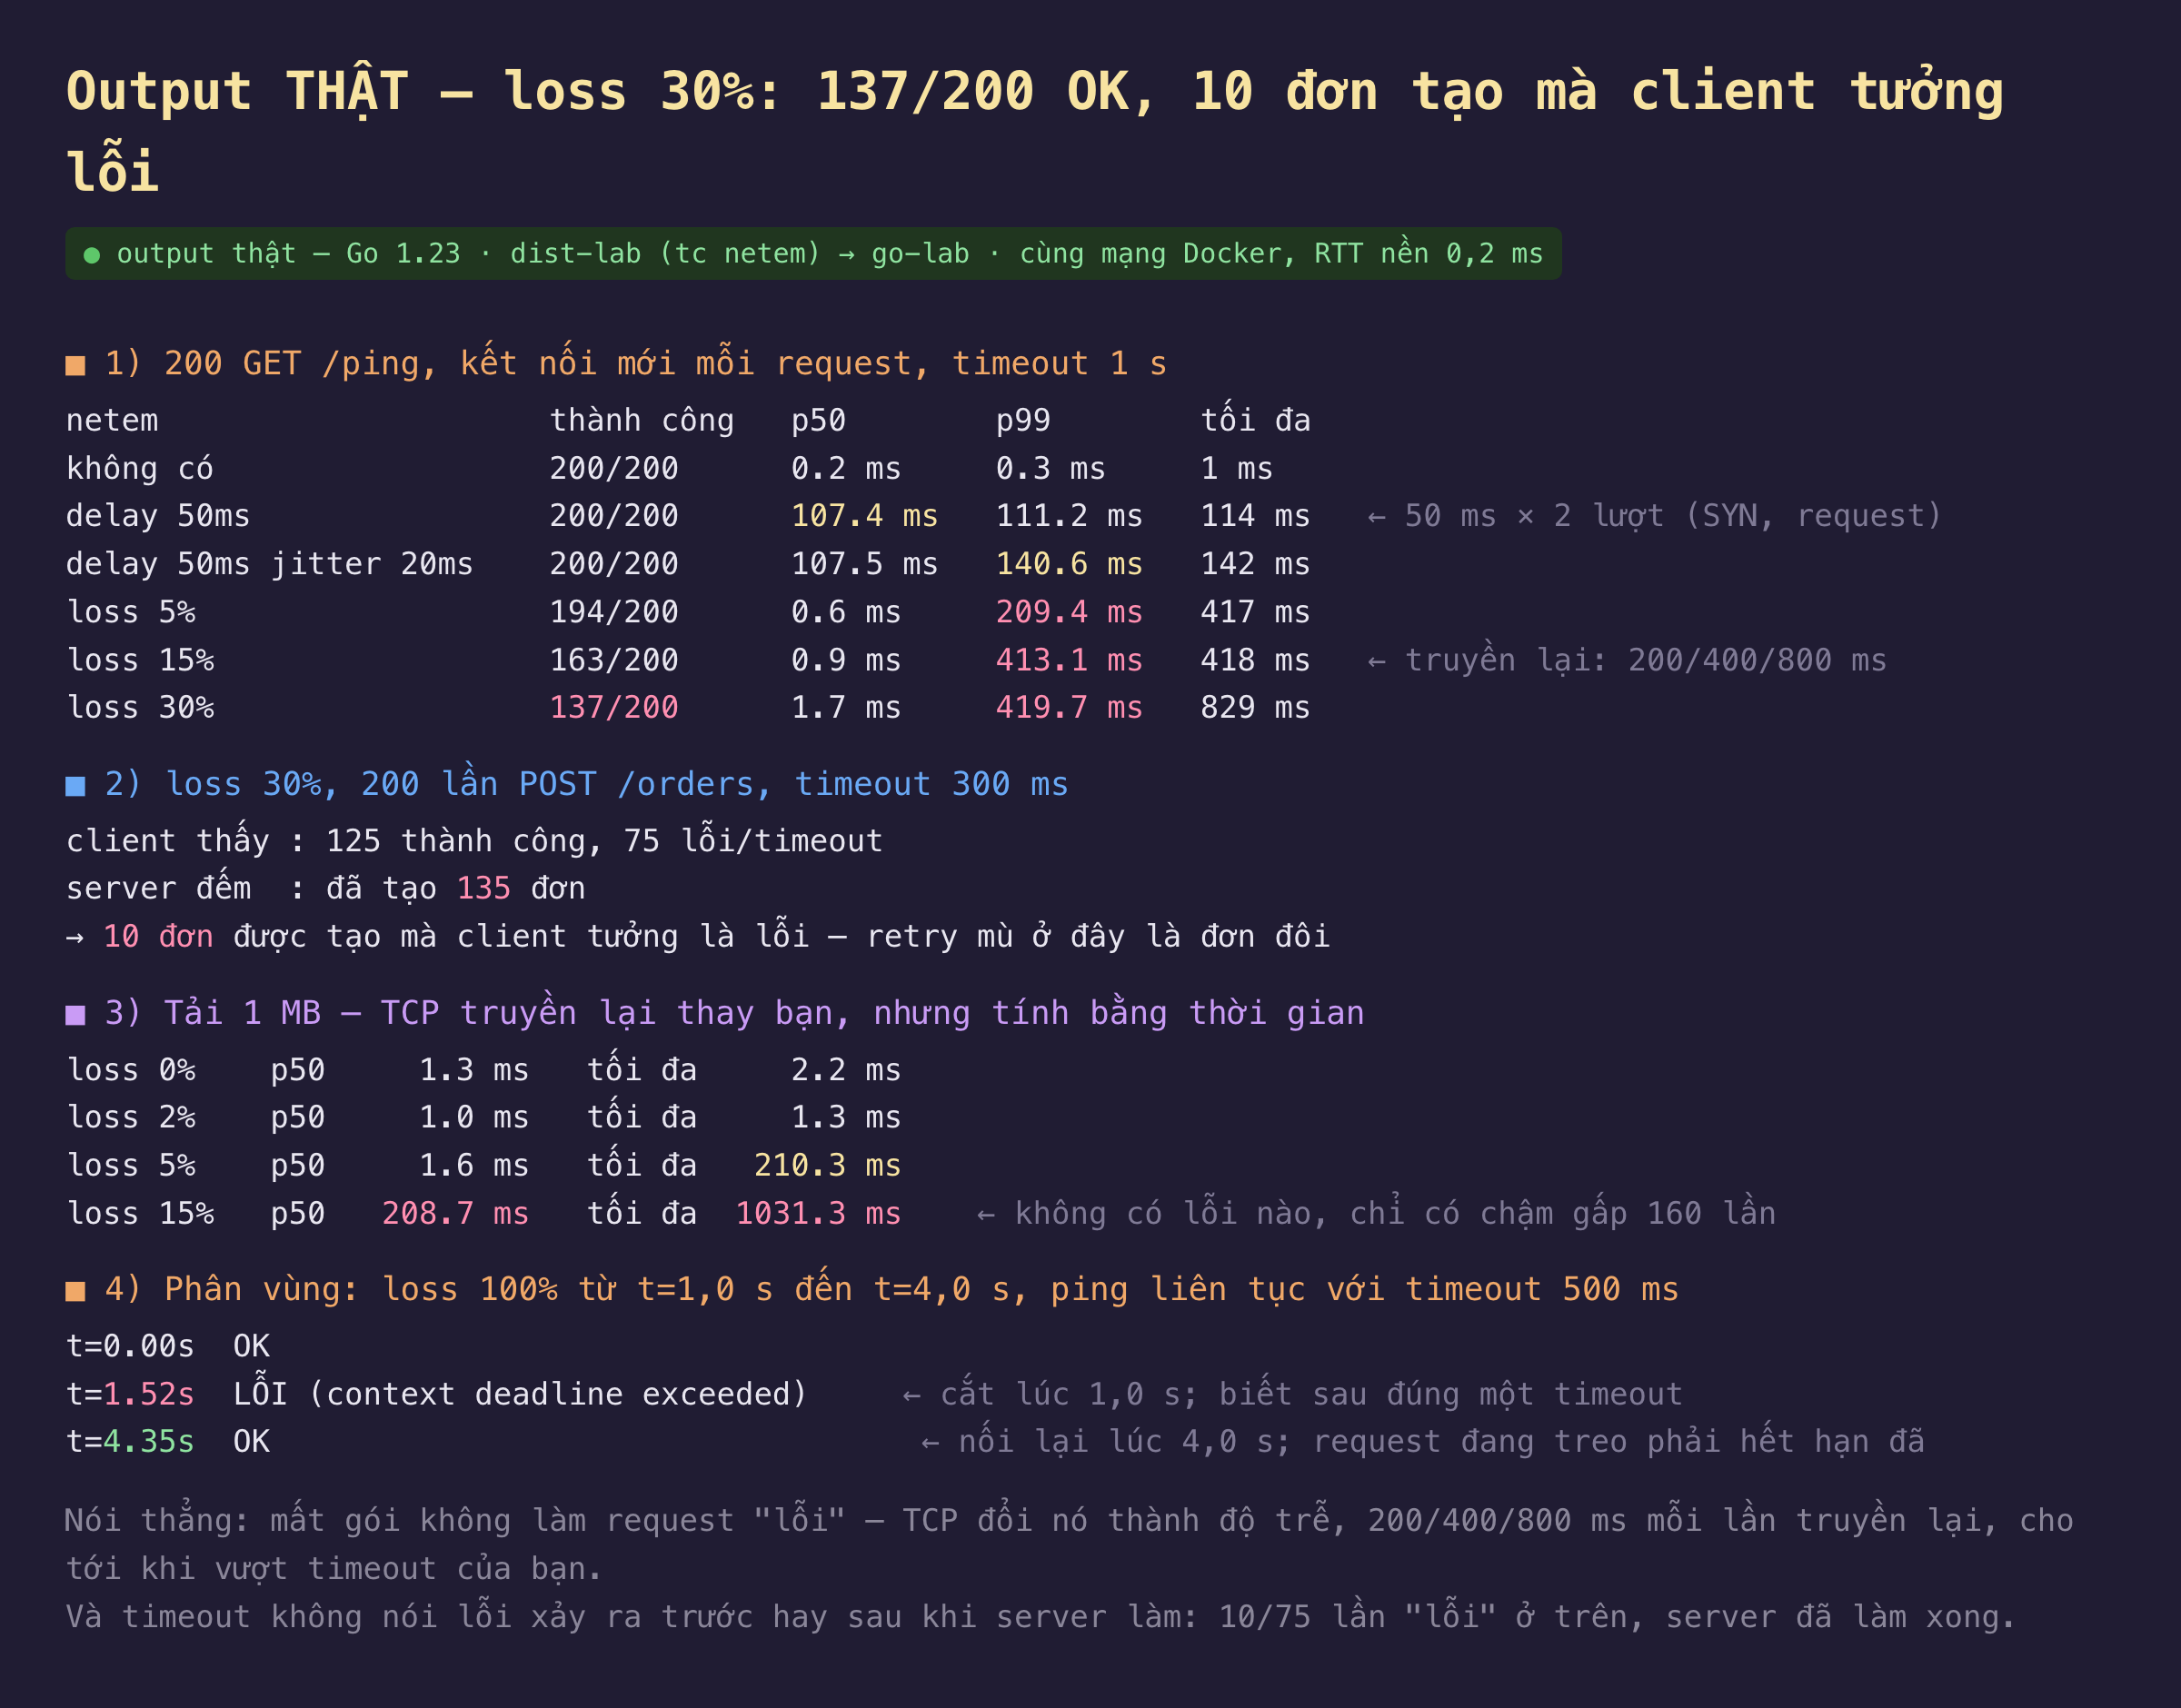
Hình 2: Bốn phép đo. Mục 2 là phép đo mà cả sê-ri này xoay quanh.
Trễ 50 ms một chiều thành 107 ms mỗi request. Không phải 50, không phải 100: bắt tay TCP tốn một lượt đi (SYN), request tốn một lượt nữa, cộng vài mili-giây xử lý. Với keep-alive, con số này về gần 50 — nhưng request đầu tiên của mỗi kết nối luôn trả giá gấp đôi. Jitter 20 ms không đổi p50 nhưng kéo p99 lên 140 ms: độ trễ đuôi là jitter cộng dồn qua nhiều lượt.
Mất gói 5% không làm 5% request lỗi — nó làm p99 nhảy từ 0,3 lên 209 ms. 194/200 vẫn thành công, vì TCP tự truyền lại gói mất. Nhưng lần truyền lại đầu tiên chờ khoảng 200 ms (RTO tối thiểu của Linux), lần hai 400, lần ba 800 — các cột "tối đa" 417 và 829 ms ở mất gói 15% và 30% chính là chuỗi đó. TCP đổi mất gói thành độ trễ, và độ trễ đó không tỉ lệ với RTT thật (0,2 ms) mà với hằng số 200 ms của kernel. Request "lỗi" chỉ xuất hiện khi chuỗi truyền lại vượt timeout 1 giây của client: 6, 37, rồi 63 lần.
Mục 2 — câu hỏi thật sự. Dưới mất gói 30%, client POST tạo đơn 200 lần với timeout 300 ms: nó thấy 125 thành công và 75 lỗi. Server đếm 135 đơn. Mười request client xếp vào "lỗi" thực ra đã tới server, server đã tạo đơn, chỉ có phản hồi (hoặc ACK của nó) bị vứt trên đường về. Client không có cách nào phân biệt 10 request đó với 65 request thật sự chưa tới. Nếu client retry cả 75 — điều mọi client "làm đúng" đều làm — thì 10 đơn thành 20. Đây là lý do khoá idempotency tồn tại, và là lý do câu "exactly-once" trong hệ phân tán luôn phải đi kèm một dấu hoa thị: mạng chỉ cho at-least-once hoặc at-most-once, exactly-once là thứ ứng dụng tự xây ở trên.
Mục 3 — không có lỗi, chỉ có chậm gấp 160 lần. Tải 1 MB dưới mất gói 15%: không request nào lỗi, p50 là 208,7 ms thay vì 1,3 ms, tối đa hơn một giây. Ứng dụng không thấy mất gói; nó thấy một đường truyền đột nhiên chậm. Biểu đồ độ trễ tăng vọt mà tỉ lệ lỗi vẫn 0% là dấu hiệu kinh điển của mất gói ở tầng dưới — và là lý do giám sát phải có p99 chứ không chỉ tỉ lệ lỗi.
Mục 4 — phân vùng. Cắt mạng hoàn toàn từ giây 1,0 đến 4,0. Client biết có chuyện ở giây 1,52 — đúng sau một timeout 500 ms. Nó biết mạng đã trở lại ở giây 4,35 — vì request đang treo phải hết hạn trước đã. Không có tín hiệu "mạng vừa đứt"; chỉ có "request này chưa về", và thời gian phát hiện bằng đúng timeout bạn đặt. Timeout ngắn phát hiện nhanh nhưng báo động giả nhiều (jitter 20 ms đã kéo p99 lên 140); timeout dài thì ngược lại. Phần 10 về phát hiện lỗi sẽ đo đánh đổi đó.
Vì sao cả sê-ri bắt đầu từ đây
Mọi kỹ thuật tiếp theo là câu trả lời cho một trong ba điều vừa đo:
- Request không về không có nghĩa là server chưa làm (mục 2) → idempotency, khoá phân tán có fencing, giao dịch phân tán phải có pha "hỏi lại".
- Mất gói thành trễ, trễ thành timeout, timeout thành "node chết" (mục 1, 3, 4) → phát hiện lỗi là xác suất chứ không phải chắc chắn; bầu chủ và đồng thuận phải sống được với "tôi tưởng nó chết nhưng nó còn sống".
- Hai bên có thể cùng sống mà không nói chuyện được với nhau (mục 4) → split-brain, quorum, CRDT.
Đánh đổi cần cân nhắc
Netem ở đây chỉ chiều đi. tc trên eth0 của client chỉ làm hỏng gói client → server; gói server → client đi đường sạch. Đó là lý do mục 3 (tải 1 MB về) ở mất gói 2% gần như không ảnh hưởng — chỉ ACK bị mất, và TCP dung thứ mất ACK tốt hơn mất dữ liệu. Mạng thật hỏng cả hai chiều, nên con số thật xấu hơn. Muốn mô phỏng đủ thì đặt netem ở cả hai container, hoặc trên cầu nối Docker.
Hằng số 200 ms là của Linux. RTO tối thiểu (TCP_RTO_MIN) là 200 ms trong kernel Linux mặc định; nhiều trung tâm dữ liệu hạ xuống vài mili-giây cho mạng nội bộ, và lúc đó mất gói trở thành độ trễ nhỏ hơn nhiều. Tỉ lệ (truyền lại nhân đôi mỗi lần) thì không đổi.
Kết nối mới mỗi request là trường hợp xấu. Với keep-alive và HTTP/2, bắt tay chỉ trả giá một lần, và mất gói trên kết nối đang mở được TCP xử lý mượt hơn (fast retransmit thay vì RTO). Số đo ở đây là sàn của trải nghiệm xấu — nhưng là sàn mà client mới khởi động nào cũng chạm.
Netem là mô hình, không phải mạng thật. Mất gói thật thường theo cụm (burst) chứ không độc lập từng gói; netem có tham số loss 15% 25% cho tương quan và mô hình Gilbert-Elliott cho burst. Kết luận định tính (mất gói → trễ bậc thang → timeout → "không biết") không đổi; con số p99 thì đổi theo mô hình.
Ba ý mang về
- Gọi qua mạng có kết quả thứ ba là "không biết", và nó có thật bằng số: dưới mất gói 30%, 10 trong 75 request client xếp vào "lỗi" đã được server thực hiện. Retry mù ở đó là tạo đôi — mọi thứ trong sê-ri này bắt đầu từ chỗ đó.
- TCP đổi mất gói thành độ trễ theo bậc 200/400/800 ms, không tỉ lệ với RTT thật: mất 5% làm p99 nhảy từ 0,3 lên 209 ms mà tỉ lệ lỗi gần như không đổi; tải 1 MB ở mất 15% chậm gấp 160 lần với 0 lỗi. Giám sát p99, không chỉ tỉ lệ lỗi.
- Phát hiện mạng đứt bằng đúng timeout bạn đặt — 0,5 giây sau khi cắt, 0,35 giây sau khi nối — và không có tín hiệu nào khác. Timeout là đánh đổi giữa phát hiện nhanh và báo động giả, không phải một hằng số đúng.
Nguồn
- Linux man page — tc-netem(8): https://man7.org/linux/man-pages/man8/tc-netem.8.html
- RFC 6298 — Computing TCP's Retransmission Timer: https://www.rfc-editor.org/rfc/rfc6298
- Peter Deutsch — The Eight Fallacies of Distributed Computing: https://architecturenotes.co/fallacies-of-distributed-systems/
- Martin Kleppmann — Designing Data-Intensive Applications, chương 8 The Trouble with Distributed Systems
- Jepsen — Network partitions in practice (Kyle Kingsbury): https://jepsen.io/
Phần sau bỏ mạng sang một bên và nhìn vào thứ còn đáng ngờ hơn: đồng hồ. Hai máy không bao giờ cùng giờ, và "sự kiện A xảy ra trước B" cần một định nghĩa không dựa vào đồng hồ tường — Lamport và vector clock, đo trên nhiều tiến trình thật.
