Phần 1 để lại một câu hỏi lơ lửng: gửi yêu cầu mà không có hồi âm, máy kia chết hay mạng chậm? Mọi phần sau đều dựa vào câu trả lời cho nó — bầu chủ cần biết chủ cũ đã chết, Raft cần biết khi nào mở bầu cử, khoá phân tán cần biết người giữ khoá còn sống. Bài này đo thẳng vào bộ phận trả lời câu hỏi đó: bộ phát hiện lỗi. Năm bộ dò chạy song song trên cùng một luồng heartbeat thật, qua mạng bị làm xấu bằng tc netem, rồi tiến trình gửi bị giết, bị dừng, và được đếm xem ai báo đúng, ai báo oan, và ai báo sớm.
Năm bộ dò, một luồng heartbeat
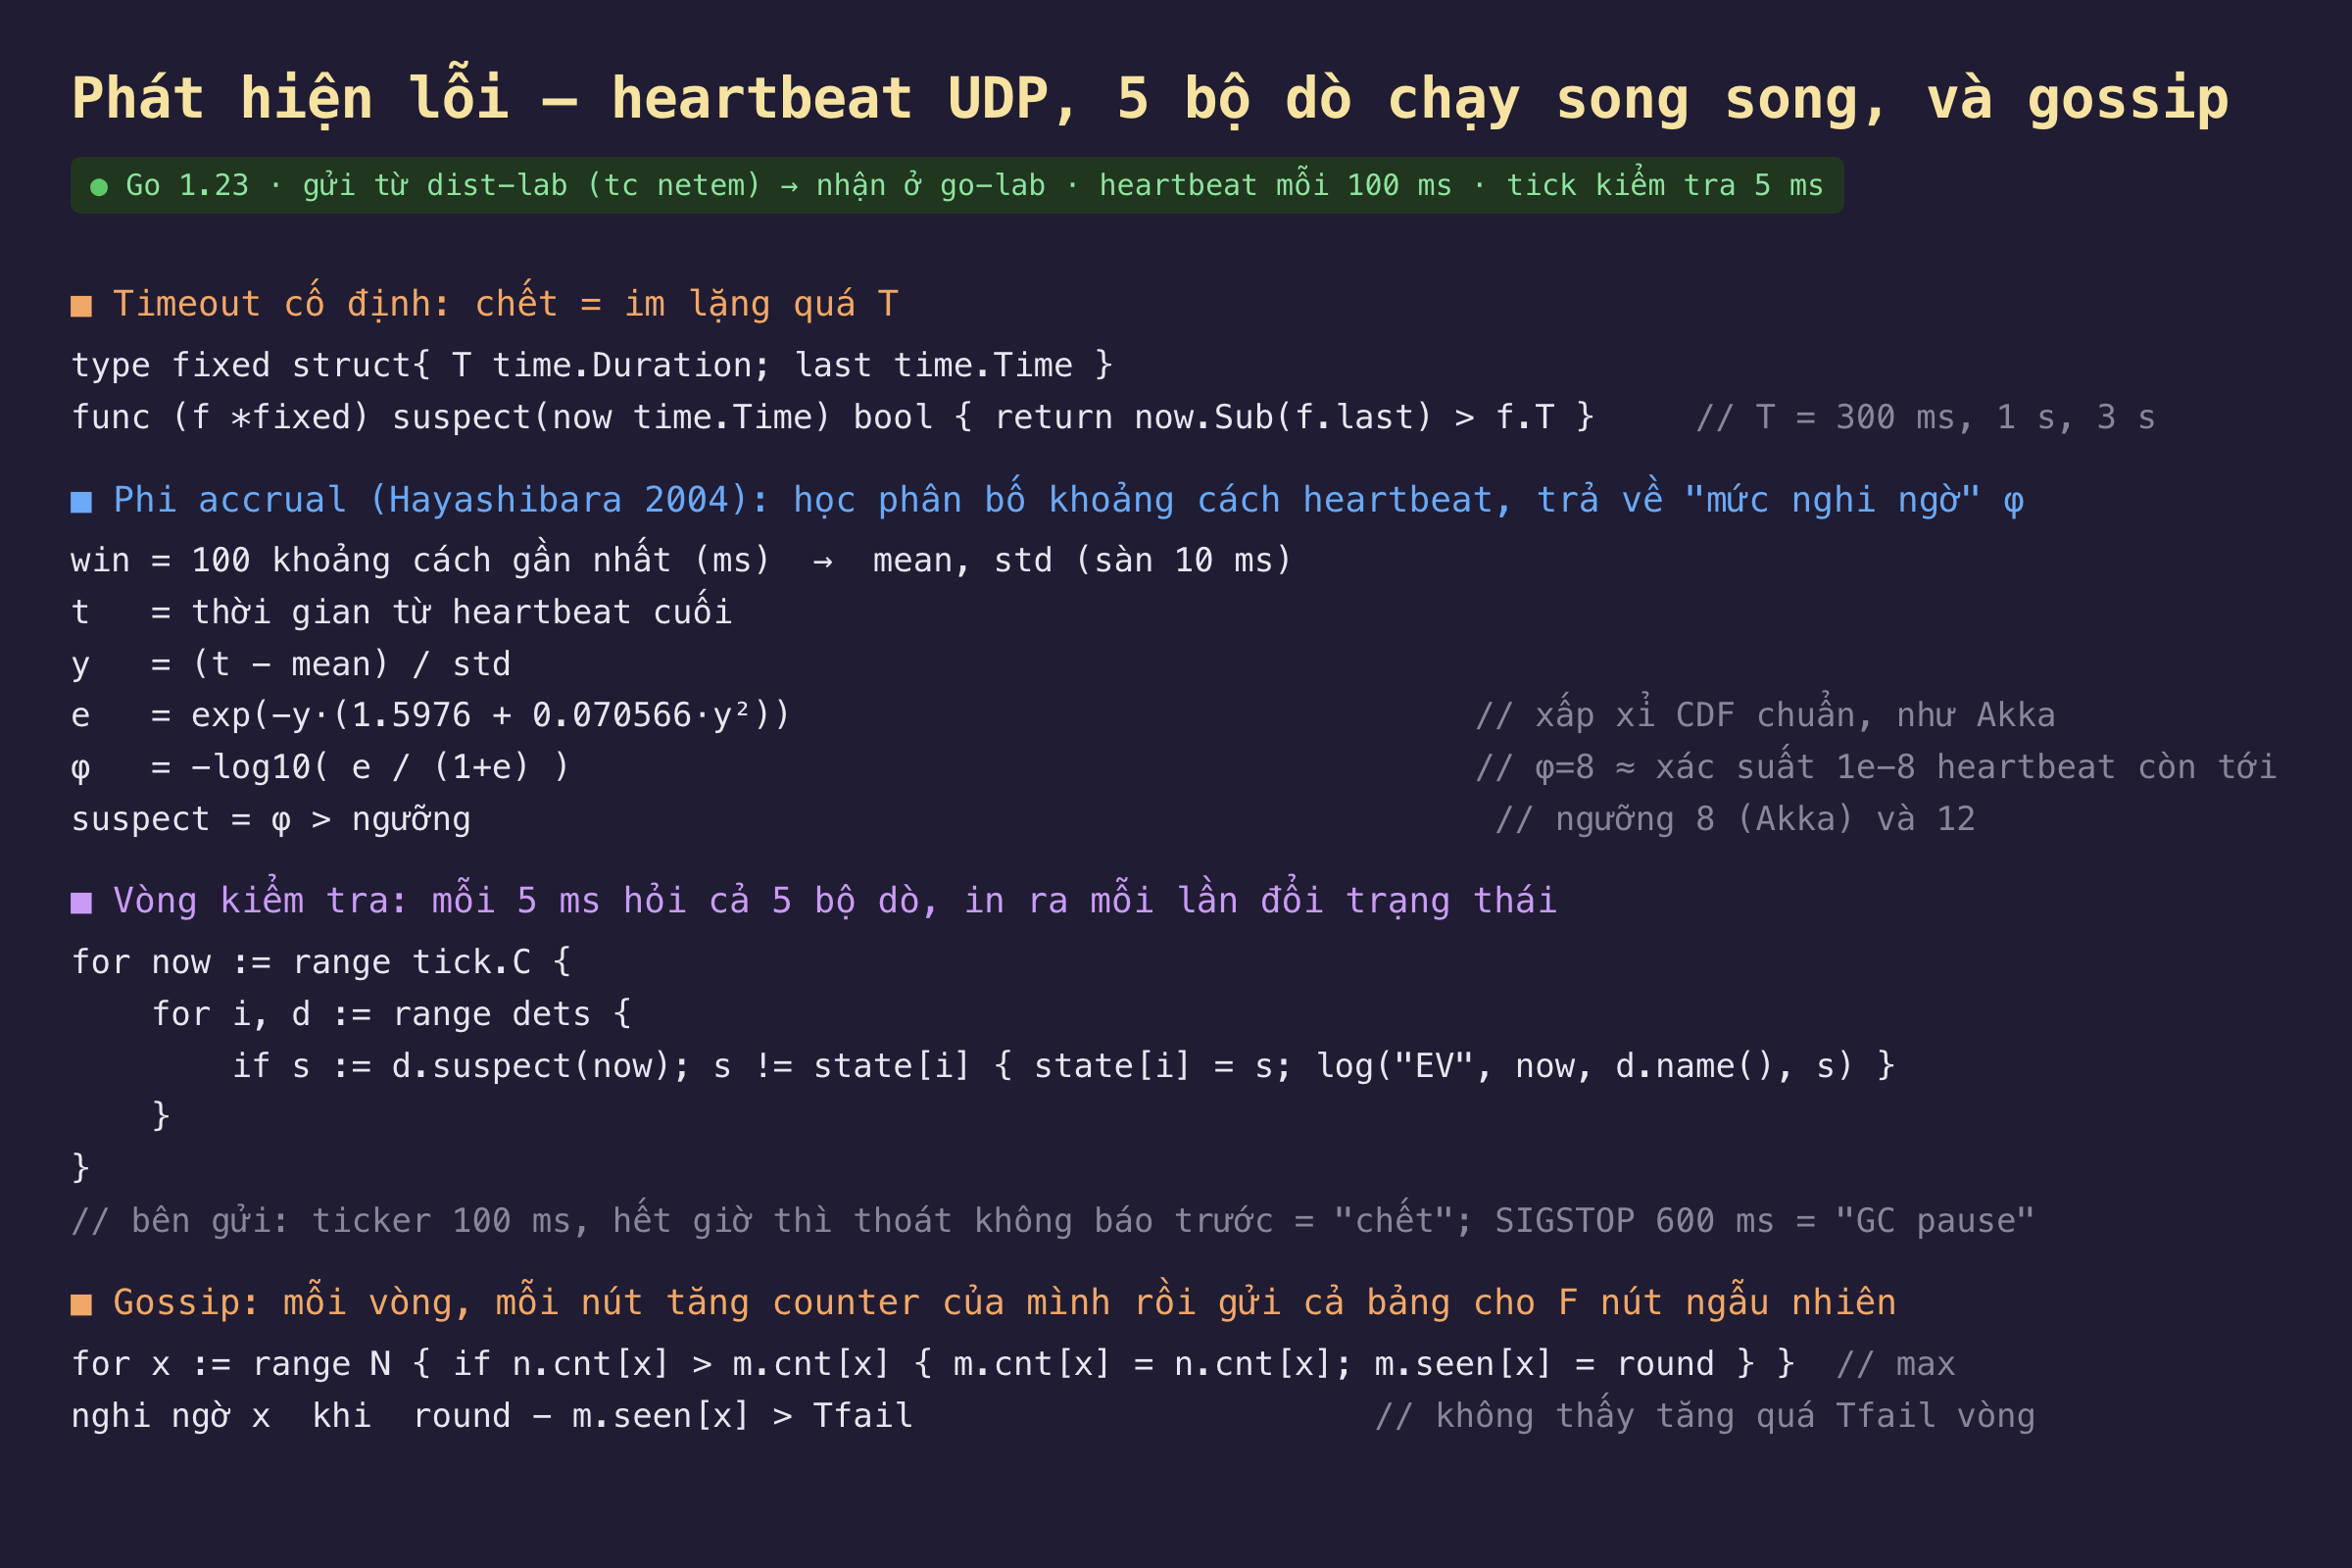
Hình 1: Timeout cố định so với phi accrual, cùng nhận một luồng heartbeat. Phần gossip là mô phỏng trong một tiến trình.
Tiến trình gửi chạy trong dist-lab (có quyền NET_ADMIN để dùng tc netem), bắn một gói UDP mỗi 100 ms sang go-lab. Bên nhận có năm bộ dò:
- Timeout cố định 300 ms, 1 s, 3 s: nghi ngờ khi im lặng quá T. Đơn giản, dễ hiểu, và là thứ hầu hết mã đang chạy ngoài kia dùng.
- Phi accrual (Hayashibara 2004, dùng trong Cassandra và Akka): giữ 100 khoảng cách heartbeat gần nhất, tính trung bình và độ lệch chuẩn, rồi trả về φ = −log₁₀ của xác suất "heartbeat vẫn còn đang tới". φ = 8 nghĩa là xác suất đó dưới 10⁻⁸. Ngưỡng 8 là mặc định của Akka; thêm ngưỡng 12 để thấy đánh đổi.
"Chết" là tiến trình gửi thoát không báo trước. "GC pause" là SIGSTOP 600 ms rồi SIGCONT. Mạng xấu là netem delay 80ms 60ms distribution normal loss 15%. Mỗi kịch bản ba lượt 20 giây.
Đo thật: ba kịch bản, một bảng
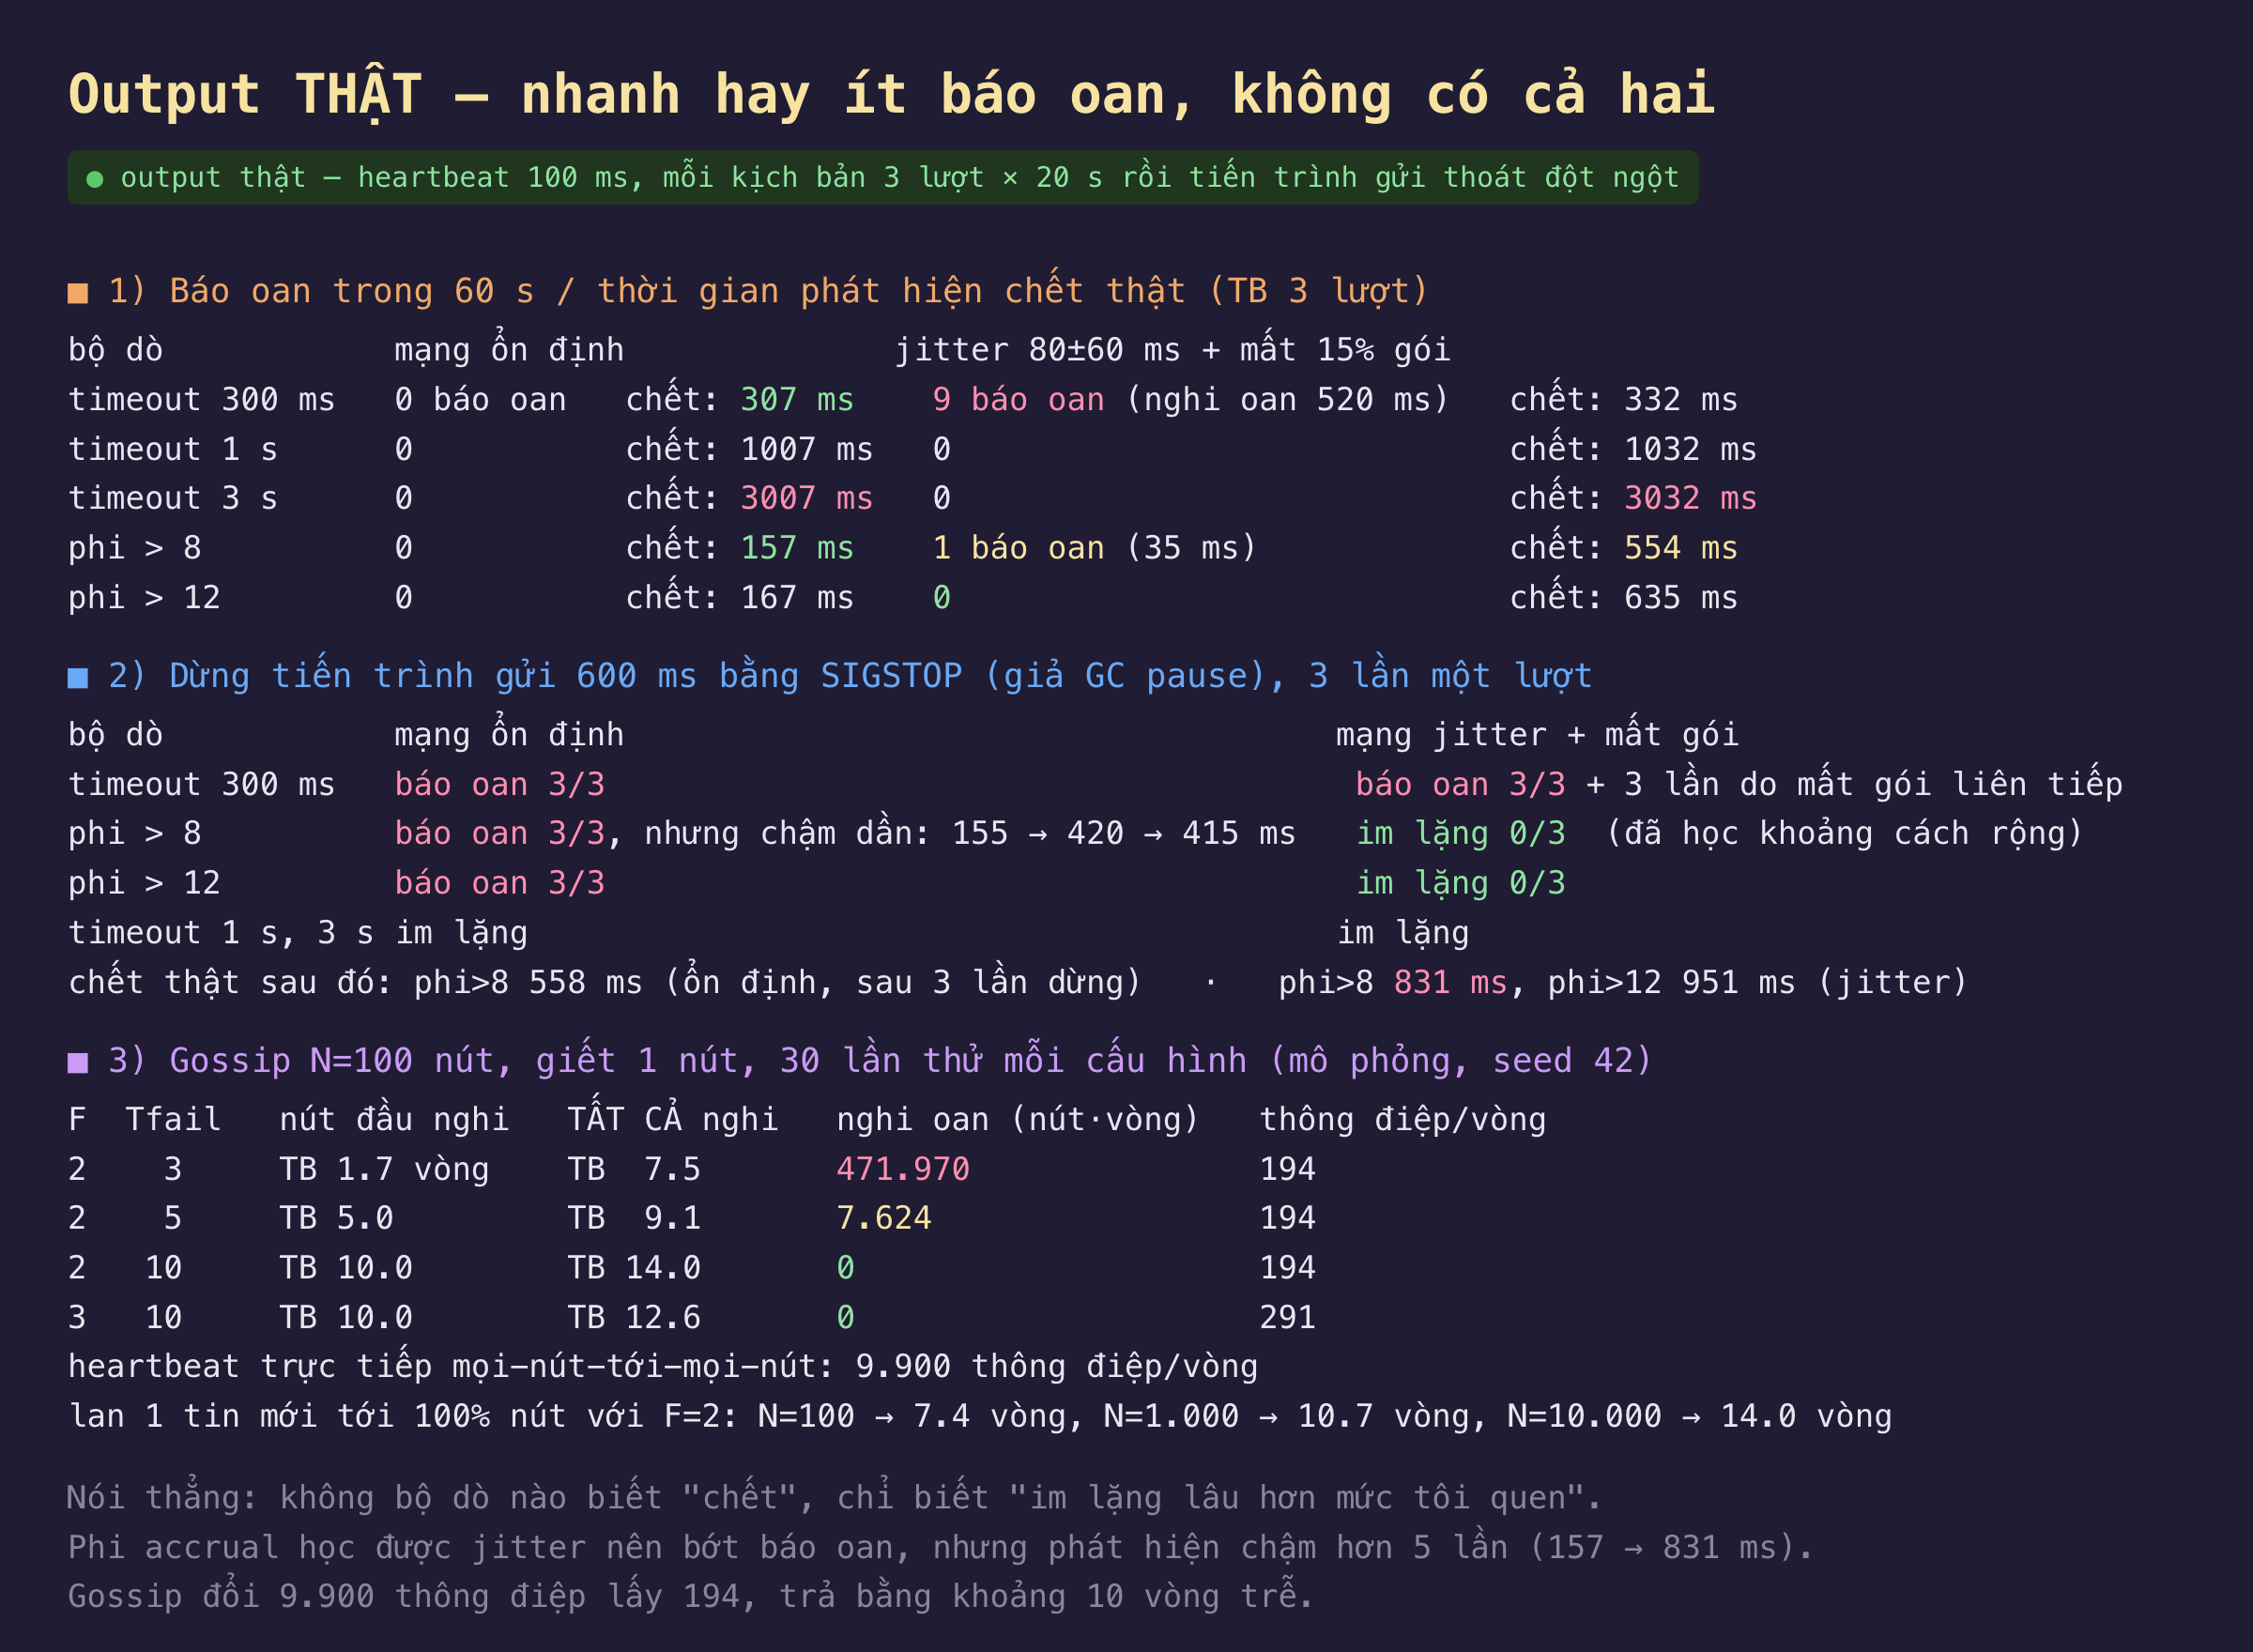
Hình 2: Kết quả thật. Mục 1 và 2 đo qua mạng giữa hai container; mục 3 là mô phỏng 100 nút trong một tiến trình, seed cố định.
| bộ dò | ổn định: báo oan / phát hiện | jitter + mất gói: báo oan / phát hiện |
|---|---|---|
| timeout 300 ms | 0 / 307 ms | 9 lần / 332 ms |
| timeout 1 s | 0 / 1.007 ms | 0 / 1.032 ms |
| timeout 3 s | 0 / 3.007 ms | 0 / 3.032 ms |
| phi > 8 | 0 / 157 ms | 1 lần / 554 ms |
| phi > 12 | 0 / 167 ms | 0 / 635 ms |
Mạng ổn định thì cái gì cũng đúng, và phi nhanh nhất. Không bộ dò nào báo oan trong 60 giây. Phi > 8 phát hiện chết sau 157 ms — nhanh hơn cả timeout 300 ms — vì nó biết heartbeat đến đều 100 ± vài ms, nên im lặng 150 ms đã là bất thường ở mức 10⁻⁸. Timeout cố định thì phát hiện đúng bằng T cộng vài ms, không hơn không kém: nhanh hay chậm là do bạn chọn trước, không liên quan gì tới mạng thật.
Thêm jitter và mất gói, timeout 300 ms báo oan 9 lần một phút. Mất 15% gói nghĩa là cứ khoảng 44 lần thì có một lần hai gói liên tiếp cùng mất, tức 300 ms im lặng — đúng ngưỡng. Mỗi lần báo oan ngắn (tổng 520 ms trong 60 giây), nhưng nếu phía sau là "chuyển chủ" hay "mở bầu cử" thì 9 lần một phút là thảm hoạ. Timeout 1 s và 3 s không báo oan, đổi lại phát hiện chết sau 1 và 3 giây. Phi > 12 không báo oan lần nào và phát hiện chết sau 635 ms: nó tự nới ngưỡng theo mạng — cùng một dòng mã, mạng xấu hơn thì chờ lâu hơn. Đó chính là lý do nó tồn tại.
Mục 2 là chỗ phi lộ ra bản chất. Dừng tiến trình gửi 600 ms ba lần. Trên mạng ổn định, phi > 8 báo oan cả ba lần — tất nhiên, vì 600 ms im lặng trên nền 100 ± 10 ms là φ rất lớn. Nhưng để ý thời điểm báo: lần đầu 155 ms sau heartbeat cuối, lần hai 420 ms, lần ba 415 ms. Nó đã học luôn cả lần dừng đầu tiên vào phân bố và nới ngưỡng ra; đến khi chết thật thì mất 558 ms mới báo thay vì 157. Trên mạng jitter, phi im lặng suốt ba lần dừng — nghe như thắng lợi, nhưng cùng lúc đó nó phát hiện chết thật chậm tới 831 ms, gấp hơn 5 lần mạng ổn định. Phi không phân biệt được "mạng xấu" với "tiến trình hay dừng": với nó mọi thứ đều là phân bố khoảng cách heartbeat.
Mục 3 — gossip thay cho heartbeat trực tiếp. 100 nút mà ai cũng gửi heartbeat cho mọi người là 9.900 thông điệp mỗi vòng; gossip với fanout 2 là 194. Giá là độ trễ lan truyền: một tin mới cần 7,4 vòng để tới đủ 100 nút, 14 vòng với 10.000 nút — tỉ lệ log N, đúng lý thuyết dịch bệnh. Và Tfail phải lớn hơn độ trễ đó: với Tfail = 3 vòng, hệ thống nghi oan 471.970 lần (nút-vòng) trong 30 lần thử vì counter của một nút sống bình thường cũng cần vài vòng mới tới được nút ở xa; Tfail = 10 thì sạch, đổi lại cả cụm mất trung bình 14 vòng mới đồng ý nút kia chết. Fanout 3 rút xuống 12,6 vòng với giá 291 thông điệp.
Đánh đổi cần cân nhắc
Không có bộ dò nào biết "chết". Tất cả chỉ biết "im lặng lâu hơn mức tôi chờ". Bộ dò nhanh thì báo oan nhiều; bộ dò ít báo oan thì chậm. Phi accrual không phá được đánh đổi này, nó chỉ tự chỉnh điểm cân bằng theo mạng thật thay vì để bạn đoán một con số lúc viết cấu hình. Đó là lợi thế lớn khi cùng một mã chạy ở nhiều môi trường khác nhau, và là bất lợi khi bạn cần một cam kết cố định kiểu "phát hiện trong 500 ms".
Hậu quả của báo oan quyết định ngưỡng, không phải thẩm mỹ. Báo oan để chuyển lưu lượng sang bản sao khác thì rẻ, chọn ngưỡng thấp. Báo oan để mở bầu cử, cắt khoá, hoặc coi một nút là chết rồi phân lại dữ liệu (phần 7 đã đo di chuyển dữ liệu tốn thế nào) thì đắt, chọn ngưỡng cao hoặc đòi nhiều nút cùng nghi ngờ (SWIM gọi là indirect ping). Vì thế hệ thống thật thường tách nghi ngờ khỏi kết luận: nghi ngờ nhanh và rẻ, kết luận chậm và cần đồng thuận.
Phi accrual học cả thứ bạn không muốn nó học. Vài lần GC pause là đủ để nó nới ngưỡng và chậm đi; Akka chữa bằng acceptable-heartbeat-pause cộng thẳng vào trung bình, Cassandra dùng phân bố mũ thay vì chuẩn để bớt nhạy với đuôi. Cửa sổ 100 mẫu ở đây tương ứng 10 giây — ngắn thì phản ứng nhanh với mạng đổi, dài thì nhớ lâu hơn những lần dừng cũ.
Gossip đổi băng thông lấy độ trễ và độ chắc. Phù hợp cho thành viên cụm lớn (Cassandra, Consul dùng SWIM), không phù hợp cho thứ cần phát hiện dưới một giây. Và mô phỏng ở đây không có mất gói lẫn trễ mạng; Tfail an toàn ngoài đời phải cộng thêm cả hai.
Phạm vi đo. Hai container trên cùng máy, loopback qua cầu Docker; jitter là netem, không phải mạng thật. Ba lượt mỗi kịch bản là đủ để thấy xu hướng, không đủ để nói về đuôi phân bố. Gói "reset" giữa các lượt cũng đi qua netem và một lần đã mất — phải tách lượt theo mốc thời gian thay vì theo gói đánh dấu.
Ba ý mang về
- Phát hiện lỗi là đánh đổi tốc độ với báo oan, không có cấu hình nào thoát: timeout 300 ms phát hiện trong 307 ms nhưng báo oan 9 lần một phút khi mạng xấu; timeout 3 s sạch nhưng mất 3 giây; phi tự dịch điểm cân bằng từ 157 ms lên 831 ms theo chất lượng mạng.
- Phi accrual học mọi thứ nó thấy, kể cả GC pause: tiện vì không phải đoán ngưỡng, nguy vì vài lần dừng là nó chậm đi gấp ba. Tách "nghi ngờ" khỏi "kết luận", và chọn ngưỡng theo giá của hành động đi sau lời báo.
- Gossip giảm thông điệp từ N² xuống N·F (9.900 → 194) với giá log N vòng trễ, và
Tfailphải lớn hơn độ trễ lan truyền — Tfail 3 nghi oan gần nửa triệu lần, Tfail 10 thì không lần nào.
Nguồn
- Hayashibara, Défago, Yared, Katayama — The φ Accrual Failure Detector (SRDS 2004): https://ieeexplore.ieee.org/document/1353004
- Chandra, Toueg — Unreliable Failure Detectors for Reliable Distributed Systems (JACM 1996): https://www.cs.utexas.edu/~lorenzo/corsi/cs380d/papers/p225-chandra.pdf
- Das, Gupta, Motivala — SWIM: Scalable Weakly-consistent Infection-style Process Group Membership Protocol (DSN 2002): https://www.cs.cornell.edu/projects/Quicksilver/public_pdfs/SWIM.pdf
- Akka — Phi Accrual Failure Detector (tài liệu): https://doc.akka.io/libraries/akka-core/current/typed/failure-detector.html
- Demers et al. — Epidemic Algorithms for Replicated Database Maintenance (PODC 1987): https://dl.acm.org/doi/10.1145/41840.41841
Phần sau rời khỏi câu hỏi "ai còn sống" để sang "dữ liệu nằm ở đâu": chia mảnh theo băm hay theo khoảng, mảnh nóng khi khoá phân bố lệch kiểu Zipf, và cân bằng lại khi đang chạy — đo trên PostgreSQL thật.
