Phần 1 đã chạm tới column projection khi so đọc một cột giữa Parquet và CSV. Phần này đo kỹ hơn trên một bảng rộng, vì đó là nơi projection phát huy mạnh nhất. Bảng phân tích thật thường có hàng chục tới hàng trăm cột, nhưng mỗi truy vấn chỉ đụng một vài cột. Trên định dạng cột, chỉ đọc đúng những cột cần là một lợi thế cơ bản, và nó dẫn tới một quy tắc thực hành rõ ràng: SELECT * là phản mẫu. Bài này sinh một bảng ba mươi mốt cột, năm triệu dòng, rồi đo thời gian truy vấn theo số cột đọc trên Parquet so với CSV, để thấy chính xác projection đáng giá bao nhiêu.
Định dạng cột đọc theo cột, định dạng hàng đọc cả dòng
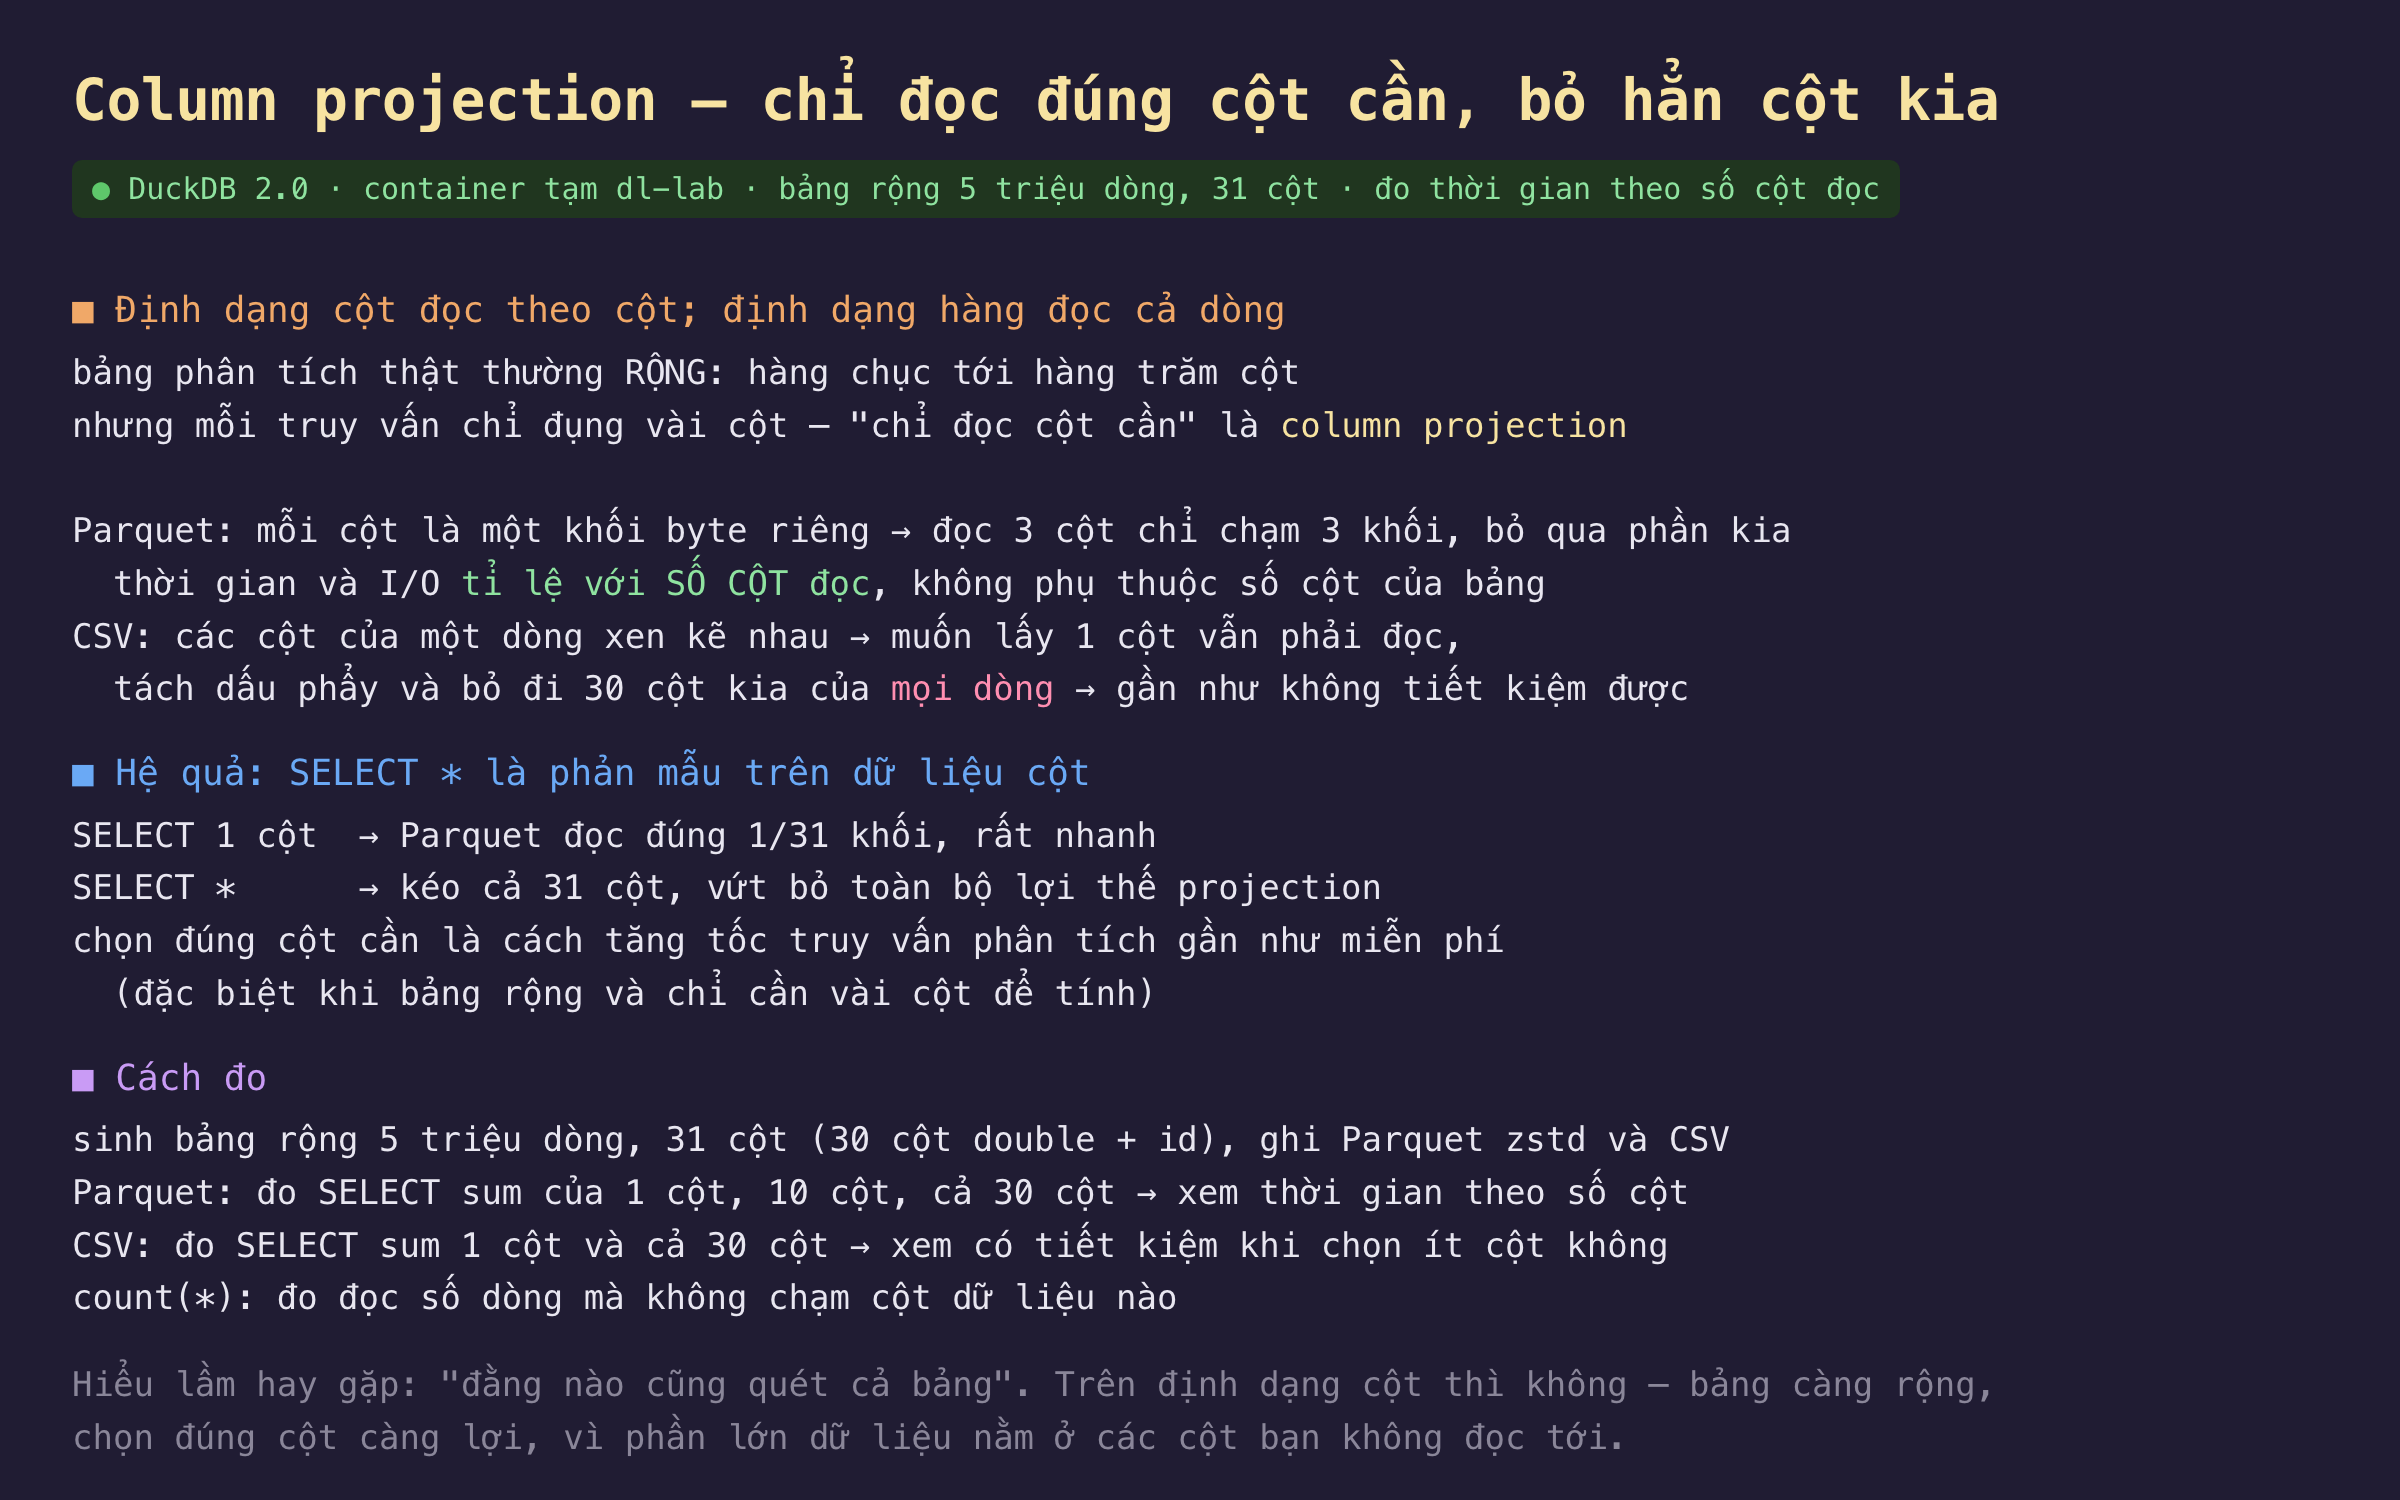
Hình 1: Định dạng cột đọc theo cột nên thời gian tỉ lệ với số cột truy vấn; định dạng hàng phải đọc cả dòng dù chỉ cần một cột.
Bảng phân tích thật thường rất rộng, hàng chục tới hàng trăm cột, nhưng một truy vấn điển hình chỉ đụng một vài cột, ví dụ tính tổng doanh thu theo quốc gia chỉ cần hai cột trong bảng ba mươi cột. "Chỉ đọc những cột cần" là column projection, và cách mỗi định dạng xử lý nó khác nhau hoàn toàn. Trong Parquet, mỗi cột là một khối byte riêng trong file, nên đọc ba cột chỉ chạm ba khối và bỏ qua phần còn lại; thời gian và I/O tỉ lệ với số cột đọc, không phụ thuộc bảng có bao nhiêu cột. Trong CSV, các cột của một dòng xen kẽ nhau theo thứ tự, nên muốn lấy một cột vẫn phải đọc nguyên dòng, tách theo dấu phẩy, và bỏ đi ba mươi cột kia của mọi dòng; kết quả là chọn ít cột gần như không tiết kiệm được gì.
Hệ quả trực tiếp là SELECT * trở thành phản mẫu trên dữ liệu cột. SELECT một cột khiến Parquet đọc đúng một trong ba mươi mốt khối, rất nhanh; còn SELECT * kéo cả ba mươi mốt cột, vứt bỏ toàn bộ lợi thế projection. Chọn đúng cột cần là cách tăng tốc truy vấn phân tích gần như miễn phí, đặc biệt khi bảng rộng và chỉ cần vài cột để tính. Đây không phải vi tối ưu nhỏ nhặt: trên bảng rộng, phần lớn dữ liệu nằm ở các cột mà truy vấn không đọc tới, nên bỏ chúng là bỏ phần lớn công việc.
Cách đo: sinh một bảng rộng năm triệu dòng, ba mươi mốt cột (ba mươi cột số thực cộng một cột id), ghi ra Parquet nén zstd và CSV. Trên Parquet, đo SELECT sum của một cột, mười cột, và cả ba mươi cột để xem thời gian thay đổi theo số cột. Trên CSV, đo SELECT sum một cột và cả ba mươi cột để xem có tiết kiệm khi chọn ít cột không. Và đo count(*) để xem đếm số dòng mà không chạm cột dữ liệu nào tốn bao nhiêu.
Đo thật: tính một cột 17,8 ms, kéo cả 30 cột 388 ms
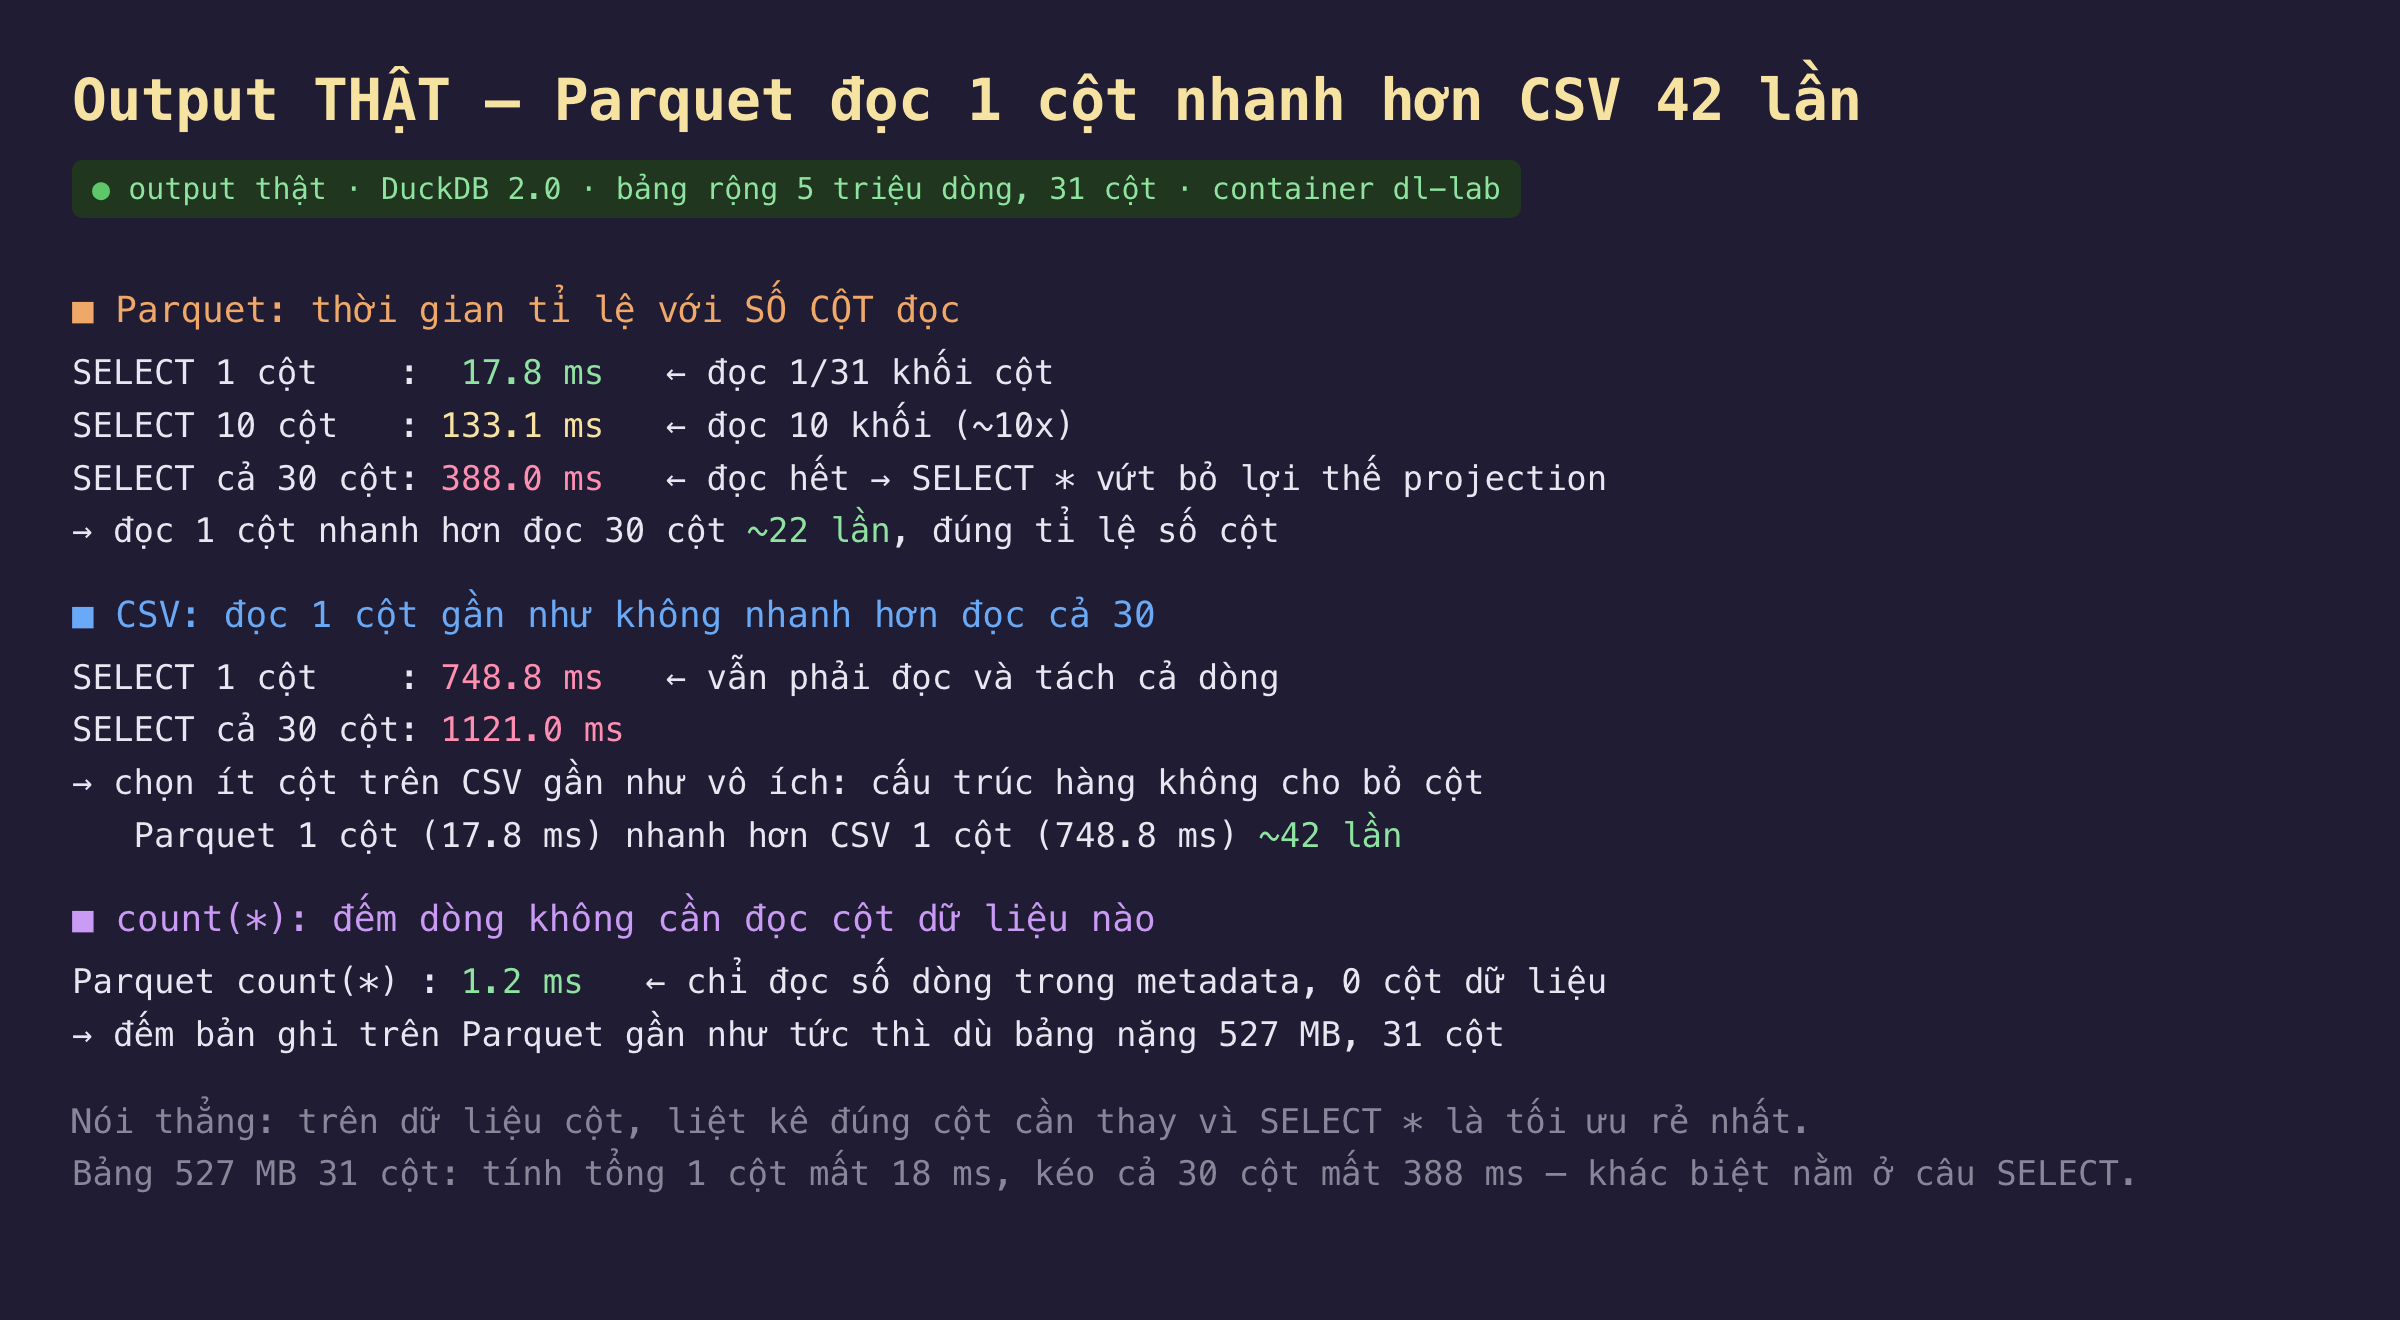
Hình 2: Thời gian Parquet tăng tuyến tính theo số cột, CSV gần như phẳng, và count() chỉ đọc metadata.*
| truy vấn | Parquet | CSV |
|---|---|---|
| SELECT 1 cột | 17,8 ms | 748,8 ms |
| SELECT 10 cột | 133,1 ms | — |
| SELECT cả 30 cột | 388,0 ms | 1121,0 ms |
| count(*) | 1,2 ms | — |
Trên Parquet, thời gian tỉ lệ đúng với số cột đọc. Tính tổng một cột mất 17,8 ms, mười cột mất 133,1 ms, và cả ba mươi cột mất 388,0 ms. Quan hệ gần như tuyến tính: đọc mười cột tốn khoảng mười lần một cột, đọc ba mươi cột tốn khoảng hai mươi hai lần. Đây là bằng chứng trực tiếp rằng Parquet chỉ đọc đúng các khối cột được truy vấn; mỗi cột thêm vào SELECT là một khối byte nữa phải đọc và giải mã, còn cột không nhắc tới thì hoàn toàn không chạm. Hệ quả thực hành: SELECT * trên bảng này mất 388 ms, trong khi truy vấn thật chỉ cần một cột đáng lẽ mất 17,8 ms, chênh hai mươi hai lần chỉ vì kéo thừa các cột không dùng.
Trên CSV, chọn ít cột gần như vô ích. Đọc một cột mất 748,8 ms, còn đọc cả ba mươi cột mất 1121,0 ms. Khác biệt chỉ khoảng một lần rưỡi, dù số cột chênh ba mươi lần. Lý do là cấu trúc hàng: để lấy giá trị một cột, engine vẫn phải đọc từng dòng văn bản, tách theo dấu phẩy, và duyệt qua vị trí của cột cần, nên công đọc và phân tích cú pháp gần như không giảm khi chọn ít cột. So sánh đáng chú ý nhất: Parquet đọc một cột, 17,8 ms, nhanh hơn CSV đọc một cột, 748,8 ms, khoảng bốn mươi hai lần. Đây là khoảng cách lớn nhất trong bài, và nó đến từ việc Parquet bỏ qua ba mươi cột không cần, còn CSV bắt buộc đọc hết.
Đếm số dòng trên Parquet gần như tức thì vì chỉ đọc metadata. count(*) trên bảng Parquet mất 1,2 ms, dù file nặng 527 MB và có ba mươi mốt cột. Lý do: đếm số dòng không cần đọc nội dung cột nào; số dòng được ghi sẵn trong metadata của mỗi row group, nên engine chỉ cộng các con số đó lại. Đây là một trường hợp đặc biệt của projection, projection về không cột, và nó cho thấy khi truy vấn không cần dữ liệu cột, Parquet gần như không tốn công đọc. Trên CSV, đếm dòng vẫn phải quét cả file để đếm ký tự xuống dòng, chậm hơn nhiều bậc.
Đánh đổi cần cân nhắc
*Liệt kê đúng cột cần thay vì SELECT , nhất là trong code sản phẩm. Quy tắc rút ra đơn giản và rẻ: trong truy vấn phân tích trên dữ liệu cột, hãy nêu tên chính xác các cột cần thay vì dùng SELECT *. Lợi ích tỉ lệ với độ rộng bảng và mức dư thừa của SELECT *: bảng càng rộng, truy vấn chỉ cần càng ít cột, thì projection càng đáng giá. Trong code sản phẩm, nơi một truy vấn chạy hàng nghìn lần, thói quen này tiết kiệm đáng kể mà không đổi kết quả. SELECT * chỉ nên dùng khi khám phá dữ liệu bằng tay hoặc thật sự cần mọi cột.
Bảng rộng không phải vấn đề nếu dùng định dạng cột. Một hệ quả tích cực: với định dạng cột, thêm cột vào bảng gần như không làm chậm các truy vấn không dùng cột đó, vì chúng không bị đọc. Điều này cho phép thiết kế bảng rộng, gộp nhiều thuộc tính vào một bảng thay vì tách nhỏ, mà không lo mỗi truy vấn phải trả giá cho mọi cột. Đây là khác biệt lớn so với tư duy định dạng hàng, nơi bảng rộng làm chậm mọi thứ. Tất nhiên bảng quá rộng vẫn có chi phí quản lý và metadata, nhưng về mặt đọc, projection khiến độ rộng gần như miễn phí cho truy vấn hẹp.
Phạm vi đo. Bài đo trên bảng toàn cột số thực, nơi mỗi cột có kích thước tương đương. Với bảng cột kiểu hỗn hợp, chi phí đọc mỗi cột khác nhau, nên thời gian không hẳn tuyến tính theo số cột mà theo tổng kích thước các cột đọc. Thời gian đo trên dữ liệu đã trong bộ nhớ đệm; với đọc đĩa lần đầu, lợi thế của projection còn lớn hơn vì file nhỏ hơn cũng nghĩa là ít I/O vật lý. Chưa đo kết hợp projection với predicate pushdown, khi cả hai cùng hoạt động để đọc ít dòng của ít cột, điều thường gặp trong truy vấn thật.
Ba ý mang về
- Thời gian đọc Parquet tỉ lệ với số cột truy vấn, không phụ thuộc độ rộng bảng. Một cột 17,8 ms, mười cột 133 ms, ba mươi cột 388 ms; mỗi cột thêm vào là một khối byte nữa phải đọc.
- SELECT * là phản mẫu trên dữ liệu cột. Kéo cả ba mươi cột chậm hơn tính một cột hai mươi hai lần; CSV đọc một cột đã chậm hơn Parquet một cột bốn mươi hai lần.
- count(*) trên Parquet gần như tức thì vì chỉ đọc metadata. Đếm năm triệu dòng mất 1,2 ms dù file 527 MB; projection về không cột không cần đọc dữ liệu nào.
Nguồn
- Apache Parquet — File Format, column chunk và cách cột được lưu riêng: https://parquet.apache.org/docs/file-format/
- DuckDB — Parquet, projection pushdown khi đọc file: https://duckdb.org/docs/data/parquet/overview
- DuckDB — Performance Guide, chọn cột và tránh SELECT *: https://duckdb.org/docs/guides/performance/overview
- Apache Parquet — Metadata, số dòng trong row group metadata: https://parquet.apache.org/docs/file-format/metadata/
- Daniel Abadi — Column-Stores vs. Row-Stores: https://www.cs.umd.edu/~abadi/papers/abadi-sigmod08.pdf
Phần sau chuyển trọng tâm từ định dạng sang công cụ: DuckDB quét Parquet trực tiếp tại chỗ mà không cần nạp vào một cơ sở dữ liệu trước. Xem truy vấn thẳng trên file so với import vào bảng khác nhau thế nào về thời gian, và khi nào nạp vào bộ nhớ đáng công so với đọc file lặp lại.
