Bốn phần đầu sê-ri đo định dạng Parquet. Phần này chuyển sang công cụ truy vấn, DuckDB, và một đặc tính làm nó khác với cơ sở dữ liệu truyền thống: nó quét Parquet tại chỗ, truy vấn thẳng trên file mà không cần một bước nạp dữ liệu vào kho trước. Với cơ sở dữ liệu quan hệ cổ điển, muốn phân tích một file dữ liệu phải IMPORT hoặc COPY nó vào bảng đã, rồi mới SELECT. DuckDB bỏ qua bước đó: có file Parquet là query được ngay. Nhưng tại chỗ không phải lúc nào cũng tối ưu; với dữ liệu truy vấn đi truy vấn lại, nạp vào bộ nhớ hoặc lưu sang định dạng riêng của DuckDB lại nhanh hơn. Bài này đo cả ba cách, tìm điểm hoà vốn, và rút ra khi nào dùng cách nào.
Ba cách chạy truy vấn trên một file Parquet
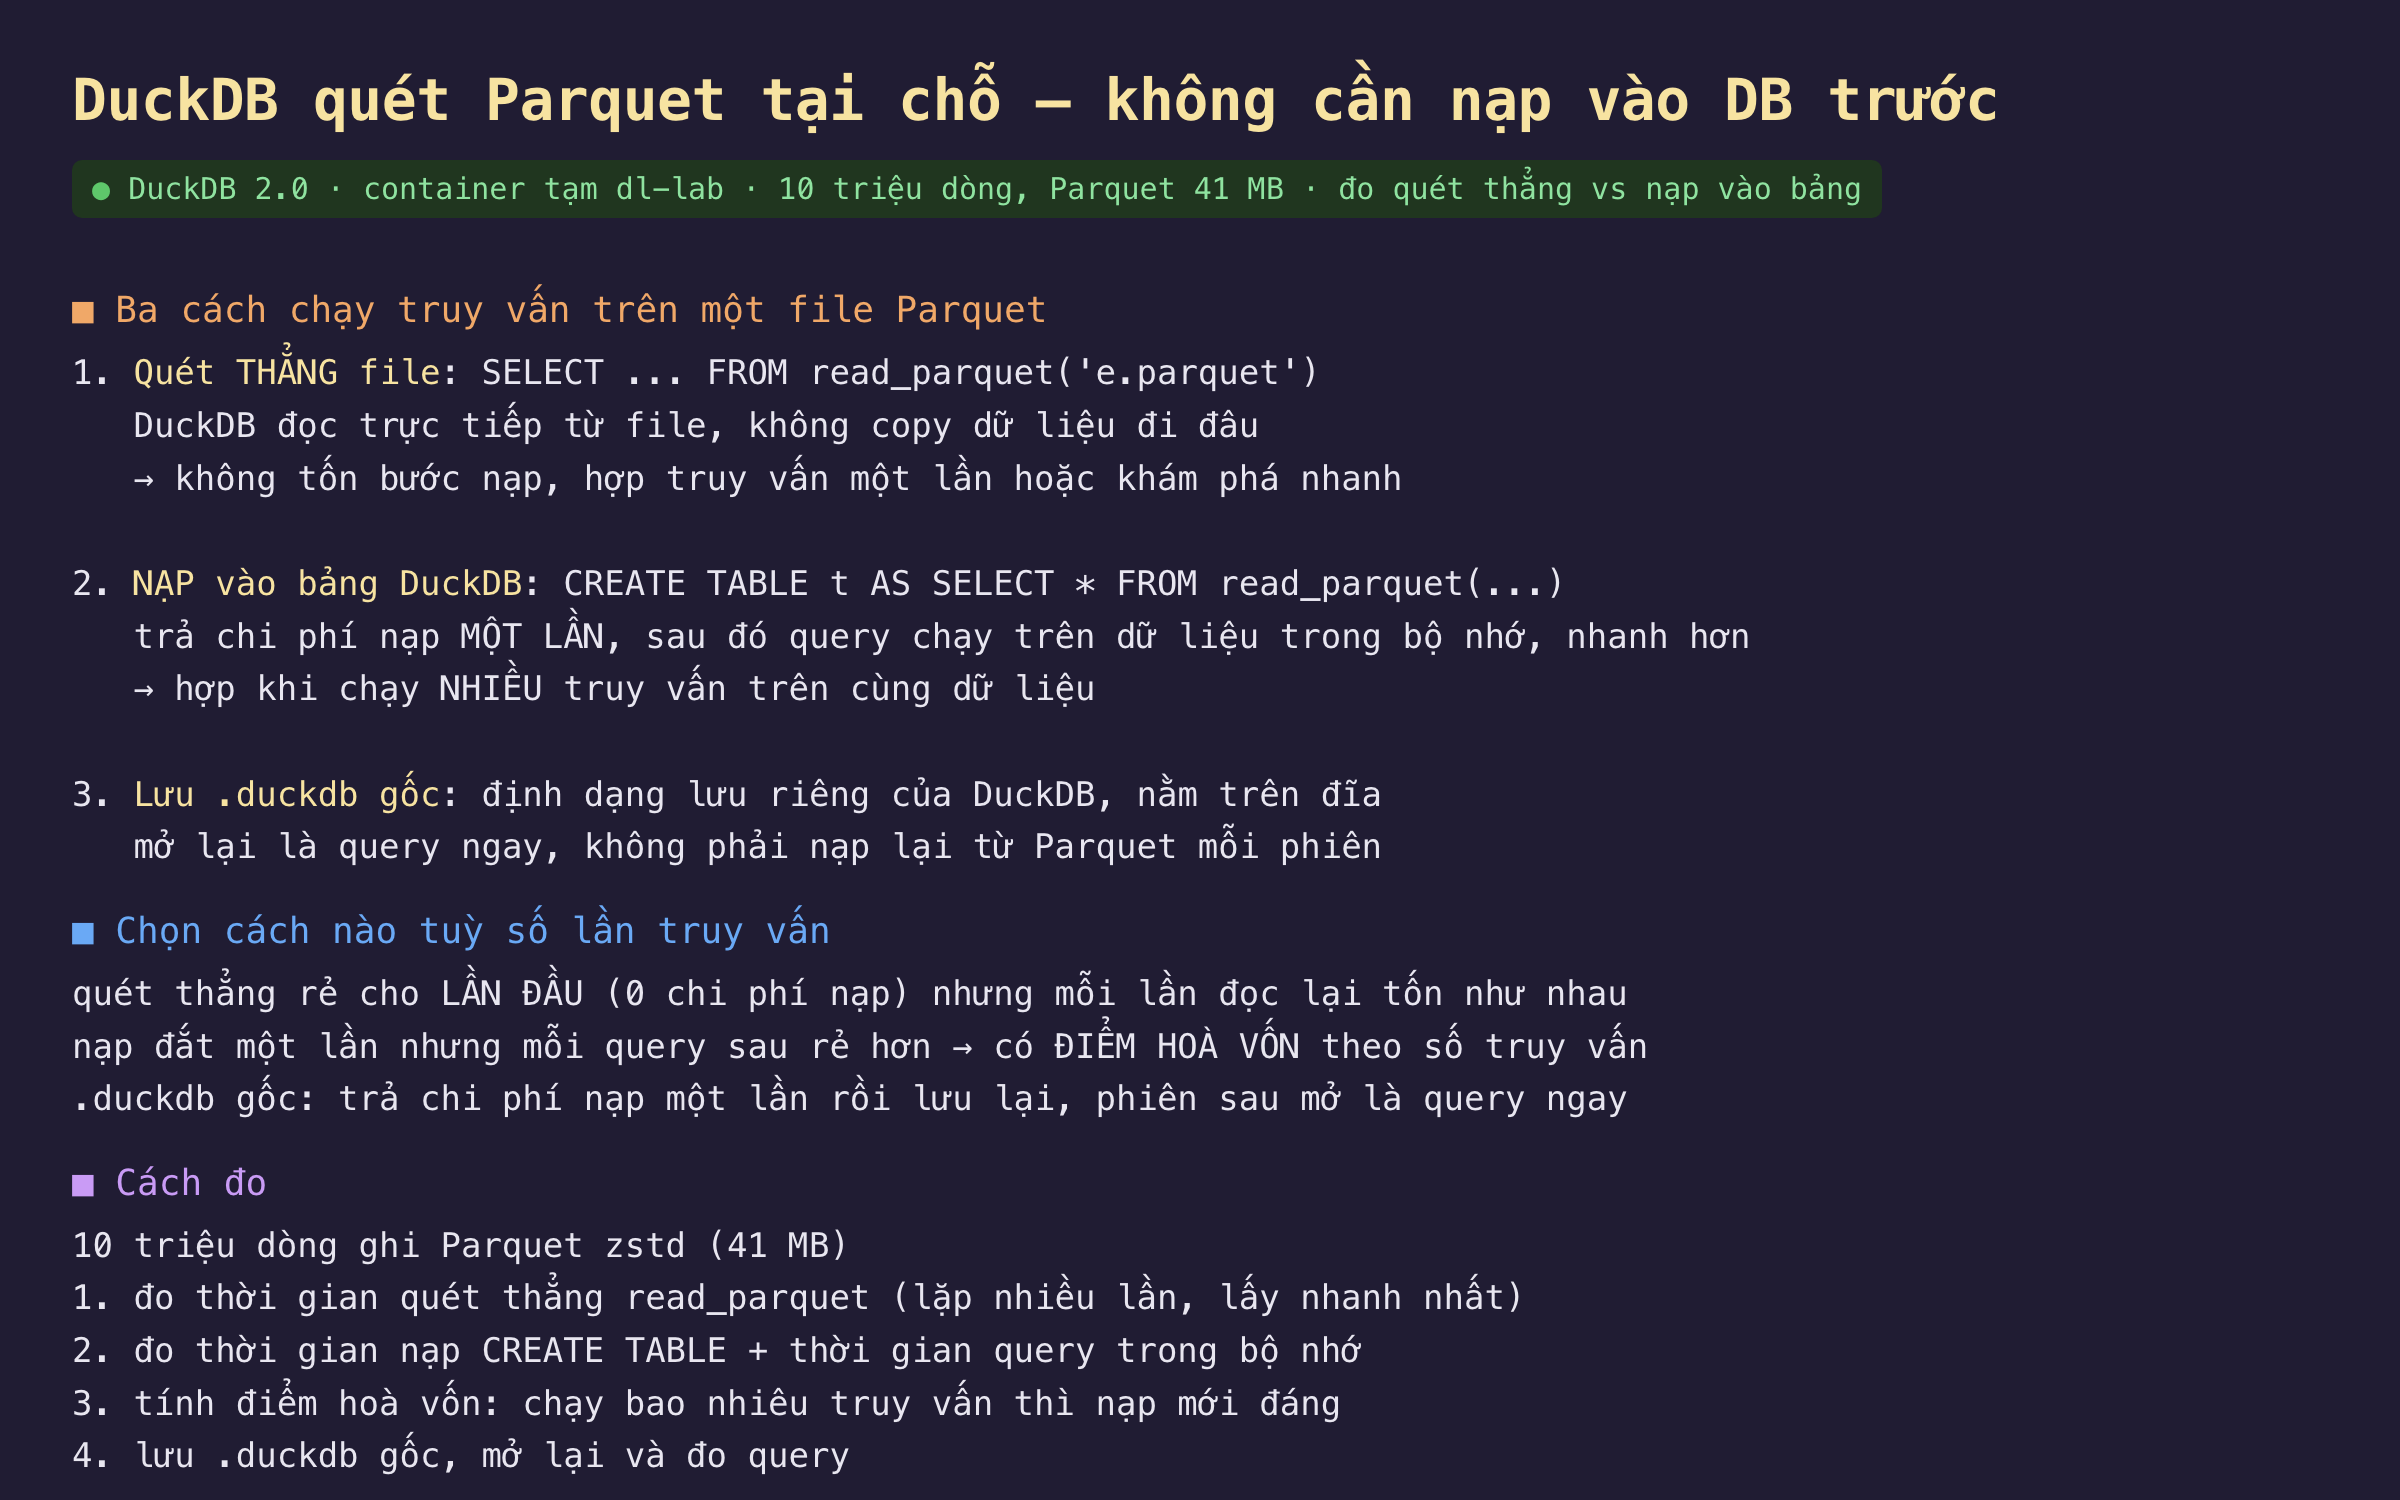
Hình 1: Ba cách chạy truy vấn trên file Parquet — quét thẳng, nạp vào bảng, lưu .duckdb gốc — và cách chọn theo số lần truy vấn.
Cách thứ nhất là quét thẳng file: viết SELECT ... FROM read_parquet('e.parquet'), DuckDB đọc trực tiếp từ file và không copy dữ liệu đi đâu. Không tốn bước nạp, nên cách này hợp với truy vấn một lần hoặc khám phá dữ liệu nhanh, khi bạn chỉ muốn nhìn qua một file mà không cam kết nạp nó vào đâu. Đây là điểm khác biệt lớn với cơ sở dữ liệu truyền thống: không có khái niệm "nạp dữ liệu vào kho rồi mới phân tích", file là nguồn truy vấn trực tiếp.
Cách thứ hai là nạp vào bảng DuckDB: CREATE TABLE t AS SELECT * FROM read_parquet(...). Cách này trả chi phí nạp một lần, chuyển dữ liệu từ file vào cấu trúc bảng trong bộ nhớ của DuckDB, sau đó mọi truy vấn chạy trên dữ liệu trong bộ nhớ và nhanh hơn vì không phải đọc và giải mã file mỗi lần. Nó hợp khi chạy nhiều truy vấn khác nhau trên cùng một tập dữ liệu, ví dụ một phiên phân tích tương tác với hàng chục câu hỏi.
Cách thứ ba là lưu sang định dạng .duckdb gốc, định dạng lưu trữ riêng của DuckDB nằm trên đĩa. Khác với nạp vào bộ nhớ vốn mất khi đóng chương trình, file .duckdb bền qua các phiên: mở lại là query được ngay, không phải nạp lại từ Parquet mỗi lần khởi động. Chọn cách nào tùy số lần truy vấn: quét thẳng rẻ cho lần đầu vì không chi phí nạp nhưng mỗi lần đọc lại tốn như nhau; nạp đắt một lần nhưng mỗi query sau rẻ hơn, nên có một điểm hoà vốn theo số truy vấn; còn .duckdb gốc trả chi phí nạp một lần rồi lưu lại, phiên sau mở là query ngay. Cách đo: ghi mười triệu dòng ra Parquet zstd 41 MB, rồi đo thời gian quét thẳng, thời gian nạp cộng query trong bộ nhớ, tính điểm hoà vốn, và đo query sau khi lưu .duckdb gốc.
Đo thật: quét thẳng rẻ nhất tới truy vấn thứ 17
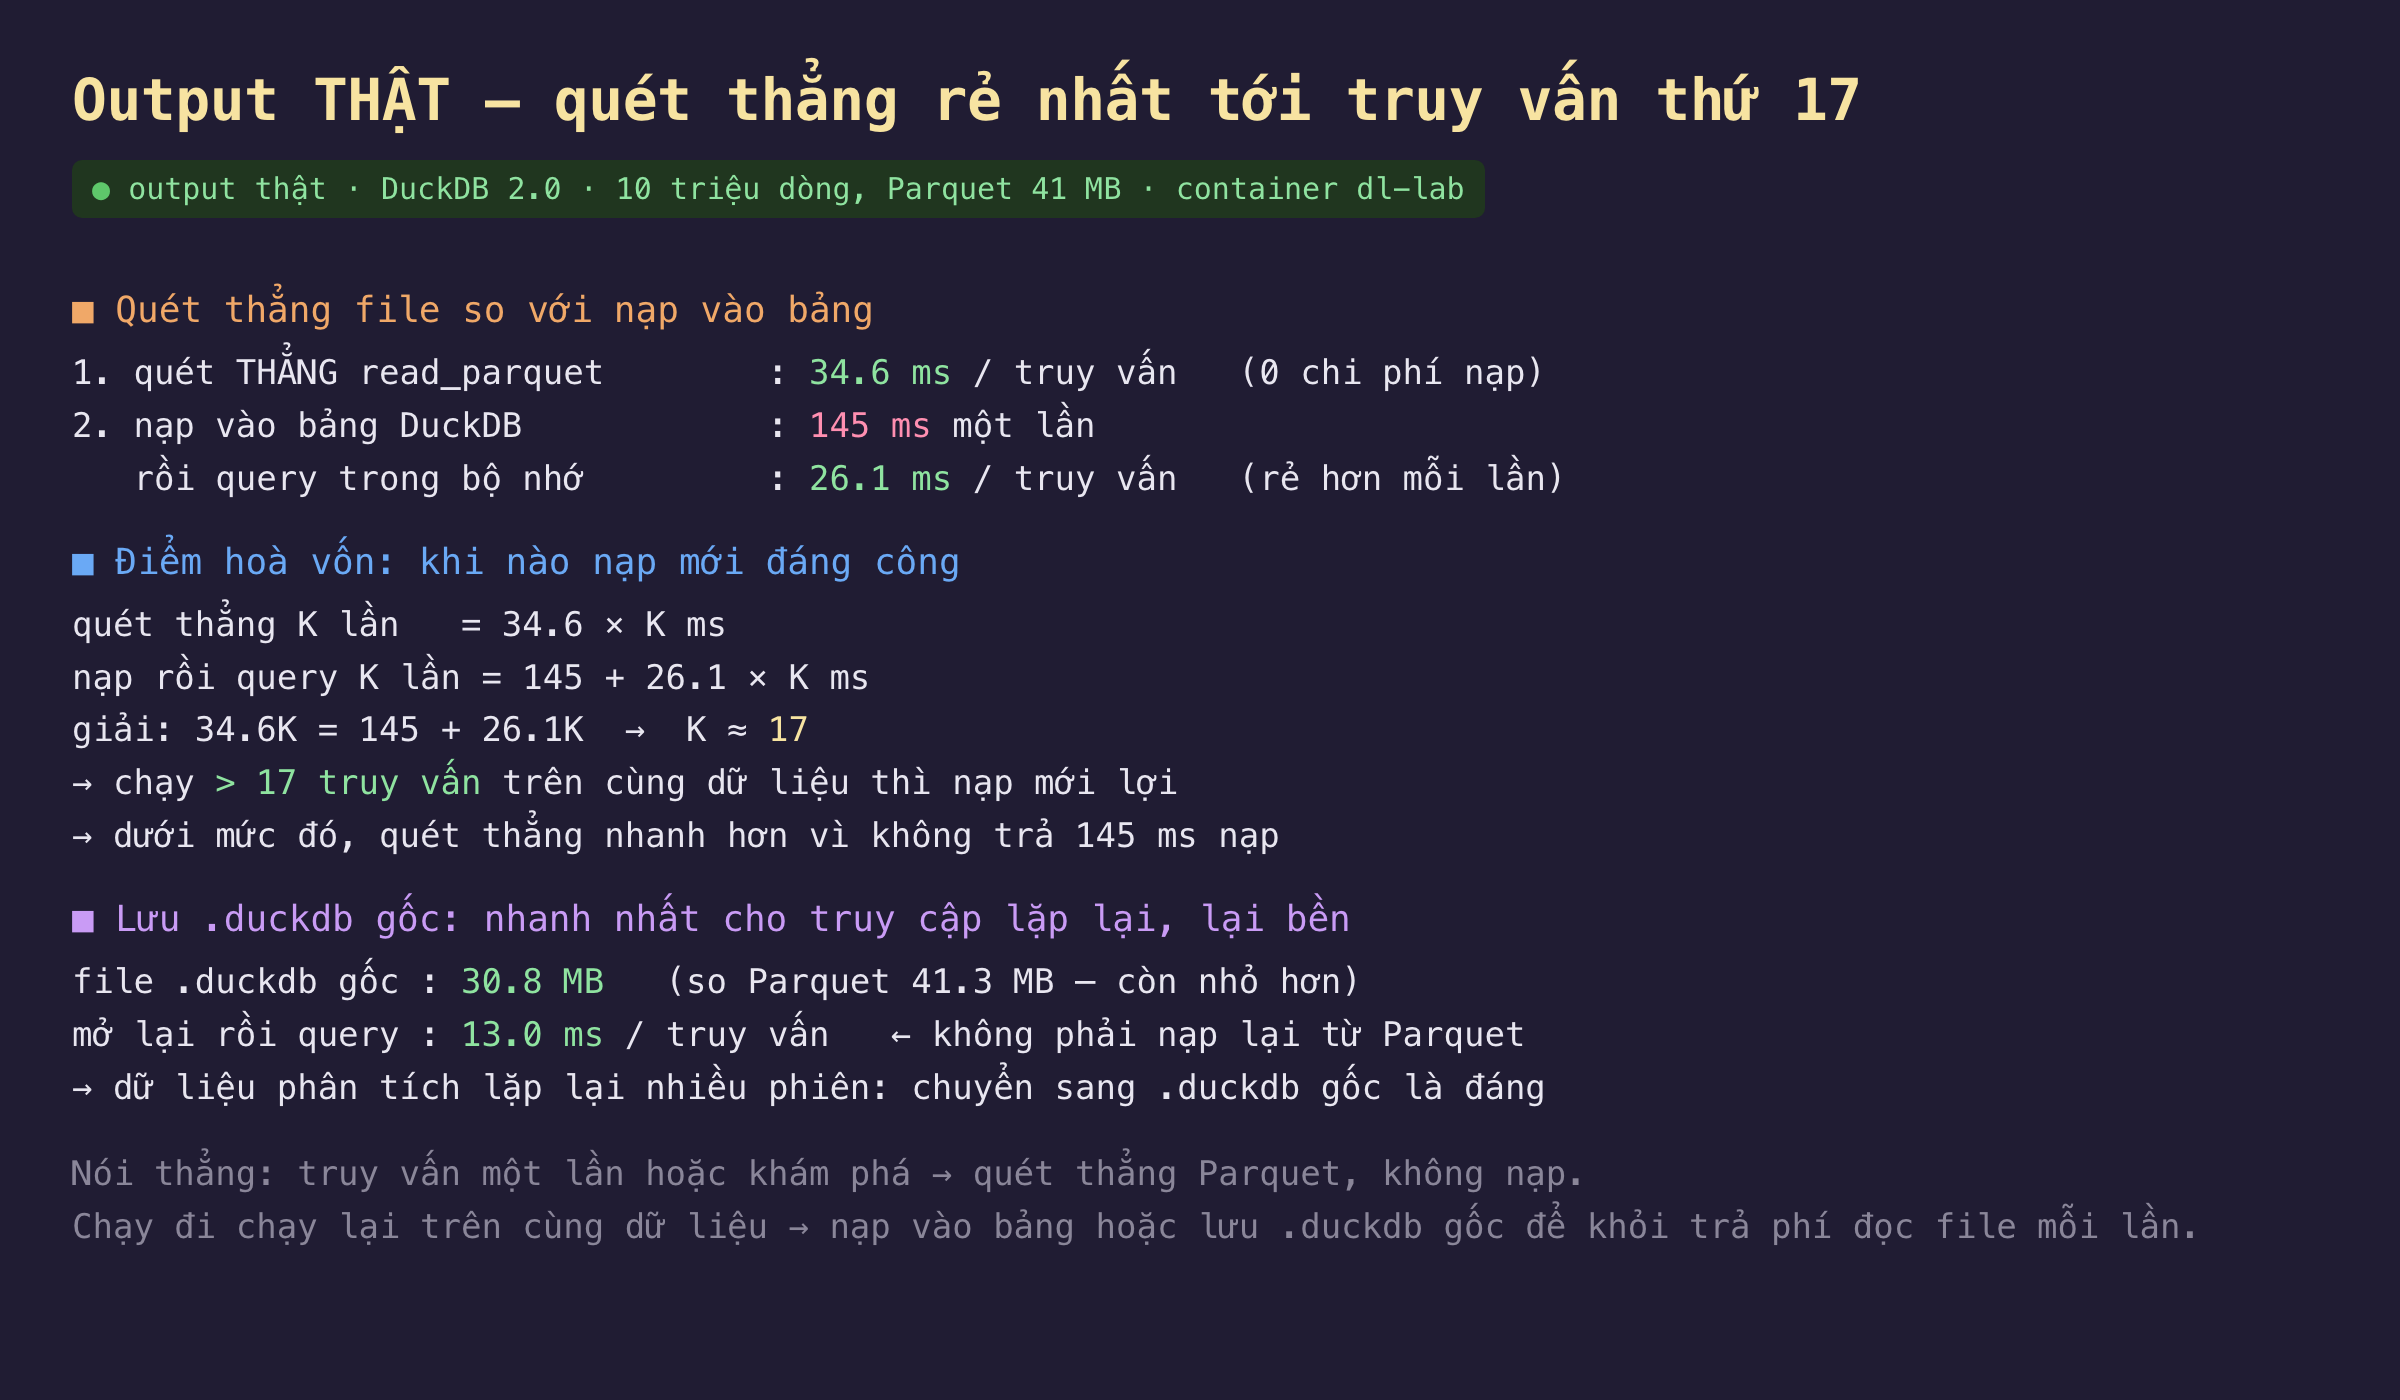
Hình 2: Quét thẳng 34,6 ms, nạp 145 ms một lần rồi 26,1 ms, điểm hoà vốn 17 truy vấn, và .duckdb gốc chỉ 13 ms.
| cách | chi phí một lần | mỗi truy vấn |
|---|---|---|
| quét thẳng read_parquet | 0 | 34,6 ms |
| nạp vào bảng DuckDB | 145 ms | 26,1 ms |
| .duckdb gốc (mở lại) | nạp trước | 13,0 ms |
Quét thẳng file mất 34,6 ms mỗi truy vấn và không tốn bước nạp. Chạy SELECT ... FROM read_parquet(...) lặp lại, mỗi truy vấn mất 34,6 ms. Con số này gồm cả việc đọc và giải mã file Parquet mỗi lần, nhưng không có chi phí nạp trả trước. Với một truy vấn duy nhất, đây là cách nhanh nhất về tổng thời gian, vì nạp vào bảng sẽ tốn thêm 145 ms mà truy vấn đơn lẻ không bù lại được. Đây là lý do quét thẳng lý tưởng cho khám phá: mở một file lạ, chạy vài câu nhìn qua, không cần cam kết gì.
Nạp vào bảng tốn 145 ms một lần nhưng mỗi query sau rẻ hơn. Lệnh CREATE TABLE mất 145 ms để đọc toàn bộ file và dựng bảng trong bộ nhớ. Sau đó mỗi truy vấn trên bảng đó mất 26,1 ms, rẻ hơn quét thẳng vì dữ liệu đã nằm trong bộ nhớ ở định dạng tối ưu của DuckDB, không phải giải mã Parquet lại. Chênh lệch 34,6 trừ 26,1 là 8,5 ms mỗi truy vấn, nhưng phải trả trước 145 ms. Giải phương trình hoà vốn, 34,6 nhân K bằng 145 cộng 26,1 nhân K, cho K xấp xỉ 17. Nghĩa là nếu chạy hơn mười bảy truy vấn trên cùng dữ liệu, nạp vào bảng mới lợi về tổng thời gian; dưới mức đó, quét thẳng nhanh hơn vì không phải trả 145 ms nạp.
Lưu .duckdb gốc là nhanh nhất cho truy cập lặp lại và lại bền. Lưu dữ liệu sang file định dạng .duckdb gốc cho ra file 30,8 MB, thậm chí nhỏ hơn Parquet 41,3 MB nhờ lưu trữ cột tối ưu của DuckDB. Mở lại file này rồi truy vấn chỉ mất 13,0 ms, nhanh nhất trong ba cách, và quan trọng là không phải nạp lại từ Parquet: dữ liệu đã ở sẵn định dạng DuckDB trên đĩa, chỉ cần mở. Với dữ liệu phân tích được truy vấn lặp lại qua nhiều phiên làm việc, chuyển một lần sang .duckdb gốc là đáng, vì mỗi phiên sau không phải trả lại chi phí đọc và chuyển đổi Parquet.
Đánh đổi cần cân nhắc
Quét thẳng cho ad-hoc, nạp hoặc .duckdb gốc cho workload lặp lại. Quy tắc chọn rõ ràng: truy vấn một lần hoặc khám phá thì quét thẳng Parquet, không nạp, để tránh chi phí 145 ms vô ích. Chạy đi chạy lại nhiều truy vấn trên cùng dữ liệu trong một phiên thì nạp vào bảng. Dữ liệu dùng lại qua nhiều phiên hoặc nhiều ngày thì lưu .duckdb gốc để khỏi trả phí đọc Parquet mỗi lần mở. Điểm hoà vốn mười bảy truy vấn ở đây phụ thuộc kích thước dữ liệu và độ phức tạp truy vấn, nhưng nguyên lý không đổi: so chi phí nạp trả trước với khoản tiết kiệm mỗi truy vấn.
Parquet vẫn là định dạng trao đổi; .duckdb gốc là định dạng làm việc. Hai định dạng phục vụ hai vai trò. Parquet là chuẩn mở, đọc được bởi Spark, pandas, nhiều công cụ, nên là định dạng tốt để lưu trữ và trao đổi dữ liệu giữa hệ thống. File .duckdb gốc chỉ DuckDB đọc, nên không dùng để chia sẻ, nhưng tối ưu cho chính DuckDB truy vấn lặp lại. Mô hình thực tế: giữ dữ liệu gốc dưới dạng Parquet trong kho, và khi làm việc nhiều lần với một tập con, nạp hoặc chuyển nó sang .duckdb gốc cho phiên làm việc đó. Chọn sai định dạng cho vai trò, như chia sẻ file .duckdb hay truy vấn lặp lại thẳng trên Parquet lớn, đều trả giá không cần thiết.
Phạm vi đo. Bài đo trên file 41 MB nằm trên đĩa cục bộ, đã trong bộ nhớ đệm hệ điều hành ở các lần lặp sau. Với file lớn hơn bộ nhớ hoặc nằm trên lưu trữ đối tượng từ xa như S3, cân bằng thay đổi: chi phí đọc file mỗi lần của quét thẳng tăng mạnh, đẩy điểm hoà vốn xuống và làm nạp hoặc .duckdb gốc hấp dẫn hơn. Bài không đo trường hợp từ xa đó, và cũng chưa đo chi phí bộ nhớ của việc nạp bảng lớn, một yếu tố giới hạn khi dữ liệu gần bằng RAM, chủ đề của phần về xử lý dữ liệu lớn hơn RAM sau.
Ba ý mang về
- DuckDB quét Parquet tại chỗ, không cần nạp vào kho trước.
read_parquettruy vấn thẳng file, 34,6 ms mỗi lần, không chi phí nạp; lý tưởng cho truy vấn một lần và khám phá. - Nạp vào bảng có điểm hoà vốn theo số truy vấn. Tốn 145 ms một lần rồi 26,1 ms mỗi query; chạy hơn mười bảy truy vấn trên cùng dữ liệu thì nạp mới lợi.
- Lưu .duckdb gốc nhanh nhất cho truy cập lặp lại và bền qua phiên. File 30,8 MB nhỏ hơn Parquet, query 13 ms, không phải nạp lại; dùng cho dữ liệu làm việc nhiều lần.
Nguồn
- DuckDB — Reading Parquet Files, hàm
read_parquetvà quét tại chỗ: https://duckdb.org/docs/data/parquet/overview - DuckDB — Importing Data,
CREATE TABLE ASvà nạp dữ liệu: https://duckdb.org/docs/data/overview - DuckDB — Database Files, định dạng lưu trữ .duckdb: https://duckdb.org/docs/sql/statements/attach
- DuckDB — Why DuckDB, triết lý truy vấn tại chỗ: https://duckdb.org/why_duckdb
- DuckDB — Performance Guide, chọn giữa đọc file và nạp bảng: https://duckdb.org/docs/guides/performance/overview
Phần sau đi vào vì sao DuckDB nhanh ngay cả khi quét thẳng: vectorized execution. Thay vì xử lý từng dòng một như vòng lặp thông thường, DuckDB xử lý dữ liệu theo lô vector lớn. Xem thông lượng aggregation chênh bao nhiêu giữa một vòng lặp Python tính từng dòng và DuckDB tính theo vector trên cùng phép tính.
