Bạn viết một regex thay thế từ cat bằng dog trong văn bản, chạy xong mới phát hiện category biến thành dogegory và scatter thành sdogter. Đây là lỗi kinh điển, và cách chữa không phải sửa phần khớp ký tự — mà thêm những thứ không khớp ký tự nào: neo (anchor) và ranh giới (boundary). Chúng là nhóm cấu trúc regex đặc biệt: ^, $, \b, \B không tiêu thụ một ký tự nào của input (nên gọi là zero-width), mà chỉ khẳng định một điều kiện về vị trí hiện tại. Hiểu chúng là chìa khóa để regex khớp đúng chỗ chứ không chỉ đúng nội dung. Bài này (phần 3 loạt Regex) đo thật cách chúng đổi kết quả.
Zero-width: khẳng định vị trí, không nuốt ký tự
Nhớ lại phần 1: engine duyệt input theo máy trạng thái, mỗi ký tự đẩy nó qua một trạng thái. Anchor thì khác — tới lượt nó, engine không đọc ký tự nào; nó chỉ hỏi "vị trí hiện tại có thỏa điều kiện không?", đúng thì đi tiếp, sai thì nhánh này hỏng. Các anchor thường gặp:
^: đầu chuỗi (hoặc đầu dòng nếu bật cờ MULTILINE).$: cuối chuỗi (hoặc cuối dòng nếu bật MULTILINE).\b: ranh giới từ — vị trí giữa một ký tự-từ (\w: chữ, số,_) và một ký tự-không-từ (\W), hoặc mép đầu/cuối.\B: không phải ranh giới từ (ngược lại\b).
Vì zero-width, \bcat\b vẫn chỉ khớp đúng ba ký tự cat — hai \b không thêm ký tự nào vào kết quả.
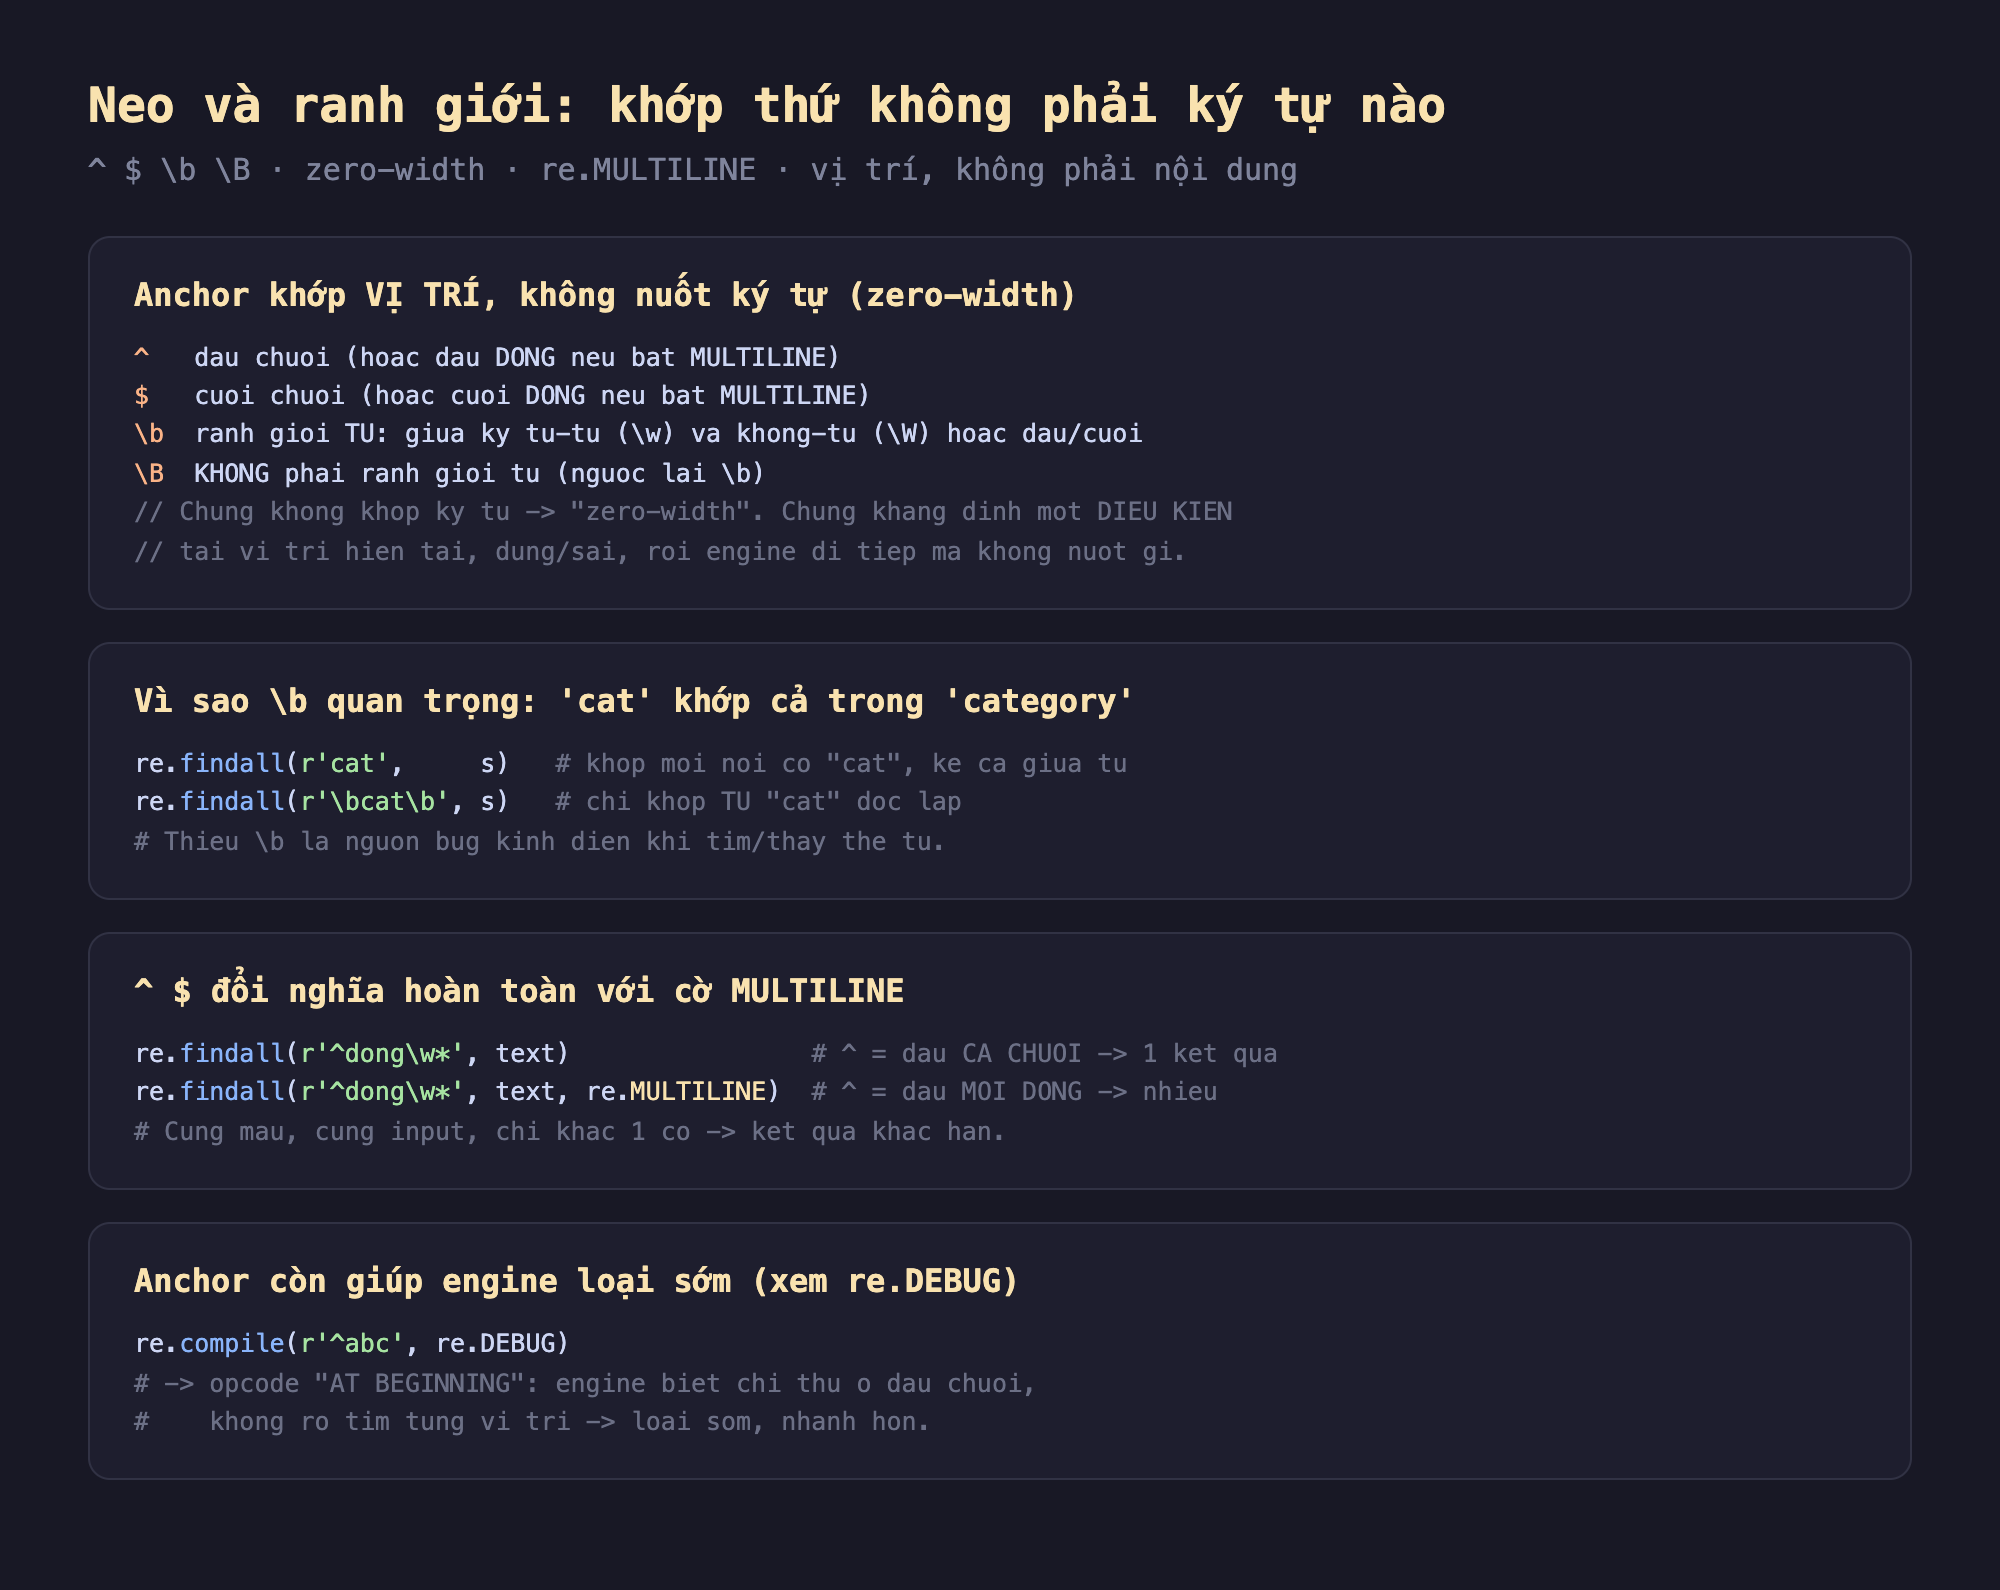
Hình 1: Anchor (^ $ \b \B) khớp vị trí, không nuốt ký tự (zero-width); \b phân biệt cat độc lập với cat trong category; ^/$ đổi nghĩa theo cờ MULTILINE; và anchor ^ giúp engine loại sớm (opcode AT BEGINNING).
Đo thật: từng anchor đổi kết quả ra sao
Mình chạy python re trên các ca đối chiếu:
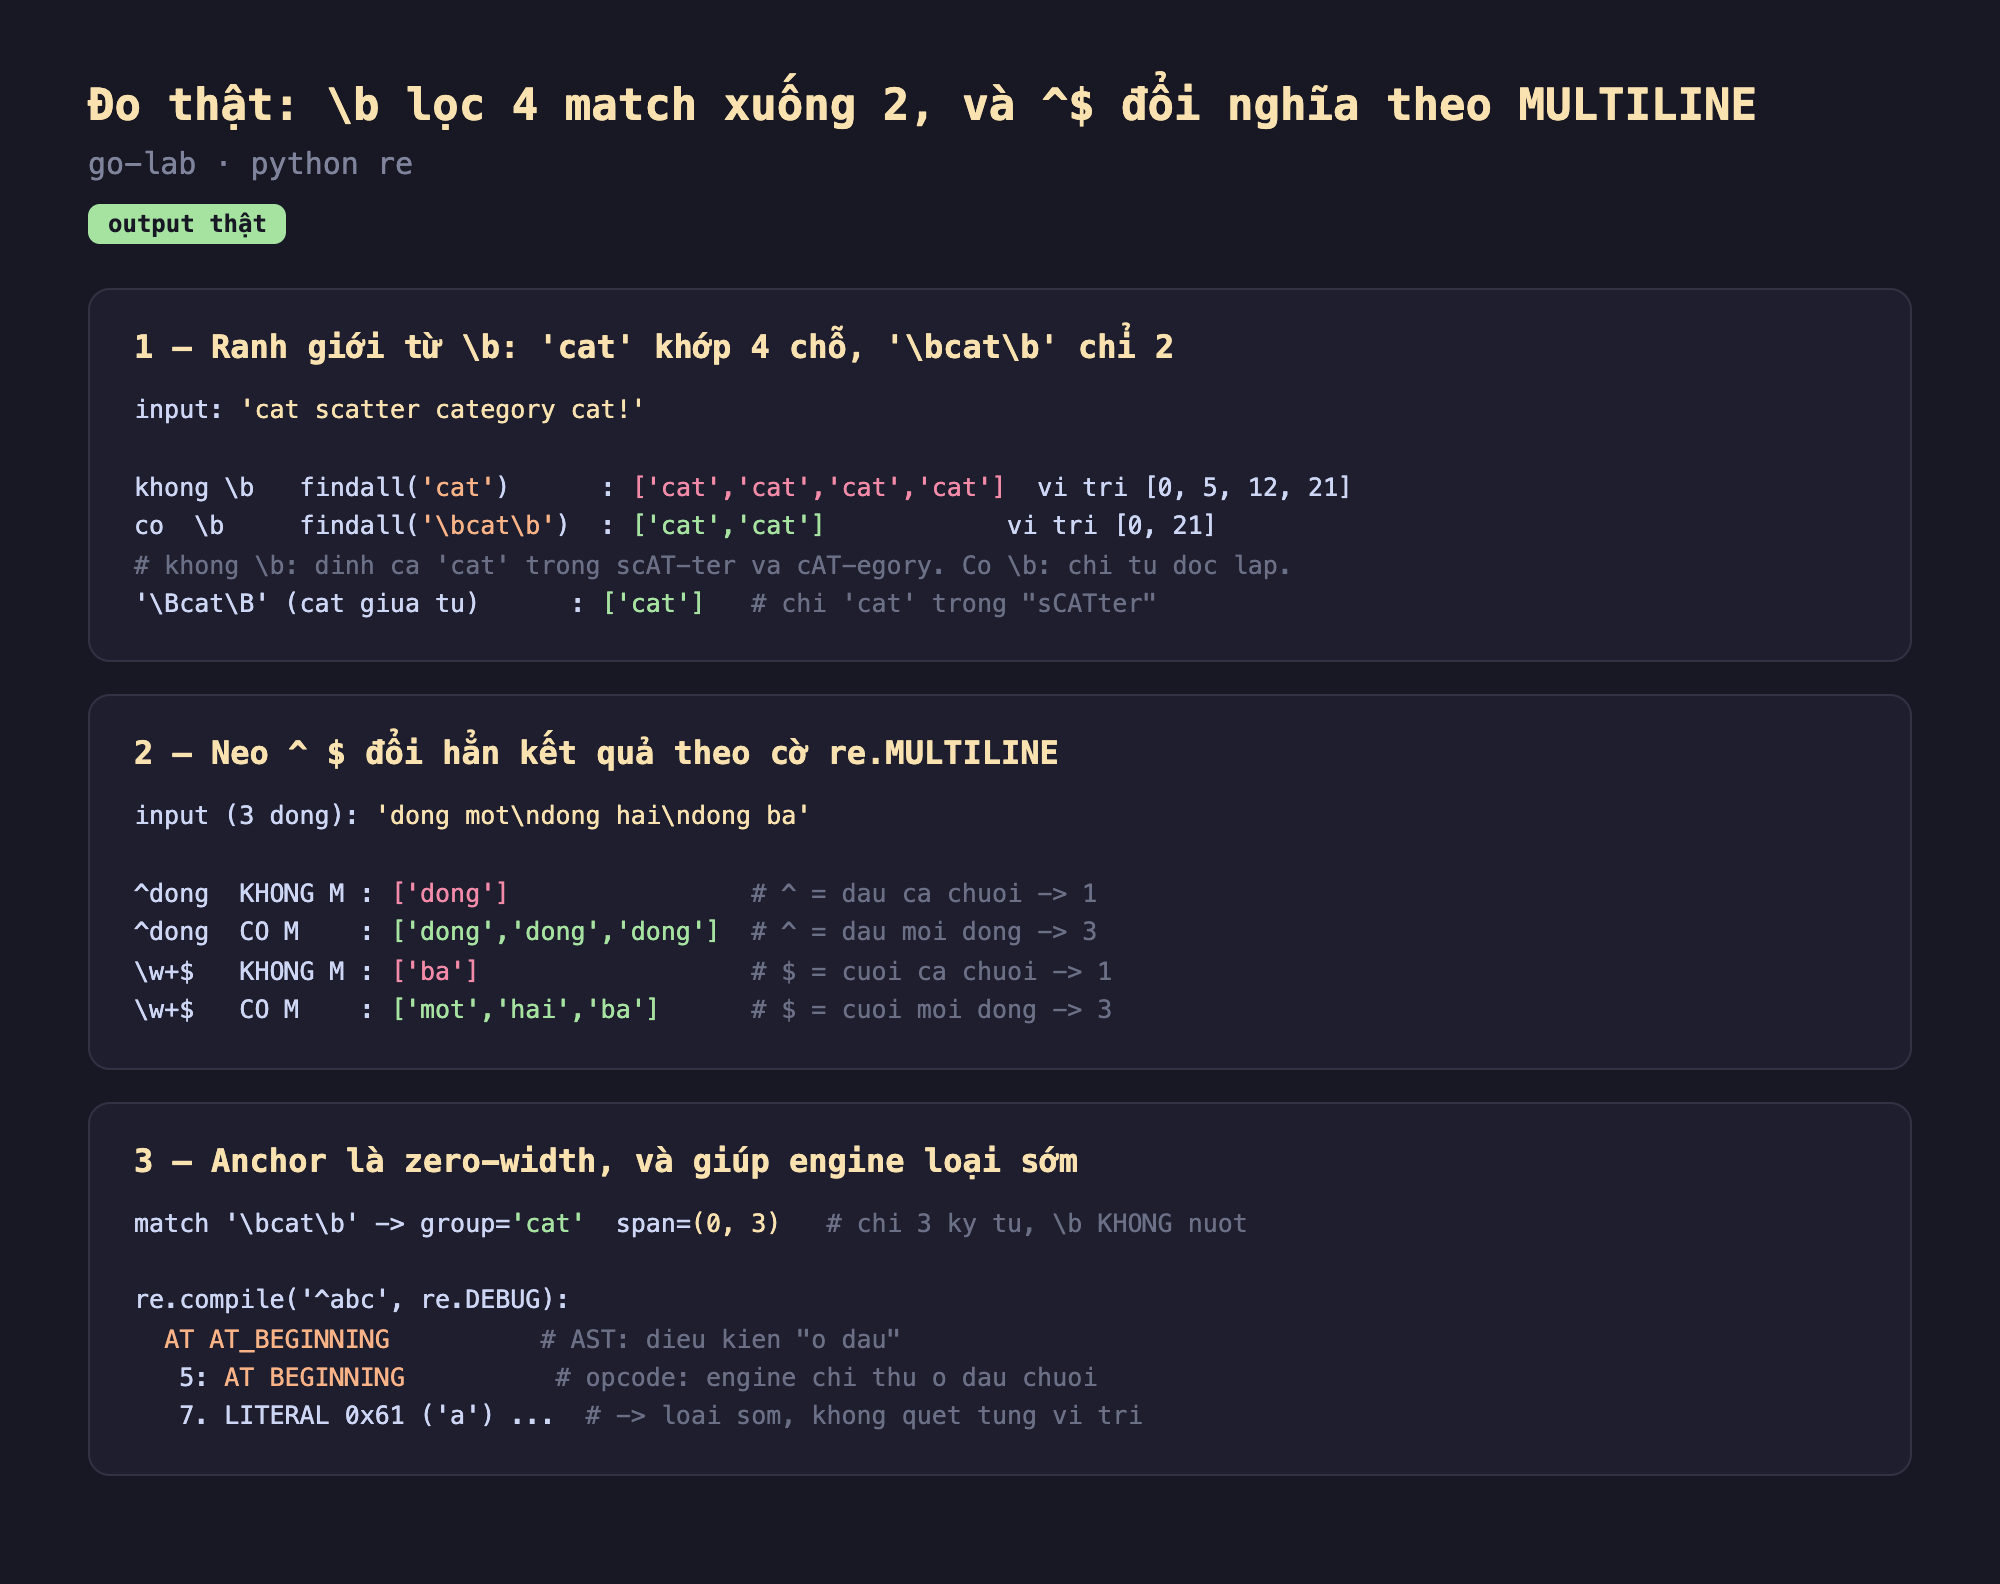
Hình 2: Chạy thật — cat khớp 4 chỗ [0,5,12,21] (kể cả trong scatter, category), \bcat\b chỉ 2 [0,21], \Bcat\B đúng 1 (cat trong scatter); ^dong/\w+$ cho 1 kết quả khi không MULTILINE, 3 kết quả khi có; \bcat\b span (0,3); re.DEBUG của ^abc cho AT BEGINNING.
\bbiến 4 match thành 2: trêncat scatter category cat!, mẫu trầncatkhớp bốn vị trí[0, 5, 12, 21]— dính cảcatnằm trongscattervàcategory. Thêm ranh giới\bcat\blọc còn hai[0, 21]: chỉ từcatđứng một mình (vàcat!vì!là ký tự không-từ nên vẫn có ranh giới). Ngược lại\Bcat\B(yêu cầucatnằm giữa một từ) khớp đúng một chỗ —cattrongscatter. Đây chính là cách sửa lỗi tìm-thay-thế dính nhầm.^$đổi nghĩa hoàn toàn với MULTILINE: trên chuỗi ba dòng,^dongkhông cờ chỉ khớpdongở đầu cả chuỗi (1 kết quả); bậtre.MULTILINEthì^nghĩa là đầu mỗi dòng, khớp cả ba (['dong','dong','dong']). Tương tự\w+$: không cờ chỉ lấy từ cuối cả chuỗi (ba), có cờ lấy từ cuối mỗi dòng (mot,hai,ba). Cùng mẫu, cùng input — chỉ một cờ khác biệt là kết quả đổi hẳn.- Zero-width, và loại sớm: match
\bcat\bcóspan=(0,3)— đúng ba ký tự, hai\bkhông nuốt gì. Và như phần 1,re.DEBUGcủa^abcsinh opcodeAT BEGINNING: engine biết chỉ cần thử ở đầu chuỗi, không phải dò từng vị trí — anchor^giúp loại sớm, tăng tốc.
Đánh đổi cần cân nhắc
\w và \b phụ thuộc định nghĩa "ký tự-từ", mà định nghĩa đó khác nhau theo engine/cờ. Mặc định \w là [A-Za-z0-9_] (ASCII), nên \b quanh chữ có dấu tiếng Việt hay ký tự Unicode có thể hành xử bất ngờ — "café" có thể bị coi là có ranh giới giữa caf và é. Python 3 mặc định bật Unicode cho \w, nhưng nhiều engine/cờ khác thì không. Khi làm việc với tiếng Việt (phần 9 về Unicode), phải kiểm tra \b có hiểu đúng chữ có dấu không, đừng cho là mặc định.
$ và ký tự xuống dòng cuối là một cái bẫy. Mặc định (không MULTILINE), $ khớp ở cuối chuỗi và ngay trước một \n kết thúc chuỗi. Điều này khiến \d+$ trên "123\n" vẫn khớp 123. Nếu cần khớp tuyệt đối cuối chuỗi không tính \n, dùng \Z (Python) / \z (nhiều engine). Nhầm $ với \Z gây bug tinh vi khi xử lý dữ liệu có dòng trắng cuối.
Anchor tăng tốc, nhưng chỉ khi đặt đúng. ^ giúp engine không dò mọi vị trí — nhưng nếu bạn viết .*abc (không neo) khi thật ra dữ liệu luôn bắt đầu bằng abc, engine vẫn thử tốn kém. Neo mẫu vào vị trí bạn biết chắc (dùng ^, hoặc \A cho đầu tuyệt đối) là một tối ưu regex đơn giản mà hiệu quả (phần 11). Ngược lại, đừng thêm ^/$ bừa nếu dữ liệu không thực sự neo ở đó — bạn sẽ khớp hụt.
Ba ý mang về
- Anchor là zero-width — khớp vị trí, không nuốt ký tự: đo thật
\bcat\bcóspan=(0,3), chỉ ba ký tự dù có hai\b; chúng khẳng định điều kiện tại vị trí rồi engine đi tiếp. \bquyết định khớp từ hay khớp chuỗi con: đo thậtcatdính 4 chỗ (kể cả trongscatter,category),\bcat\blọc còn 2 từ độc lập — thiếu\blà nguồn lỗi tìm-thay-thế kinh điển.^$đổi nghĩa theo MULTILINE: đo thật^dongcho 1 kết quả (đầu cả chuỗi) hay 3 (đầu mỗi dòng) tùy cờ; nhớ$còn khớp trước\ncuối (dùng\Znếu cần cuối tuyệt đối), và\w/\bphụ thuộc định nghĩa Unicode của engine.
Nguồn
- Python docs — re (anchors,
\b, flags): https://docs.python.org/3/library/re.html - man7.org — grep(1) (
-w,^,$): https://man7.org/linux/man-pages/man1/grep.1.html - Go docs — regexp/syntax (empty-width): https://pkg.go.dev/regexp/syntax
Phần sau ta đào vào hai viên gạch nền tảng nhất: lớp ký tự [...] và quantifier {m,n} — cách engine đọc một lớp, và vì sao {m,n} mở rộng thành đường đi khớp thế nào.
