Nếu regex là một ngôn ngữ, thì lớp ký tự ([...]) và quantifier (*, +, {m,n}) là bảng chữ cái và ngữ pháp cơ bản của nó — gần như mọi mẫu đều dựng từ hai viên gạch này. Chúng đơn giản đến mức dễ bị coi thường, nhưng chính sự "hiển nhiên" đó giấu vài cái bẫy khiến mẫu khớp sai một cách âm thầm: \w không giống [a-zA-Z] như nhiều người tưởng, và {2,4} khớp không như bạn đoán. Bài này (phần 4 loạt Regex) đo thật cả hai để bạn dùng chúng chính xác — và nối tiếp phần 1, ta xem luôn chúng biên dịch thành opcode gì.
Lớp ký tự: khớp đúng một ký tự trong tập
Một lớp ký tự [...] khớp đúng một ký tự nằm trong tập bạn liệt kê:
[abc]— một tronga,b,c.[a-z]— một chữ thường, dùng dải (range) từatớiz.[^0-9]— một ký tự không phải số (dấu^ngay sau[nghĩa là phủ định).
Có các shorthand (lối tắt) cho những lớp hay dùng: \d = [0-9], \w = "ký tự-từ" (chữ + số + _), \s = khoảng trắng; và bản in hoa \D, \W, \S là phủ định tương ứng. Nhưng "chữ" trong \w là gì thì tùy engine — và đó là cái bẫy.
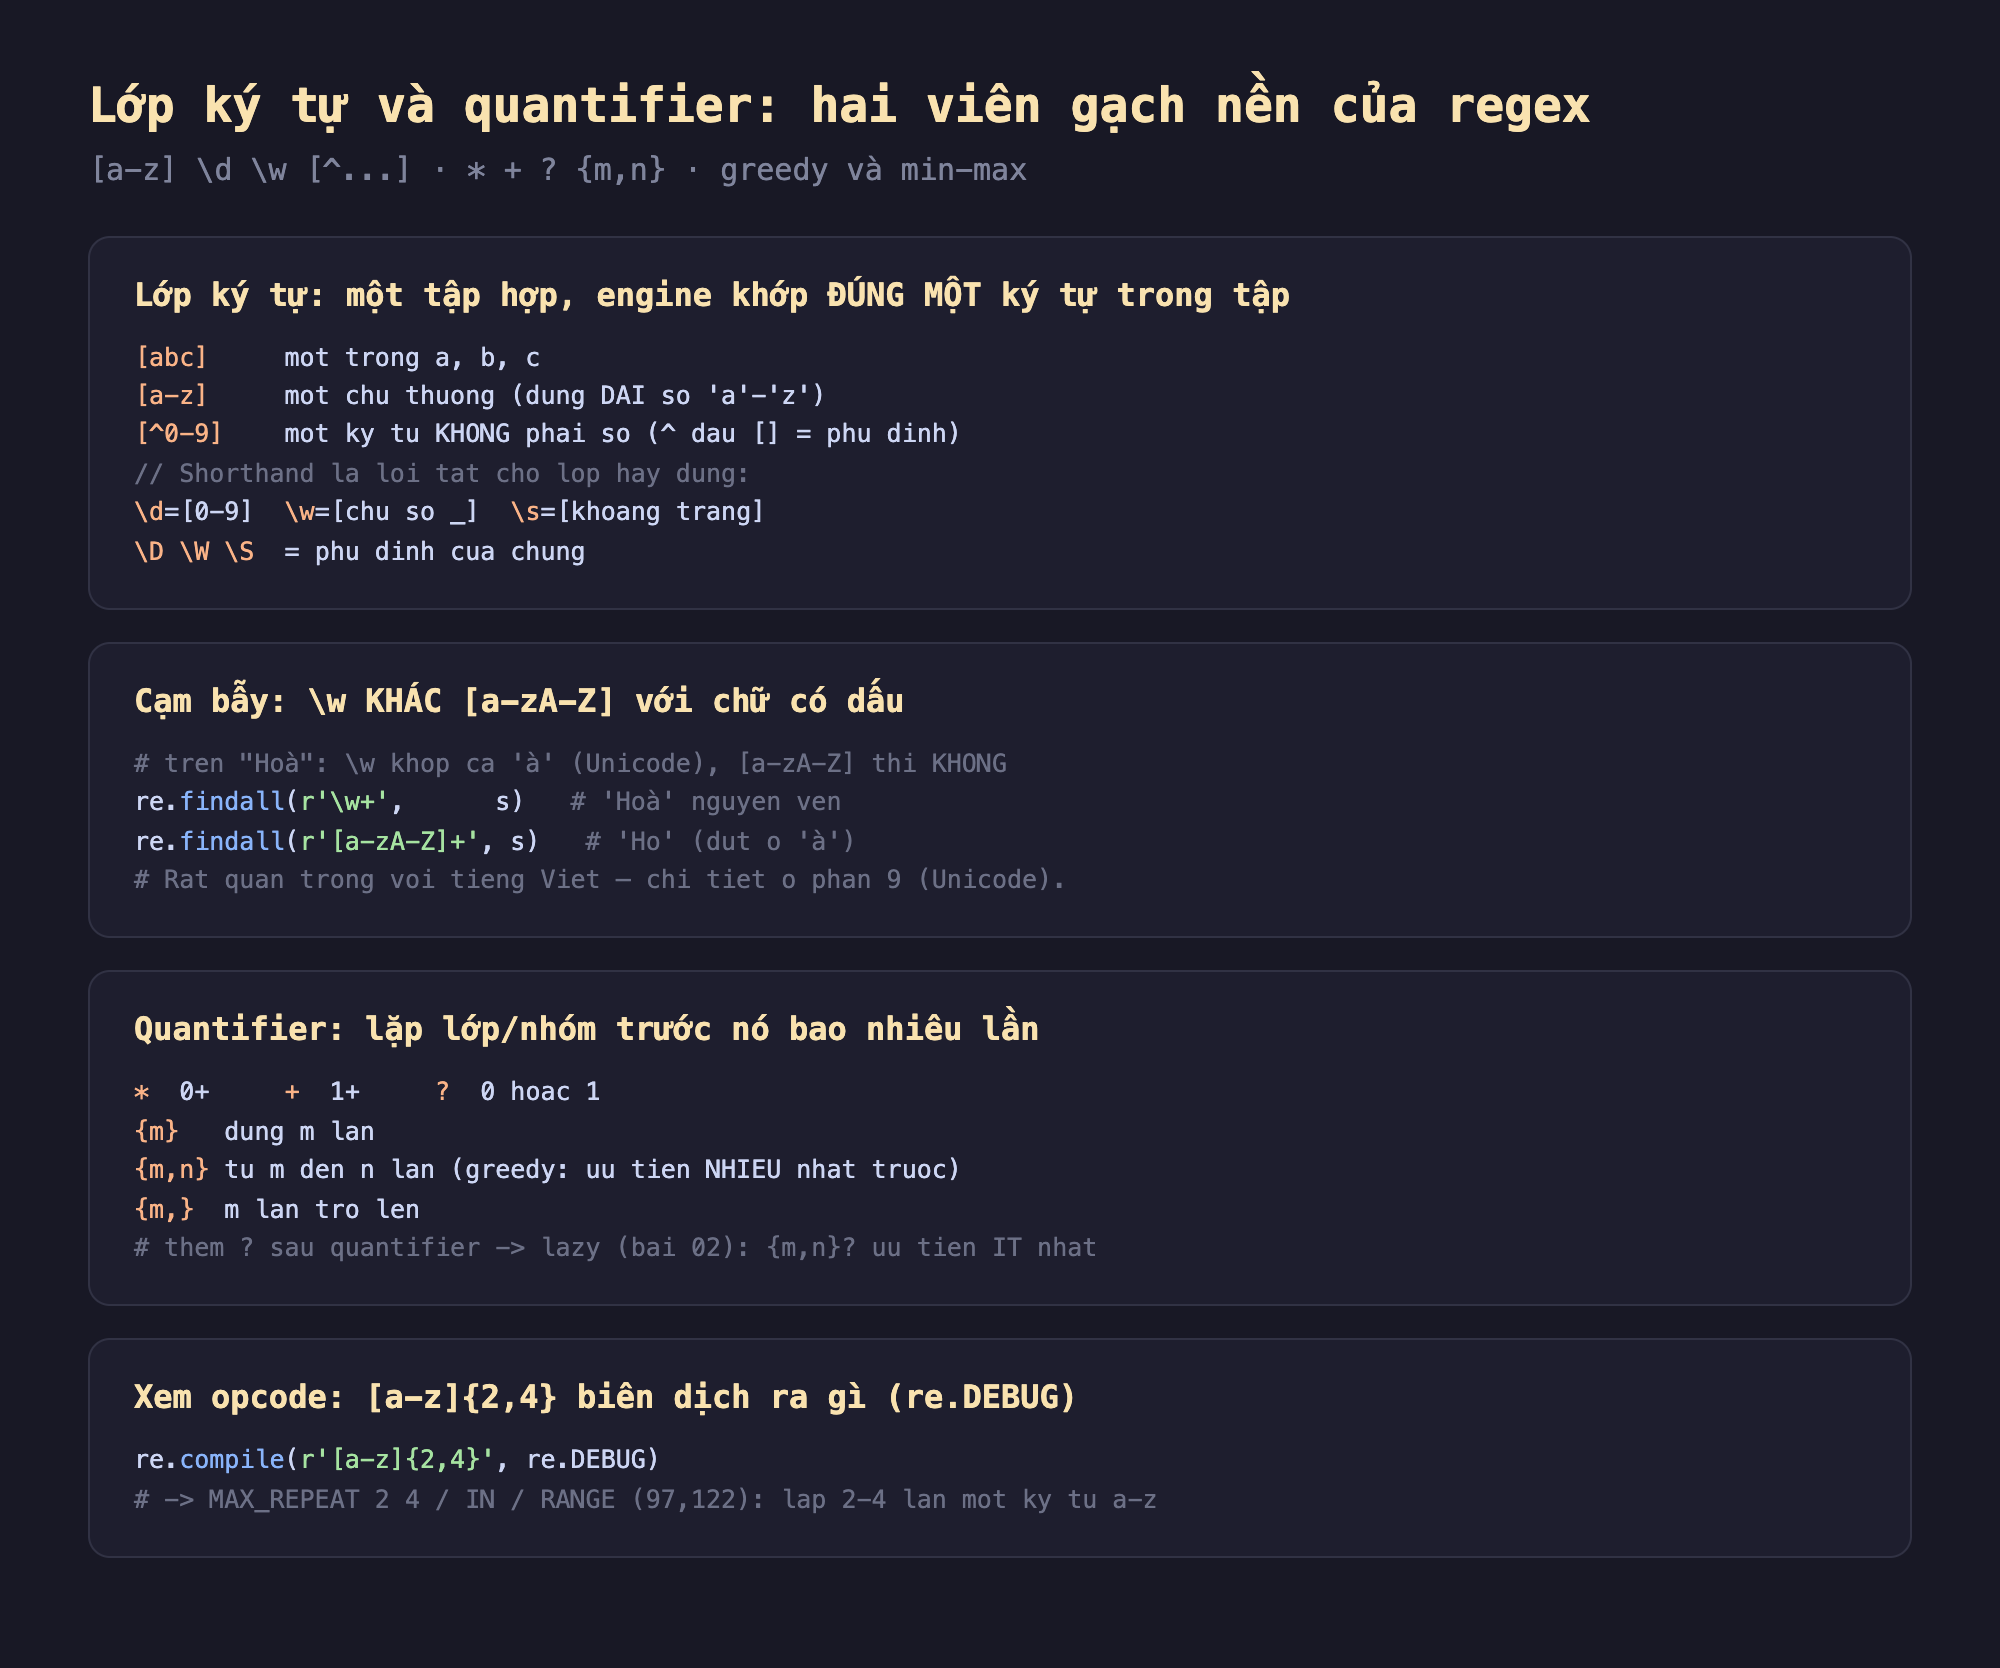
Hình 1: Lớp ký tự [...] khớp đúng một ký tự trong tập ([a-z], [^0-9]); shorthand \d/\w/\s và phủ định \D/\W/\S; quantifier */+/?/{m,n} lặp phần trước; và \w khác [a-zA-Z] với chữ có dấu.
Đo thật: từng lớp và quantifier khớp gì
Mình chạy python re trên abc_123 Hoà-9 cafe33:
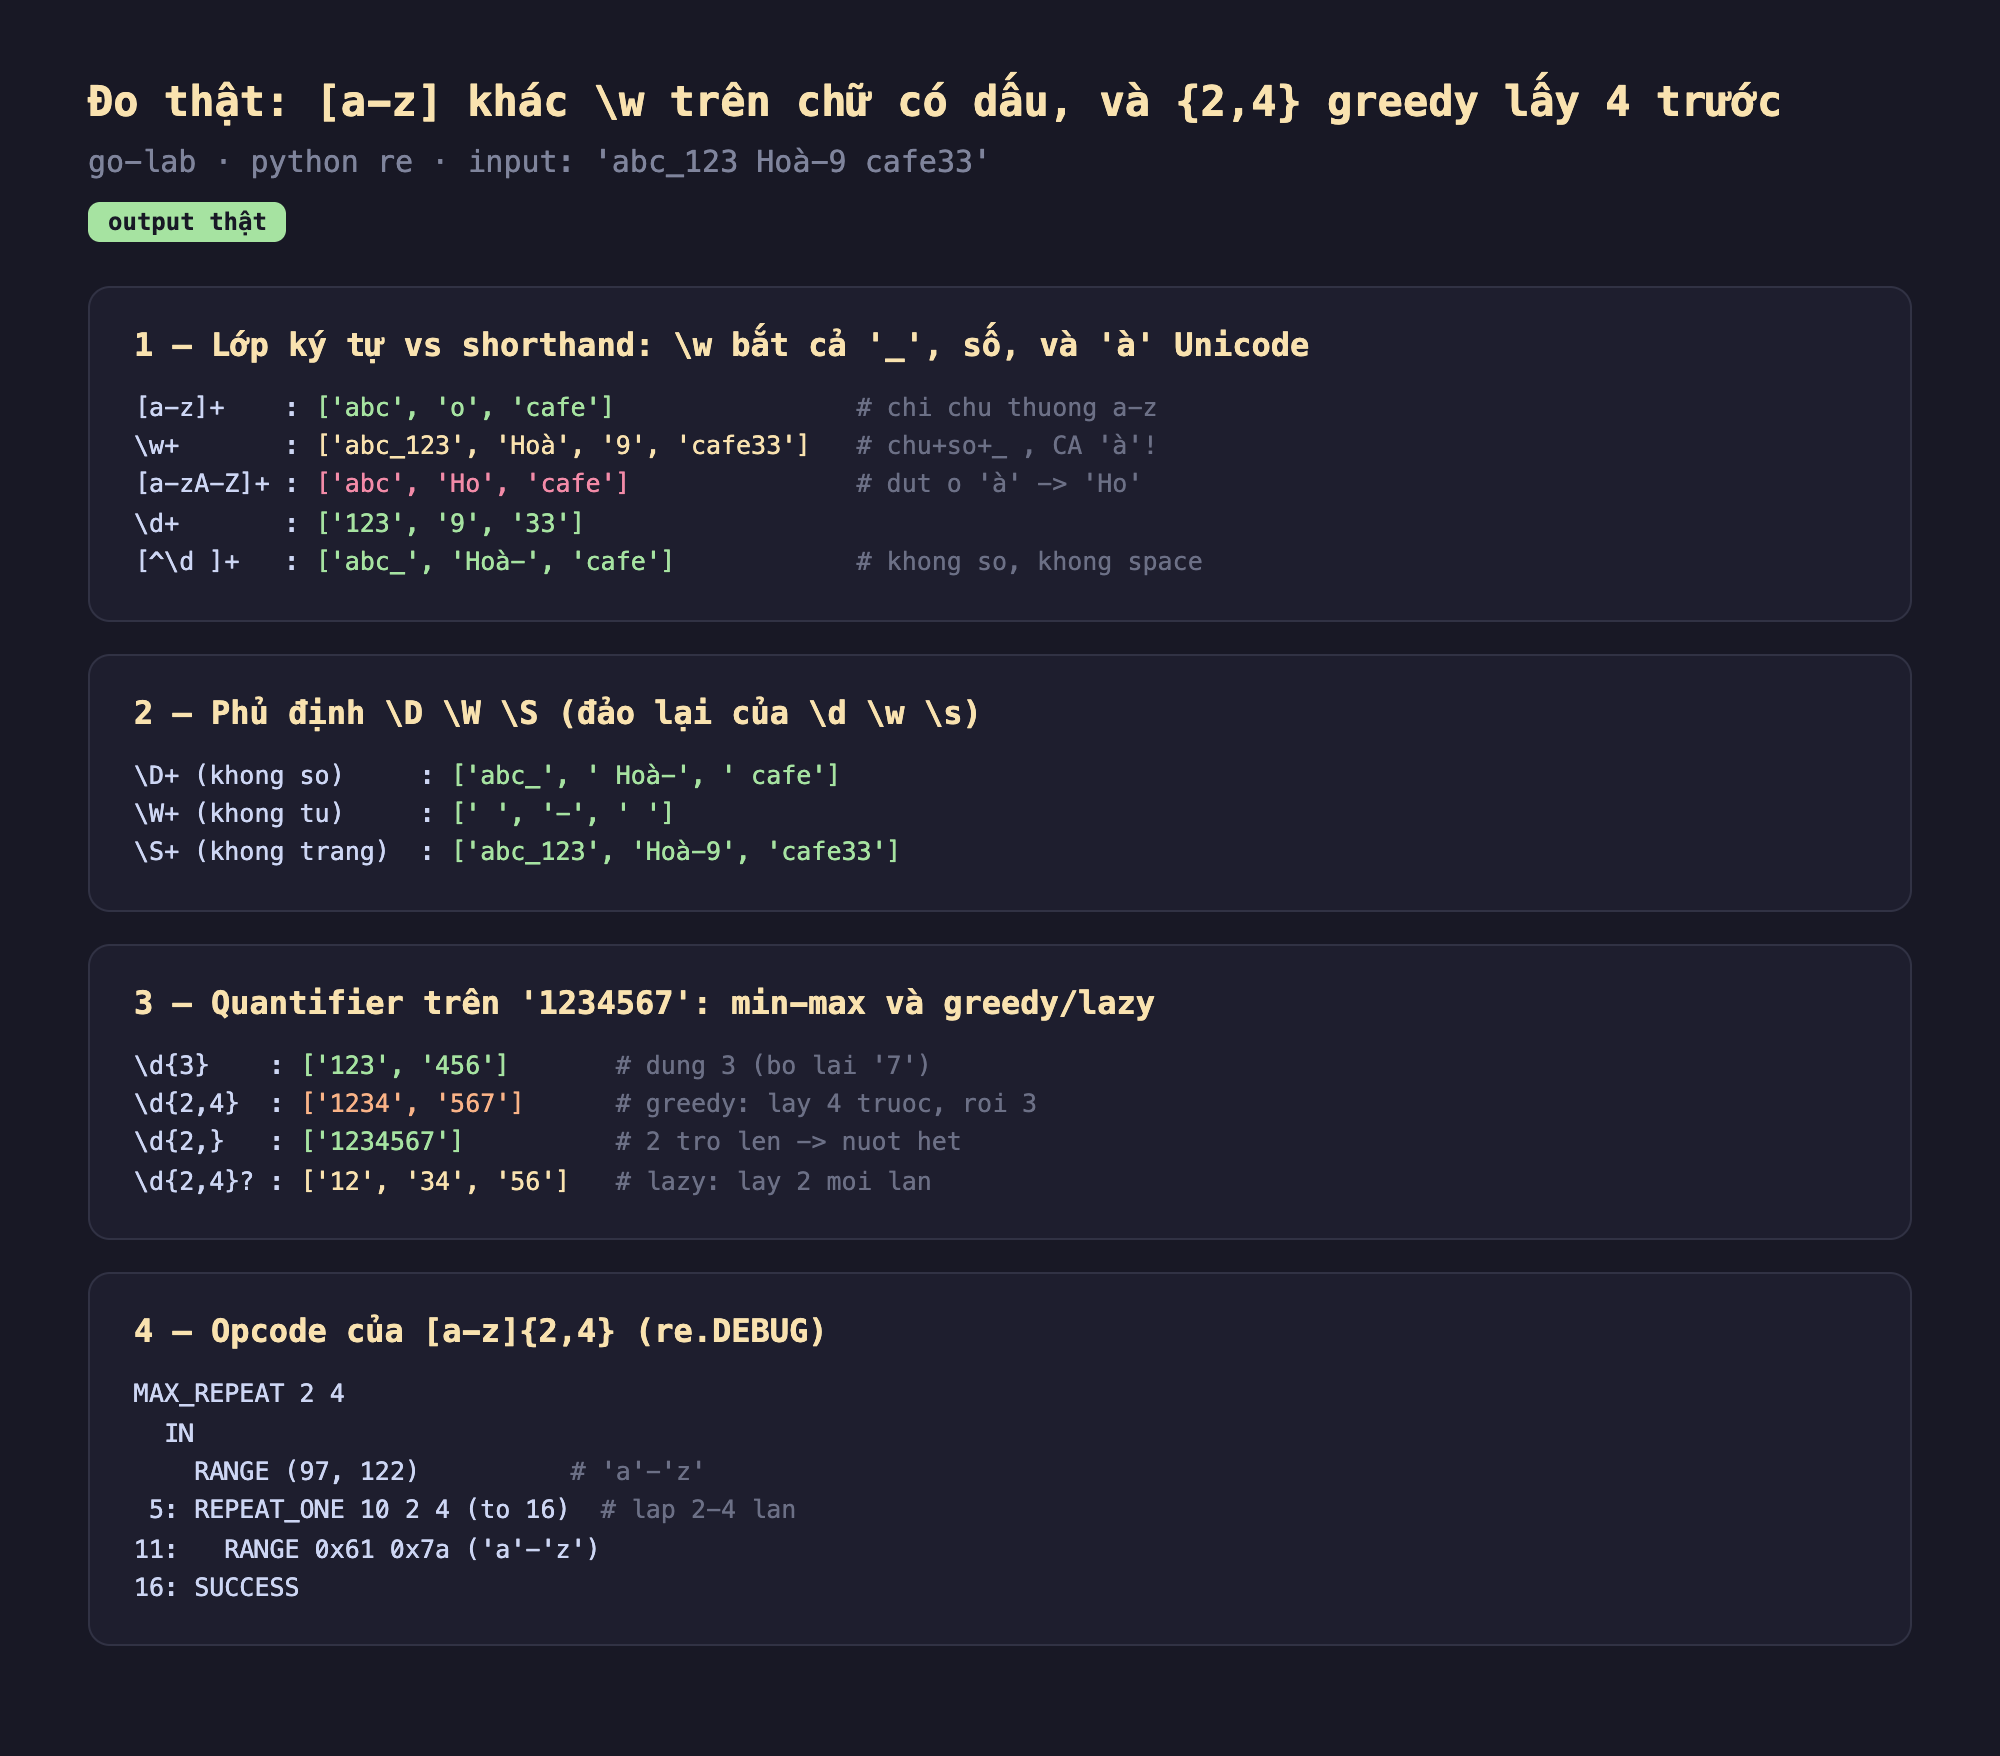
Hình 2: Chạy thật — [a-z]+ cho ['abc','o','cafe'] nhưng \w+ cho ['abc_123','Hoà','9','cafe33'] (bắt cả à), còn [a-zA-Z]+ đứt ở à thành 'Ho'; quantifier trên 1234567: \d{3}→['123','456'], \d{2,4}→['1234','567'] (greedy lấy 4), \d{2,}→['1234567'], \d{2,4}?→['12','34','56'] (lazy).
\wKHÁC[a-zA-Z]— cái bẫy Unicode: đây là điểm quan trọng nhất. TrênHoà,\w+khớp cả cụmHoàvì trong Python 3,\wmặc định hiểu Unicode và coiàlà ký tự-từ. Nhưng[a-zA-Z]+chỉ liệt kê ASCII, nên nó đứt ởà, cho ra'Ho'. Nếu bạn viết[a-zA-Z]+để "lấy một từ" trên dữ liệu tiếng Việt, bạn sẽ cắt cụt mọi từ có dấu mà không có lỗi nào báo.\wcũng bắt_và chữ số, nênabc_123là một match với\w+nhưng[a-z]+chỉ lấyabc.- Phủ định là đảo hoàn toàn:
\D+(không phải số) cho['abc_', ' Hoà-', ' cafe']— mọi đoạn không có chữ số.\W+(không phải ký tự-từ) chỉ lấy khoảng trắng và-.\S+(không phải khoảng trắng) chia chuỗi theo space thành ba "token". {m,n}là greedy,{m,n}?là lazy: trên1234567,\d{3}lấy đúng ba số mỗi lần (123,456, bỏ lại7vì không đủ ba).\d{2,4}(greedy) ưu tiên nhiều nhất: lấy1234(4 số) rồi567(3 số còn lại).\d{2,}lấy hai trở lên nên nuốt cả1234567. Còn\d{2,4}?(lazy, thêm?) ưu tiên ít nhất: lấy đúng 2 mỗi lần →12,34,56. Đây chính là greedy/lazy của phần 2, áp lên quantifier có cận.- Opcode xác nhận cơ chế:
re.DEBUGcủa[a-z]{2,4}sinhMAX_REPEAT 2 4bọc quanhIN / RANGE (97,122)— nghĩa là "lặp 2 tới 4 lần một ký tự trong dảia-z". Cỗ máy trạng thái ở phần 1 hiện ra đúng như mô tả.
Đánh đổi cần cân nhắc
Trong lớp ký tự, hầu hết metachar mất nghĩa đặc biệt — nhưng không phải tất cả. Bên trong [...], dấu . chỉ là dấu chấm, * chỉ là sao — không cần escape. Nhưng bốn ký tự vẫn đặc biệt: ] (đóng lớp), \ (escape), ^ (phủ định nếu ở đầu), và - (dải nếu ở giữa). Muốn khớp dấu - theo nghĩa đen, đặt nó ở đầu/cuối lớp ([-a-z]) hoặc escape. Nhầm chỗ này tạo ra dải ngoài ý muốn, ví dụ [a-z-0-9] không như bạn nghĩ.
\d cũng có thể là Unicode — không chỉ [0-9]. Giống \w, \d trong Python 3 mặc định khớp cả chữ số của các hệ chữ khác (chữ số Ả Rập-Ấn, Devanagari...), không chỉ 0-9 ASCII. Nếu bạn chỉ muốn 0-9, hãy viết [0-9] tường minh, hoặc bật cờ re.ASCII. Với dữ liệu quốc tế, "\d là số" là một giả định nguy hiểm — điều ta sẽ đào kỹ ở phần 9.
{m,n} với n lớn có thể mở rộng thành máy trạng thái khổng lồ. Một số engine "unroll" (trải phẳng) a{1,1000} thành cả nghìn trạng thái, tốn bộ nhớ biên dịch và có thể góp phần vào backtracking tệ. RE2 giới hạn kích thước mẫu để chặn điều này; engine backtracking thì không. Khi cần lặp số lượng lớn, cân nhắc +/* (nếu không cần cận chính xác) thay vì {0,10000}.
Ba ý mang về
\wkhông phải[a-zA-Z]— bẫy Unicode: đo thật trênHoà,\w+khớp cảà(được cảHoà) còn[a-zA-Z]+đứt thành'Ho'; dùng[a-zA-Z]cho dữ liệu tiếng Việt sẽ cắt cụt từ có dấu mà không báo lỗi.- Quantifier
{m,n}là greedy, thêm?thành lazy: đo thật trên1234567,\d{2,4}lấy['1234','567'](ưu tiên 4),\d{2,4}?lấy['12','34','56'](ưu tiên 2);\d{3}lấy đúng 3,\d{2,}nuốt hết. - Lớp và quantifier biên dịch thẳng thành opcode:
re.DEBUGcho[a-z]{2,4}sinhMAX_REPEAT 2 4+IN RANGE (97,122); nhớ trong[...]chỉ] \ ^ -còn đặc biệt, và\d/\wmặc định Unicode (dùng[0-9]/re.ASCIInếu chỉ muốn ASCII).
Nguồn
- Python docs — re (character classes,
{m,n},re.ASCII): https://docs.python.org/3/library/re.html - Go docs — regexp/syntax (character classes): https://pkg.go.dev/regexp/syntax
- Unicode — UTS #18 Unicode Regular Expressions: https://unicode.org/reports/tr18/
Phần sau ta chạm tới thứ khiến regex "không còn regular" theo nghĩa lý thuyết: backreference \1 — vì sao khả năng "khớp lại đúng cái đã khớp" buộc engine phải backtracking và không thể dùng DFA tuyến tính.
