Đây là lỗi regex kinh điển mà gần như ai cũng dính một lần: bạn viết <.*> để "lấy một thẻ HTML", chạy thử, và nó nuốt trọn cả dòng từ thẻ đầu tới thẻ cuối. Thêm đúng một dấu ? thành <.*?> là mọi thứ đúng lại. Cặp tham lam (greedy) và lười (lazy) này gây bối rối vì trông gần giống nhau nhưng hành xử ngược nhau — và khác biệt không chỉ ở kết quả mà cả ở hiệu năng. Bài này (phần 2 loạt Regex) đo thật để thấy cả hai mặt. Nhớ lại phần 1: regex là máy trạng thái duyệt input; greedy/lazy chính là chiến lược cỗ máy đó dùng khi gặp một quantifier như * hay +.
Hai chiến lược ngược nhau
Khi engine gặp .* (hay .+, {m,n}...), nó phải quyết định: khớp bao nhiêu ký tự? Có hai chính sách:
- Greedy (tham lam) —
.*,.+,{m,n}: nuốt càng nhiều càng tốt ngay từ đầu, rồi nhả dần (backtrack) nếu phần còn lại của mẫu không khớp được. - Lazy (lười) —
.*?,.+?,{m,n}?(thêm?): nuốt càng ít càng tốt, rồi ăn thêm từng ký tự chỉ khi phần còn lại chưa khớp.
Chúng khớp cùng một loại ký tự, chỉ khác lượng mỗi lần thử. Và vì regex duyệt tìm match trái-nhất, chính sách này quyết định match kết thúc ở đâu.
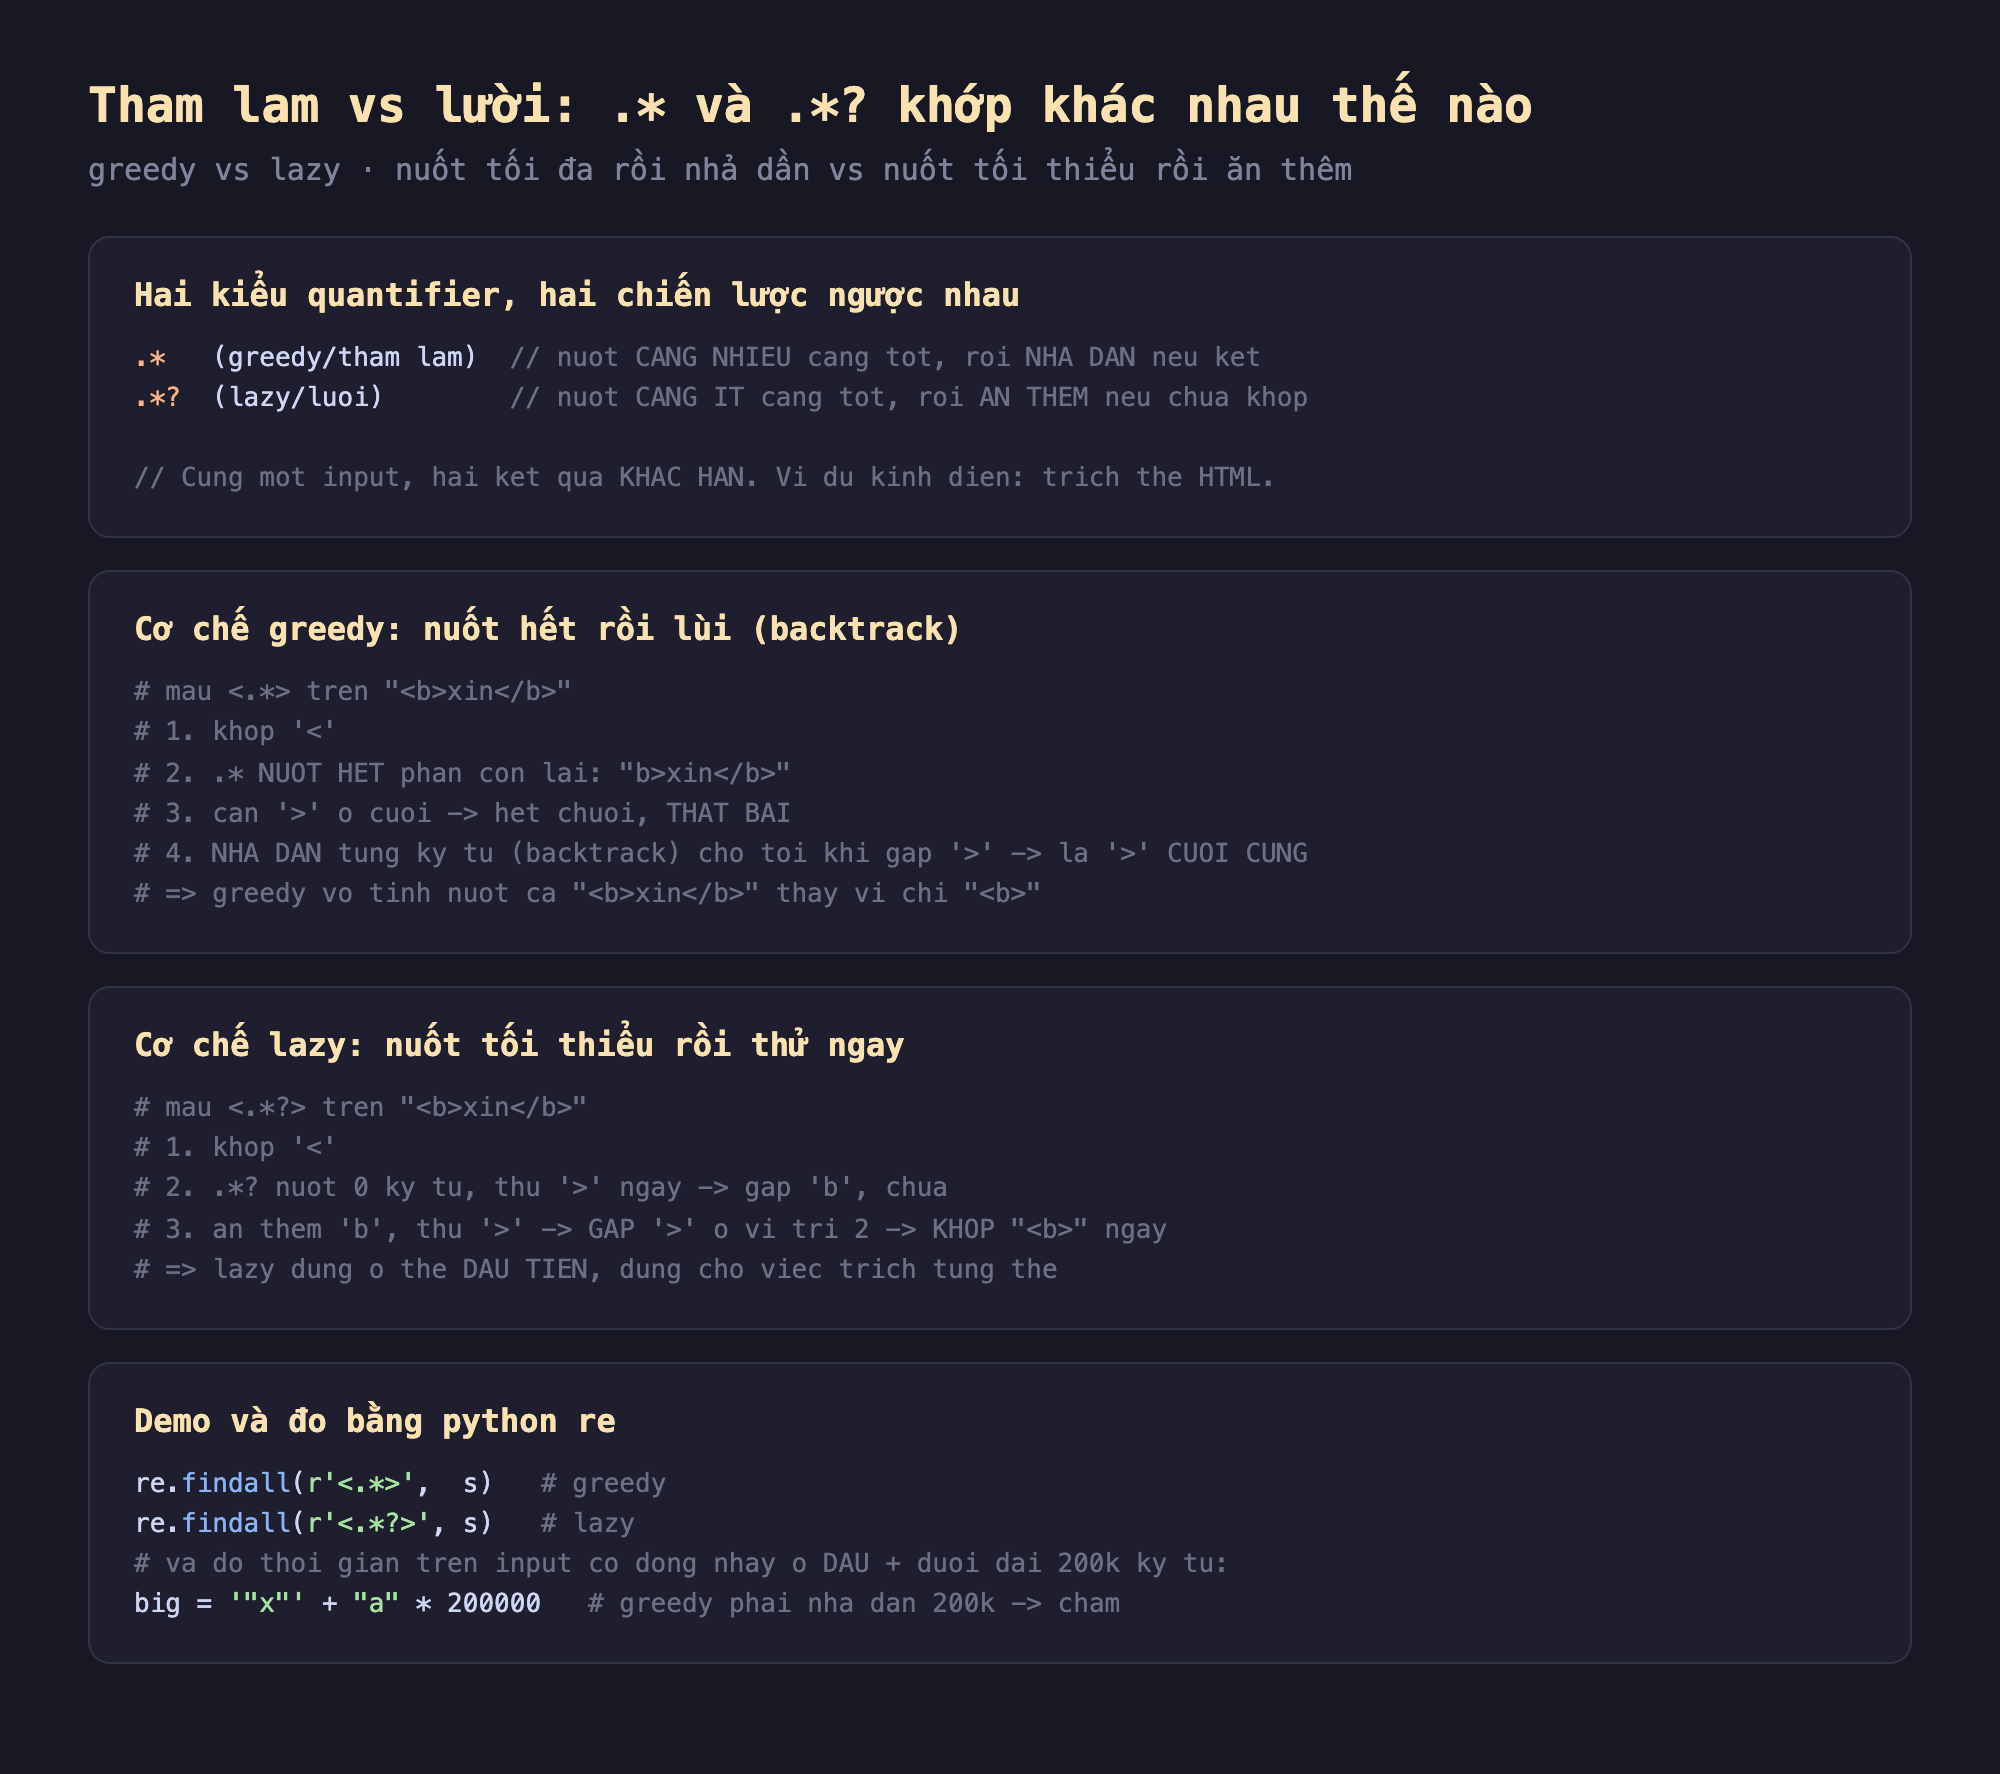
Hình 1: Greedy (.*) nuốt tối đa rồi nhả dần (backtrack) nếu kẹt; lazy (.*?) nuốt tối thiểu rồi ăn thêm — trên <b>xin</b>, greedy vô tình nuốt cả thẻ tới > cuối cùng, còn lazy dừng ngay ở thẻ đầu tiên <b>.
Đo thật: cùng input, kết quả và tốc độ khác hẳn
Mình dùng python re chạy cùng mẫu ở hai biến thể trên cùng input:
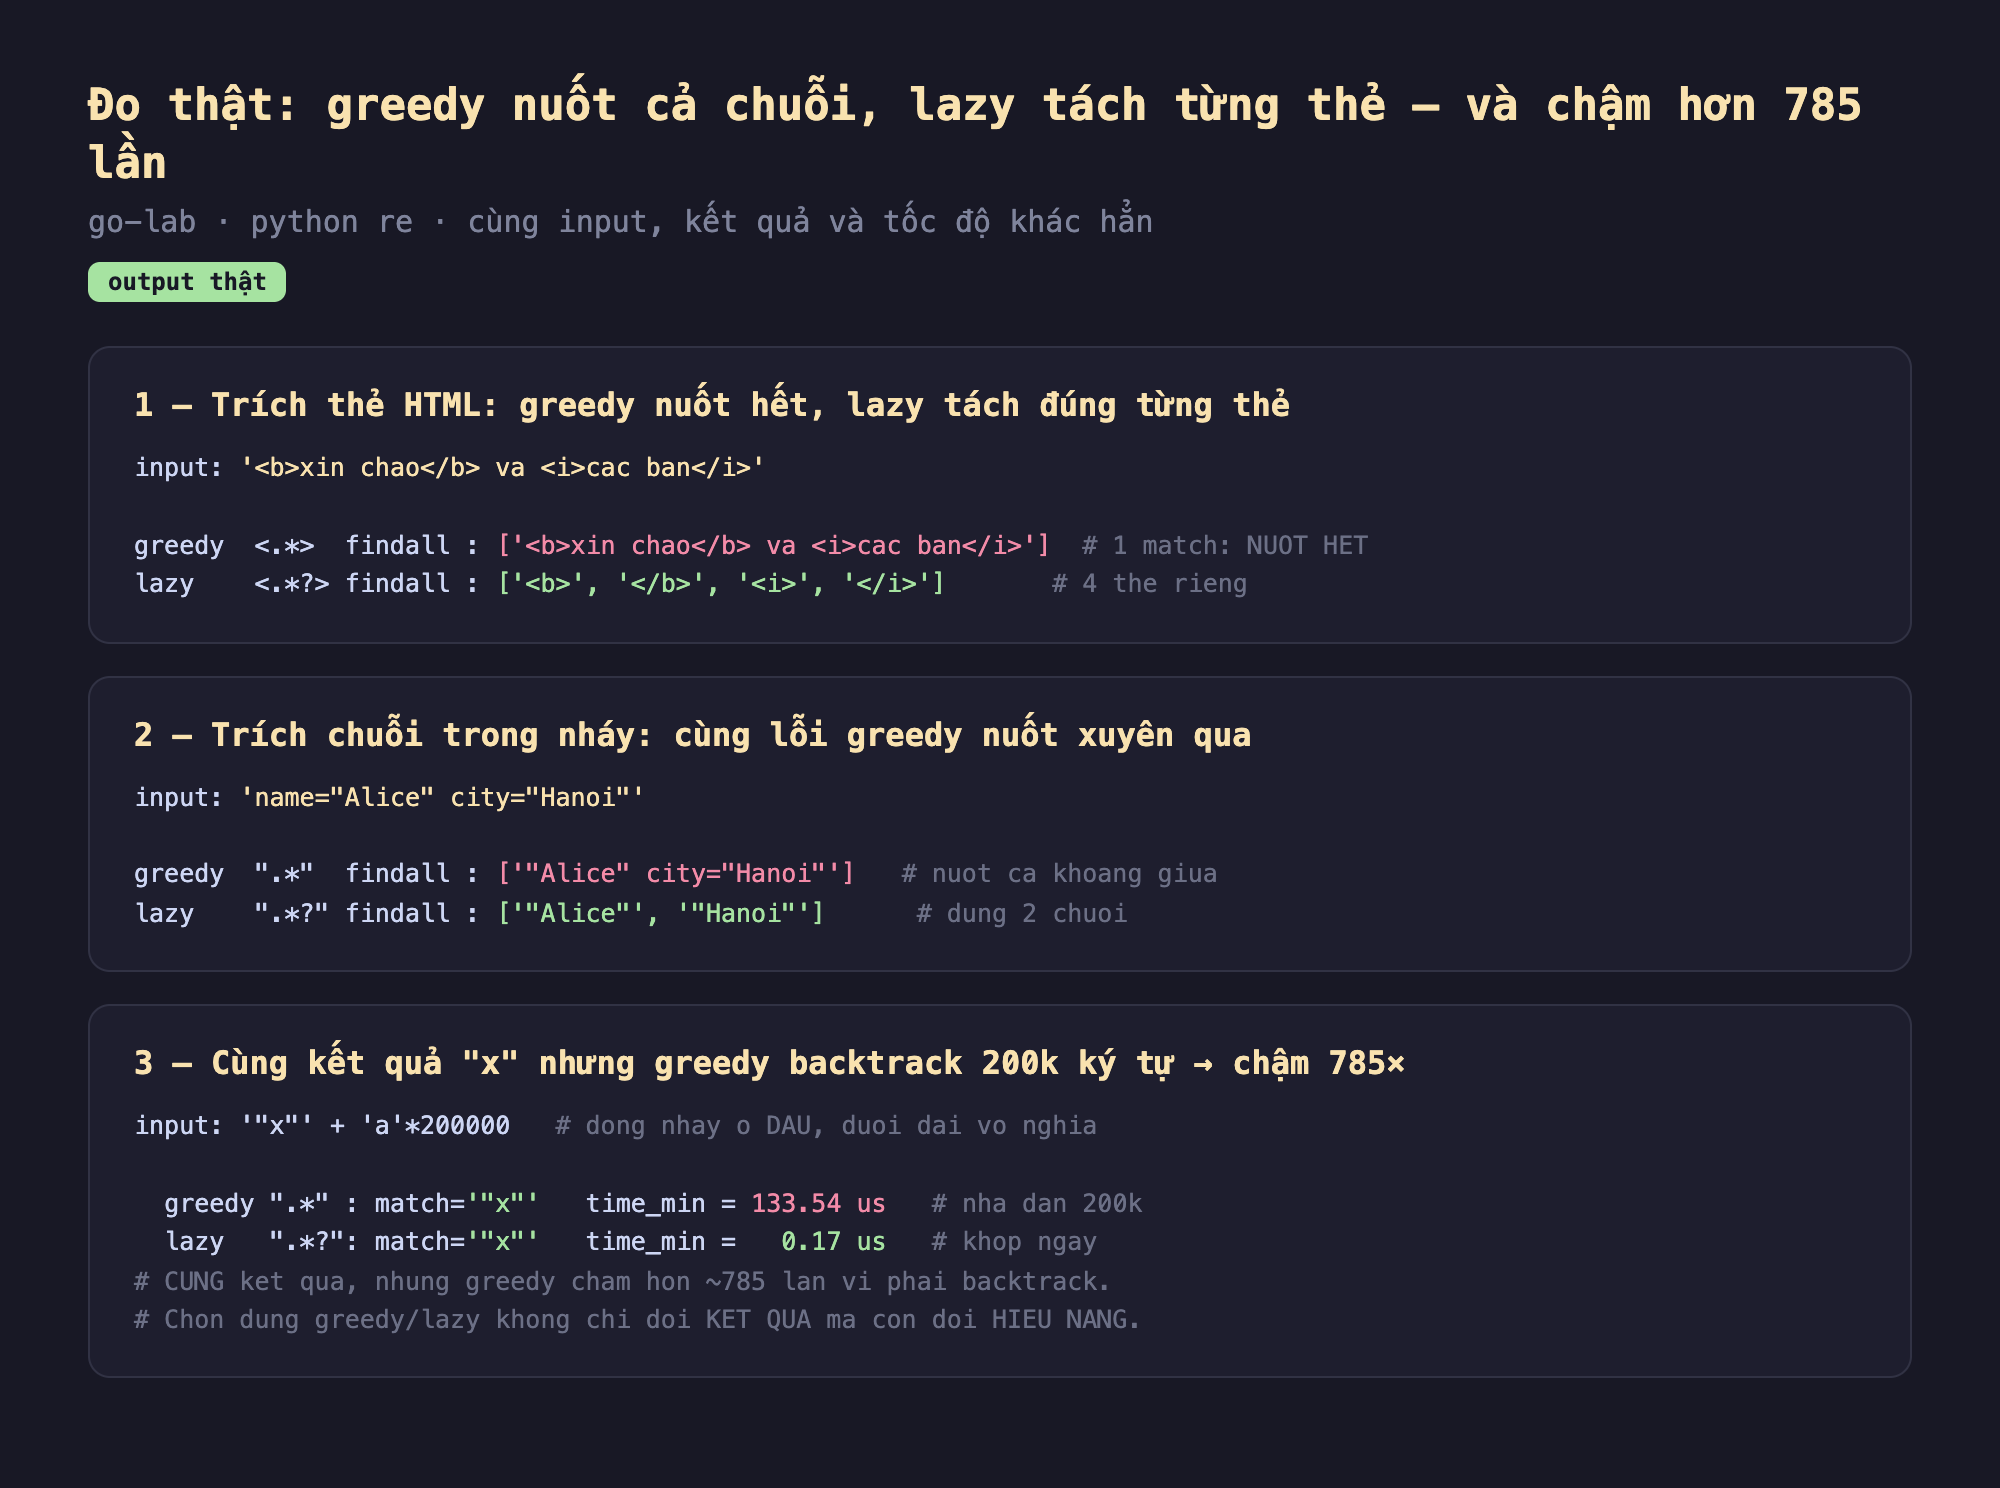
Hình 2: Chạy thật — trích thẻ HTML: greedy <.*> cho 1 match nuốt cả chuỗi, lazy <.*?> cho 4 thẻ riêng; trích chuỗi nháy: greedy ".*" nuốt xuyên qua, lazy ".*?" tách đúng 2 chuỗi; và trên input 200k ký tự, greedy 133.54µs vs lazy 0.17µs (cùng ra "x").
- Greedy nuốt xuyên qua ranh giới bạn muốn: với
<.*>trên<b>xin chao</b> va <i>cac ban</i>, kết quả là một match ôm trọn cả chuỗi — vì greedy nuốt tối đa rồi chỉ lùi tới>cuối cùng. Còn<.*?>cho đúng bốn thẻ<b>,</b>,<i>,</i>vì lazy dừng ở>đầu tiên mỗi lần. Ví dụ chuỗi trong nháy".*"vs".*?"cho đúng cùng bài học: greedy dính"Alice" city="Hanoi", lazy tách"Alice"và"Hanoi". - Khác biệt hiệu năng là thật và lớn: mình tạo input
"x"+ 200.000 ký tựa(dấu nháy đóng nằm ngay đầu, phần đuôi dài vô nghĩa). Cả hai cùng khớp ra"x", nhưng greedy".*"mất 133.54µs còn lazy".*?"chỉ 0.17µs — chậm hơn ~785 lần. Lý do: greedy nuốt hết 200k ký tự tới cuối, thấy không có"để đóng, rồi nhả dần từng ký tự (backtrack) suốt 200k bước cho tới khi tìm lại dấu". Lazy thì thử"ngay sauxvà khớp tức thì.
Đánh đổi cần cân nhắc
Lazy không phải "luôn nhanh hơn" — tùy input. Ở ví dụ trên lazy thắng vì thứ cần tìm ở gần đầu. Nếu ngược lại (thứ cần khớp ở cuối một đoạn dài), lazy sẽ phải ăn thêm từng ký tự suốt quãng đường và chậm hơn greedy. Quy tắc thực dụng: chọn chính sách khớp đúng ý trước (kết quả đúng quan trọng hơn), rồi mới cân hiệu năng theo vị trí dữ liệu thường gặp.
Cách tốt nhất thường là không dùng . — dùng lớp phủ định. Thay vì <.*?>, viết <[^>]*> (khớp mọi ký tự trừ >). Nó diễn đạt ý "tới > thì dừng" một cách tường minh, thường nhanh hơn cả lazy (không cần cơ chế ăn-thêm-rồi-thử), và tránh nhiều cạm bẫy backtracking. Với dữ liệu có cấu trúc, [^delimiter]* gần như luôn tốt hơn .*?.
Đừng dùng regex để phân tích HTML/JSON lồng nhau. Cả greedy lẫn lazy đều không xử lý đúng cấu trúc lồng (thẻ trong thẻ, ngoặc trong ngoặc) vì regex (thuần) không đếm được độ sâu — đó là giới hạn lý thuyết, không phải chuyện chọn quantifier. Trích một thẻ phẳng thì regex ổn; phân tích cả cây DOM thì dùng parser thật. Nhầm chỗ này là nguồn bug bất tận.
Ba ý mang về
- Greedy nuốt tối đa rồi nhả dần, lazy nuốt tối thiểu rồi ăn thêm: đo thật
<.*>cho 1 match nuốt cả chuỗi,<.*?>tách đúng 4 thẻ — thêm một dấu?đổi hẳn kết quả trích. - Khác biệt cả ở hiệu năng: đo thật trên input 200k ký tự, greedy
133.54µsvs lazy0.17µs(~785 lần) dù cùng ra"x"— vì greedy phải backtrack nhả dần 200k ký tự. - Thường nên dùng lớp phủ định thay vì lazy:
<[^>]*>diễn đạt "tới>thì dừng" tường minh, tránh backtracking; và đừng dùng regex cho cấu trúc lồng nhau — đó là giới hạn lý thuyết, không phải chuyện quantifier.
Nguồn
- Python docs — Regular Expression HOWTO (greedy vs non-greedy): https://docs.python.org/3/howto/regex.html
- Jeffrey Friedl — Mastering Regular Expressions (greediness): https://www.oreilly.com/library/view/mastering-regular-expressions/0596528124/
- Go docs — regexp/syntax: https://pkg.go.dev/regexp/syntax
Phần sau ta xét những thứ không khớp ký tự nào nhưng đổi hẳn kết quả: neo ^ $ và ranh giới \b — vì sao chúng vừa tăng tốc vừa quyết định mẫu của bạn có khớp đúng chỗ hay không.
