grep là công cụ đầu tiên mọi lập trình viên chạm tới khi cần tìm gì đó trong file hay log. Nhưng có một sự thật khiến nhiều người vấp: grep không có một loại regex, mà tới ba phương ngữ khác nhau — và dùng nhầm chính là nguyên nhân của cái bẫy quen thuộc "grep "ERROR|WARN" sao không ra gì?". Bài này (phần 2 loạt Unix) chạy grep thật trên một file log mẫu để làm rõ ba phương ngữ đó, cùng những cờ biến grep từ "bộ lọc dòng" thành "bộ trích dữ liệu".
Ba phương ngữ regex của grep
Đây là điều gây bối rối nhất. Cùng một mẫu regex cho kết quả khác nhau tuỳ cách gọi grep:
grep(BRE — Basic Regular Expression): mặc định. Các ký tự| ? + ( ) { }là ký tự thường, muốn dùng làm toán tử phải thoát:\|,\+,\(.grep -E(ERE — Extended):| ? + ( )là toán tử regex ngay, không cần thoát. Đây là chế độ hầu hết người dùng tưởng mình đang chạy.grep -P(PCRE — Perl Compatible): mạnh nhất, thêm\d,\w,\K, lookbehind/lookahead...
grep      "a|b"   # BRE: tìm chuỗi "a|b" nguyên văn (| là ký tự thường!)
grep -E   "a|b"   # ERE: tìm "a" HOẶC "b"
grep -P   "\d+"   # PCRE: tìm chuỗi chữ số
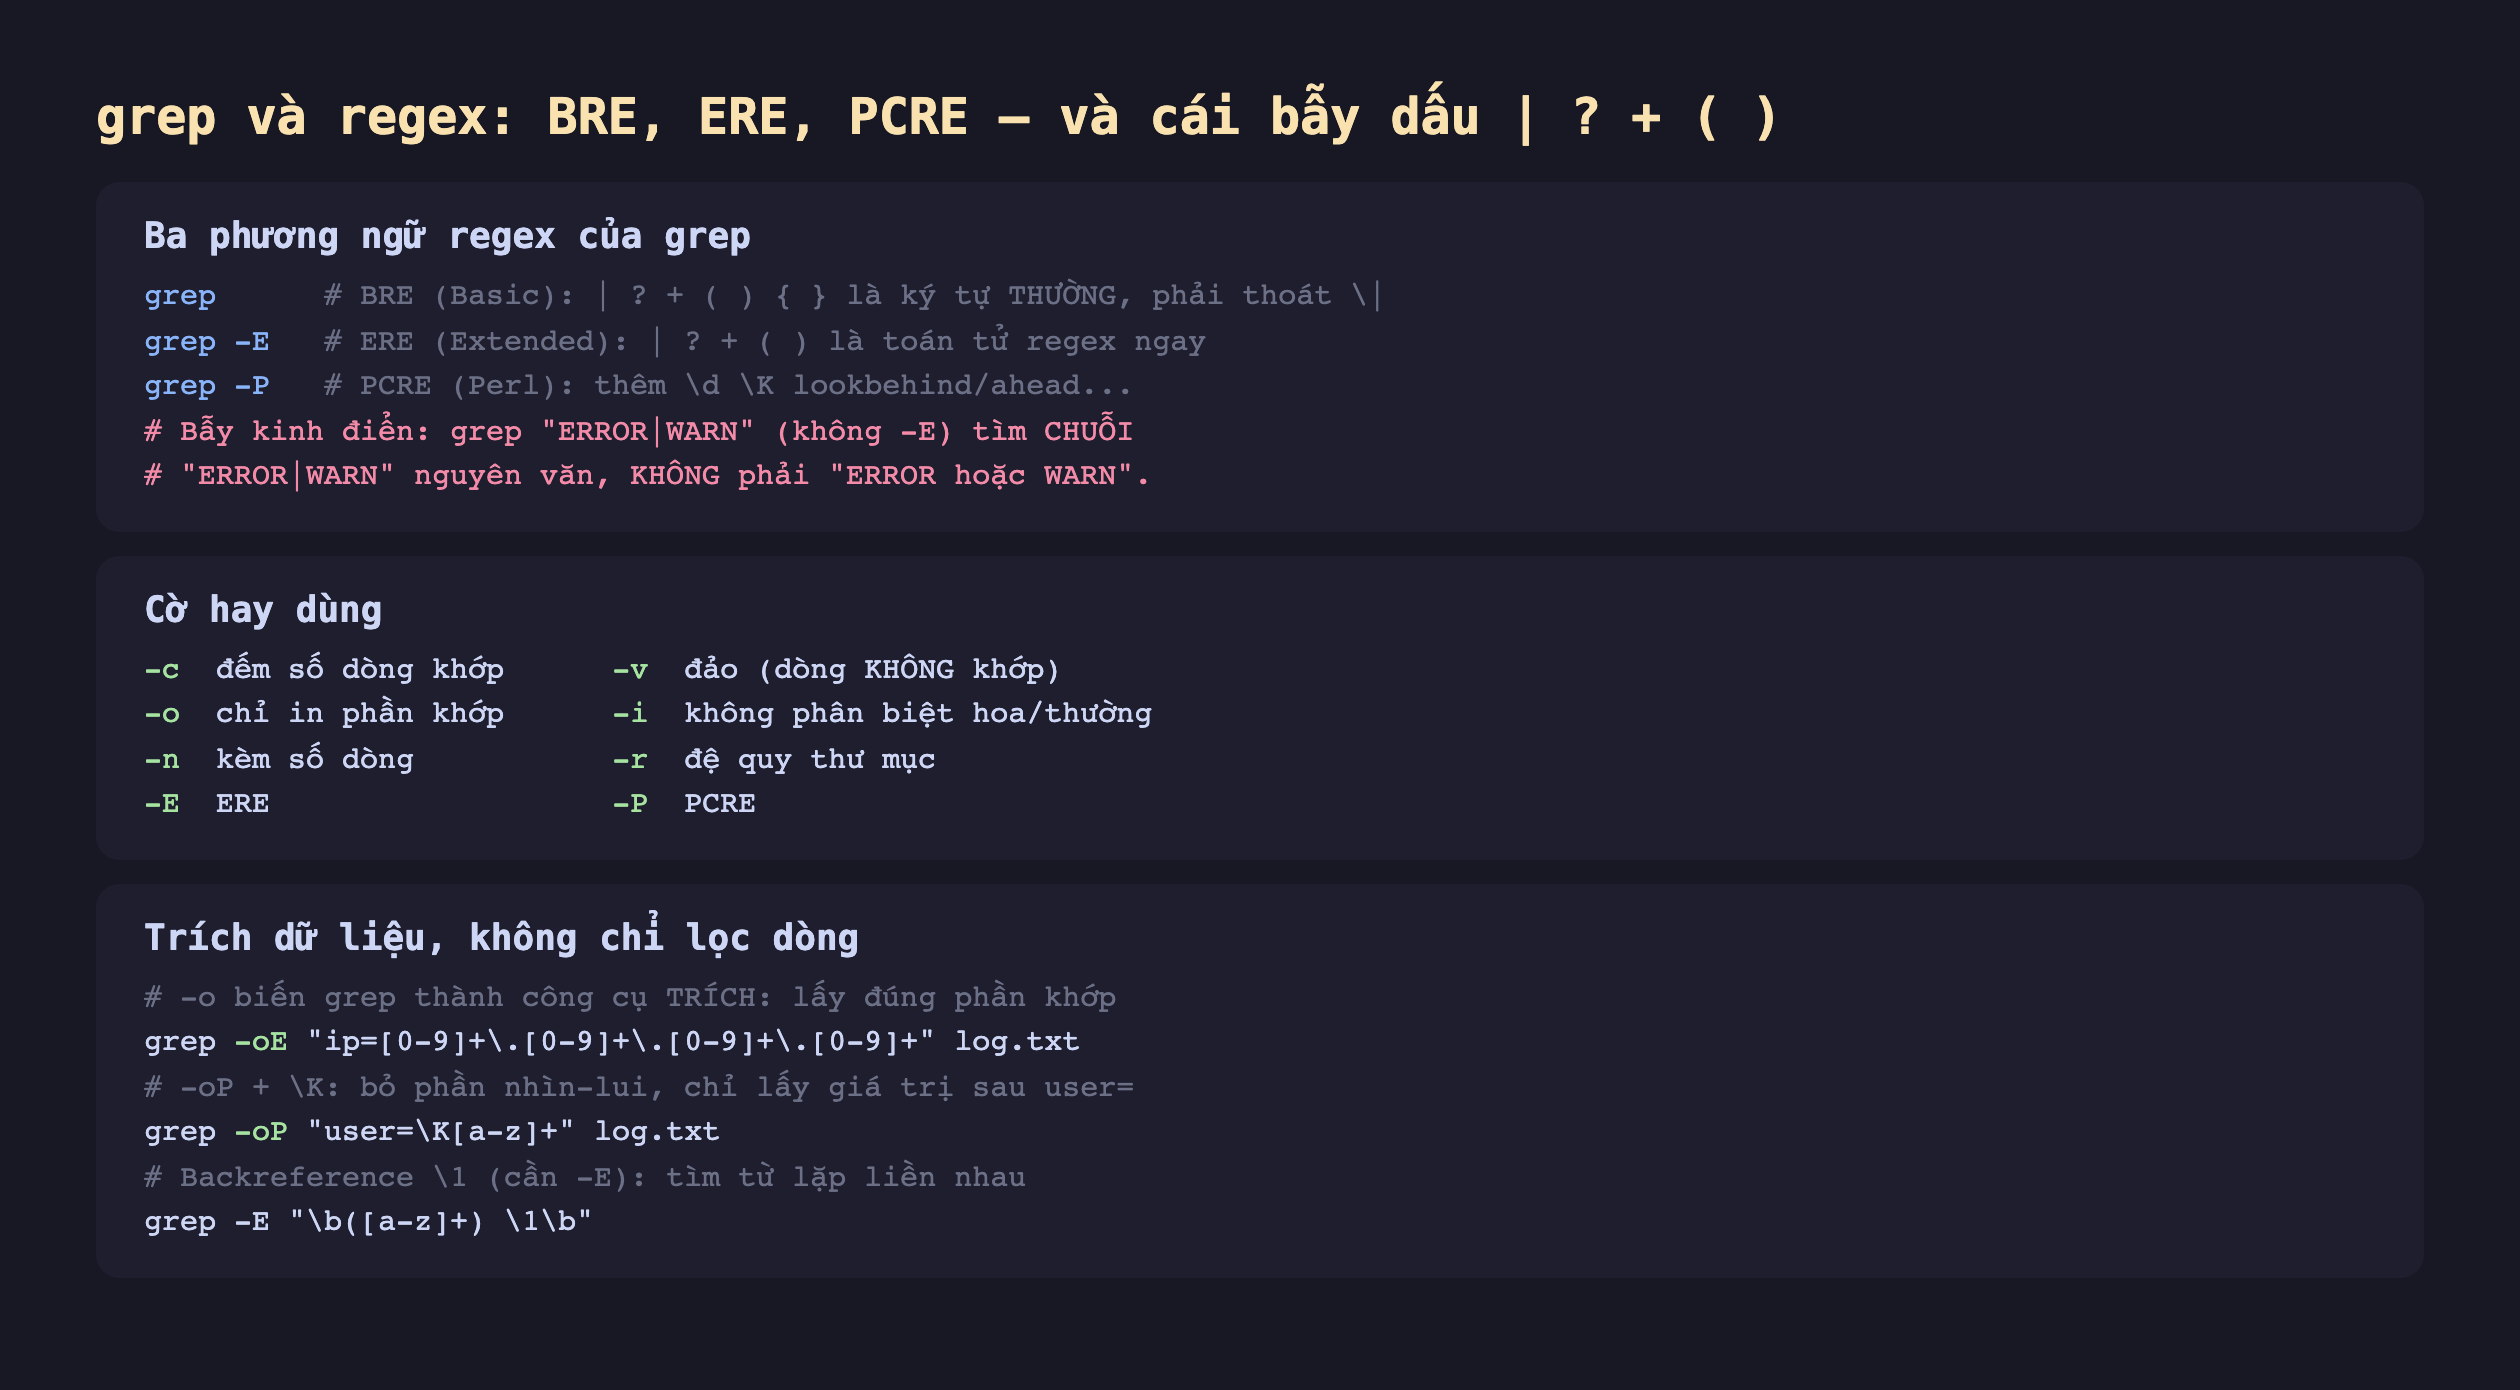
Hình 1: grep có ba phương ngữ regex (BRE/ERE/PCRE); bẫy kinh điển là | trong BRE là ký tự thường. Các cờ -c -v -o -i -n -r và khả năng trích dữ liệu bằng -o.
Đo thật: bẫy dấu | và các cờ cốt lõi
Mình chạy trên một file log mẫu 6 dòng (INFO/ERROR/WARN). Kết quả thật:
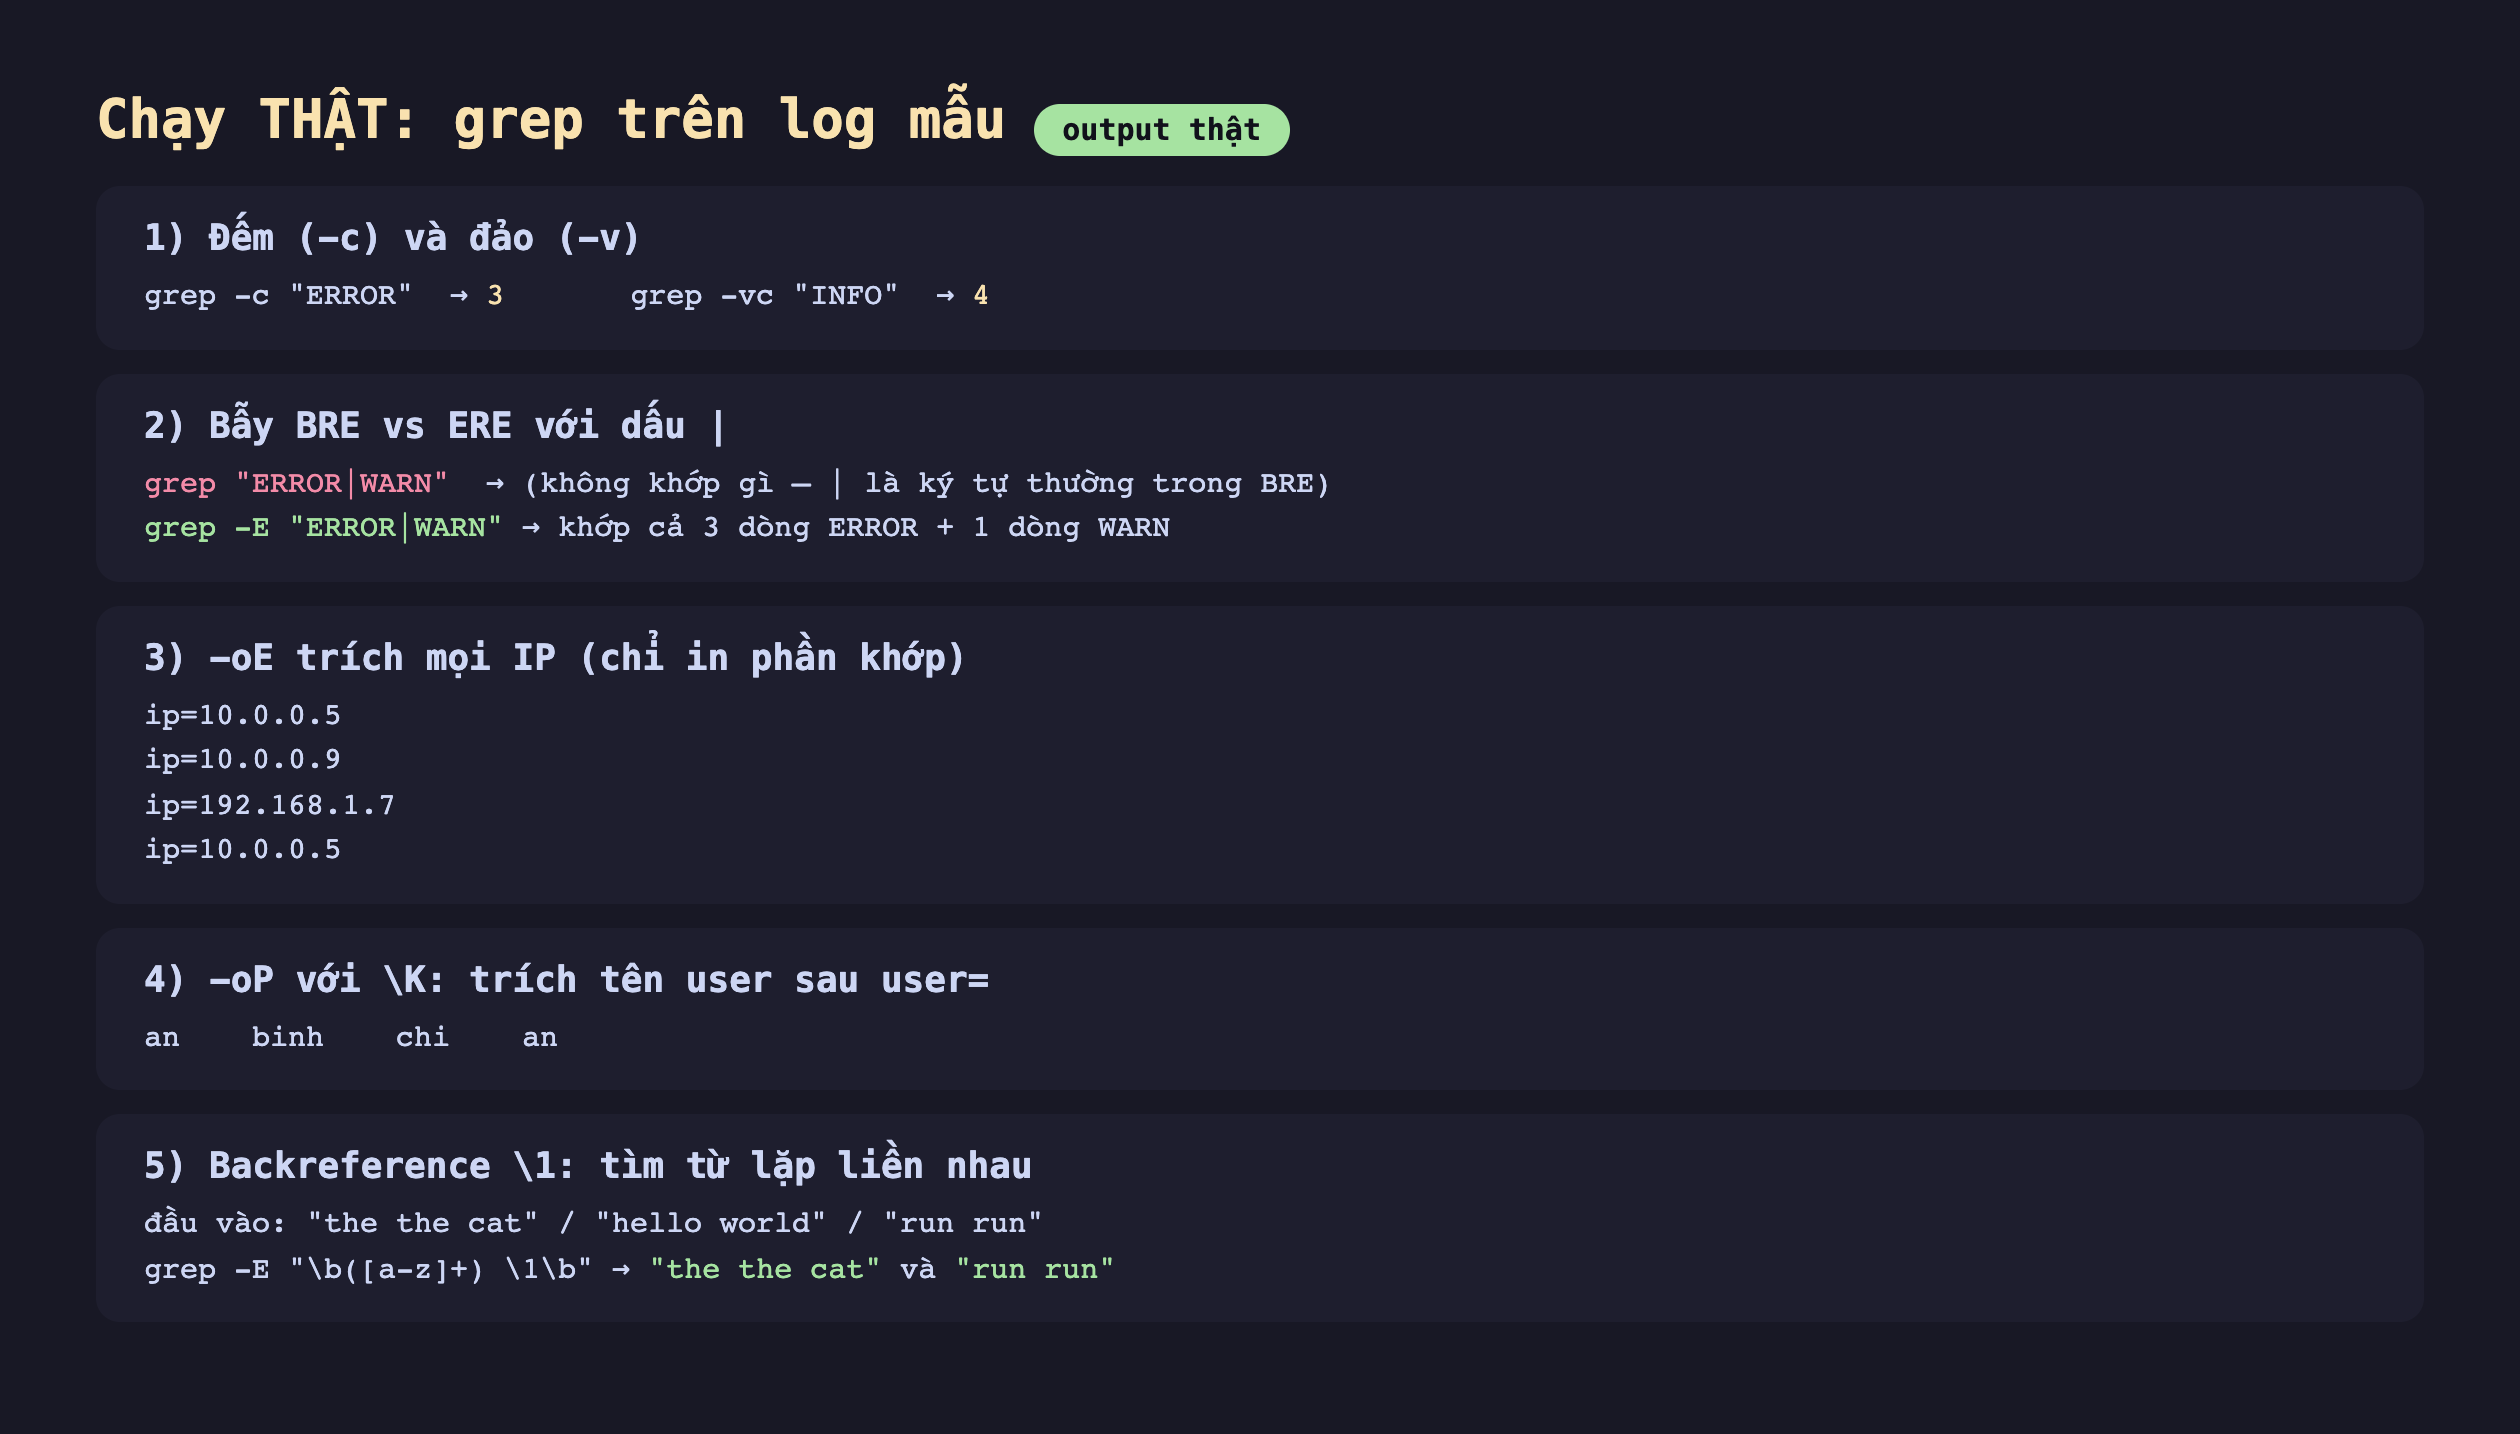
Hình 2: Chạy thật — grep -c "ERROR" = 3, grep -vc "INFO" = 4; grep "ERROR|WARN" không khớp gì (BRE), grep -E "ERROR|WARN" khớp đúng; -oE trích mọi IP; -oP với \K lấy tên user; backreference \1 tìm từ lặp.
-cđếm,-vđảo:grep -c "ERROR"trả3(số dòng khớp, không phải số lần khớp);grep -vc "INFO"trả4(đếm các dòng không chứa INFO). Ghép-vvới-crất hay dùng để đếm phần còn lại.- Bẫy dấu
|:grep "ERROR|WARN"(không-E) không khớp gì — vì trong BRE,|chỉ là ký tự văn bản thường, nó đi tìm chuỗiERROR|WARNnguyên văn (mà file không có). Thêm-Emới cho|nghĩa "hoặc", và khớp đúng cả 3 dòng ERROR lẫn 1 dòng WARN. Đây là lỗi phổ biến nhất khi dùng grep.
Trích dữ liệu với -o, không chỉ lọc dòng
Mặc định grep in cả dòng chứa mẫu. Cờ -o đổi hành vi: chỉ in phần khớp, biến grep thành công cụ trích:
grep -oE "ip=[0-9]+\.[0-9]+\.[0-9]+\.[0-9]+" log.txt # lấy mọi IP
Đo thật cho ra danh sách IP gọn (ip=10.0.0.5, ip=10.0.0.9, ...). Muốn lấy chỉ giá trị mà bỏ phần tiền tố, dùng PCRE với \K (bỏ mọi thứ đã khớp phía trước điểm \K):
grep -oP "user=\K[a-z]+" log.txt # -> an, binh, chi, an
\K "quên" phần user= đã khớp, chỉ giữ tên. Đây là cách trích trường cực gọn mà không cần sed/awk.
Backreference: tìm mẫu tự tham chiếu
Một khả năng ít người dùng: backreference \1 tham chiếu lại nhóm đã bắt. Ví dụ tìm từ lặp liền nhau (lỗi gõ kinh điển "the the"):
grep -E "\b([a-z]+) \1\b"
Đo thật: với đầu vào "the the cat", "hello world", "run run", grep khớp đúng hai dòng có từ lặp và bỏ qua dòng giữa. ([a-z]+) bắt một từ, \1 đòi từ đó lặp lại ngay sau.
Đánh đổi cần cân nhắc
Dùng -F (fixed string) khi tìm chuỗi thường, đừng để regex hiểu nhầm. Nếu bạn tìm một chuỗi có ký tự đặc biệt (như 192.168.1.7 — dấu . trong regex khớp mọi ký tự), grep -F "192.168.1.7" tìm đúng chuỗi văn bản, nhanh hơn và không bị . hiểu nhầm. Chỉ bật regex khi thực sự cần mẫu.
-P (PCRE) mạnh nhưng không phải bản grep nào cũng có. PCRE cần grep biên dịch kèm thư viện PCRE (GNU grep thường có; grep trên macOS/BSD không). Nếu script cần chạy nhiều nơi, hạn chế -P hoặc dùng ripgrep/perl cho phần phức tạp. Kiểm bằng grep -P "x" </dev/null xem có báo lỗi không.
Regex tham lam (greedy) và hiệu năng. Mẫu như .* khớp tham lam (dài nhất có thể), dễ cho kết quả ngoài ý muốn khi có nhiều phần trên một dòng. Với file cực lớn, mẫu phức tạp (nhất là PCRE có backtracking) có thể chậm; cân nhắc ripgrep (rg) — nhanh hơn nhiều nhờ engine không-backtracking cho phần lớn mẫu.
Ba ý mang về
- grep có ba phương ngữ regex: BRE (mặc định,
| ? + ( )là ký tự thường), ERE (-E, chúng là toán tử), PCRE (-P, thêm\d \Klookaround). Đo thật:grep "ERROR|WARN"không khớp gì, phảigrep -E— đây là bẫy phổ biến nhất. -obiến grep thành công cụ trích dữ liệu: đo thật-oElấy mọi IP,-oPvới\Klấy giá trị sauuser=(an, binh, chi, an) — không cần sed/awk cho việc đơn giản.- Cờ và tính năng nâng cao:
-cđếm dòng,-vđảo (đo thật 3 và 4), backreference\1tìm từ lặp; và nhớ dùng-Fcho chuỗi thường, cân nhắcripgrepkhi cần tốc độ.
Nguồn
- GNU grep manual — Regular Expressions: https://www.gnu.org/software/grep/manual/grep.html#Regular-Expressions
- POSIX — Regular Expressions (BRE/ERE): https://pubs.opengroup.org/onlinepubs/9699919799/basedefs/V1_chap09.html
- man7.org — grep(1): https://man7.org/linux/man-pages/man1/grep.1.html
Phần sau ta sang công cụ chỉnh sửa dòng lệnh mạnh nhất cho biến đổi văn bản: sed — thay thế, xoá, chèn theo dòng, và vì sao sed -i trên Linux khác macOS khiến script hỏng khi chuyển máy.
