Regex là một trong những công cụ được dùng nhiều nhất mà hiểu ít nhất. Đa số lập trình viên gõ \d+ hay [a-z]* và hy vọng nó "hiểu" ý mình — coi regex như một loại phép thuật so khớp. Nhưng bên trong không có phép thuật nào cả: một engine regex làm đúng hai việc rất cơ học. Thứ nhất, nó biên dịch mẫu của bạn thành một máy trạng thái — một danh sách các trạng thái và luật chuyển. Thứ hai, nó chạy cỗ máy đó trên chuỗi input, ký tự này qua ký tự khác. Hiểu được điều này là nền tảng để hiểu mọi thứ còn lại của cả loạt bài: vì sao regex nhanh hay chậm, vì sao có mẫu làm treo cả server (ReDoS), và vì sao Go/RE2 lại khác Perl/Python. Bài này (phần 1 loạt Regex) mở nắp cỗ máy ra xem tận mắt.
Hai bước: biên dịch rồi chạy
Khi bạn viết re.compile("a(b|c)*d"), engine không lưu lại chuỗi ký tự đó. Nó phân tích cú pháp mẫu và sinh ra một cấu trúc dữ liệu — trong lý thuyết gọi là automaton (máy tự động). Có hai họ:
- NFA (Nondeterministic Finite Automaton): ở một trạng thái, một ký tự input có thể dẫn tới nhiều trạng thái kế. Các engine kiểu backtracking (Perl, Python
re, PCRE, Java) mô phỏng NFA bằng cách thử từng nhánh, quay lui (backtrack) khi hỏng. - DFA (Deterministic Finite Automaton): mỗi (trạng thái, ký tự) dẫn tới đúng một trạng thái kế — không cần quay lui. RE2 (Go, và thư viện của Google) dùng cách tiếp cận này (thực chất là NFA mô phỏng kiểu Thompson, hoặc DFA sinh dần), đảm bảo duyệt tuyến tính.
Khác biệt giữa hai họ này chính là chủ đề của phần 6 và 7 (ReDoS và RE2). Nhưng cả hai đều là máy trạng thái — và ta xem được nó bằng công cụ thật.
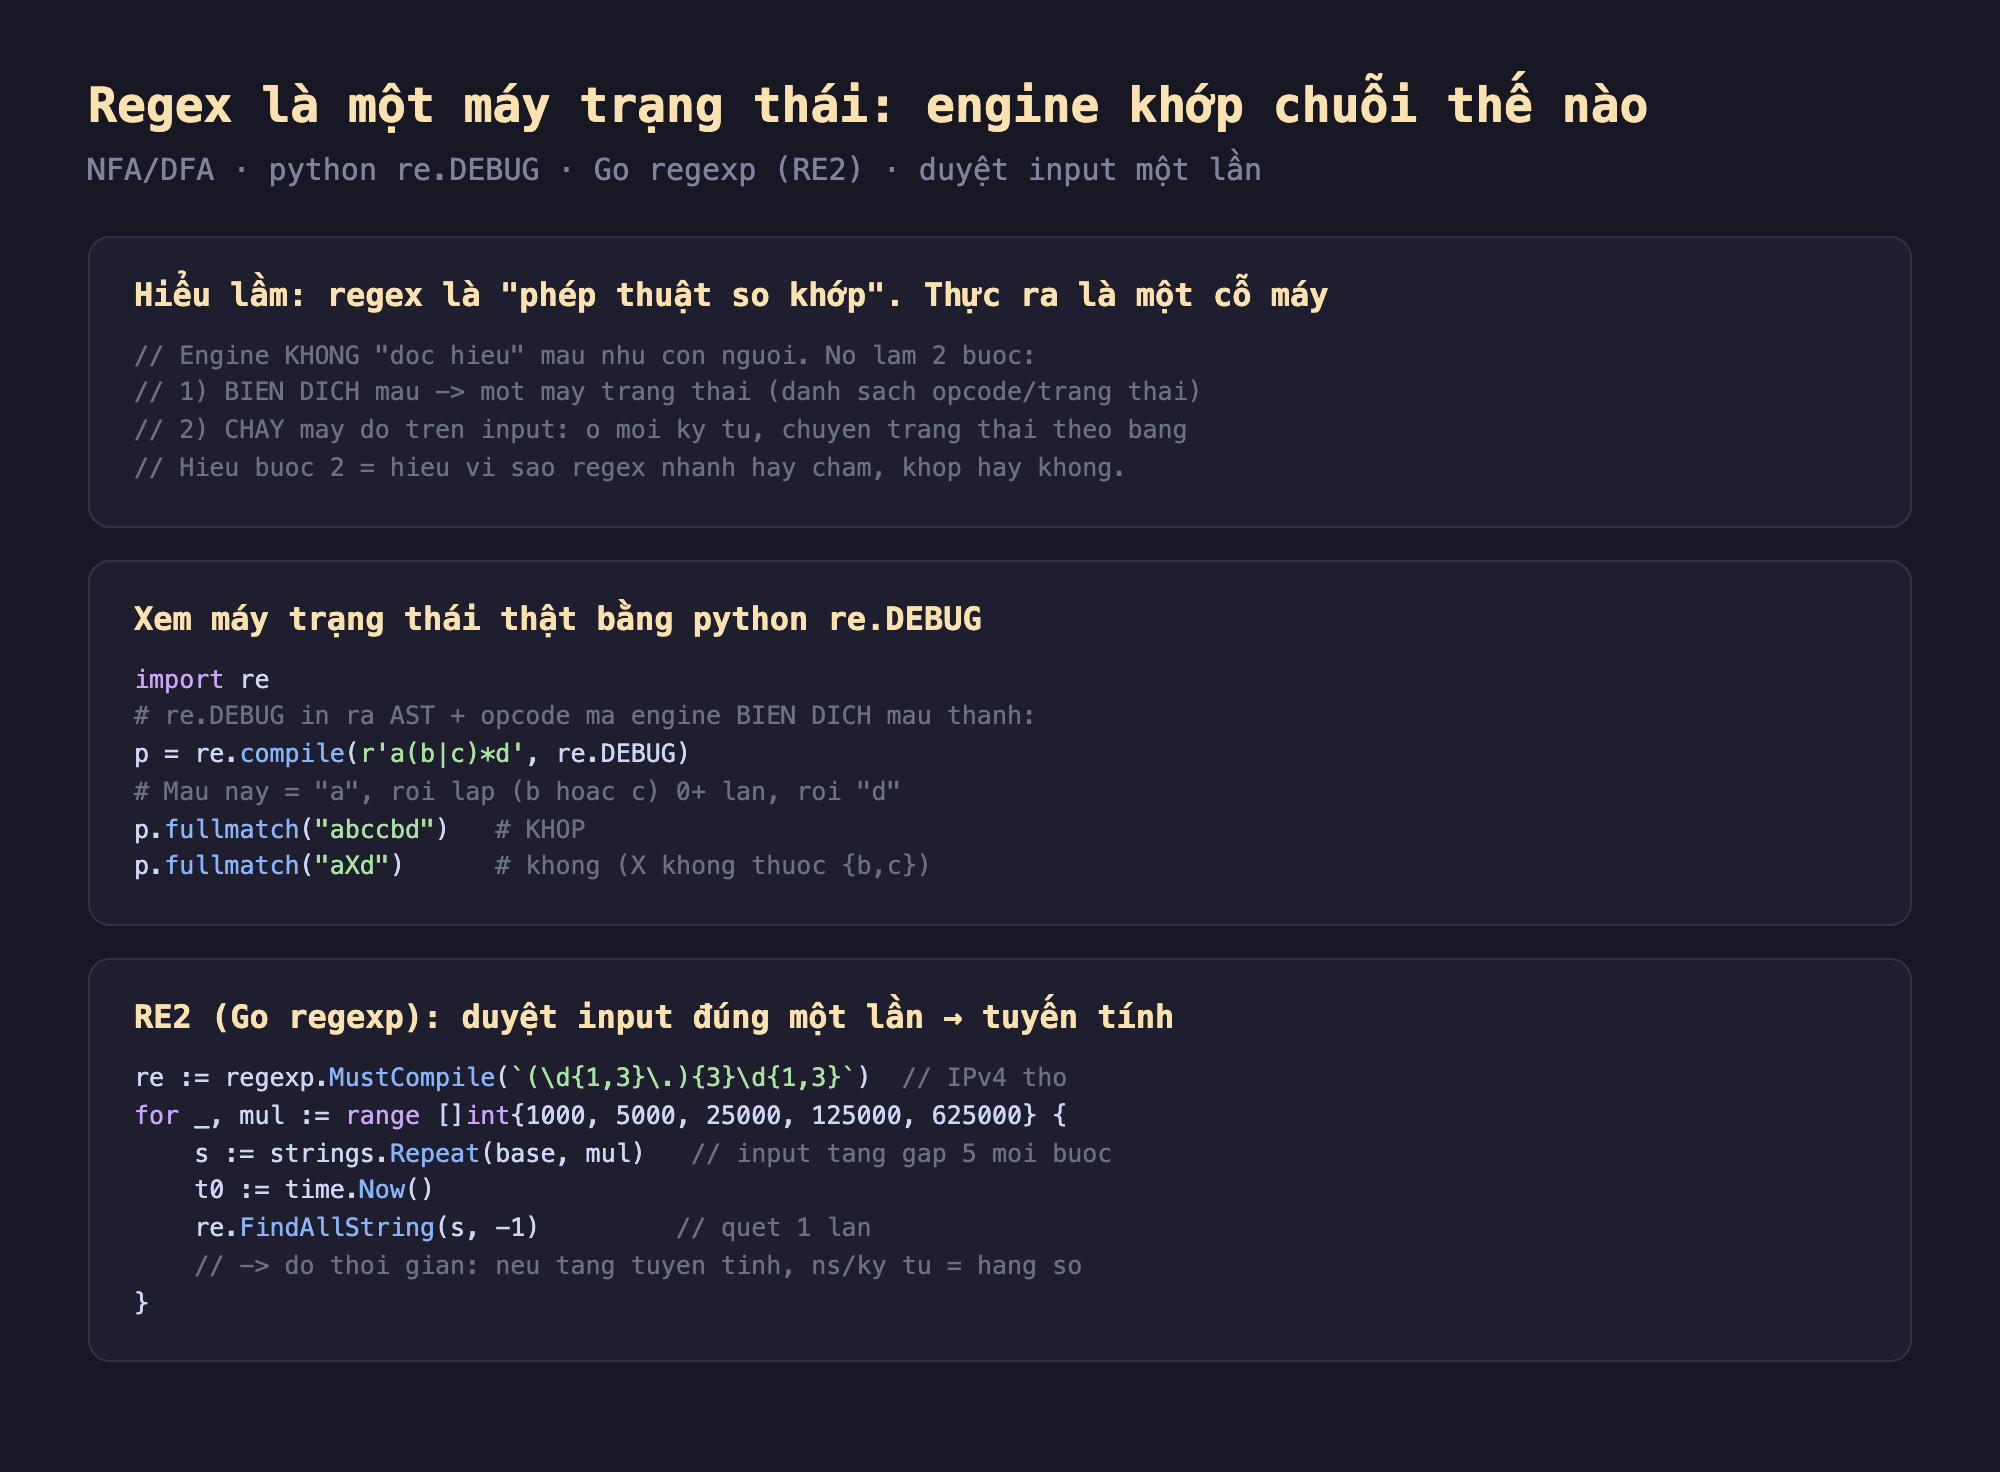
Hình 1: Engine không "đọc hiểu" mẫu mà làm hai bước — biên dịch mẫu thành máy trạng thái (opcode), rồi chạy máy đó trên input; python re.DEBUG cho xem máy trạng thái thật, và Go regexp (RE2) duyệt input một lần nên thời gian tuyến tính.
Đo thật: mở máy trạng thái ra xem
Python có một cờ tuyệt vời để nhìn vào bên trong: re.compile(pattern, re.DEBUG) in ra cả cây cú pháp (AST) lẫn danh sách opcode mà engine sẽ thực thi. Đây không phải hình vẽ minh hoạ — nó là cỗ máy thật mà Python chạy. Mình biên dịch mẫu a(b|c)*d (khớp: một chữ a, rồi lặp b hoặc c không-hoặc-nhiều lần, rồi một chữ d):
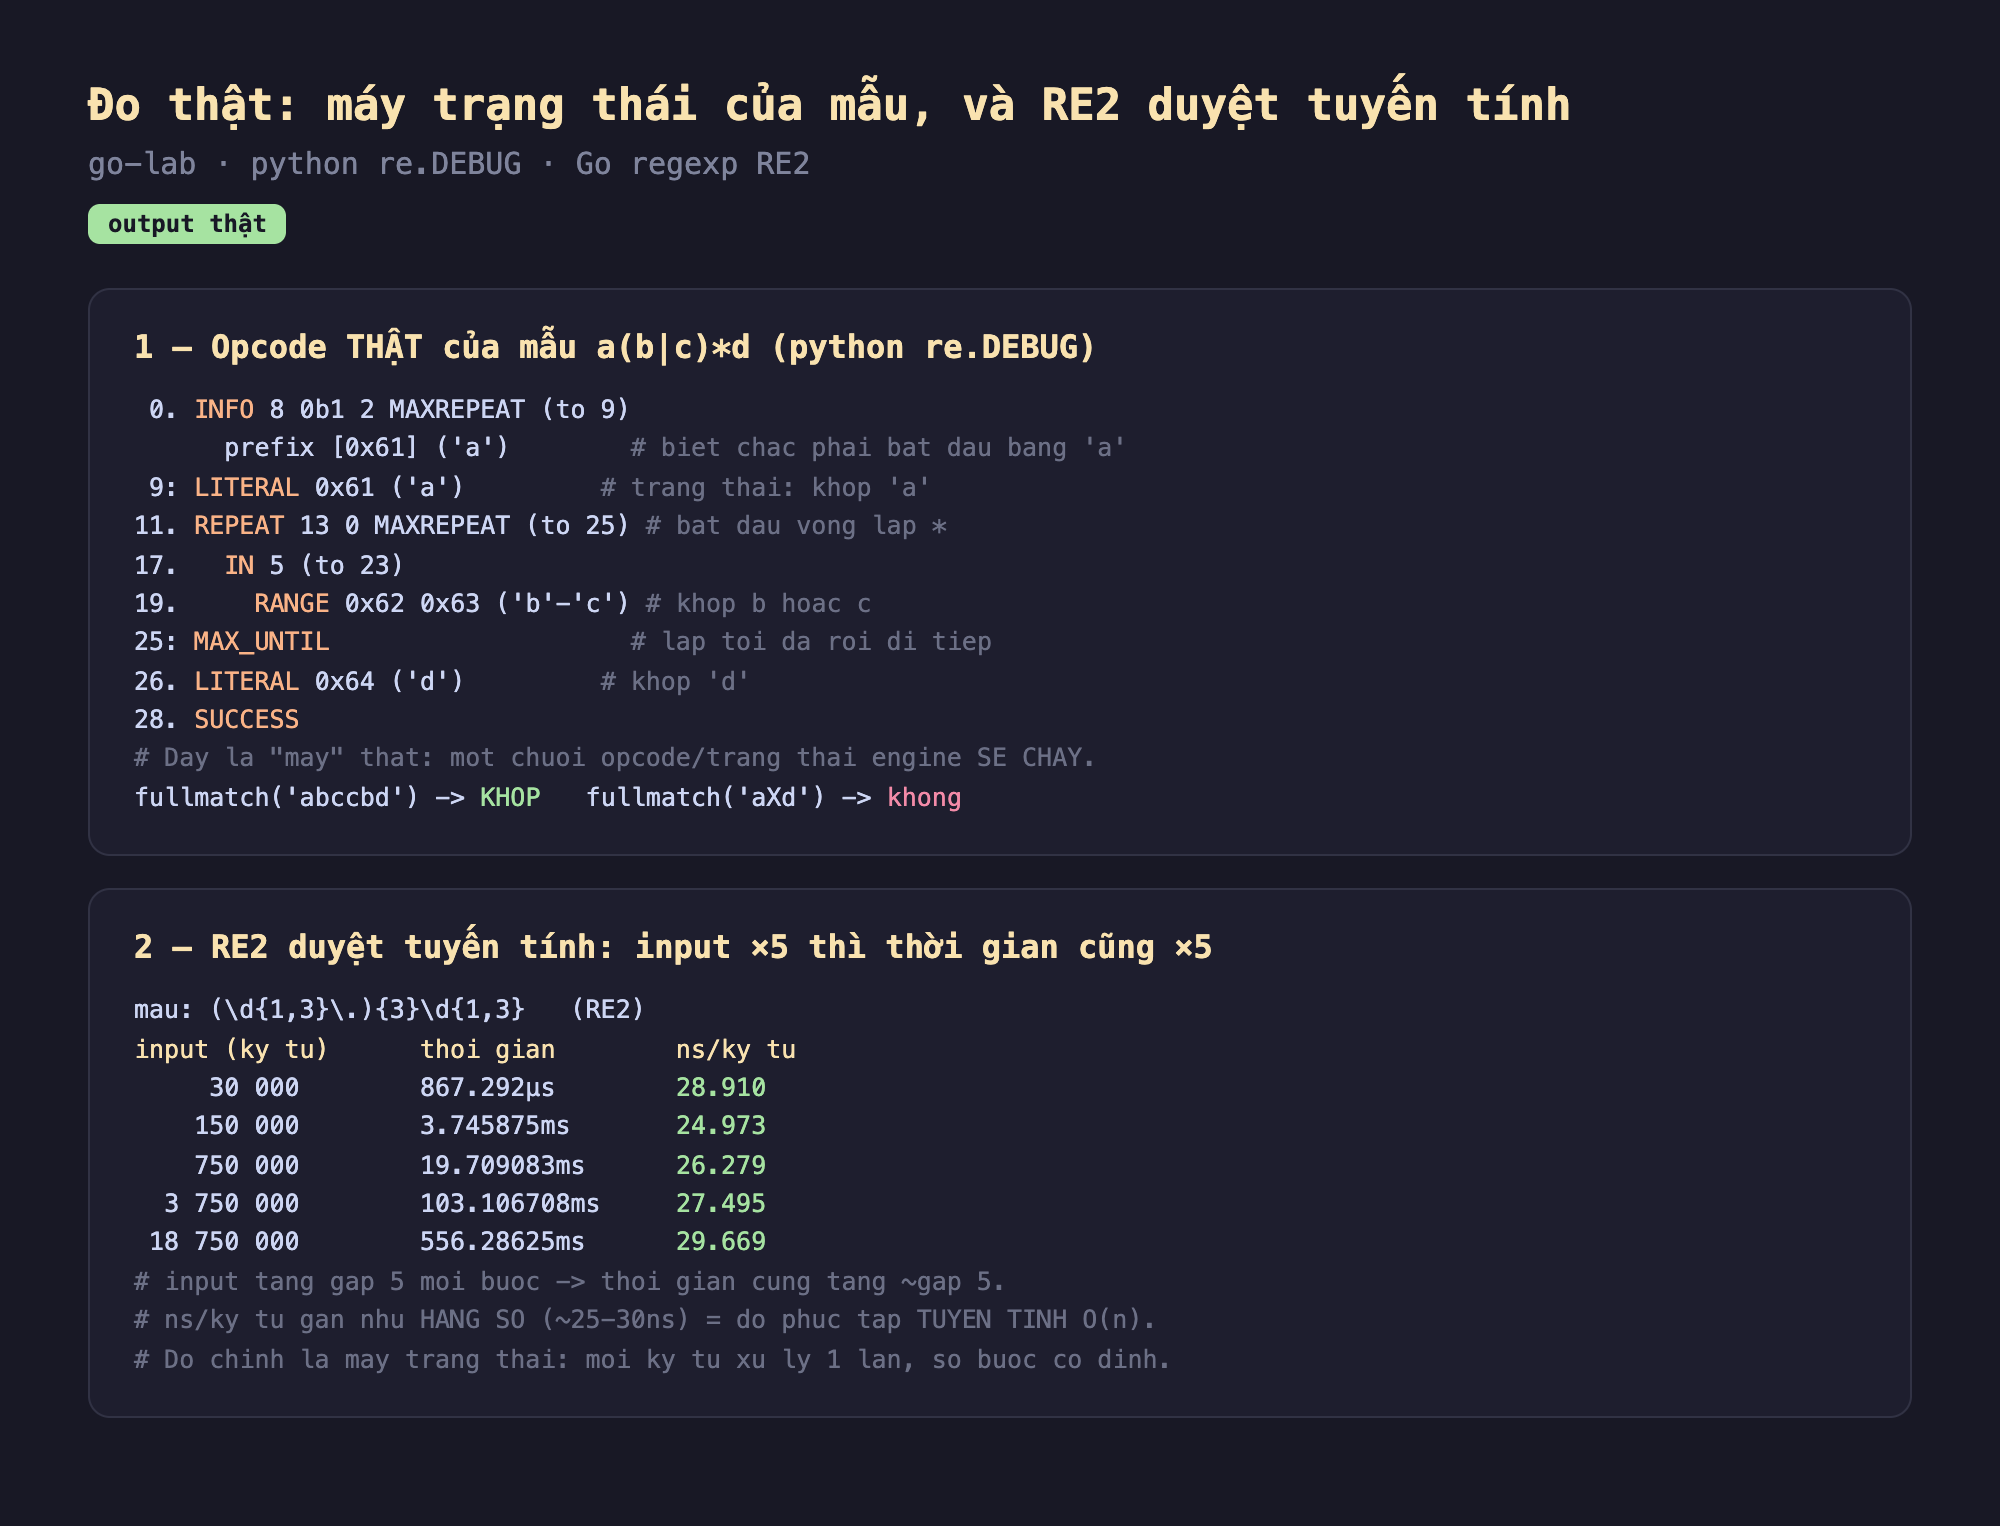
Hình 2: Chạy thật — re.DEBUG in opcode của a(b|c)*d: LITERAL 'a' → REPEAT/IN RANGE 'b'-'c'/MAX_UNTIL → LITERAL 'd' → SUCCESS; và RE2 trên input từ 30.000 tới 18.750.000 ký tự cho thời gian 867µs → 556ms với ns/ký tự giữ ~25-30 (tuyến tính).
- Opcode là cỗ máy thật: đọc từ trên xuống, đây chính là chương trình engine chạy.
INFOvớiprefix ['a']cho biết engine đã tối ưu: nó biết chuỗi khớp bắt buộc bắt đầu bằnga, nên có thể nhảy nhanh tới các vị trí cóa. RồiLITERAL 0x61(khớpa),REPEAT ... IN RANGE 'b'-'c' ... MAX_UNTIL(vòng lặp khớpbhoặcc),LITERAL 0x64(khớpd),SUCCESS. Mỗi opcode là một trạng thái; chạy chúng tuần tự trên input chính là "khớp regex". - Khớp là chạy máy:
fullmatch('abccbd')thành công vì chuỗi đi trọn từaqua vòngb/ctớidrồiSUCCESS.fullmatch('aXd')thất bại vì tớiX, opcodeIN RANGE 'b'-'c'không chấp nhậnX, máy dừng. - RE2 duyệt tuyến tính — đo thật: mình cho RE2 (Go regexp) khớp mẫu IPv4 trên input tăng gấp 5 mỗi bước (30.000 → 150.000 → ... → 18.750.000 ký tự). Thời gian cũng tăng gấp ~5 mỗi bước (
867µs → 3.7ms → 19.7ms → 103ms → 556ms), vàns/ký tựgiữ gần như hằng số (~25-30ns). Đây là chữ ký của độ phức tạp tuyến tính O(n): cỗ máy trạng thái xử lý mỗi ký tự đúng một lần với số bước cố định. Chính tính chất này khiến RE2 an toàn trước ReDoS (phần 7) — điều mà engine backtracking không đảm bảo.
Đánh đổi cần cân nhắc
re.DEBUG của Python cho thấy máy backtracking, không phải DFA của RE2. Opcode ta xem ở trên là của engine re Python (kiểu NFA-backtracking). RE2 của Go biên dịch sang một dạng khác (chương trình NFA chạy song song các trạng thái, hoặc DFA sinh dần), không xem được bằng re.DEBUG. Hai engine cùng là "máy trạng thái" nhưng cách chạy máy khác nhau — và đó là gốc rễ của khác biệt hiệu năng ở các phần sau. Đừng nghĩ mọi engine regex đều làm giống nhau.
Biên dịch mẫu tốn công — nên làm một lần. Bước biên dịch mẫu thành máy trạng thái không miễn phí. Nếu bạn gọi regexp.MustCompile/re.compile bên trong vòng lặp, bạn trả chi phí biên dịch lại mỗi lần. Luôn biên dịch một lần và tái dùng đối tượng regex đã biên dịch (chi tiết ở phần 11 về tối ưu). Đây là lỗi hiệu năng regex phổ biến nhất trong thực tế.
Tuyến tính theo độ dài input, nhưng hằng số phụ thuộc mẫu. RE2 đảm bảo O(n) theo độ dài input, nhưng con số ns/ký tự (hằng số nhân) phụ thuộc độ phức tạp của mẫu: một mẫu nhiều nhánh, nhiều lớp ký tự lớn sẽ có hằng số cao hơn. "Tuyến tính" không có nghĩa "luôn nhanh" — nó có nghĩa "không bùng nổ theo input". Với engine backtracking thì ngay cả điều đó cũng không được đảm bảo.
Ba ý mang về
- Regex là máy trạng thái, không phải phép thuật: engine biên dịch mẫu thành opcode/trạng thái (xem thật bằng
python re.DEBUG:LITERAL,REPEAT,IN RANGE,MAX_UNTIL,SUCCESS) rồi chạy máy đó trên input — khớp chính là chạy cỗ máy qua từng ký tự. - RE2 duyệt input tuyến tính: đo thật input tăng gấp 5 (30.000 → 18.750.000 ký tự) thì thời gian cũng tăng ~gấp 5 (
867µs → 556ms),ns/ký tựhằng số ~25-30 — độ phức tạp O(n), mỗi ký tự xử lý một lần. - Không phải engine nào cũng giống nhau: NFA-backtracking (Python/Perl/PCRE) và DFA/RE2 (Go) cùng là máy trạng thái nhưng chạy khác nhau — đây là gốc của mọi khác biệt hiệu năng ở các phần sau; và luôn nhớ biên dịch mẫu một lần rồi tái dùng.
Nguồn
- Russ Cox — Regular Expression Matching Can Be Simple And Fast: https://swtch.com/~rsc/regexp/regexp1.html
- Python docs — re module (
re.DEBUG): https://docs.python.org/3/library/re.html - Go docs — regexp package (RE2): https://pkg.go.dev/regexp
Phần sau ta mổ xẻ một cặp gây bối rối nhất: tham lam (.*) và lười (.*?) — chúng khớp khác nhau ra sao, và vì sao chọn sai làm engine phải quay lui nhiều hơn hẳn.
