Phần 5 cho thấy DuckDB quét thẳng Parquet rất nhanh. Phần này trả lời vì sao: vectorized execution, mô hình thực thi xử lý dữ liệu theo lô vector thay vì từng dòng một. Đây là khác biệt kiến trúc giữa một engine phân tích hiện đại và một vòng lặp xử lý dữ liệu viết tay, và nó giải thích tại sao cùng một phép tính trên cùng một máy có thể chênh nhau hàng chục lần. Bài này đo trực tiếp bằng cách so một vòng lặp Python tính từng dòng với DuckDB tính theo vector, trên cùng mười triệu dòng, rồi thêm numpy để chứng minh điểm cốt lõi: thắng lợi đến từ việc xử lý theo lô, không phải riêng chuyện ngôn ngữ nào nhanh hơn.
Từng dòng một tốn chi phí lặp lại cho mỗi dòng
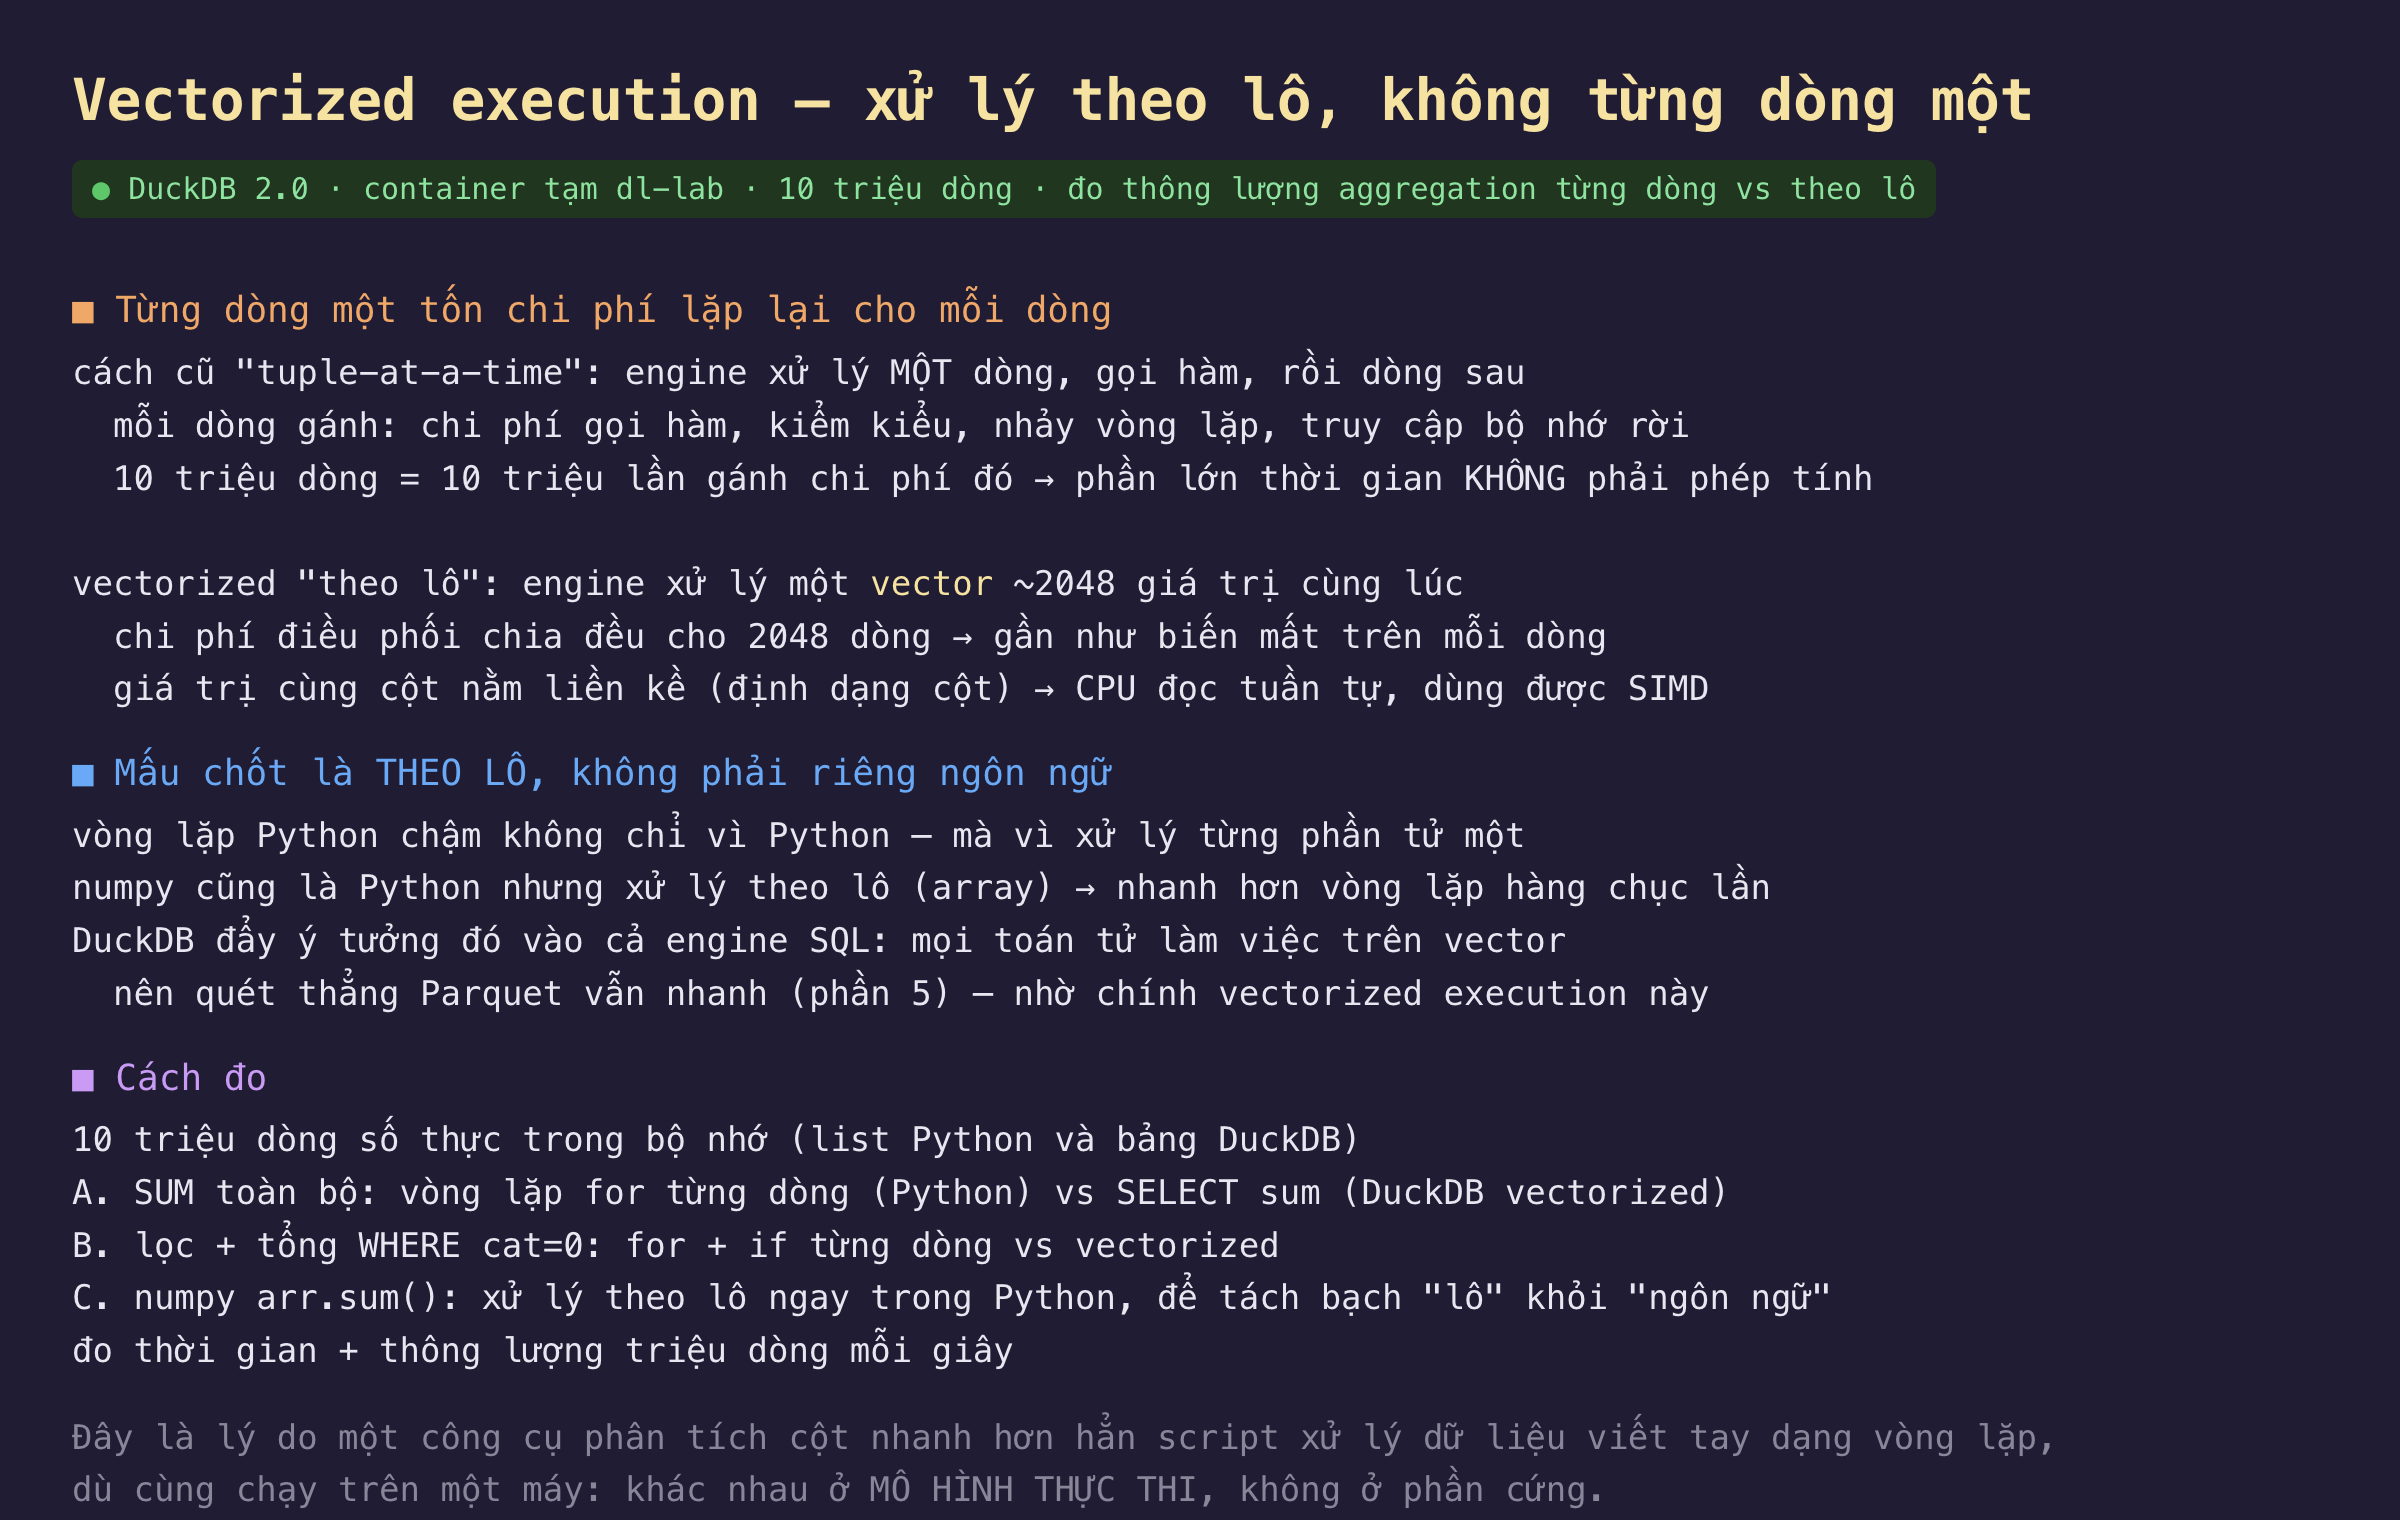
Hình 1: Từng dòng một gánh chi phí điều phối cho mỗi dòng; vectorized chia chi phí đó cho cả vector nên gần như biến mất.
Mô hình cũ, gọi là tuple-at-a-time, xử lý một dòng mỗi lần: engine lấy một dòng, gọi hàm tính toán, rồi sang dòng tiếp theo. Vấn đề là mỗi dòng gánh một loạt chi phí không phải phép tính thật: chi phí gọi hàm, kiểm tra kiểu dữ liệu, nhảy vòng lặp, và truy cập bộ nhớ ở các vị trí rời rạc. Với mười triệu dòng, đó là mười triệu lần gánh chi phí điều phối, và phần lớn thời gian trôi vào những chi phí đó chứ không vào phép tính mà bạn thực sự cần. Một vòng lặp cộng từng số trong Python là ví dụ điển hình: mỗi vòng lặp làm rất ít việc hữu ích so với công sức điều phối.
Mô hình vectorized xử lý theo lô: engine làm việc trên một vector khoảng 2048 giá trị cùng lúc. Chi phí điều phối, vốn trả một lần cho cả vector, được chia đều cho 2048 dòng nên gần như biến mất khi tính trên mỗi dòng. Thêm nữa, vì các giá trị cùng một cột nằm liền kề trong bộ nhớ ở định dạng cột, CPU đọc chúng tuần tự và tận dụng được SIMD, tức các lệnh xử lý nhiều giá trị trong một chu kỳ. Hai yếu tố này cộng lại cho thông lượng cao hơn hẳn mà không cần phần cứng mạnh hơn.
Điểm cốt lõi cần nhớ: mấu chốt là xử lý theo lô, không phải riêng ngôn ngữ. Vòng lặp Python chậm không chỉ vì Python là ngôn ngữ thông dịch, mà vì nó xử lý từng phần tử một. numpy cũng là Python nhưng xử lý theo lô dưới dạng array, nên nhanh hơn vòng lặp Python hàng chục lần. DuckDB đẩy chính ý tưởng đó vào cả engine SQL: mọi toán tử của nó làm việc trên vector, nên quét thẳng Parquet vẫn nhanh như phần trước đo, nhờ chính vectorized execution. Cách đo: mười triệu dòng số thực trong bộ nhớ, vừa ở dạng list Python vừa trong bảng DuckDB; tính tổng toàn bộ bằng vòng lặp for Python so với SELECT sum của DuckDB; lọc rồi tổng WHERE cat=0 bằng for cộng if so với vectorized; và numpy arr.sum() để tách bạch yếu tố lô khỏi yếu tố ngôn ngữ.
Đo thật: tính tổng 10 triệu dòng, 2,7 ms so với 83,9 ms
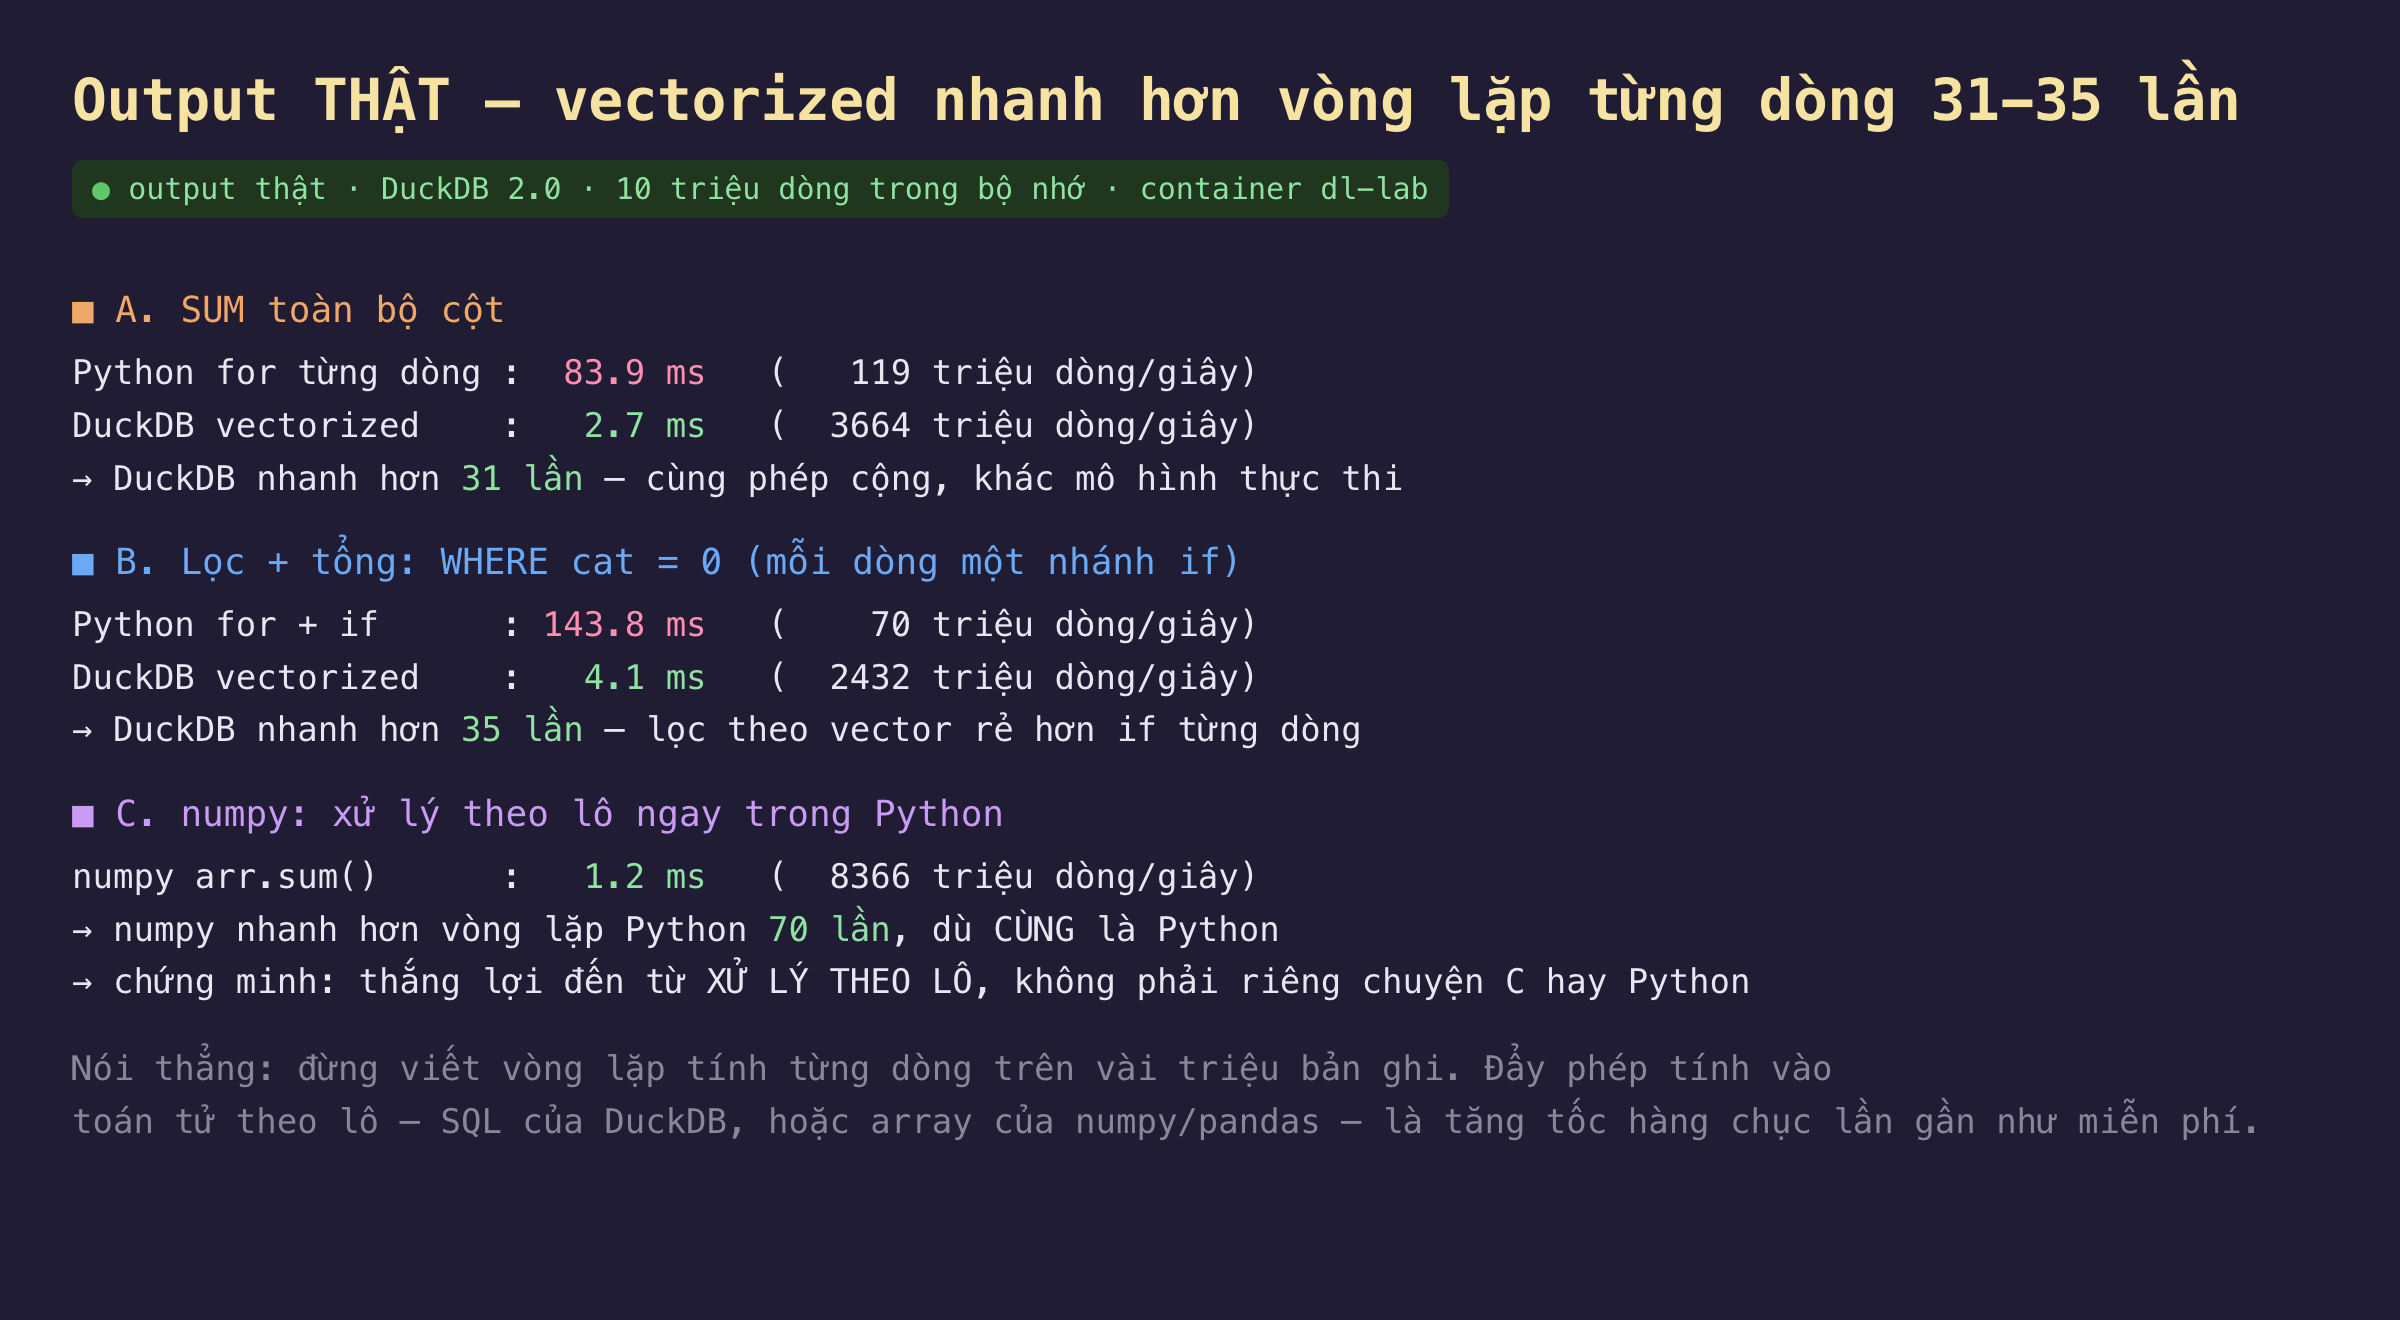
Hình 2: Vòng lặp Python từng dòng so với DuckDB vectorized và numpy; batch thắng row-at-a-time hàng chục lần.
| phép đo | từng dòng | vectorized |
|---|---|---|
| SUM toàn bộ | 83,9 ms (119 tr/s) | 2,7 ms (3664 tr/s) |
| lọc + tổng WHERE cat=0 | 143,8 ms (70 tr/s) | 4,1 ms (2432 tr/s) |
| numpy arr.sum() | — | 1,2 ms (8366 tr/s) |
Tính tổng mười triệu dòng mất 2,7 ms với vectorized, so với 83,9 ms với vòng lặp. Vòng lặp for Python cộng từng số đạt thông lượng 119 triệu dòng mỗi giây, trong khi DuckDB vectorized đạt 3664 triệu dòng mỗi giây, nhanh hơn ba mươi mốt lần. Cùng một phép cộng, cùng một dữ liệu trong bộ nhớ, khác biệt hoàn toàn nằm ở mô hình thực thi: vòng lặp gánh chi phí điều phối cho từng dòng, còn DuckDB xử lý theo vector nên chi phí đó gần như biến mất. Đây là lý do một engine phân tích tính nhanh hơn hẳn một script viết tay dạng vòng lặp, dù cả hai chạy trên cùng một CPU.
Lọc rồi tổng còn chênh nhiều hơn, 35 lần. Khi thêm điều kiện WHERE cat=0, vòng lặp Python phải chạy một nhánh if cho từng dòng, kéo thông lượng xuống chỉ 70 triệu dòng mỗi giây, mất 143,8 ms. DuckDB vectorized xử lý lọc theo vector, đạt 2432 triệu dòng mỗi giây và chỉ mất 4,1 ms, nhanh hơn ba mươi lăm lần. Khoảng cách rộng hơn ở trường hợp này vì nhánh if từng dòng là một trong những thao tác đắt nhất với mô hình thông dịch: mỗi dòng là một lần rẽ nhánh, một lần dự đoán nhánh có thể trượt. Vectorized áp dụng điều kiện lên cả vector bằng các phép toán trên mảng, tránh được chi phí rẽ nhánh từng dòng.
numpy chứng minh mấu chốt là lô, không phải ngôn ngữ. numpy arr.sum() mất 1,2 ms, đạt 8366 triệu dòng mỗi giây, nhanh hơn vòng lặp Python bảy mươi lần, dù numpy cũng chạy trong Python. Điều này tách bạch hai yếu tố mà người ta hay gộp: không phải "Python chậm nên dùng công cụ khác", mà là "xử lý từng phần tử một chậm, xử lý theo lô nhanh". numpy nhanh vì array của nó là một khối liền trong bộ nhớ và phép sum chạy một vòng lặp C chặt chẽ tận dụng SIMD, cùng nguyên lý với vectorized của DuckDB. numpy thậm chí nhanh hơn DuckDB ở phép sum thuần vì nó là thao tác mảng đơn giản không có bộ máy truy vấn SQL kèm theo; nhưng cả hai đều cho thấy batch thắng row-at-a-time áp đảo.
Đánh đổi cần cân nhắc
Đừng viết vòng lặp tính từng dòng trên vài triệu bản ghi. Bài học thực hành rõ ràng: khi xử lý nhiều triệu dòng, đẩy phép tính vào các toán tử theo lô thay vì viết vòng lặp Python duyệt từng phần tử. Công cụ có sẵn rất nhiều: SQL của DuckDB, array của numpy, DataFrame của pandas hay Polars, tất cả đều vectorized. Chuyển một vòng lặp tổng hợp sang một câu SQL hoặc một phép mảng thường tăng tốc hàng chục lần mà không cần tối ưu gì thêm, gần như miễn phí. Đây là một trong những thay đổi có tỉ lệ lợi ích trên công sức cao nhất khi xử lý dữ liệu.
Vectorized mạnh cho thao tác đồng nhất, kém cho logic rẽ nhánh phức tạp từng dòng. Lợi thế của vectorized đến khi áp cùng một phép toán lên nhiều giá trị. Với logic phức tạp khác nhau tùy từng dòng, nhiều nhánh điều kiện lồng nhau, hoặc phụ thuộc trạng thái tích lũy qua các dòng, mô hình vector khó phát huy và đôi khi phải quay lại xử lý từng dòng. Tin tốt là phần lớn phân tích dữ liệu, lọc, tổng hợp, nhóm, join, đều là thao tác đồng nhất hợp với vectorized. Khi gặp logic thật sự tuần tự, đó là ngoại lệ chứ không phải thông lệ, và thường có thể diễn đạt lại dưới dạng vector nếu suy nghĩ lại bài toán.
Phạm vi đo. Bài đo trên dữ liệu đã nằm trong bộ nhớ để cô lập chi phí thực thi khỏi chi phí đọc đĩa. Thông lượng tuyệt đối phụ thuộc kiểu dữ liệu, số lõi CPU và kích thước vector; con số ở đây là trên bốn luồng với số thực. Vòng lặp Python đo là vòng lặp thuần, không dùng các kỹ thuật tăng tốc như Cython hay Numba vốn có thể thu hẹp khoảng cách. Bài cũng không đo chi phí chuyển dữ liệu giữa DuckDB và Python, một yếu tố thực tế khi kết hợp hai công cụ trong một pipeline.
Ba ý mang về
- Vectorized xử lý theo lô vector, chia chi phí điều phối cho cả 2048 dòng. Tính tổng mười triệu dòng mất 2,7 ms với DuckDB so với 83,9 ms với vòng lặp Python, nhanh hơn ba mươi mốt lần.
- Khoảng cách rộng hơn với lọc và logic rẽ nhánh. Lọc rồi tổng nhanh hơn ba mươi lăm lần, vì vectorized tránh được chi phí rẽ nhánh từng dòng của vòng lặp thông dịch.
- Mấu chốt là xử lý theo lô, không phải riêng ngôn ngữ. numpy cũng là Python nhưng nhanh hơn vòng lặp bảy mươi lần; đẩy phép tính vào toán tử theo lô là tăng tốc hàng chục lần gần như miễn phí.
Nguồn
- DuckDB — Why DuckDB, mô hình vectorized execution: https://duckdb.org/why_duckdb
- Peter Boncz và cộng sự — MonetDB/X100: Hyper-Pipelining Query Execution, gốc của vectorized: https://www.cidrdb.org/cidr2005/papers/P19.pdf
- DuckDB — Execution Format, vector size và cách toán tử làm việc: https://duckdb.org/docs/internals/vector
- NumPy — Why is NumPy fast?, vectorization và bộ nhớ liền: https://numpy.org/doc/stable/user/whatisnumpy.html
- Intel — SIMD, xử lý nhiều dữ liệu trong một lệnh: https://www.intel.com/content/www/us/en/support/articles/000005779/processors.html
Phần sau đo một thao tác nặng hơn aggregation: join hai bảng lớn. DuckDB dùng hash join được vectorized để ghép hàng triệu dòng của hai bảng. Xem thời gian và bộ nhớ khi join tăng theo kích thước, và vì sao hash join thắng cách quét lồng nhau trên dữ liệu lớn.
