Phần 6 đo vectorized execution trên aggregation. Phần này đo một thao tác nặng hơn và hay gặp trong phân tích thật: join hai bảng. Ghép một bảng fact lớn, như đơn hàng, với một bảng dimension, như khách hàng, theo một khoá chung là nền tảng của mọi báo cáo. Cách engine thực hiện join quyết định một truy vấn chạy trong mili giây hay treo máy. Bài này đo hash join của DuckDB trên bảng tới mười triệu dòng, cho thấy nó tuyến tính theo kích thước, rồi so với nested loop để thấy vì sao thuật toán join quan trọng đến mức nào và vì sao một điều kiện join sai kiểu có thể làm truy vấn chậm hàng nghìn lần.
Hai cách ghép hai bảng, hai độ phức tạp khác hẳn
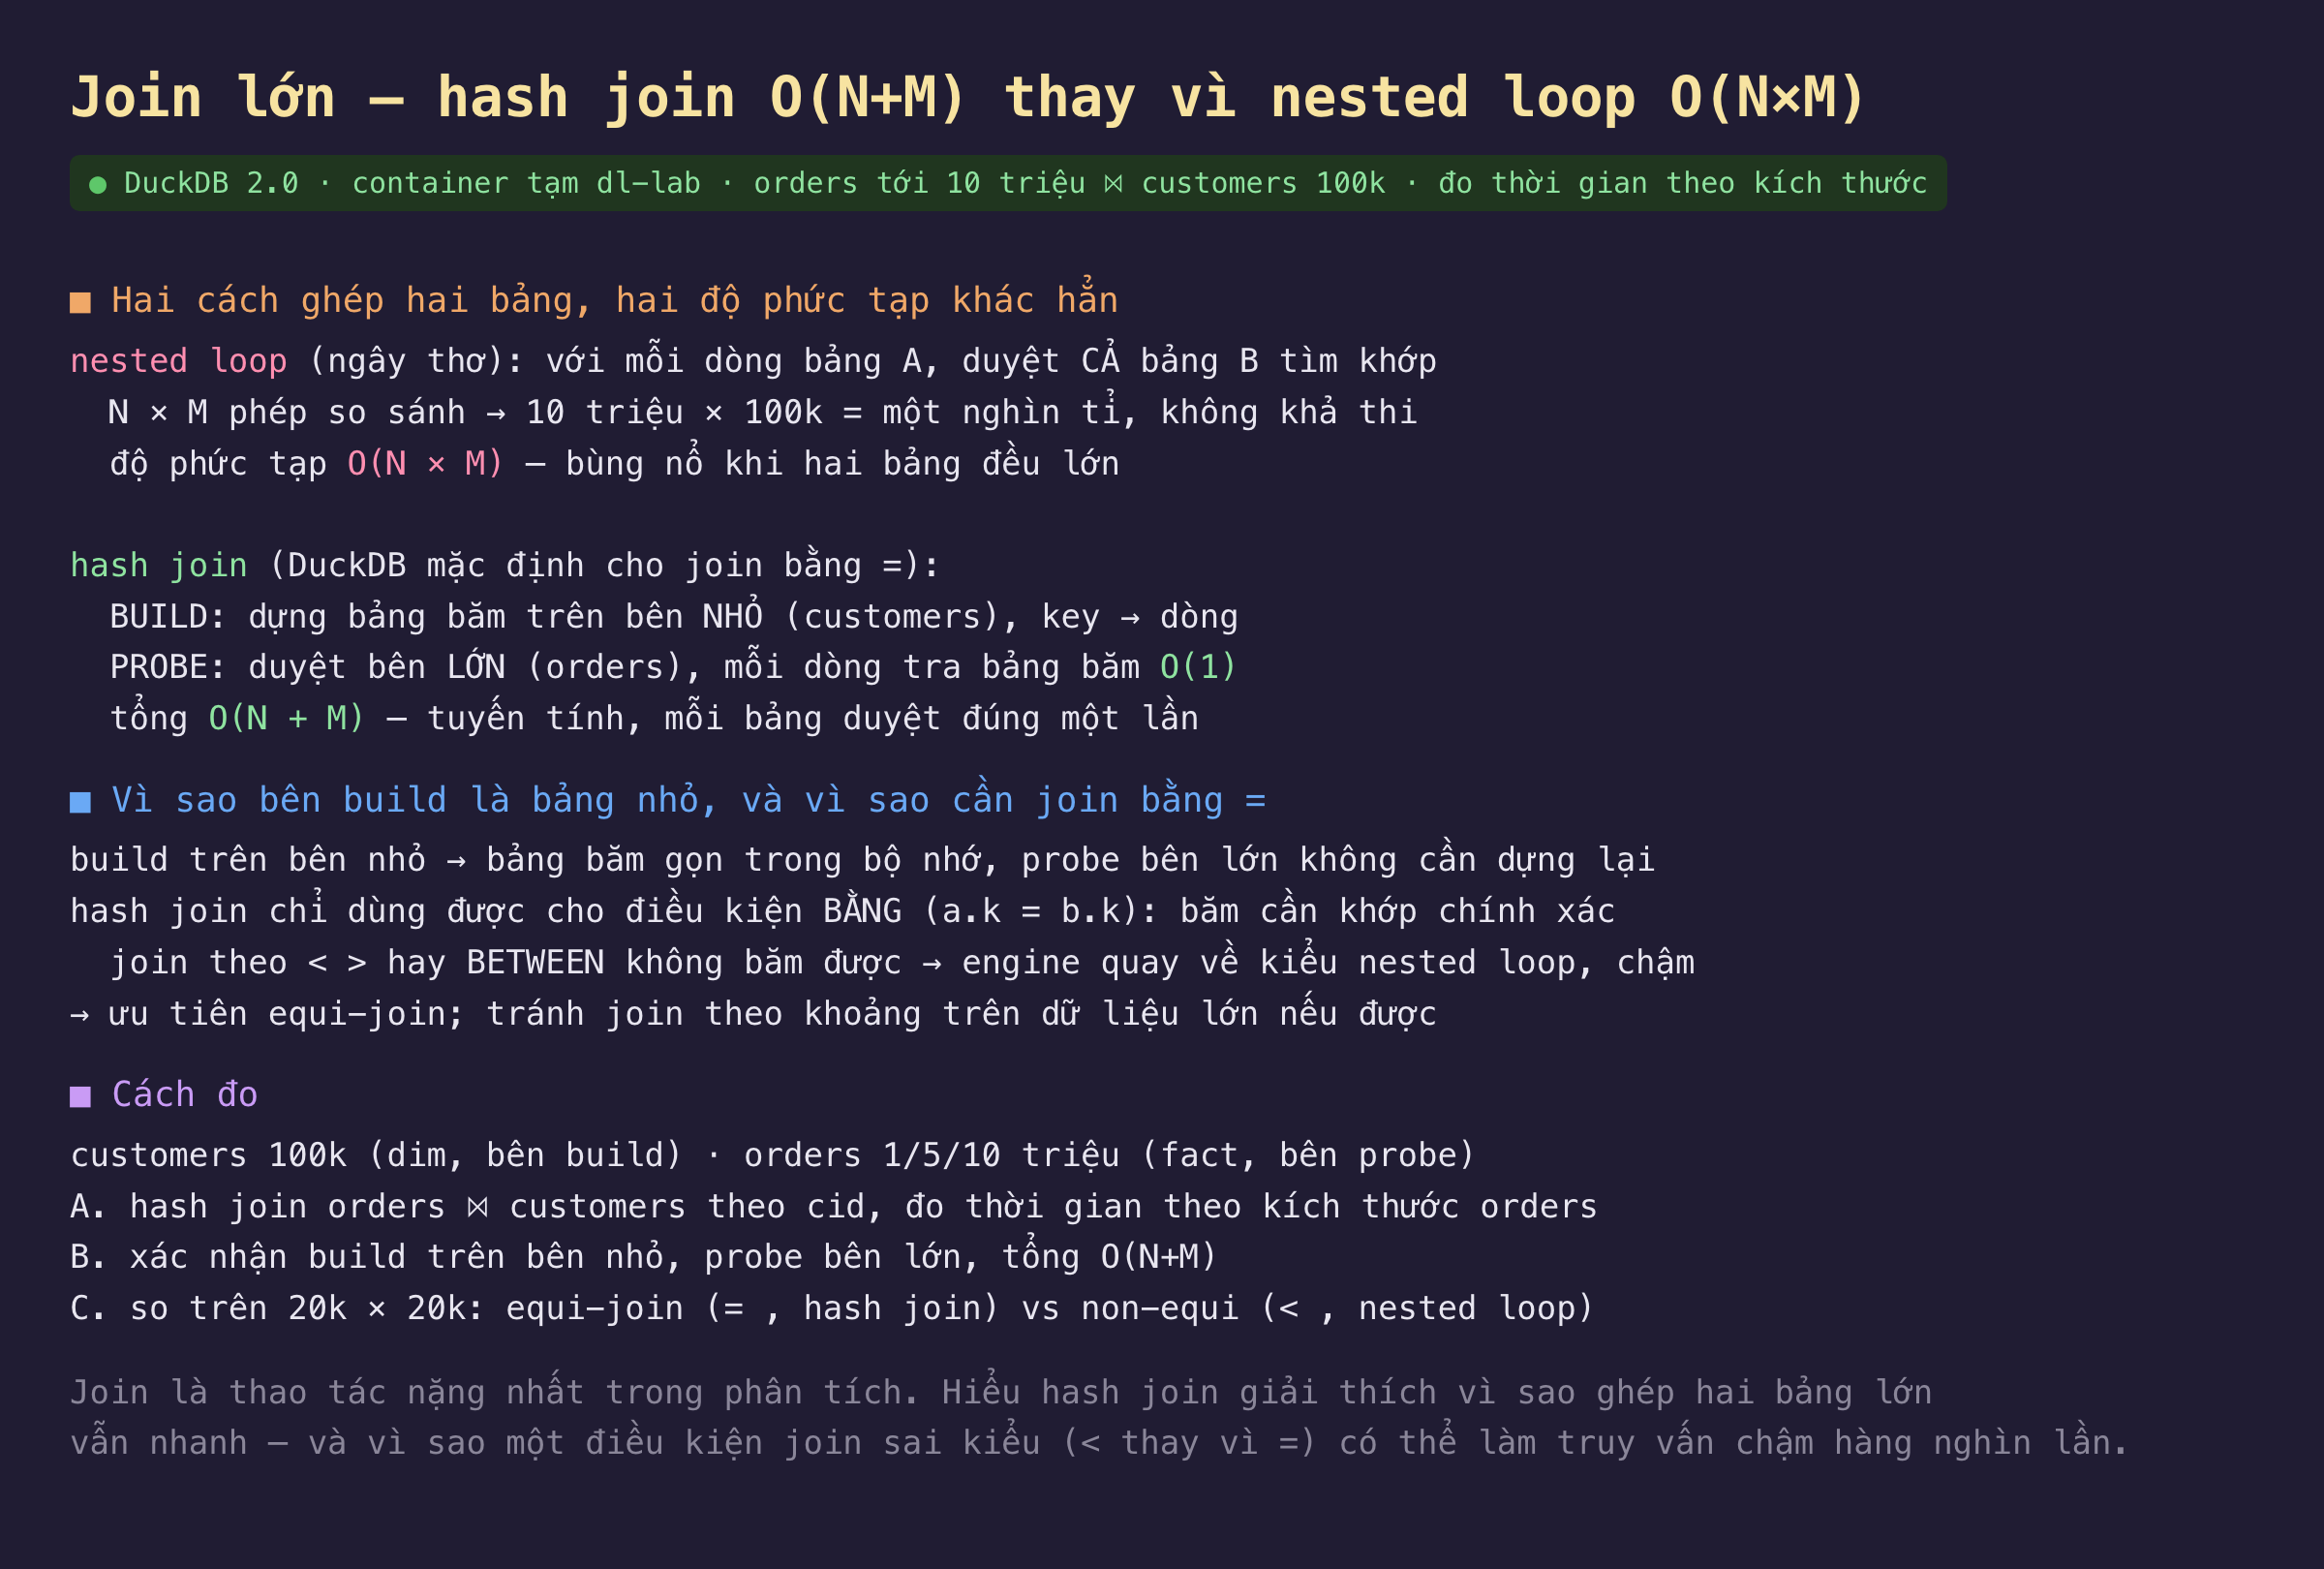
Hình 1: Nested loop O(N×M) so với hash join O(N+M); hash join dựng bảng băm trên bên nhỏ và chỉ dùng được cho điều kiện bằng.
Cách ghép ngây thơ là nested loop: với mỗi dòng của bảng A, duyệt cả bảng B để tìm dòng khớp. Cách này cần N nhân M phép so sánh; với mười triệu đơn và một trăm nghìn khách, đó là một nghìn tỉ phép so sánh, hoàn toàn không khả thi. Độ phức tạp O(N nhân M) bùng nổ khi cả hai bảng đều lớn, nên không engine nghiêm túc nào dùng nested loop cho join bằng trên dữ liệu lớn.
DuckDB, như mọi engine phân tích, mặc định dùng hash join cho join theo điều kiện bằng. Hash join làm hai bước. Bước build: dựng một bảng băm trên bên nhỏ hơn, ở đây là bảng khách hàng, ánh xạ từ khoá sang dòng. Bước probe: duyệt bên lớn hơn, bảng đơn hàng, và với mỗi dòng tra bảng băm để tìm khớp, mỗi lần tra là O(1). Tổng độ phức tạp là O(N cộng M), tuyến tính, vì mỗi bảng chỉ được duyệt đúng một lần. Đây là lý do join hai bảng lớn vẫn chạy nhanh: thay vì so sánh mọi cặp, mỗi dòng bên lớn chỉ tra một lần vào bảng băm đã dựng sẵn.
Hai chi tiết quan trọng. Thứ nhất, bên build là bảng nhỏ: dựng bảng băm trên bên nhỏ cho bảng băm gọn trong bộ nhớ, và probe bên lớn không cần dựng lại gì. Thứ hai, hash join chỉ dùng được cho điều kiện bằng, dạng a.k = b.k, vì băm cần khớp chính xác giá trị. Join theo khoảng, dùng nhỏ hơn, lớn hơn hay BETWEEN, không băm được, nên engine phải quay về kiểu nested loop và chậm hẳn. Hệ quả thực hành: ưu tiên equi-join và tránh join theo khoảng trên dữ liệu lớn nếu có thể. Cách đo: bảng khách hàng một trăm nghìn dòng làm dimension và bên build, bảng đơn hàng một, năm, mười triệu dòng làm fact và bên probe; đo hash join theo kích thước đơn hàng; xác nhận build trên bên nhỏ; và so equi-join với non-equi trên hai bảng hai mươi nghìn dòng.
Đo thật: join 10 triệu dòng 33 ms, equi nhanh hơn non-equi 1142 lần
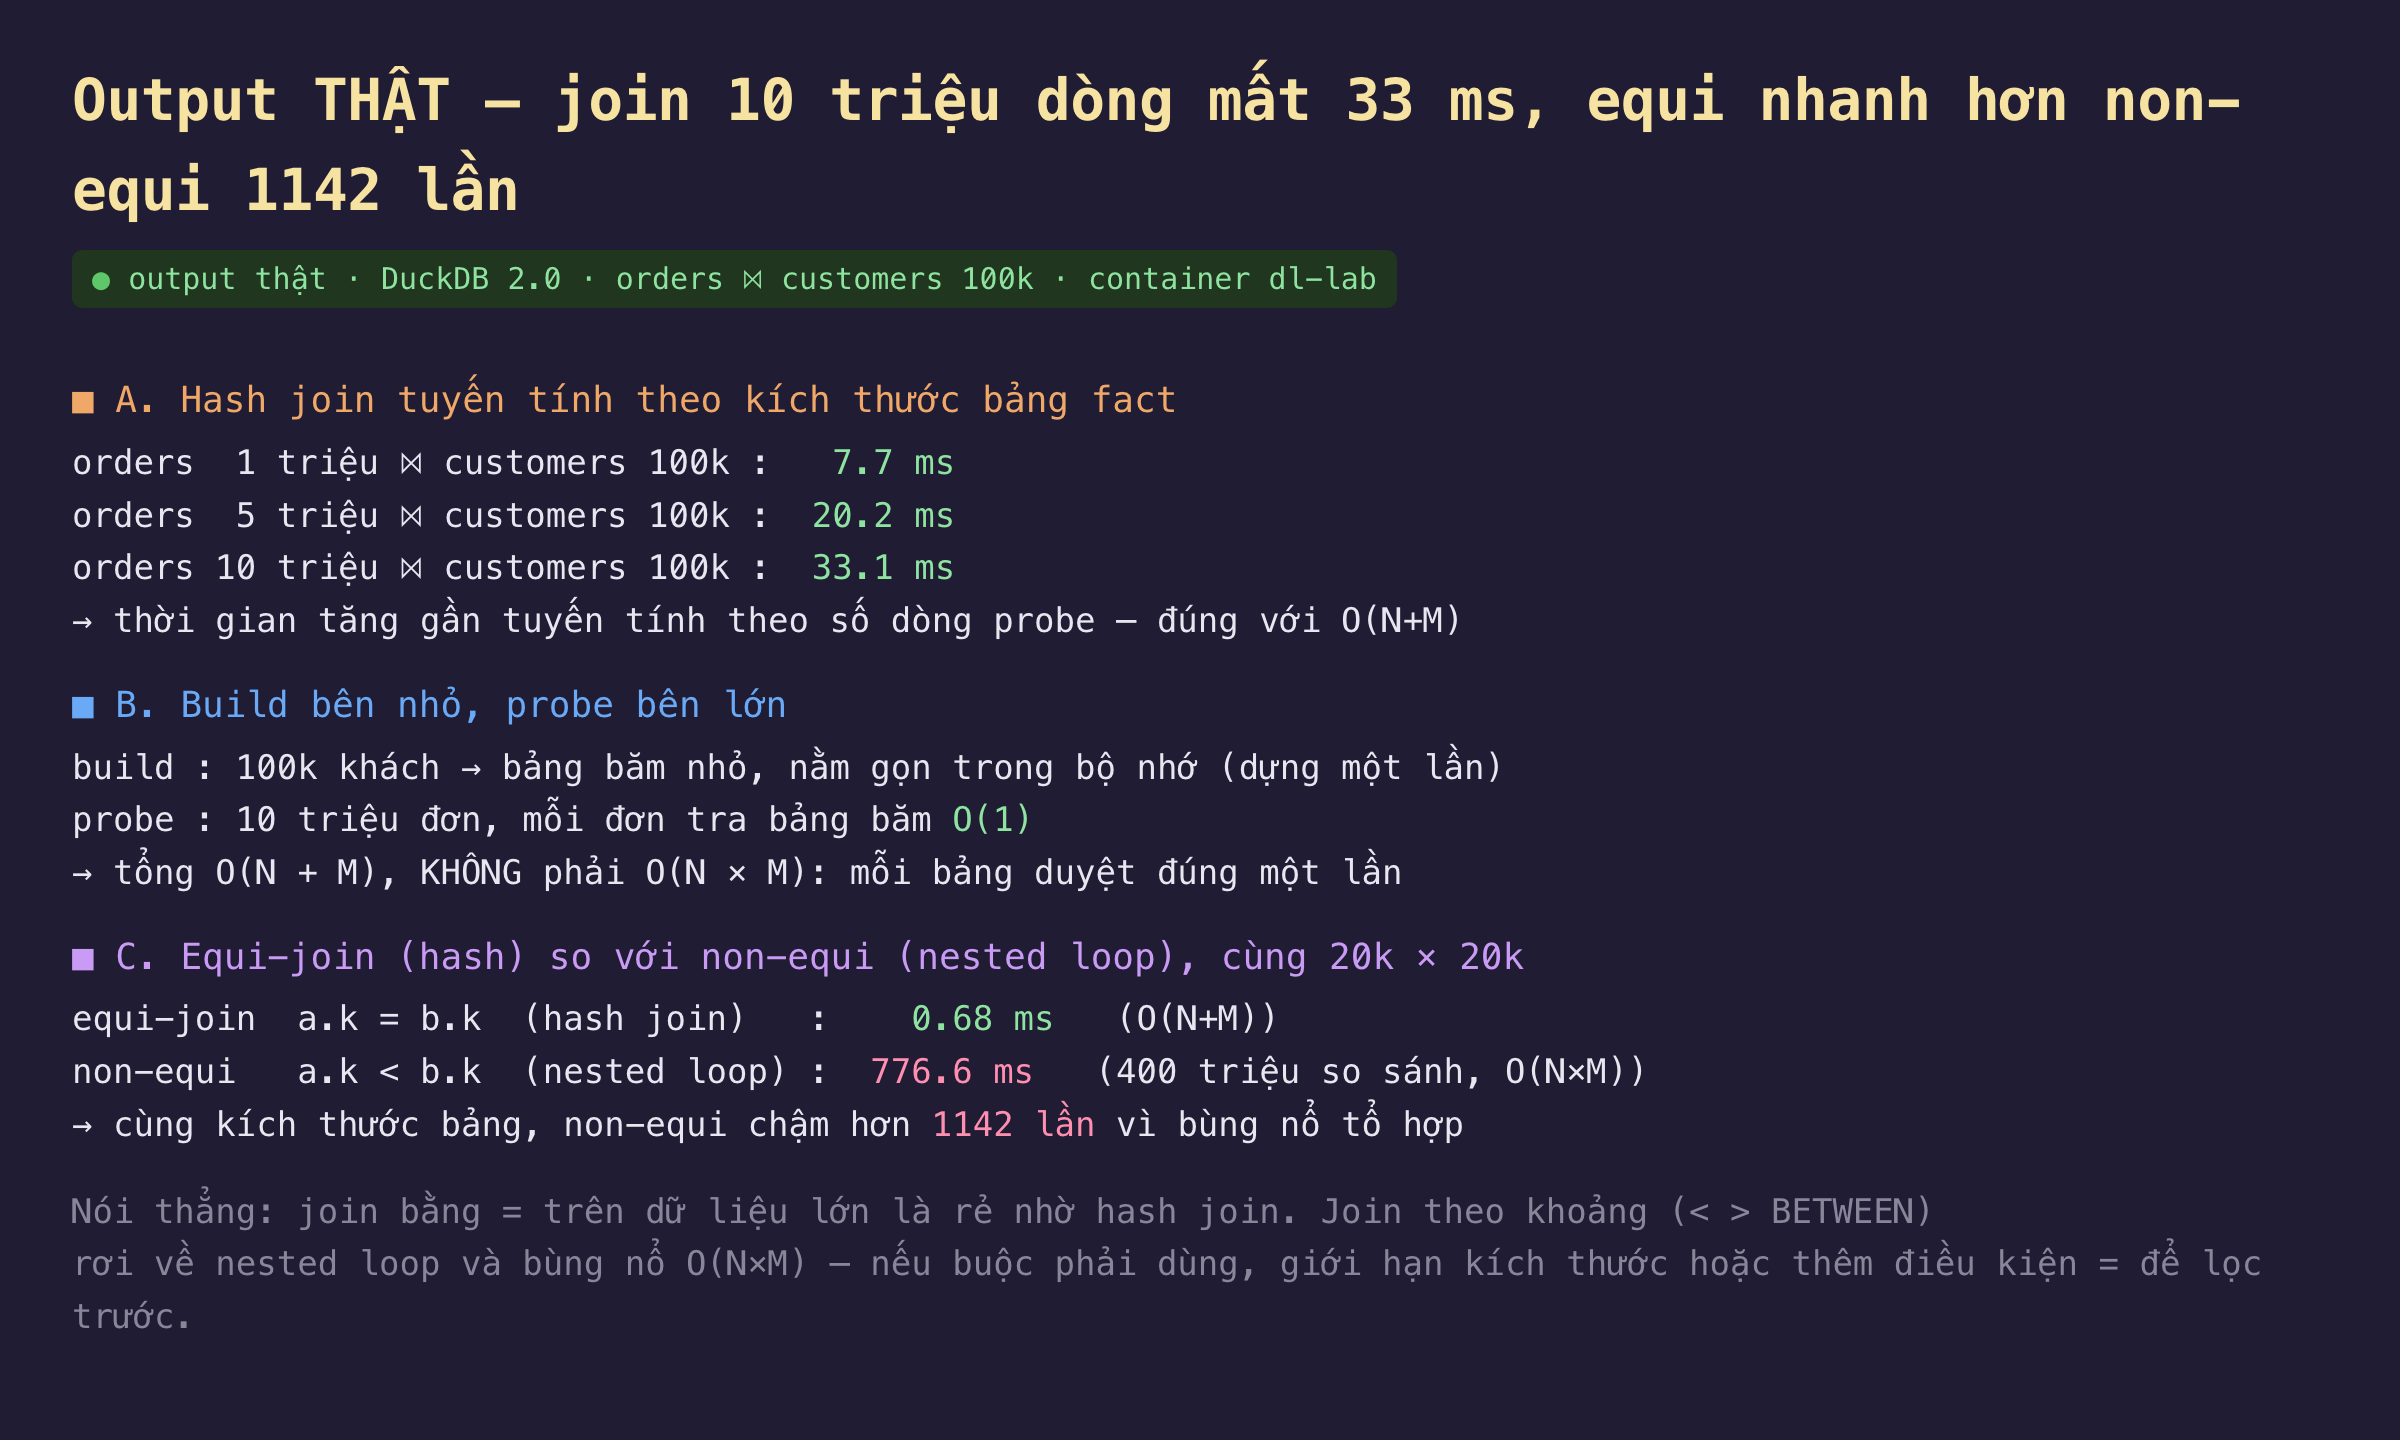
Hình 2: Hash join tuyến tính theo kích thước fact, và equi-join nhanh hơn non-equi 1142 lần trên cùng hai bảng.
| phép đo | kết quả |
|---|---|
| orders 1 triệu ⨝ customers 100k | 7,7 ms |
| orders 5 triệu ⨝ customers 100k | 20,2 ms |
| orders 10 triệu ⨝ customers 100k | 33,1 ms |
| equi-join 20k × 20k (hash) | 0,68 ms |
| non-equi 20k × 20k (nested loop) | 776,6 ms |
Hash join tuyến tính theo kích thước bảng fact. Join bảng đơn hàng với bảng khách hàng một trăm nghìn dòng mất 7,7 ms ở một triệu đơn, 20,2 ms ở năm triệu, và 33,1 ms ở mười triệu. Thời gian tăng gần tuyến tính theo số dòng bên probe, đúng với độ phức tạp O(N cộng M): bên build một trăm nghìn khách là cố định, còn chi phí chính là duyệt qua bảng đơn hàng, mỗi đơn một lần tra bảng băm. Join mười triệu dòng trong 33 ms là con số cho thấy ghép bảng lớn không phải thao tác đắt nếu dùng đúng thuật toán; nó chỉ nhanh hơn một chút so với quét đơn thuần bảng đó.
Build trên bên nhỏ, probe bằng bên lớn, mỗi bảng duyệt một lần. Bước build dựng bảng băm trên một trăm nghìn khách, cho một bảng băm nhỏ nằm gọn trong bộ nhớ, và chỉ dựng một lần. Bước probe duyệt mười triệu đơn, mỗi đơn tra bảng băm trong thời gian O(1) để tìm khách tương ứng. Tổng công là O(N cộng M), không phải O(N nhân M): cả hai bảng được duyệt đúng một lần, không có vòng lặp lồng nhau nào so sánh mọi cặp. Đây là bản chất khiến hash join thắng: nó đổi một chút bộ nhớ cho bảng băm lấy việc biến phép tìm kiếm từ duyệt tuyến tính thành tra cứu hằng số.
Equi-join nhanh hơn non-equi 1142 lần trên cùng kích thước bảng. Phép đo tương phản rõ nhất. Trên hai bảng hai mươi nghìn dòng, equi-join theo điều kiện bằng dùng hash join mất 0,68 ms. Cùng hai bảng đó, một non-equi join theo điều kiện nhỏ hơn buộc engine dùng kiểu nested loop, so sánh bốn trăm triệu cặp, và mất 776,6 ms, chậm hơn một nghìn một trăm bốn mươi hai lần. Khác biệt không nằm ở dữ liệu mà ở điều kiện join: bằng thì băm được và O(N cộng M), còn khoảng thì không băm được và O(N nhân M). Đây là lời cảnh báo thực tế: một thay đổi nhỏ trong điều kiện join, từ dấu bằng sang dấu nhỏ hơn, có thể biến một truy vấn tức thì thành một truy vấn chậm hàng nghìn lần.
Đánh đổi cần cân nhắc
Ưu tiên equi-join; nếu buộc join theo khoảng, giới hạn kích thước hoặc lọc trước. Kết luận thực hành rõ ràng: thiết kế truy vấn để join theo điều kiện bằng bất cứ khi nào có thể, vì đó là đường cho hash join phát huy. Khi bài toán thật sự cần join theo khoảng, ví dụ ghép một sự kiện với khoảng thời gian hiệu lực của một bản ghi, hãy giảm thiểu bùng nổ bằng cách thêm một điều kiện bằng để lọc trước, như join theo id rồi mới lọc theo khoảng, hoặc giới hạn kích thước hai bảng tham gia. Một số engine có tối ưu riêng cho range join, nhưng nguyên lý chung là tránh để hai bảng lớn gặp nhau qua một điều kiện không băm được.
Bên build nên là bảng nhỏ; thường engine tự chọn, nhưng cần biết. DuckDB và các engine tốt tự ước lượng kích thước và chọn bên nhỏ làm build, nhưng khi ước lượng sai, ví dụ thống kê lỗi thời hoặc kết quả trung gian lớn ngoài dự đoán, engine có thể build trên bên lớn và tốn nhiều bộ nhớ hơn. Hiểu rằng bảng băm được dựng trên một bên giúp lý giải vì sao một join đôi khi ngốn bộ nhớ bất ngờ, và gợi ý cách sửa: lọc bớt bên sẽ thành build trước khi join, hoặc cập nhật thống kê để engine ước lượng đúng. Với join nhiều bảng, thứ tự join cũng ảnh hưởng, vì kết quả trung gian của join này là đầu vào của join kia.
Phạm vi đo. Bài đo join một fact với một dimension theo một khoá, trên dữ liệu vừa trong bộ nhớ. Khi bên build lớn hơn bộ nhớ, hash join phải tràn ra đĩa và chia thành nhiều phần, làm chậm hơn, chủ đề của phần về xử lý dữ liệu lớn hơn RAM sau. Bài không đo join nhiều bảng với thứ tự join tối ưu, không đo các kiểu join khác như left, full outer, và chỉ chạm tới range join qua một ví dụ cực đoan; những tình huống này có sắc thái riêng nhưng không đổi kết luận cốt lõi về hash join so với nested loop.
Ba ý mang về
- Hash join ghép bảng lớn theo O(N+M), tuyến tính theo kích thước. Join mười triệu đơn với một trăm nghìn khách mất 33 ms; dựng bảng băm trên bên nhỏ rồi dò bằng bên lớn, mỗi bảng duyệt một lần.
- Hash join chỉ dùng cho điều kiện bằng. Join theo khoảng rơi về nested loop O(N×M); trên hai bảng hai mươi nghìn dòng, non-equi chậm hơn equi 1142 lần vì bùng nổ tổ hợp.
- Thiết kế truy vấn quanh equi-join. Ưu tiên join theo dấu bằng; nếu phải join theo khoảng, thêm điều kiện bằng để lọc trước hoặc giới hạn kích thước hai bảng.
Nguồn
- DuckDB — Join Operations, hash join và các kiểu join: https://duckdb.org/docs/sql/query_syntax/from
- DuckDB — Why DuckDB, join được vectorized: https://duckdb.org/why_duckdb
- Goetz Graefe — Query Evaluation Techniques for Large Databases, thuật toán join: https://dl.acm.org/doi/10.1145/152610.152611
- Wikipedia — Hash join, build và probe: https://en.wikipedia.org/wiki/Hash_join
- DuckDB — Performance Guide, join order và thống kê: https://duckdb.org/docs/guides/performance/overview
Phần sau đo kỹ hơn thao tác aggregation theo nhóm: GROUP BY trên nhiều triệu dòng theo một hay nhiều khoá. Xem thời gian thay đổi thế nào theo số nhóm và số khoá nhóm, và vì sao aggregation theo hash cũng tuyến tính như hash join thay vì phải sắp xếp toàn bộ dữ liệu.
