Phần 7 đo hash join và thấy nó tuyến tính nhờ bảng băm. Phần này đo thao tác họ hàng với join và cũng dùng bảng băm: GROUP BY, trái tim của mọi báo cáo tổng hợp. Có một hiểu lầm phổ biến rằng GROUP BY phải sắp xếp dữ liệu theo khoá nhóm trước khi gộp, nên nó đắt như một phép sắp xếp. Thực tế, engine phân tích hiện đại gộp nhóm bằng hash aggregation một lượt, không cần sắp xếp, nên chi phí phụ thuộc số nhóm khác nhau chứ không phải phải xếp thứ tự toàn bộ. Bài này đo trực tiếp: thời gian GROUP BY theo số nhóm, theo số khoá nhóm, và so hash aggregation với sắp xếp toàn bộ để thấy chênh lệch thật.
Gom nhóm bằng bảng băm, không cần sắp xếp trước
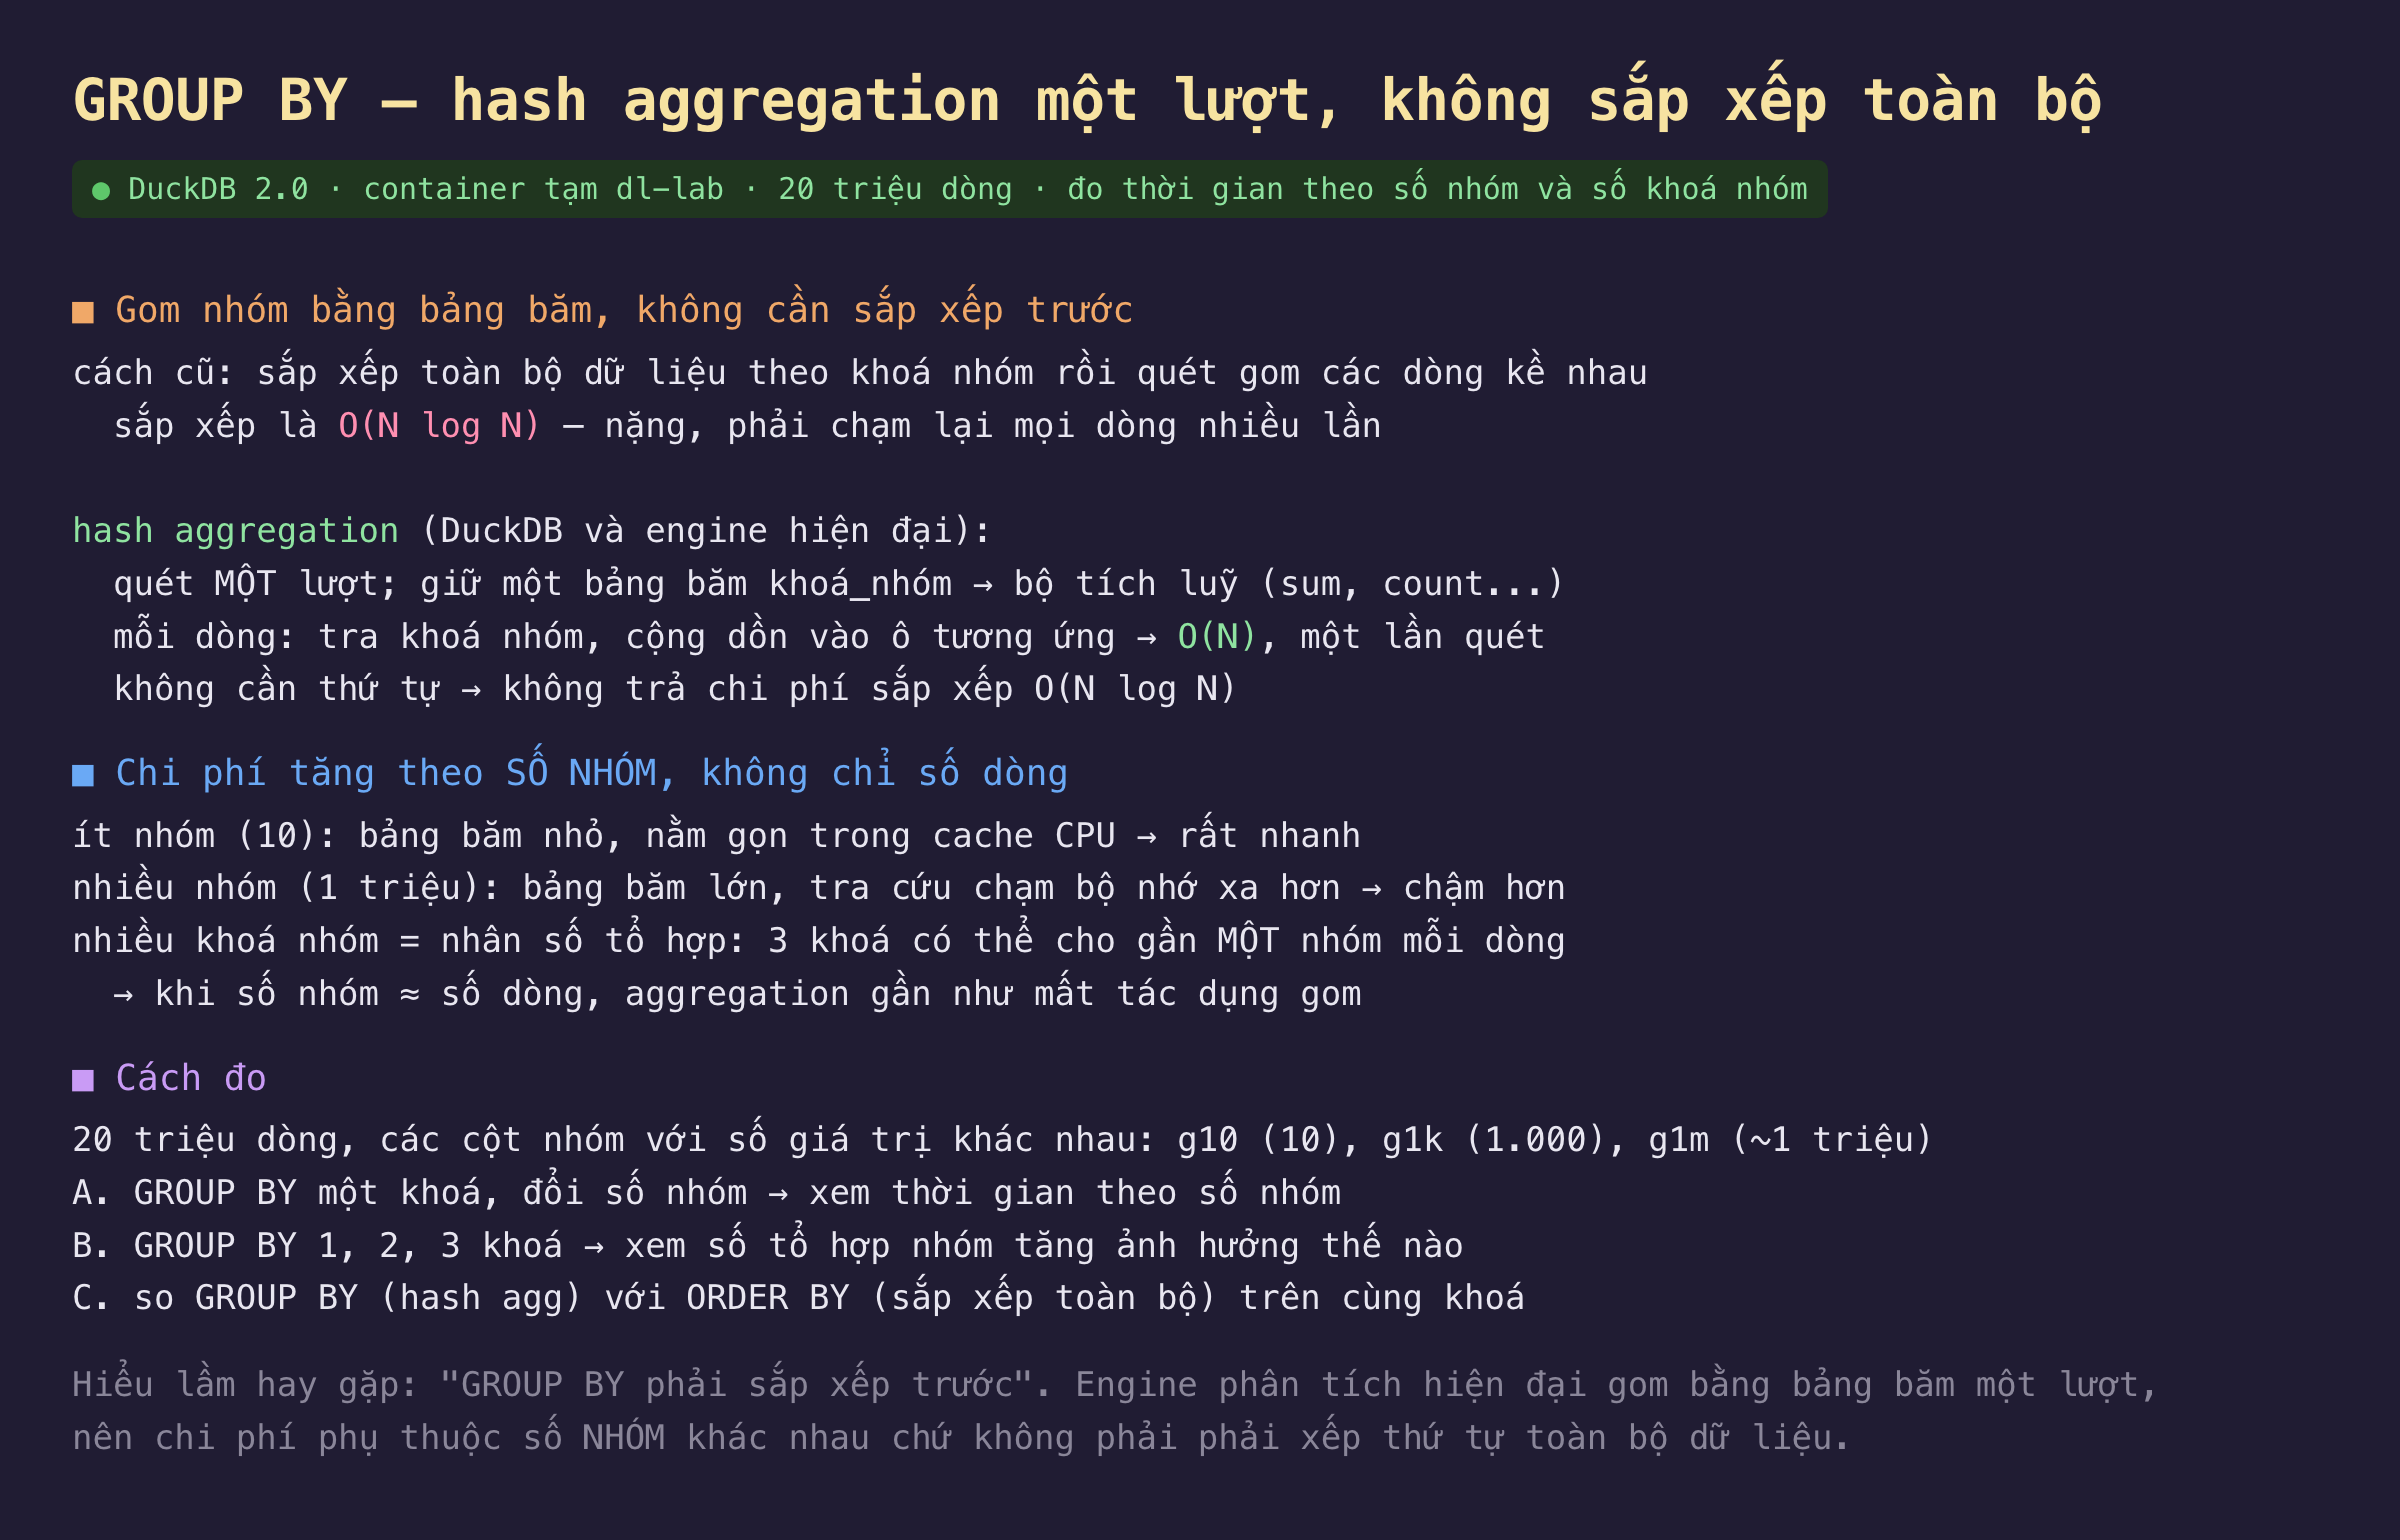
Hình 1: Hash aggregation gộp nhóm bằng bảng băm một lượt O(N), không sắp xếp; chi phí phụ thuộc số nhóm khác nhau.
Cách gộp nhóm theo lối cũ là sắp xếp toàn bộ dữ liệu theo khoá nhóm rồi quét gộp các dòng có cùng khoá nằm kề nhau. Cách này đúng về kết quả nhưng tốn kém: sắp xếp là O(N log N), phải chạm lại mọi dòng nhiều lần để đưa về thứ tự. Với dữ liệu lớn, chi phí sắp xếp này chiếm phần lớn thời gian, trong khi việc gộp thật ra chỉ cần cộng dồn.
Hash aggregation, cách mà DuckDB và các engine hiện đại dùng, bỏ qua bước sắp xếp. Nó quét dữ liệu một lượt và giữ một bảng băm ánh xạ từ khoá nhóm sang bộ tích lũy, ví dụ tổng và số đếm đang chạy của nhóm đó. Với mỗi dòng, engine tra khoá nhóm trong bảng băm và cộng dồn giá trị vào ô tương ứng. Toàn bộ là một lần quét, độ phức tạp O(N), và không cần thứ tự nào cả, nên không phải trả chi phí sắp xếp O(N log N). Đây là cùng ý tưởng với hash join ở phần trước: đổi một chút bộ nhớ cho bảng băm lấy việc biến một bài toán tưởng cần sắp xếp thành một lần quét tuyến tính.
Hệ quả quan trọng về chi phí: nó tăng theo số nhóm khác nhau, không chỉ theo số dòng. Khi ít nhóm, như mười nhóm, bảng băm nhỏ và nằm gọn trong cache CPU nên tra cứu rất nhanh. Khi nhiều nhóm, như một triệu, bảng băm lớn và tra cứu phải chạm tới bộ nhớ ở xa hơn, chậm hơn. GROUP BY nhiều khoá nhân số tổ hợp lên: ba khoá có thể cho gần một nhóm riêng cho mỗi dòng, và khi số nhóm xấp xỉ số dòng thì aggregation gần như mất tác dụng gộp vì không có gì để cộng dồn. Cách đo: hai mươi triệu dòng với các cột nhóm có số giá trị khác nhau, g10 mười giá trị, g1k một nghìn, g1m khoảng một triệu; đo GROUP BY một khoá theo số nhóm; GROUP BY một, hai, ba khoá; và so GROUP BY dùng hash aggregation với ORDER BY sắp xếp toàn bộ trên cùng khoá.
Đo thật: hash aggregation nhanh hơn sắp xếp 8 lần
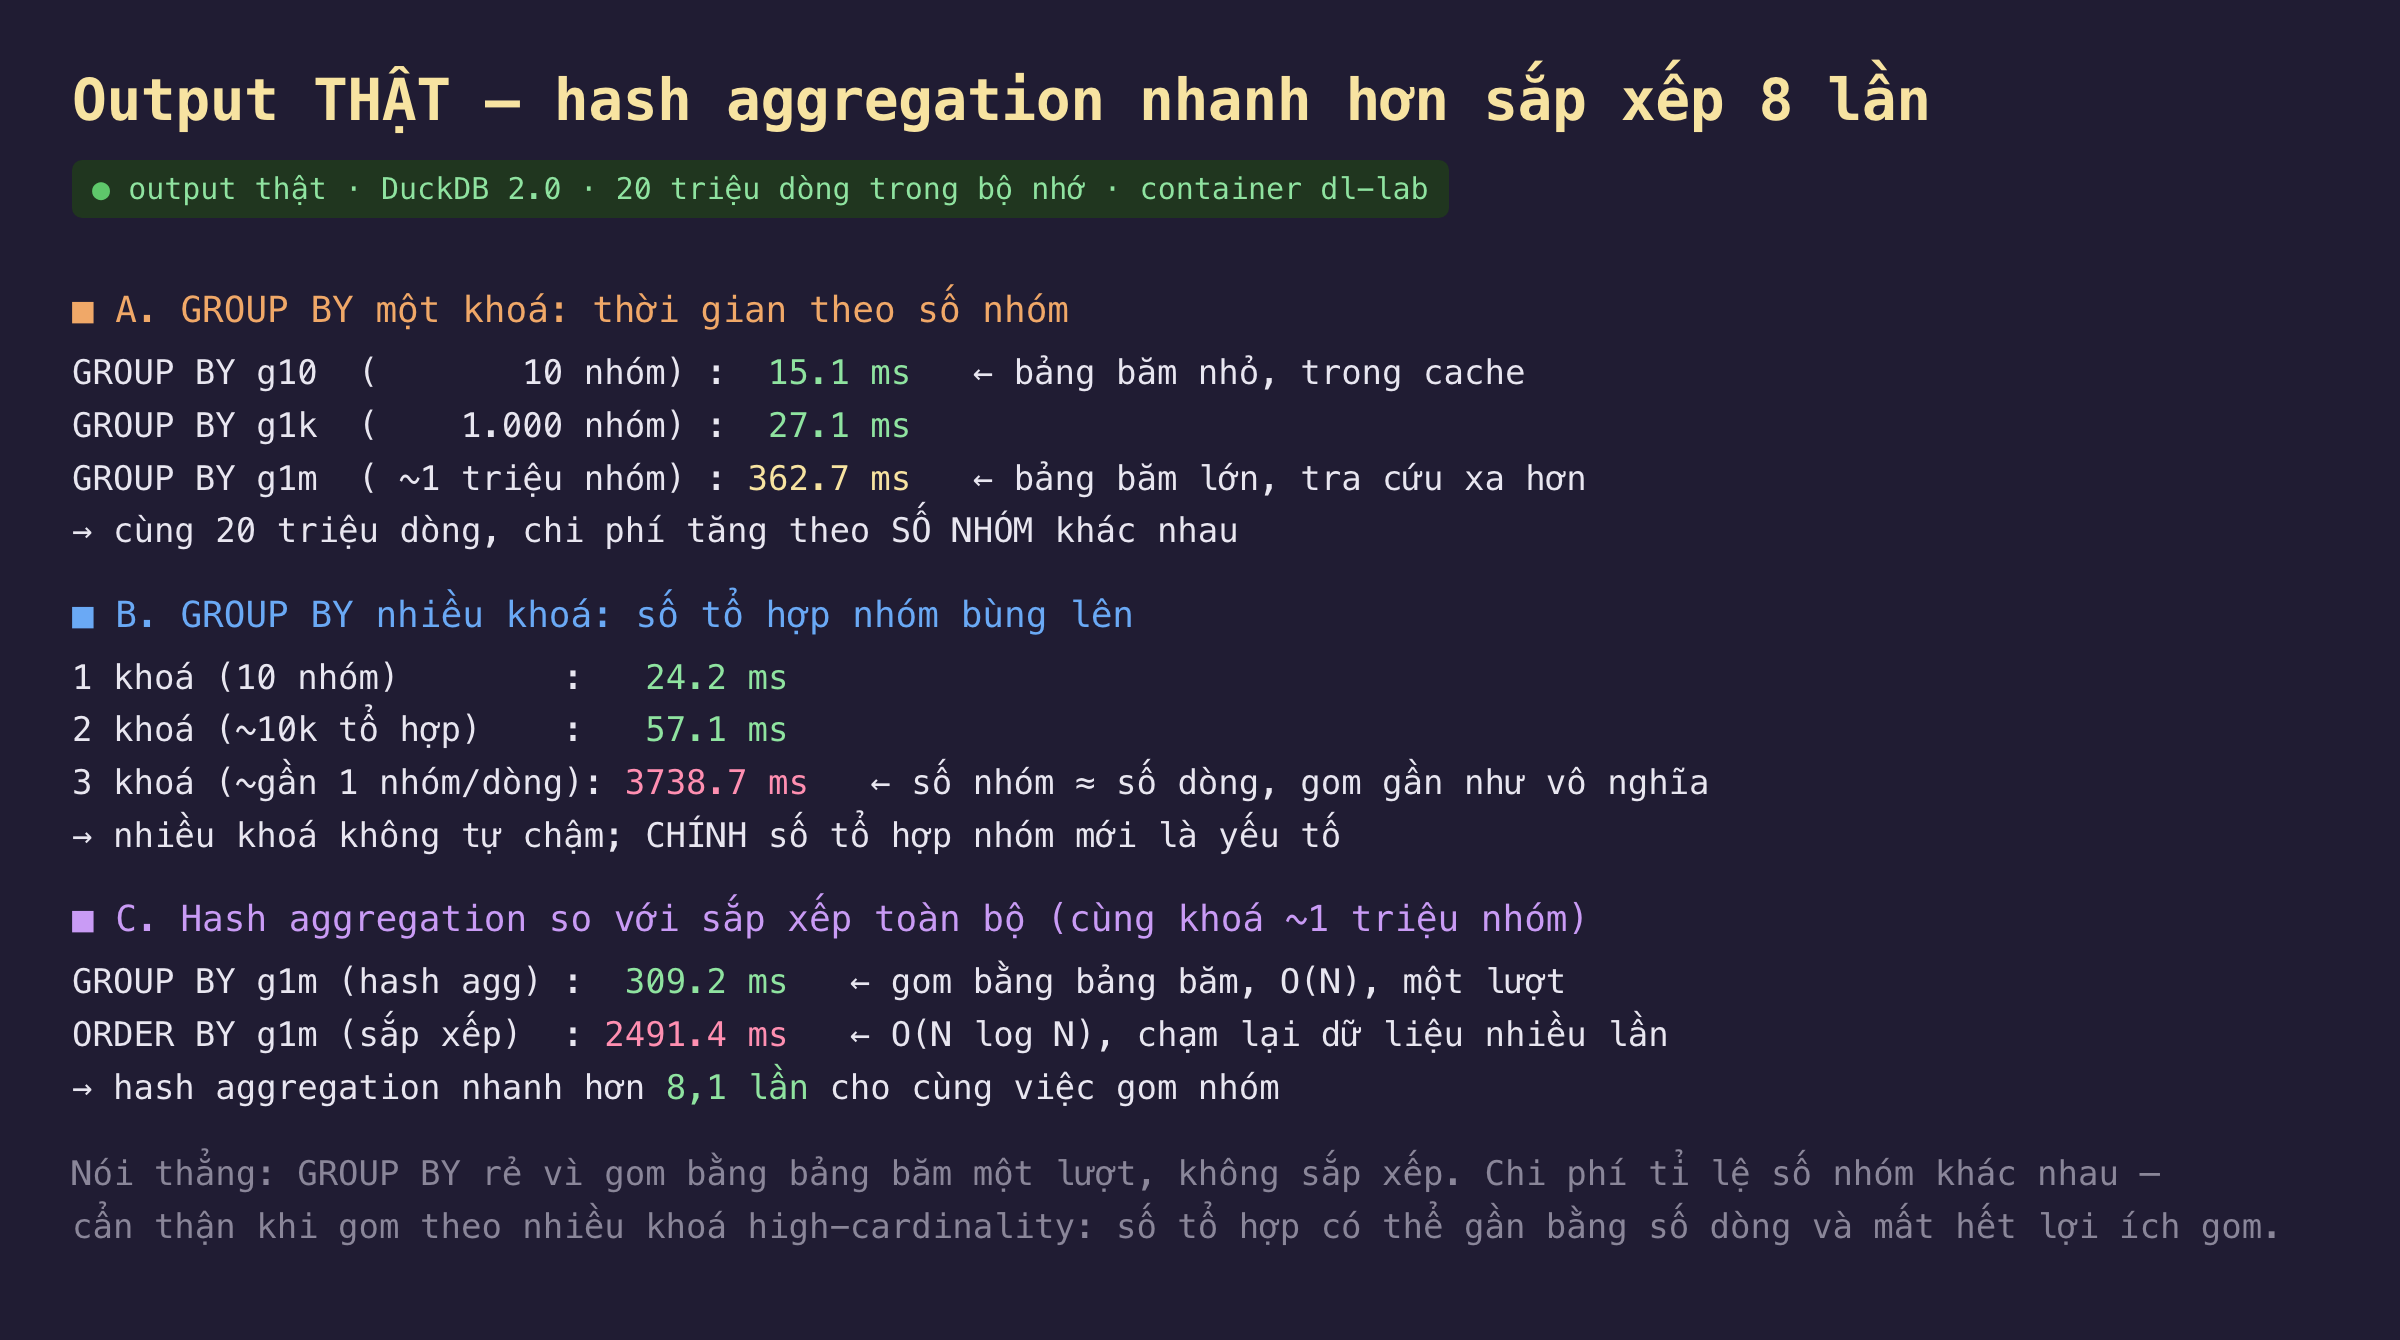
Hình 2: Thời gian GROUP BY theo số nhóm và số khoá, và hash aggregation nhanh hơn sắp xếp toàn bộ 8 lần.
| phép đo | kết quả |
|---|---|
| GROUP BY 10 nhóm | 15,1 ms |
| GROUP BY 1000 nhóm | 27,1 ms |
| GROUP BY ~1 triệu nhóm | 362,7 ms |
| GROUP BY 3 khoá (~gần 1 nhóm/dòng) | 3738,7 ms |
| hash aggregation ~1 triệu nhóm | 309,2 ms |
| sắp xếp toàn bộ cùng khoá | 2491,4 ms |
Chi phí GROUP BY tăng theo số nhóm, không chỉ số dòng. Trên cùng hai mươi triệu dòng, gộp theo cột mười nhóm mất 15,1 ms, theo cột một nghìn nhóm mất 27,1 ms, và theo cột khoảng một triệu nhóm mất 362,7 ms. Số dòng không đổi, chỉ số nhóm thay đổi, mà thời gian chênh hơn hai mươi lần. Lý do là kích thước bảng băm: mười nhóm cho một bảng băm nhỏ nằm trong cache CPU, tra cứu gần như tức thì; một triệu nhóm cho một bảng băm lớn phải trải ra bộ nhớ chính, và mỗi lần tra cứu có thể trượt cache, chạm tới RAM chậm hơn. Đây là điểm cần nhớ khi ước lượng chi phí một truy vấn tổng hợp: hãy nghĩ tới số nhóm kết quả, không chỉ số dòng đầu vào.
Nhiều khoá nhóm không tự làm chậm; chính số tổ hợp nhóm mới là yếu tố. Gộp theo một khoá với mười nhóm mất 24,2 ms, theo hai khoá với khoảng mười nghìn tổ hợp mất 57,1 ms, nhưng theo ba khoá mất tới 3738,7 ms. Bước nhảy lớn ở ba khoá không phải vì có thêm một khoá mà vì số tổ hợp nhóm bùng lên tới mức gần bằng số dòng: khi mỗi dòng rơi vào một nhóm gần như riêng, bảng băm phình to gần bằng toàn bộ dữ liệu và việc gộp gần như không còn cộng dồn được gì. Đây là một bẫy thực tế: thêm một cột vào GROUP BY tưởng vô hại nhưng nếu cột đó high-cardinality, nó có thể biến một truy vấn nhanh thành chậm, không phải vì khoá mà vì số nhóm kết quả tăng vọt.
Hash aggregation nhanh hơn sắp xếp toàn bộ 8 lần cho cùng việc gộp. So trực tiếp trên cùng khoá khoảng một triệu nhóm: GROUP BY dùng hash aggregation mất 309,2 ms, còn ORDER BY sắp xếp toàn bộ dữ liệu theo khoá đó mất 2491,4 ms, chậm hơn tám phẩy một lần. Đây là bằng chứng cho điểm cốt lõi: gộp nhóm bằng bảng băm một lượt O(N) rẻ hơn hẳn so với sắp xếp O(N log N). Sắp xếp phải chạm lại dữ liệu nhiều lần để đưa về thứ tự, trong khi hash aggregation chỉ quét một lần và cộng dồn. Đây là lý do một báo cáo GROUP BY thường nhanh hơn trực giác, và vì sao nghĩ rằng gộp nhóm đắt như sắp xếp là một hiểu lầm cần gỡ.
Đánh đổi cần cân nhắc
Cẩn thận khi gộp theo nhiều khoá high-cardinality. Bài học thực hành rõ nhất: trước khi thêm một cột vào GROUP BY, cân nhắc nó có bao nhiêu giá trị khác nhau và sẽ làm số nhóm kết quả tăng tới đâu. Gộp theo quốc gia và tháng cho số nhóm nhỏ, an toàn; gộp thêm theo id người dùng hay id phiên có thể đẩy số nhóm lên gần số dòng và làm truy vấn chậm hẳn, lại cho kết quả gần như không tổng hợp gì. Khi cần chi tiết tới mức gần một dòng một nhóm, có lẽ bài toán thật không phải tổng hợp mà là lọc hoặc liệt kê, và nên diễn đạt lại truy vấn cho đúng.
Hash aggregation nhanh nhưng tốn bộ nhớ theo số nhóm. Đánh đổi của hash aggregation là bảng băm phải chứa mọi nhóm đang gộp, nên bộ nhớ dùng tỉ lệ với số nhóm khác nhau. Với số nhóm vừa phải, bảng băm nhỏ và không thành vấn đề; với số nhóm rất lớn, bảng băm có thể vượt bộ nhớ và buộc engine tràn ra đĩa, làm chậm, tương tự hash join. DuckDB xử lý được tình huống này nhưng với cái giá hiệu năng. Khi một truy vấn gộp theo cột high-cardinality chạy chậm bất ngờ, số nhóm lớn và bảng băm tràn đĩa là nghi phạm đáng kiểm, và cách sửa thường là lọc bớt trước khi gộp hoặc giảm độ chi tiết của nhóm.
Phạm vi đo. Bài đo trên dữ liệu vừa trong bộ nhớ, nên không đo trường hợp bảng băm tràn đĩa khi số nhóm quá lớn. Thời gian phụ thuộc kiểu khoá nhóm; khoá số nguyên băm nhanh hơn khoá chuỗi dài. Bài không đo các hàm tổng hợp đắt hơn sum và count, như median hay string_agg, vốn giữ nhiều trạng thái hơn cho mỗi nhóm và làm bảng băm lớn hơn. Cũng chưa đo tối ưu của DuckDB khi gộp song song nhiều luồng rồi hợp nhất, một yếu tố giúp aggregation tận dụng nhiều lõi.
Ba ý mang về
- GROUP BY gộp bằng bảng băm một lượt O(N), không sắp xếp. Hash aggregation quét một lần, cộng dồn vào bảng băm khoá nhóm; nhanh hơn sắp xếp toàn bộ O(N log N) tám lần trên một triệu nhóm.
- Chi phí tăng theo số nhóm khác nhau, không chỉ số dòng. Trên hai mươi triệu dòng: mười nhóm 15 ms, một triệu nhóm 363 ms; bảng băm lớn hơn thì tra cứu chạm bộ nhớ xa hơn.
- Nhiều khoá nhóm nguy hiểm khi tổ hợp high-cardinality. Ba khoá cho gần một nhóm mỗi dòng và mất 3738 ms; chính số tổ hợp nhóm, không phải số khoá, làm truy vấn chậm.
Nguồn
- DuckDB — Aggregate Functions và GROUP BY: https://duckdb.org/docs/sql/aggregates
- DuckDB — Why DuckDB, hash aggregation được vectorized: https://duckdb.org/why_duckdb
- Goetz Graefe — Query Evaluation Techniques for Large Databases, hash vs sort aggregation: https://dl.acm.org/doi/10.1145/152610.152611
- Wikipedia — Hash table, tra cứu O(1) trung bình: https://en.wikipedia.org/wiki/Hash_table
- DuckDB — Performance Guide, cardinality và aggregation: https://duckdb.org/docs/guides/performance/overview
Phần sau đo một cách tổ chức dữ liệu giúp bỏ qua cả thư mục: Hive partitioning. Thay vì một file lớn, dữ liệu được chia thành nhiều thư mục theo giá trị một cột, như theo ngày hay theo quốc gia. Xem truy vấn có điều kiện lọc bỏ qua được các thư mục không liên quan thế nào, và khi nào phân vùng giúp hay lại gây hại vì quá nhiều file nhỏ.
