Phần 3 cho thấy predicate pushdown bỏ qua row group trong một file. Phần này đo một cơ chế tương tự nhưng ở mức cao hơn, mức thư mục: Hive partitioning. Thay vì một file lớn, dữ liệu được chia thành nhiều thư mục theo giá trị một cột, ví dụ mỗi quốc gia một thư mục. Khi truy vấn lọc theo cột đó, engine chỉ cần mở đúng thư mục liên quan và bỏ qua toàn bộ các thư mục khác, không đọc một byte nào của chúng. Đây là công cụ tổ chức dữ liệu phổ biến trong hồ dữ liệu, nhưng là con dao hai lưỡi: phân vùng đúng cách tăng tốc lớn, phân vùng sai cách lại gây ra vấn đề file nhỏ làm chậm hẳn. Bài này đo cả ba mặt: khi phân vùng giúp, khi không giúp, và khi gây hại.
Phân vùng là đưa giá trị cột vào tên thư mục
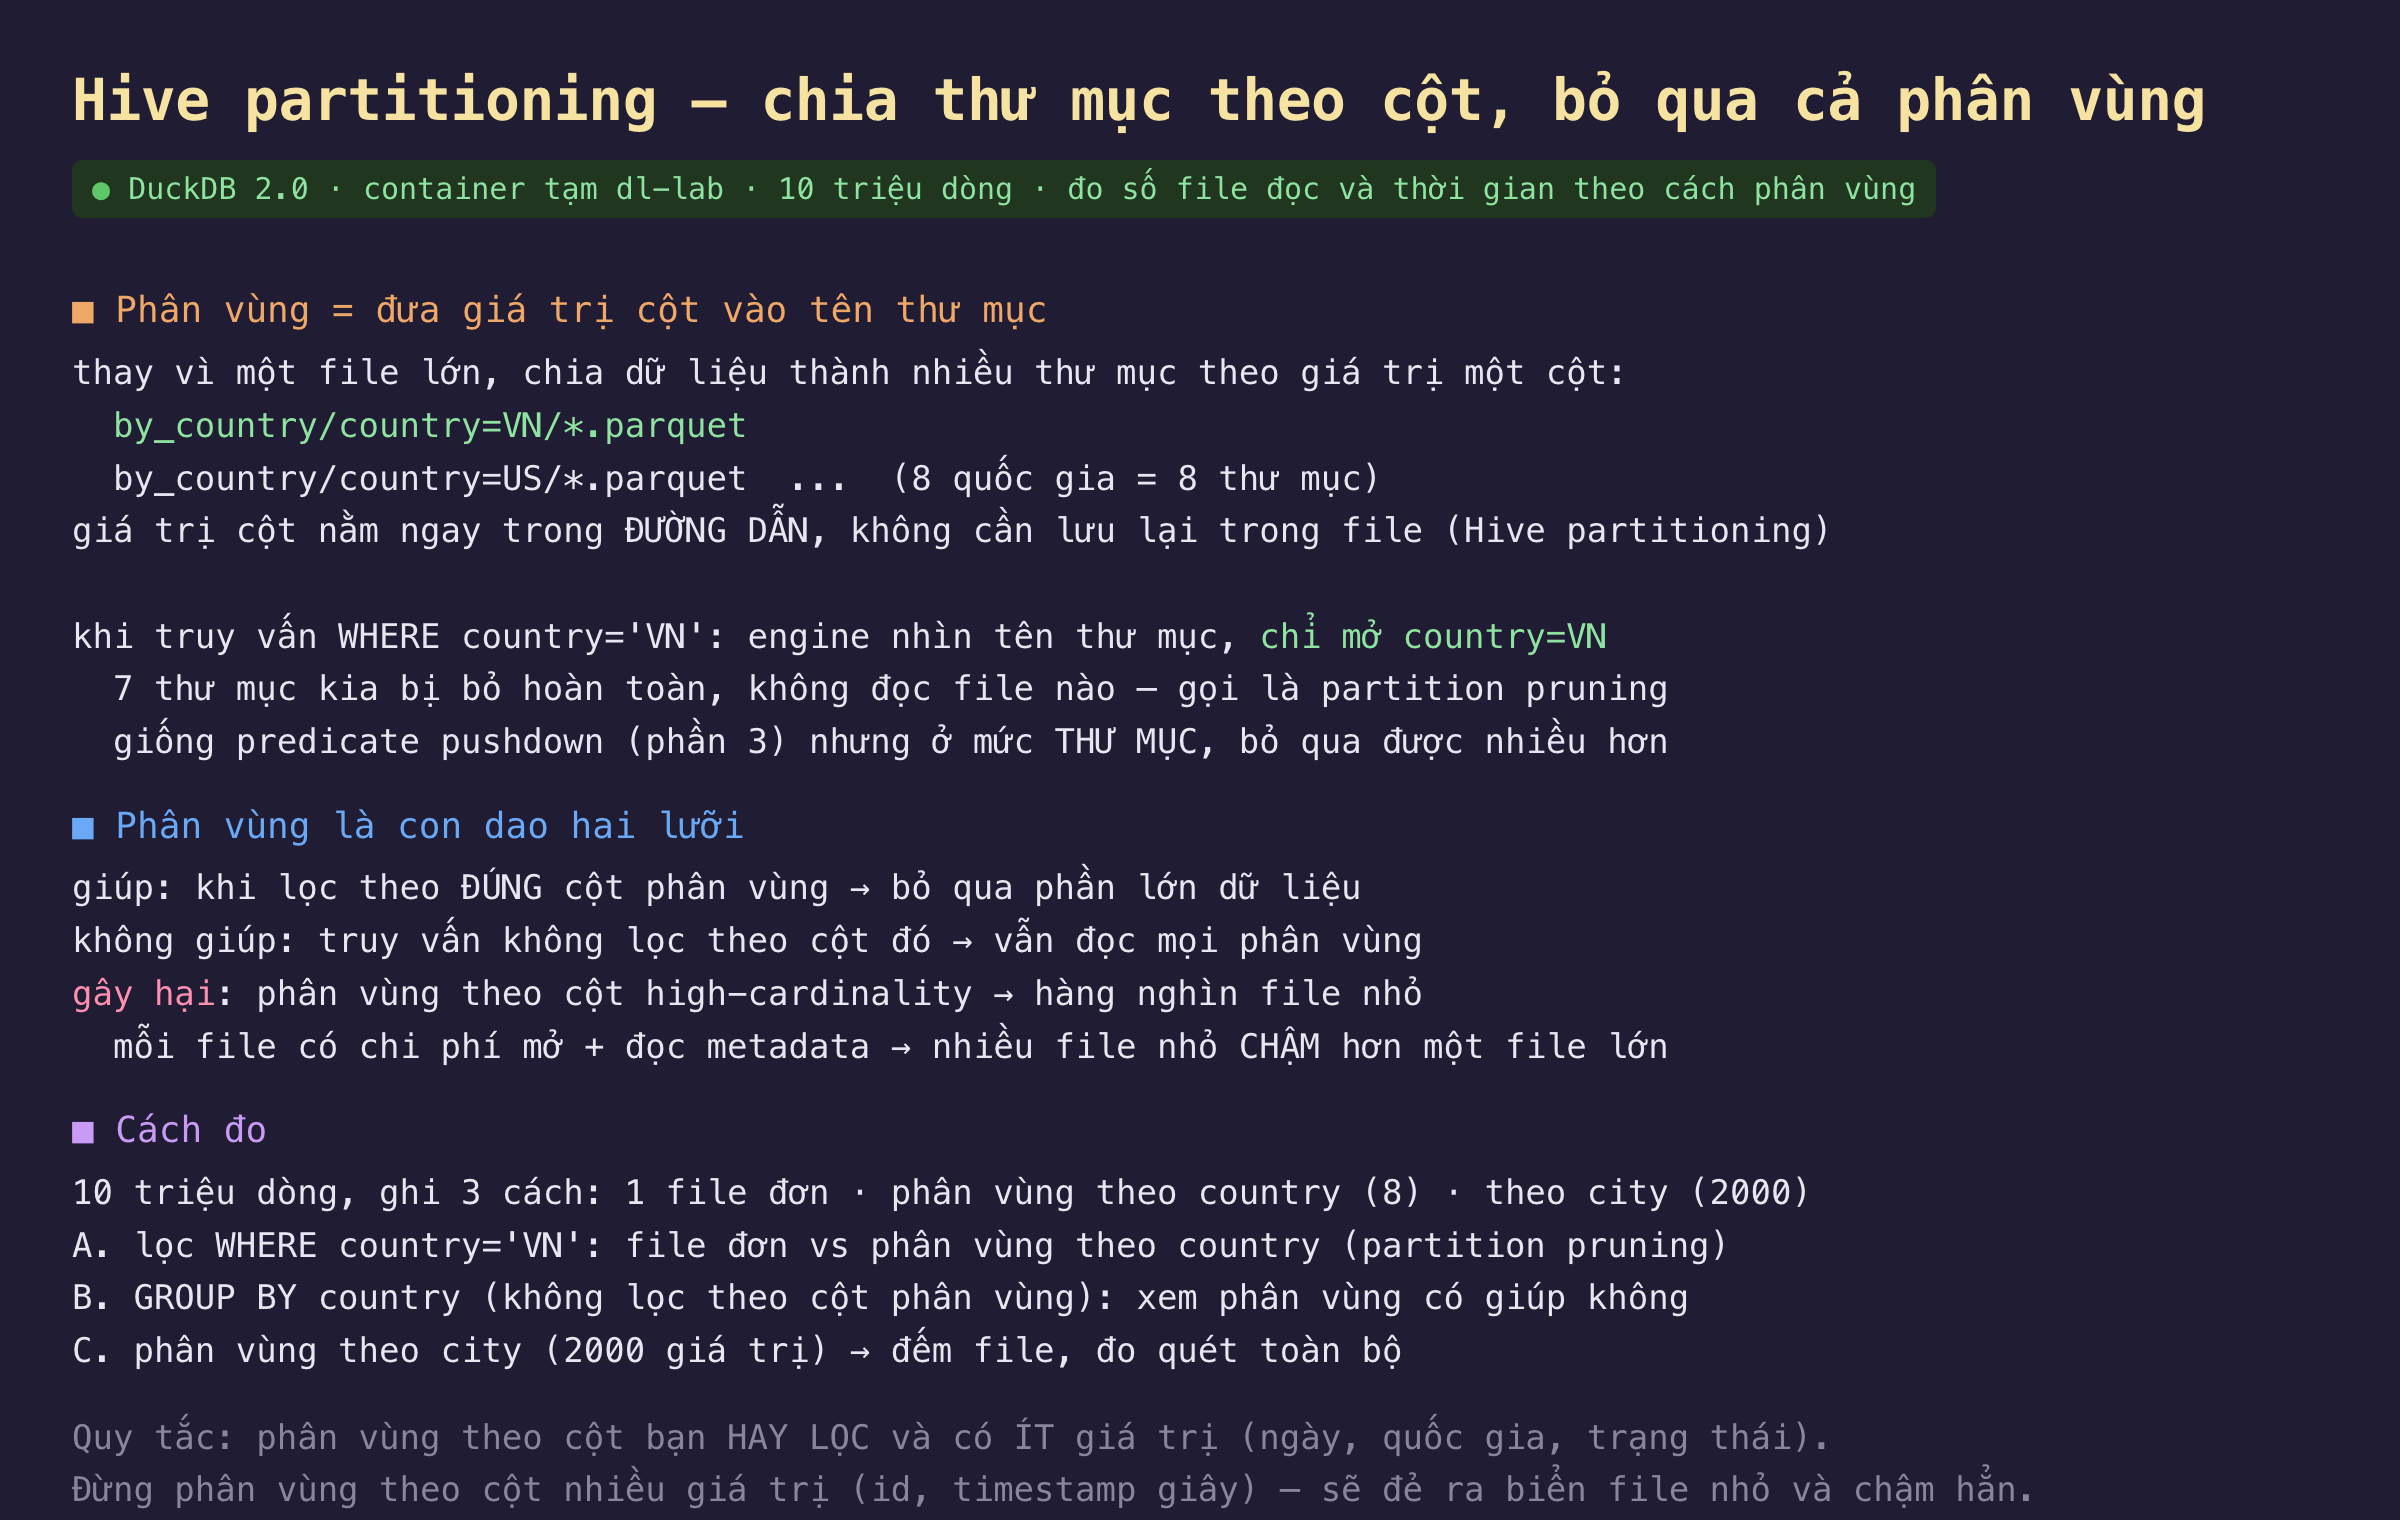
Hình 1: Hive partitioning chia dữ liệu thành thư mục theo giá trị cột; lọc theo cột đó bỏ qua cả thư mục, nhưng quá nhiều phân vùng gây vấn đề file nhỏ.
Hive partitioning là cách tổ chức đưa giá trị của một cột vào chính tên thư mục. Thay vì một file lớn, dữ liệu được chia thành các thư mục như by_country/country=VN, by_country/country=US, mỗi quốc gia một thư mục; với tám quốc gia là tám thư mục. Giá trị của cột phân vùng nằm ngay trong đường dẫn, nên thậm chí không cần lưu lại trong file, tiết kiệm thêm chỗ. Đây là quy ước đặt tên chuẩn mà nhiều công cụ hiểu được.
Lợi ích đến khi truy vấn lọc theo cột phân vùng. Với WHERE country='VN', engine nhìn tên thư mục và chỉ mở country=VN, bỏ hoàn toàn bảy thư mục còn lại mà không đọc file nào trong chúng. Đây gọi là partition pruning, cùng ý tưởng với predicate pushdown ở phần 3 nhưng hoạt động ở mức thư mục, nên bỏ qua được nhiều dữ liệu hơn trong một bước. Thay vì đọc cả file rồi lọc, engine loại bỏ cả khối dữ liệu trước khi chạm tới chúng.
Nhưng phân vùng là con dao hai lưỡi. Nó giúp khi lọc theo đúng cột phân vùng, bỏ qua được phần lớn dữ liệu. Nó không giúp khi truy vấn không lọc theo cột đó, vì khi ấy vẫn phải đọc mọi phân vùng. Và nó gây hại khi phân vùng theo cột high-cardinality: chia theo một cột có hàng nghìn giá trị tạo ra hàng nghìn file nhỏ, và mỗi file có chi phí cố định để mở và đọc metadata, nên nhiều file nhỏ lại chậm hơn một file lớn. Cách đo: mười triệu dòng ghi ba cách, một file đơn, phân vùng theo country tám giá trị, phân vùng theo city hai nghìn giá trị; đo lọc WHERE country='VN' giữa file đơn và phân vùng theo country; đo GROUP BY country không lọc theo cột phân vùng; và đo quét toàn bộ trên dữ liệu phân vùng theo city.
Đo thật: lọc đúng cột nhanh 3,5 lần, phân vùng sai chậm 27 lần
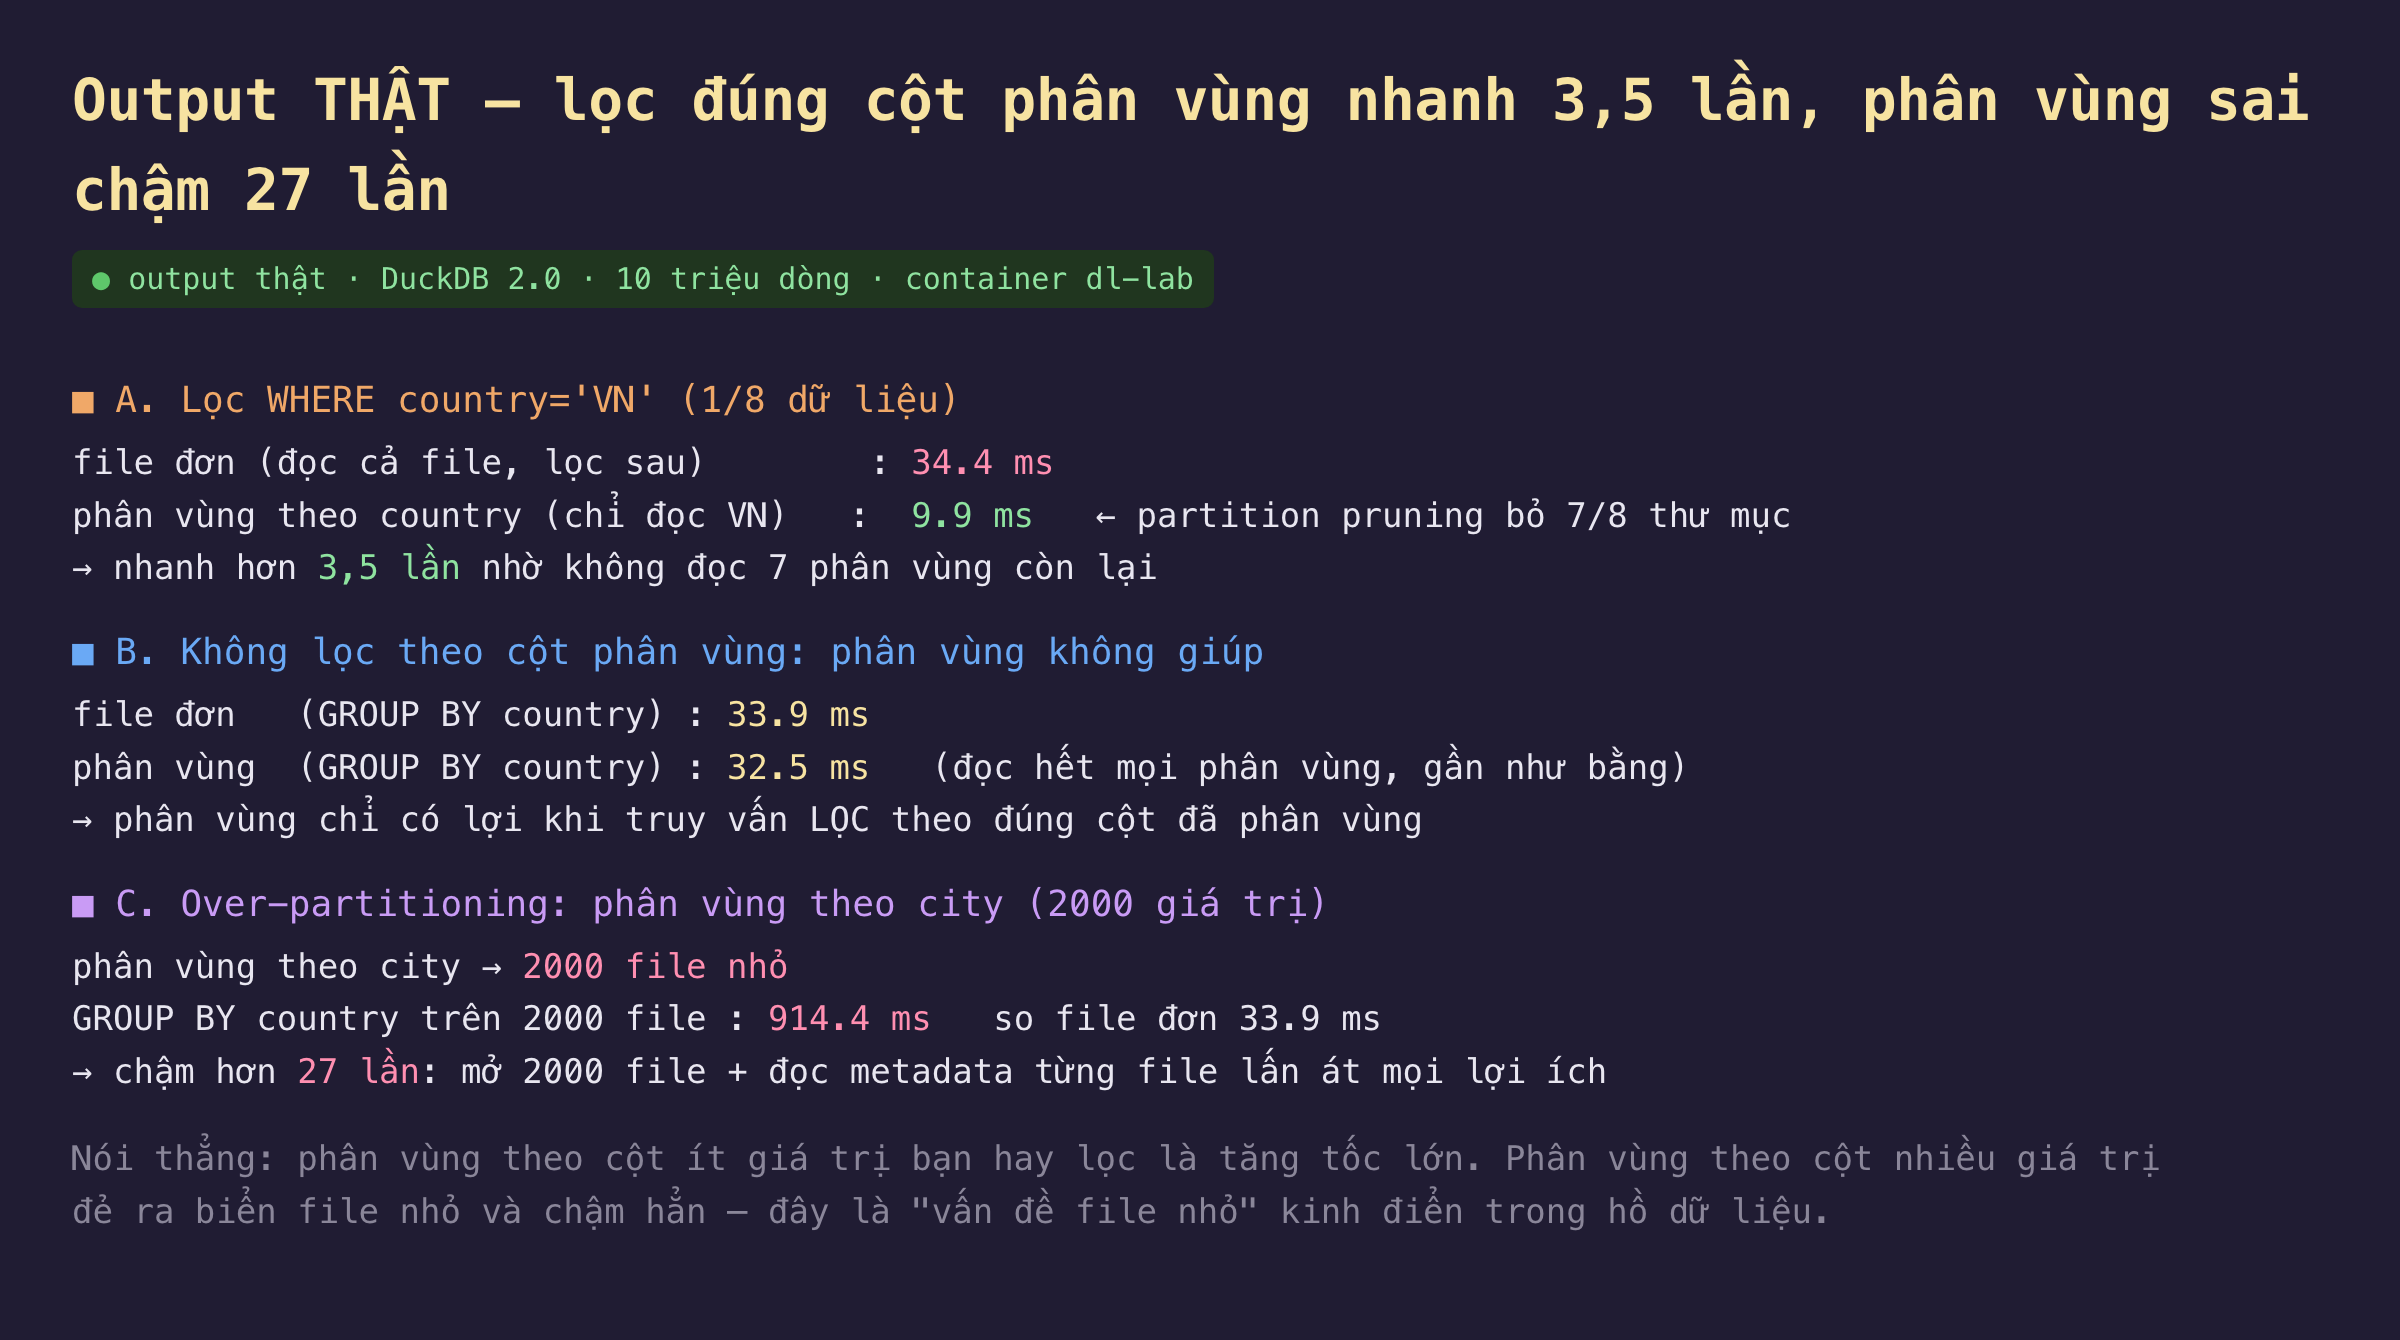
Hình 2: Partition pruning nhanh 3,5 lần khi lọc đúng cột, không giúp khi không lọc, và over-partitioning chậm 27 lần.
| phép đo | kết quả |
|---|---|
| lọc country=VN, file đơn | 34,4 ms |
| lọc country=VN, phân vùng theo country | 9,9 ms |
| GROUP BY country, file đơn | 33,9 ms |
| GROUP BY country, phân vùng theo country | 32,5 ms |
| GROUP BY country, phân vùng theo city (2000 file) | 914,4 ms |
Lọc theo đúng cột phân vùng nhanh hơn 3,5 lần nhờ partition pruning. Truy vấn WHERE country='VN', chọn một phần tám dữ liệu, mất 34,4 ms trên file đơn vì phải đọc cả file rồi lọc, nhưng chỉ 9,9 ms trên dữ liệu phân vùng theo country vì engine chỉ mở thư mục country=VN và bỏ bảy thư mục kia. Khác biệt đến thẳng từ việc không đọc bảy phần tám dữ liệu không liên quan. Đây là trường hợp phân vùng phát huy đúng: cột lọc trùng với cột phân vùng, và số phân vùng nhỏ nên mỗi phân vùng là một khối dữ liệu đáng kể.
Không lọc theo cột phân vùng thì phân vùng không giúp gì. Truy vấn GROUP BY country không có điều kiện lọc mất 33,9 ms trên file đơn và 32,5 ms trên dữ liệu phân vùng, gần như bằng nhau. Lý do rõ ràng: truy vấn này cần dữ liệu của mọi quốc gia, nên dù dữ liệu được chia thành tám thư mục, engine vẫn phải đọc hết cả tám. Partition pruning chỉ loại bỏ được thư mục khi có điều kiện lọc cho biết thư mục nào không cần. Đây là điểm cần nhớ: phân vùng không phải phép màu làm nhanh mọi truy vấn, nó chỉ có lợi khi truy vấn lọc theo đúng cột đã phân vùng.
Phân vùng theo cột high-cardinality chậm hơn file đơn 27 lần. Khi phân vùng theo city, một cột hai nghìn giá trị, dữ liệu bị chia thành hai nghìn file nhỏ. Chạy GROUP BY country trên tập này mất 914,4 ms, so với 33,9 ms trên file đơn, chậm hơn hai mươi bảy lần. Nguyên nhân là chi phí cố định của mỗi file: engine phải mở từng file trong hai nghìn file, đọc metadata footer của mỗi cái, và quản lý việc đọc rải rác, và tổng chi phí này lấn át mọi lợi ích của việc chia nhỏ. Đây là vấn đề file nhỏ kinh điển trong hồ dữ liệu: chia quá mịn biến một thao tác đọc tuần tự hiệu quả thành hàng nghìn thao tác mở file nhỏ lẻ.
Đánh đổi cần cân nhắc
Phân vùng theo cột ít giá trị mà bạn hay lọc. Quy tắc thực hành rút ra: chọn cột phân vùng là cột vừa được dùng để lọc thường xuyên, vừa có số giá trị khác nhau vừa phải. Các cột điển hình tốt là ngày, quốc gia, trạng thái, loại, những thứ có hàng chục tới hàng trăm giá trị và hay xuất hiện trong điều kiện WHERE. Phân vùng theo ngày là phổ biến nhất vì báo cáo hay lọc theo khoảng thời gian, và mỗi ngày là một phân vùng đủ lớn. Mục tiêu là mỗi phân vùng chứa một lượng dữ liệu đáng kể, không quá nhỏ.
Tránh phân vùng theo cột high-cardinality; nếu dữ liệu đã quá mịn, hãy gộp file. Đừng phân vùng theo cột có hàng nghìn tới hàng triệu giá trị như id, timestamp tới giây, hay mã giao dịch, vì sẽ đẻ ra biển file nhỏ. Nếu một pipeline đã tạo ra quá nhiều file nhỏ, cách sửa là gộp chúng lại, gọi là compaction: đọc nhiều file nhỏ và ghi lại thành ít file lớn hơn theo phân vùng thô hơn. Nhiều hệ thống hồ dữ liệu có công việc định kỳ làm việc này. Kích thước file lý tưởng thường là hàng chục tới hàng trăm MB mỗi file, đủ lớn để chi phí mở file không đáng kể so với dữ liệu bên trong.
Phạm vi đo. Bài đo trên dữ liệu cục bộ với số phân vùng vừa phải và một mức over-partitioning. Trên lưu trữ đối tượng từ xa như S3, chi phí mở mỗi file còn cao hơn nhiều vì mỗi file là một request mạng, nên vấn đề file nhỏ nghiêm trọng hơn và kích thước file tối ưu lớn hơn. Bài không đo phân vùng nhiều mức, như phân vùng theo cả năm và tháng lồng nhau, vốn là cách thường dùng để cân bằng độ mịn. Cũng chưa đo tương tác giữa partition pruning và predicate pushdown trong file, khi cả hai cùng hoạt động để bỏ qua dữ liệu ở hai mức.
Ba ý mang về
- Hive partitioning cho phép bỏ qua cả thư mục khi lọc theo cột phân vùng. Lọc một quốc gia trên dữ liệu phân vùng theo quốc gia chỉ đọc một trong tám thư mục, nhanh hơn file đơn 3,5 lần.
- Phân vùng chỉ giúp khi truy vấn lọc theo đúng cột đã phân vùng.
GROUP BYkhông lọc đọc hết mọi phân vùng, nên phân vùng không nhanh hơn file đơn. - Over-partitioning gây vấn đề file nhỏ. Phân vùng theo cột hai nghìn giá trị tạo hai nghìn file nhỏ và chậm hơn file đơn 27 lần; phân vùng theo cột ít giá trị bạn hay lọc.
Nguồn
- DuckDB — Partitioned Writes và
PARTITION_BY: https://duckdb.org/docs/data/partitioning/partitioned_writes - DuckDB — Hive Partitioning, đọc dữ liệu phân vùng: https://duckdb.org/docs/data/partitioning/hive_partitioning
- Apache Hive — quy ước đặt tên thư mục phân vùng: https://cwiki.apache.org/confluence/display/Hive/LanguageManual+DDL#LanguageManualDDL-PartitionedTables
- Databricks — The Small Files Problem, vấn đề file nhỏ trong hồ dữ liệu: https://docs.databricks.com/en/optimizations/file-size-tuning.html
- DuckDB — Performance Guide, partition pruning: https://duckdb.org/docs/guides/performance/overview
Phần sau đo cách DuckDB xử lý dữ liệu lớn hơn bộ nhớ: khi một truy vấn cần nhiều RAM hơn mức có, nó tràn trung gian ra đĩa thay vì sập. Xem một aggregation hay sort vượt giới hạn bộ nhớ cứng vẫn chạy xong thế nào, và cái giá hiệu năng của việc spill so với chạy gọn trong RAM.
