Phần 9 đo cách tổ chức dữ liệu trên đĩa. Phần này đo điều xảy ra khi một truy vấn cần nhiều bộ nhớ hơn mức máy có. Với nhiều công cụ xử lý dữ liệu, vượt bộ nhớ nghĩa là chương trình bị hệ điều hành giết vì hết RAM, và công việc dở dang mất trắng. DuckDB và các engine phân tích hiện đại xử lý khác: khi trạng thái trung gian của một truy vấn vượt giới hạn bộ nhớ, nó tràn phần dư ra đĩa và tiếp tục chạy, hoàn thành truy vấn với cái giá là chậm hơn. Đây là tính chất quan trọng cho phép phân tích dữ liệu lớn hơn RAM trên một máy. Bài này đo trực tiếp: một phép sort vượt giới hạn bộ nhớ cứng vẫn chạy xong nhờ spill, và một phép tổng hợp streaming chạy gọn với bộ nhớ rất nhỏ.
Hai loại toán tử: streaming và blocking
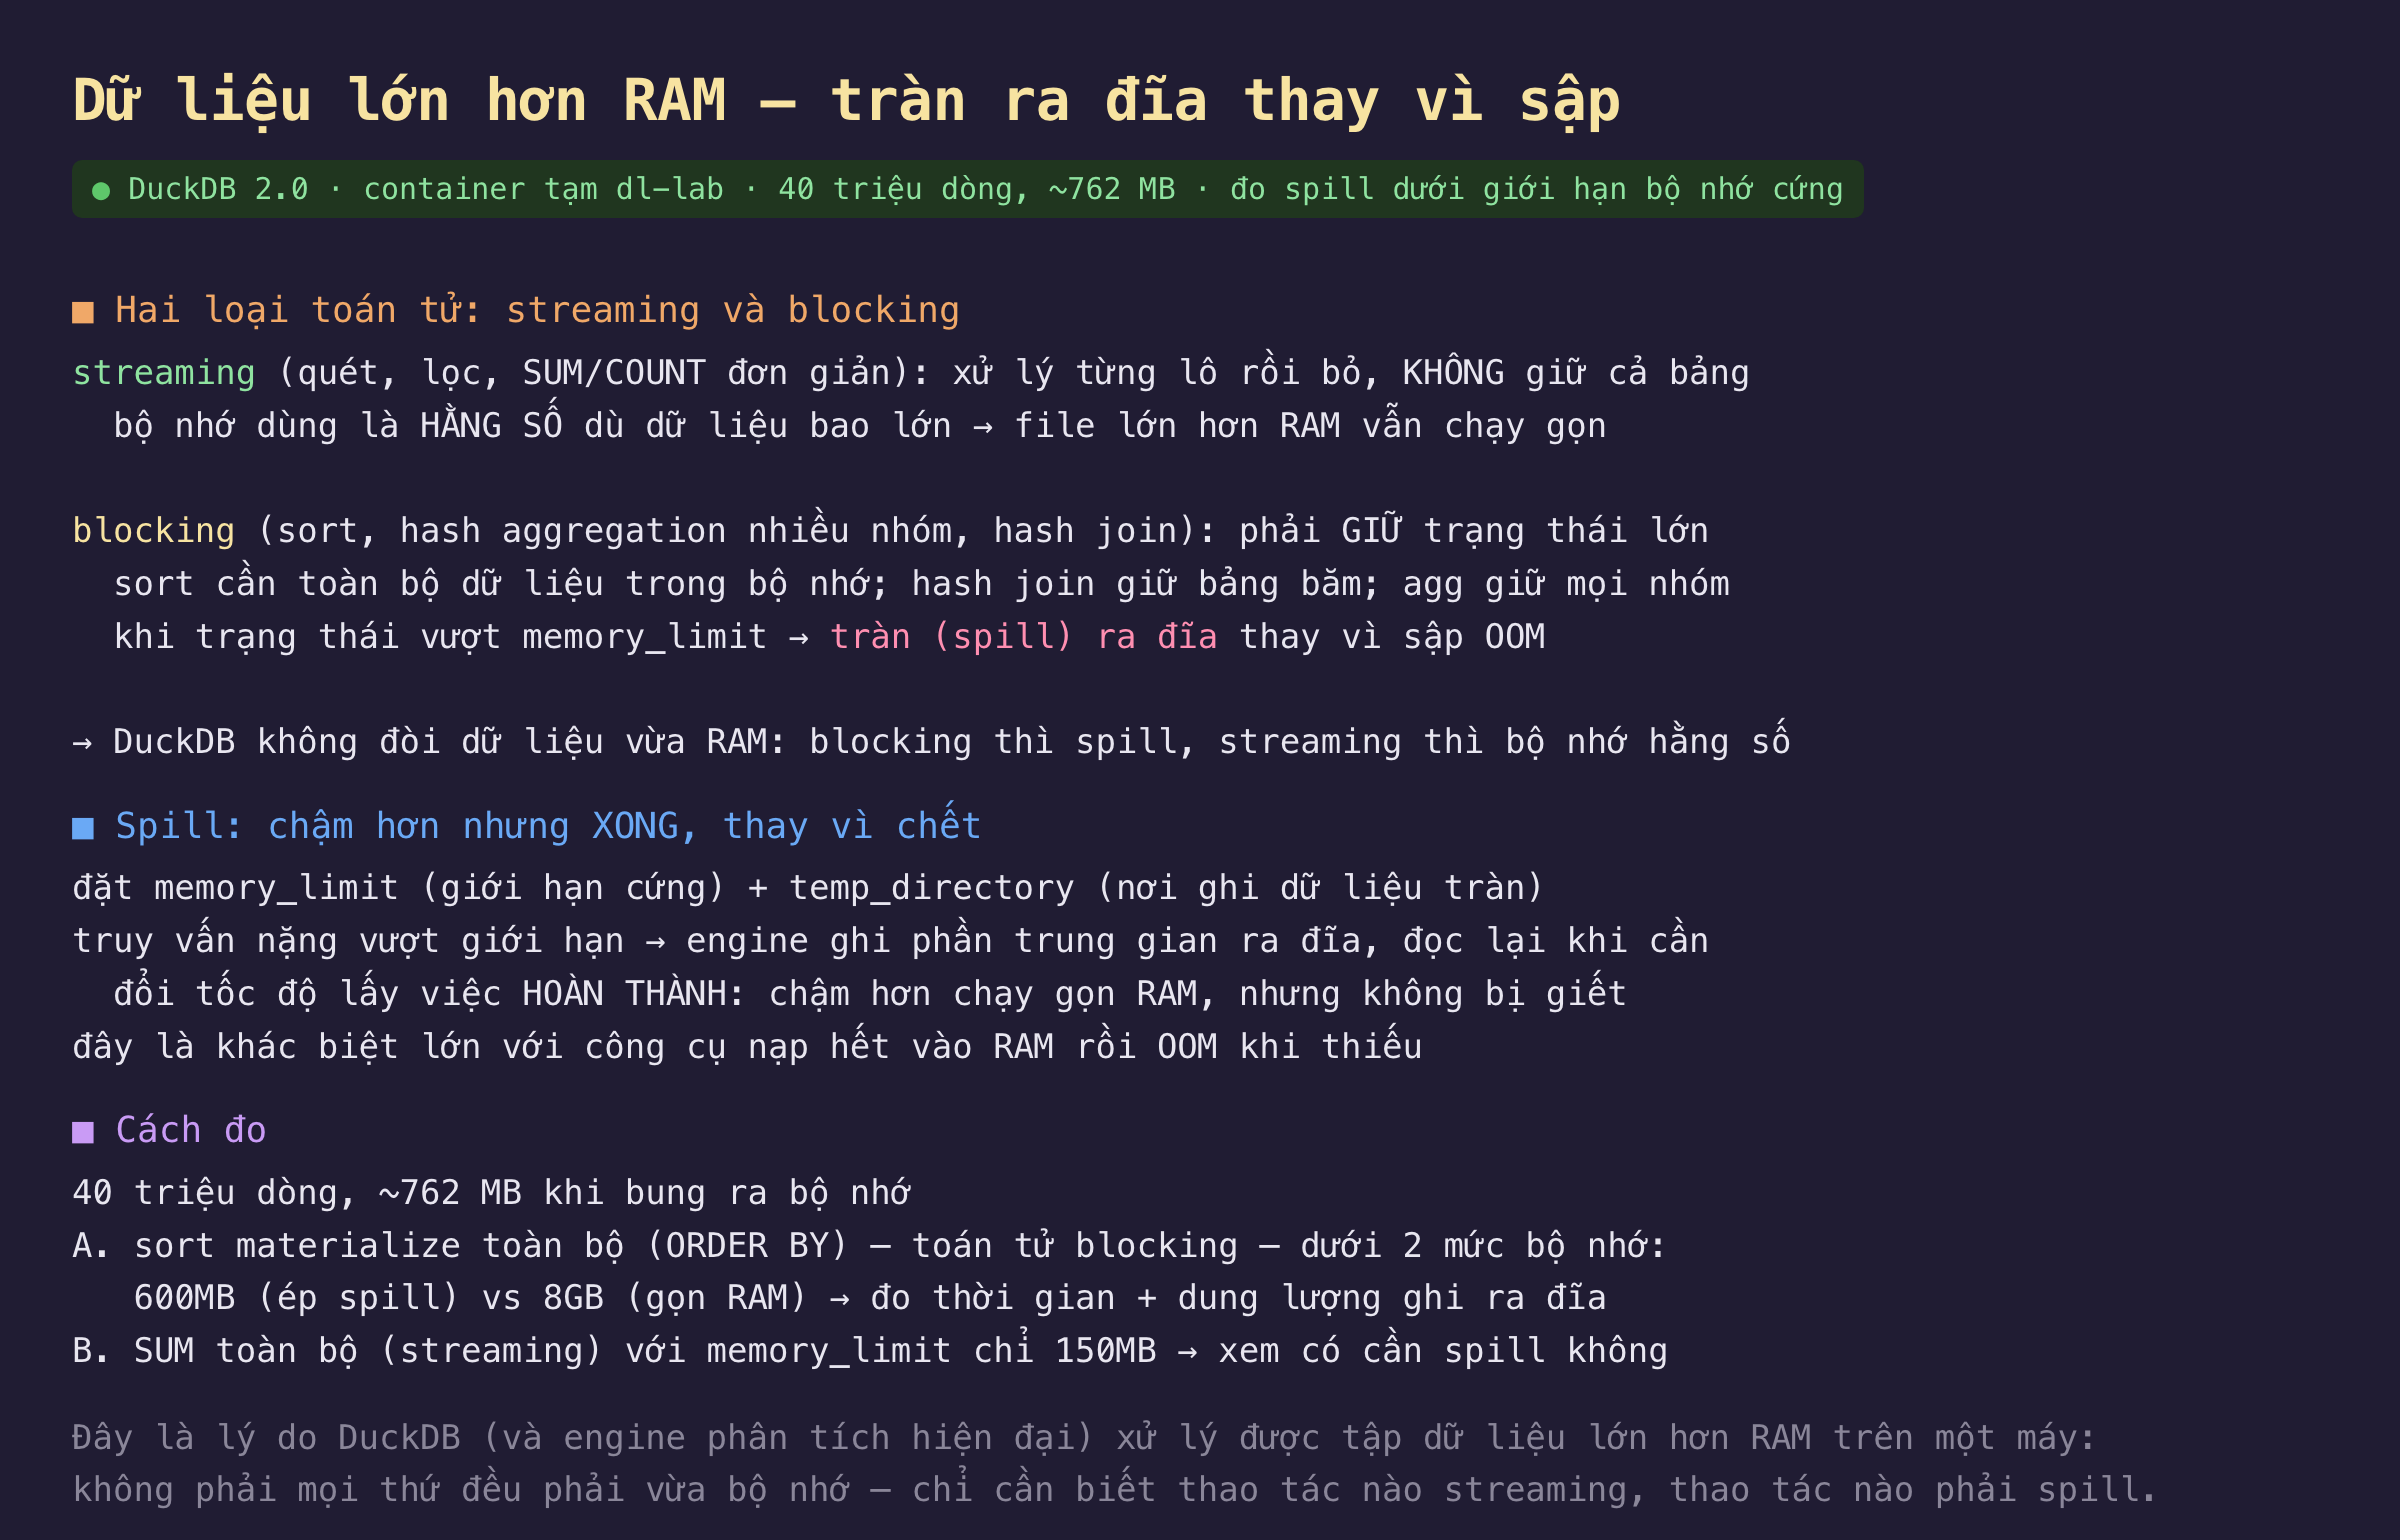
Hình 1: Toán tử streaming giữ bộ nhớ hằng số; toán tử blocking giữ trạng thái lớn và tràn ra đĩa khi vượt giới hạn.
DuckDB chia các toán tử thành hai loại theo cách chúng dùng bộ nhớ. Toán tử streaming, như quét, lọc, và các phép tổng hợp đơn giản như SUM và COUNT, xử lý dữ liệu theo từng lô rồi bỏ đi, không giữ cả bảng trong bộ nhớ. Bộ nhớ chúng dùng là hằng số dù dữ liệu lớn tới đâu, nên một file lớn hơn RAM vẫn chạy gọn: engine đọc từng phần, cộng dồn vào kết quả, và không tích lũy trạng thái lớn.
Toán tử blocking, như sort, hash aggregation với nhiều nhóm, và hash join, thì phải giữ một trạng thái lớn trước khi cho ra kết quả. Sort cần toàn bộ dữ liệu trong bộ nhớ để sắp xếp; hash join giữ bảng băm bên build; aggregation giữ mọi nhóm. Khi trạng thái này vượt memory_limit, DuckDB không sập mà tràn phần dư ra đĩa, gọi là spill, rồi đọc lại khi cần. Nhờ vậy, DuckDB không đòi dữ liệu phải vừa RAM: với toán tử blocking thì spill ra đĩa, với toán tử streaming thì bộ nhớ hằng số, và trong cả hai trường hợp truy vấn đều chạy được.
Spill là đánh đổi tốc độ lấy việc hoàn thành. Đặt memory_limit làm giới hạn cứng và temp_directory làm nơi ghi dữ liệu tràn; khi truy vấn nặng vượt giới hạn, engine ghi phần trung gian ra đĩa và đọc lại khi cần. Kết quả chậm hơn chạy gọn trong RAM, nhưng truy vấn không bị giết, đó là khác biệt lớn so với các công cụ nạp hết vào bộ nhớ rồi OOM khi thiếu. Cách đo: bốn mươi triệu dòng, khoảng bảy trăm sáu mươi hai MB khi bung ra bộ nhớ; một phép sort materialize toàn bộ, là toán tử blocking, chạy dưới hai mức bộ nhớ, 600 MB ép spill và 8 GB chạy gọn RAM, đo thời gian và dung lượng ghi ra đĩa; và một phép SUM toàn bộ, là streaming, với memory_limit chỉ 150 MB để xem có cần spill không.
Đo thật: sort vượt RAM spill 976 MB ra đĩa vẫn xong
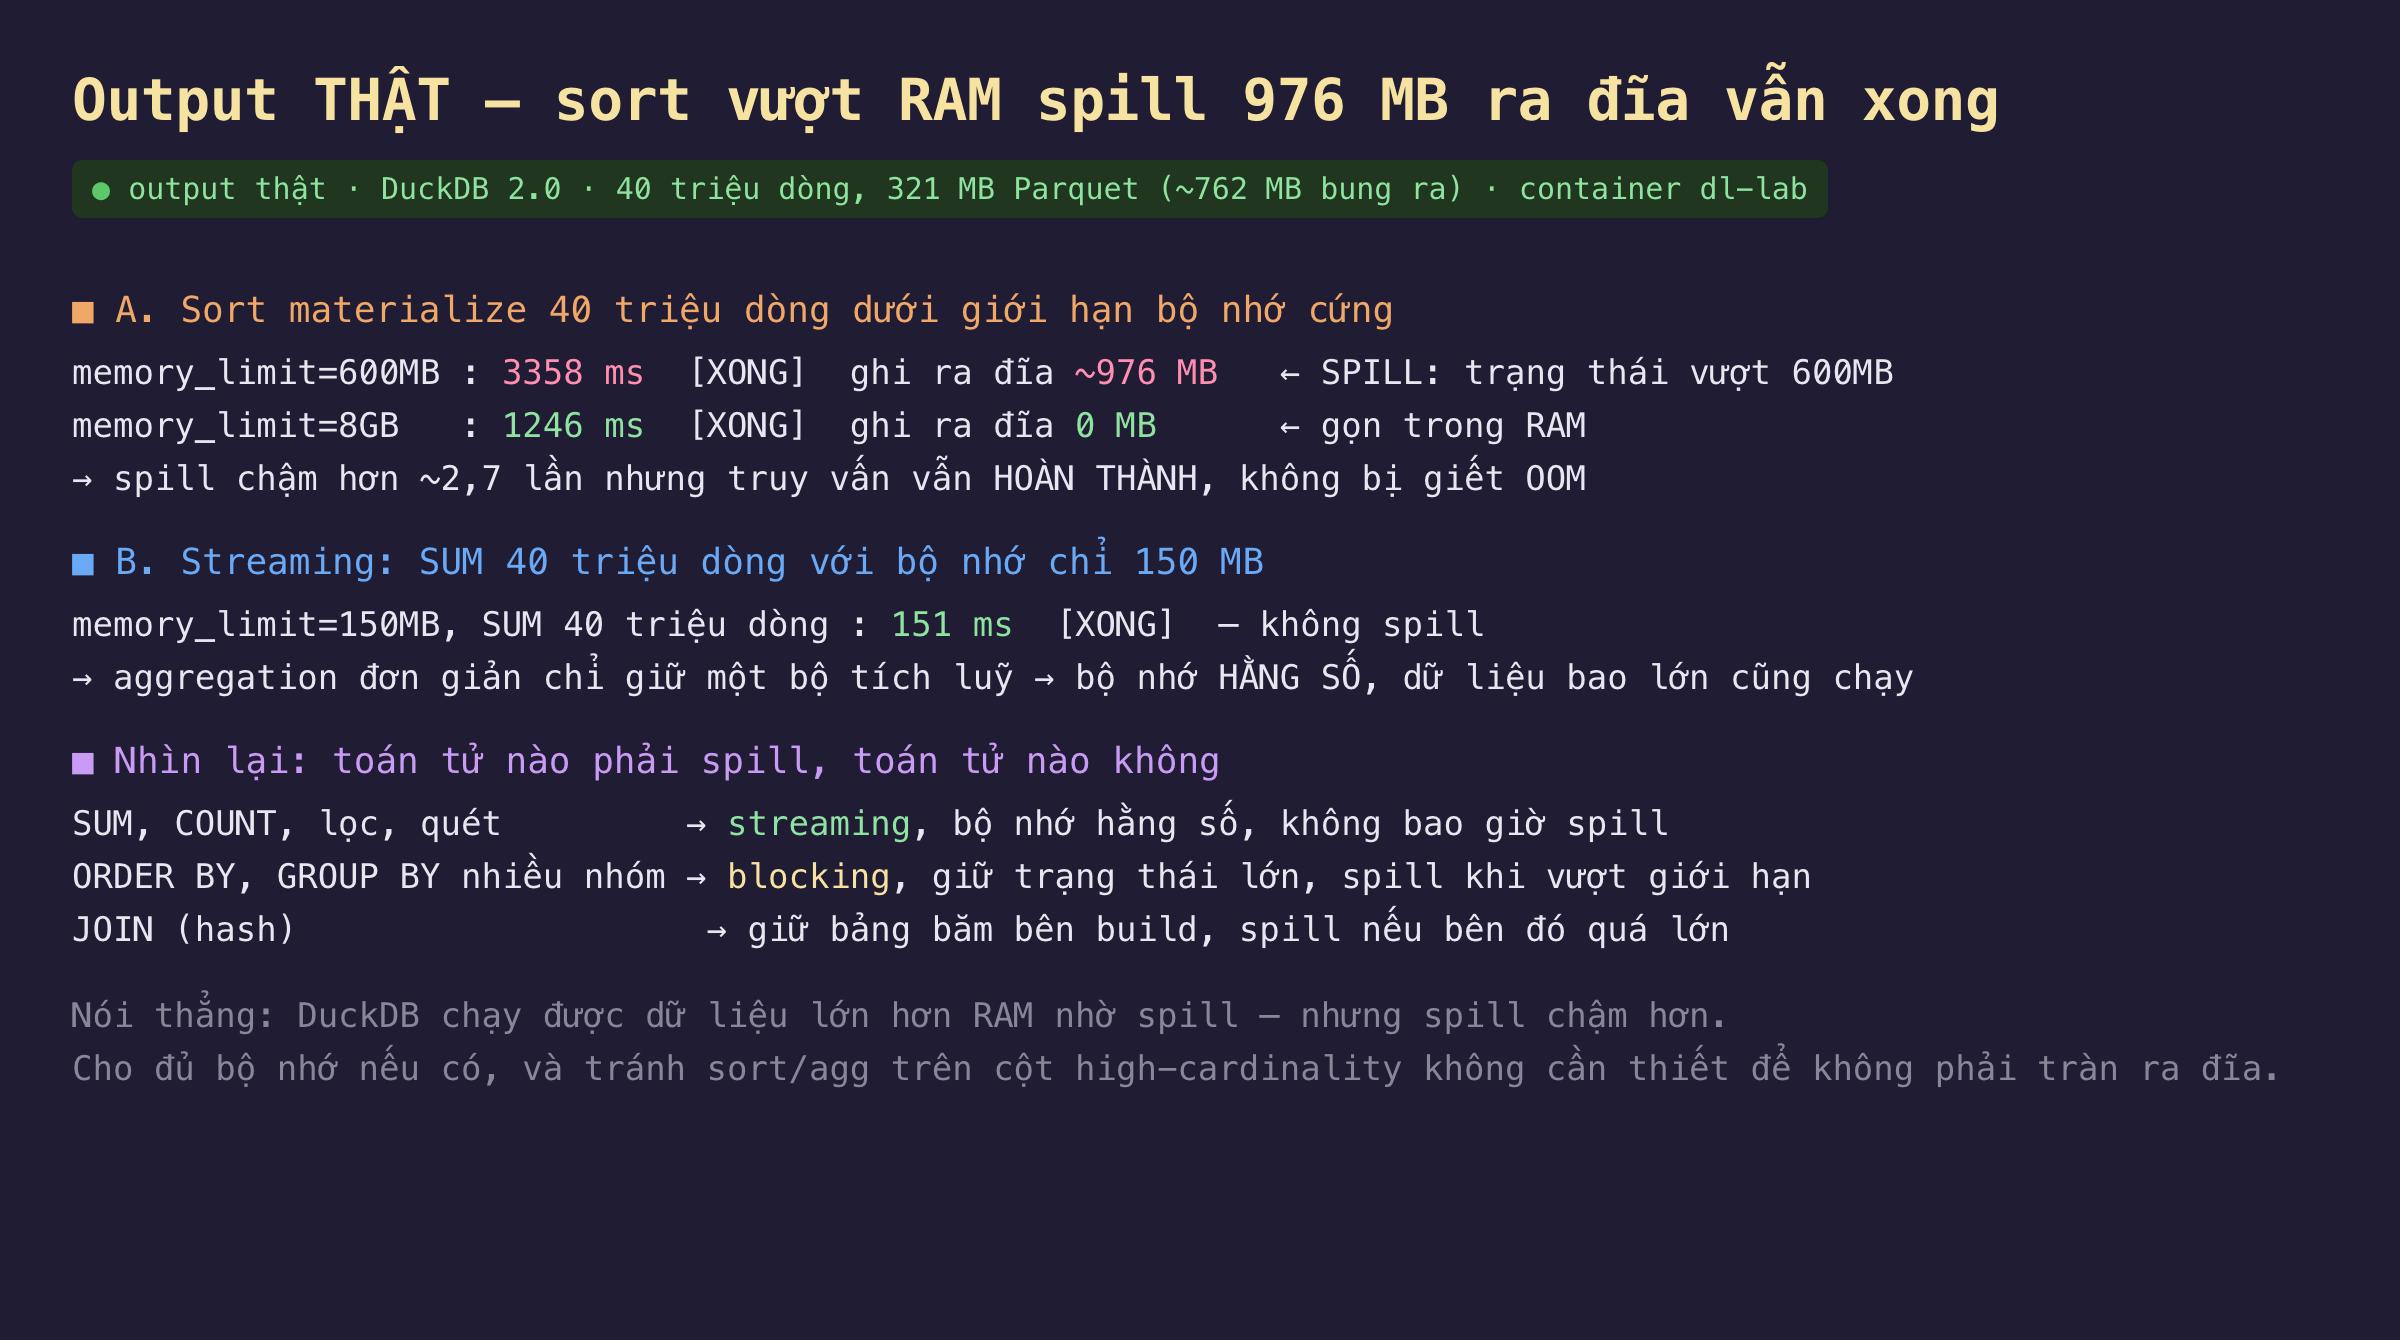
Hình 2: Sort dưới 600 MB spill 976 MB ra đĩa và chậm hơn 2,7 lần nhưng vẫn hoàn thành; SUM streaming chạy với 150 MB không spill.
| phép đo | kết quả |
|---|---|
| sort 40 triệu dòng, memory_limit 600 MB | 3358 ms, spill ~976 MB |
| sort 40 triệu dòng, memory_limit 8 GB | 1246 ms, spill 0 |
| SUM 40 triệu dòng, memory_limit 150 MB | 151 ms, không spill |
Sort vượt giới hạn bộ nhớ spill 976 MB ra đĩa nhưng vẫn hoàn thành. Phép sort materialize toàn bộ bốn mươi triệu dòng dưới giới hạn cứng 600 MB mất 3358 ms và ghi khoảng 976 MB dữ liệu trung gian ra đĩa, nhưng truy vấn chạy xong. Cùng phép sort đó với giới hạn 8 GB mất 1246 ms và không ghi gì ra đĩa vì toàn bộ trạng thái nằm gọn trong RAM. Spill làm chậm hơn khoảng hai phẩy bảy lần, cái giá của việc ghi và đọc lại dữ liệu từ đĩa thay vì giữ trong bộ nhớ. Nhưng điểm quan trọng nhất là truy vấn hoàn thành thay vì bị giết: một công cụ nạp hết vào RAM sẽ OOM ở đây, còn DuckDB cho ra kết quả đúng, chỉ chậm hơn.
SUM streaming chạy với bộ nhớ chỉ 150 MB vì không cần giữ cả bảng. Phép SUM toàn bộ bốn mươi triệu dòng với memory_limit chỉ 150 MB, nhỏ hơn nhiều so với kích thước dữ liệu khi bung ra bộ nhớ, mất 151 ms và không spill gì. Lý do là aggregation đơn giản chỉ cần giữ một bộ tích lũy, tổng đang chạy, nên bộ nhớ dùng là hằng số bất kể dữ liệu lớn tới đâu. Engine đọc từng lô, cộng vào tổng, rồi bỏ lô đó đi. Đây là minh họa rõ nhất cho toán tử streaming: nó không bao giờ cần spill vì không bao giờ tích lũy trạng thái lớn.
Biết toán tử nào streaming, toán tử nào blocking để đoán hành vi bộ nhớ. Tổng kết lại, SUM, COUNT, lọc và quét là streaming, dùng bộ nhớ hằng số và không bao giờ spill. ORDER BY và GROUP BY với nhiều nhóm là blocking, giữ trạng thái lớn và spill khi vượt giới hạn. Hash join giữ bảng băm bên build và spill nếu bên đó quá lớn. Phân biệt này giúp đoán trước một truy vấn sẽ chạy gọn hay phải tràn ra đĩa: nếu nó chỉ gồm các toán tử streaming, bộ nhớ không thành vấn đề dù dữ liệu rất lớn; nếu có sort hay aggregation trên cột cardinality cao, nó có thể spill và chậm, và đó là lúc cân nhắc cho thêm bộ nhớ hoặc viết lại truy vấn.
Đánh đổi cần cân nhắc
Cho đủ bộ nhớ nếu có, để tránh spill không cần thiết. Vì spill làm chậm đáng kể, cấu hình memory_limit rộng rãi khi máy có đủ RAM là cách đơn giản để tránh tràn ra đĩa cho các truy vấn vừa sức bộ nhớ. DuckDB mặc định đặt giới hạn theo một phần RAM của máy; nếu truy vấn phân tích hay spill mà máy còn RAM trống, nâng giới hạn có thể giúp. Ngược lại, trên máy ít RAM hoặc khi dữ liệu thật sự lớn hơn RAM, spill là cứu cánh cho phép hoàn thành công việc mà không cần cụm máy, đổi lại chấp nhận chậm hơn.
Viết lại truy vấn để giảm trạng thái blocking khi có thể. Nhiều truy vấn spill vì vô tình tạo trạng thái lớn không cần thiết. Sort toàn bộ chỉ để lấy vài dòng đầu nên dùng LIMIT để engine chỉ giữ top-N thay vì sắp xếp hết. GROUP BY theo cột cardinality quá cao tạo bảng băm khổng lồ, như phần về aggregation đã đo, nên cân nhắc lọc trước hoặc giảm độ chi tiết. Lọc dữ liệu càng sớm càng tốt, trước khi sort hay join, giảm lượng dữ liệu mà toán tử blocking phải giữ. Những thay đổi này vừa tránh spill vừa làm truy vấn nhanh hơn ngay cả khi không spill.
Phạm vi đo. Bài đo spill trên đĩa SSD cục bộ; tốc độ spill phụ thuộc mạnh vào tốc độ đĩa, nên trên đĩa cơ chậm hơn hoặc lưu trữ mạng, chi phí spill lớn hơn nhiều. Bài không đo trường hợp dữ liệu lớn hơn cả đĩa, khi spill cũng không cứu được. Cũng chưa đo chi tiết cách DuckDB chia nhỏ và trộn các phần spill, hay ngưỡng chính xác khi nào một toán tử bắt đầu spill, vốn phụ thuộc chi tiết cài đặt. Kết luận cốt lõi không đổi: blocking có thể spill và chậm, streaming thì không.
Ba ý mang về
- DuckDB xử lý dữ liệu lớn hơn RAM bằng cách spill ra đĩa, không sập. Sort bốn mươi triệu dòng dưới giới hạn 600 MB ghi 976 MB ra đĩa và vẫn hoàn thành, chậm hơn chạy gọn RAM hai phẩy bảy lần.
- Toán tử streaming dùng bộ nhớ hằng số, không bao giờ spill.
SUMbốn mươi triệu dòng với giới hạn 150 MB mất 151 ms; aggregation đơn giản chỉ giữ một bộ tích lũy. - Biết streaming với blocking để đoán hành vi bộ nhớ. Quét, lọc, SUM là streaming; sort, GROUP BY nhiều nhóm, join là blocking và có thể spill; cho đủ bộ nhớ hoặc giảm trạng thái để tránh tràn.
Nguồn
- DuckDB — Larger-than-Memory Workloads, spill và out-of-core: https://duckdb.org/docs/guides/performance/how_to_tune_workloads
- DuckDB — Configuration,
memory_limitvàtemp_directory: https://duckdb.org/docs/configuration/overview - DuckDB — Why DuckDB, xử lý out-of-core: https://duckdb.org/why_duckdb
- Goetz Graefe — Query Evaluation Techniques for Large Databases, external sort và hash: https://dl.acm.org/doi/10.1145/152610.152611
- DuckDB blog — Out-of-Core Hash Aggregation: https://duckdb.org/2024/03/29/external-aggregation.html
Phần sau đo lớp metadata của Parquet: schema, kiểu dữ liệu, và footer. Xem đọc metadata của một file tốn bao nhiêu so với đọc dữ liệu, các kiểu lồng nhau được lưu thế nào, và schema evolution cho phép thêm cột mà không viết lại file cũ ra sao.
