Bốn bài trước ta thấy namespace cô lập tầm nhìn của container — nó thấy PID, file, mạng của riêng mình. Nhưng cô lập tầm nhìn không ngăn một container ngốn hết CPU và RAM của cả host, làm chết mọi container khác (vấn đề "noisy neighbor"). Đó là việc của nửa còn lại: cgroups (control groups) — cơ chế kernel giới hạn tài nguyên. Bài này (phần 5 loạt Docker) chạy thật để thấy --memory và --cpus thực sự làm gì, giới hạn nằm ở đâu, và điểm khác biệt sống còn: vượt RAM thì container bị giết, còn vượt CPU chỉ bị làm chậm.
namespace + cgroup = container hoàn chỉnh
Hai cơ chế bổ trợ nhau:
- namespace: container thấy gì (PID, mount, mạng...) — đã bàn ở các bài trước.
- cgroup: container dùng bao nhiêu (CPU, RAM, I/O, số tiến trình...).
Không có cgroup, một container lỗi (rò rỉ bộ nhớ, vòng lặp CPU) có thể kéo sập cả máy. Đặt giới hạn khi chạy:
docker run --memory 64m --cpus 0.5 ...
# --memory 64m: trần RAM 64 MiB. Vượt -> kernel OOM kill.
# --cpus 0.5:   được nửa lõi. CPU-bound -> bị throttle (chạy chậm).
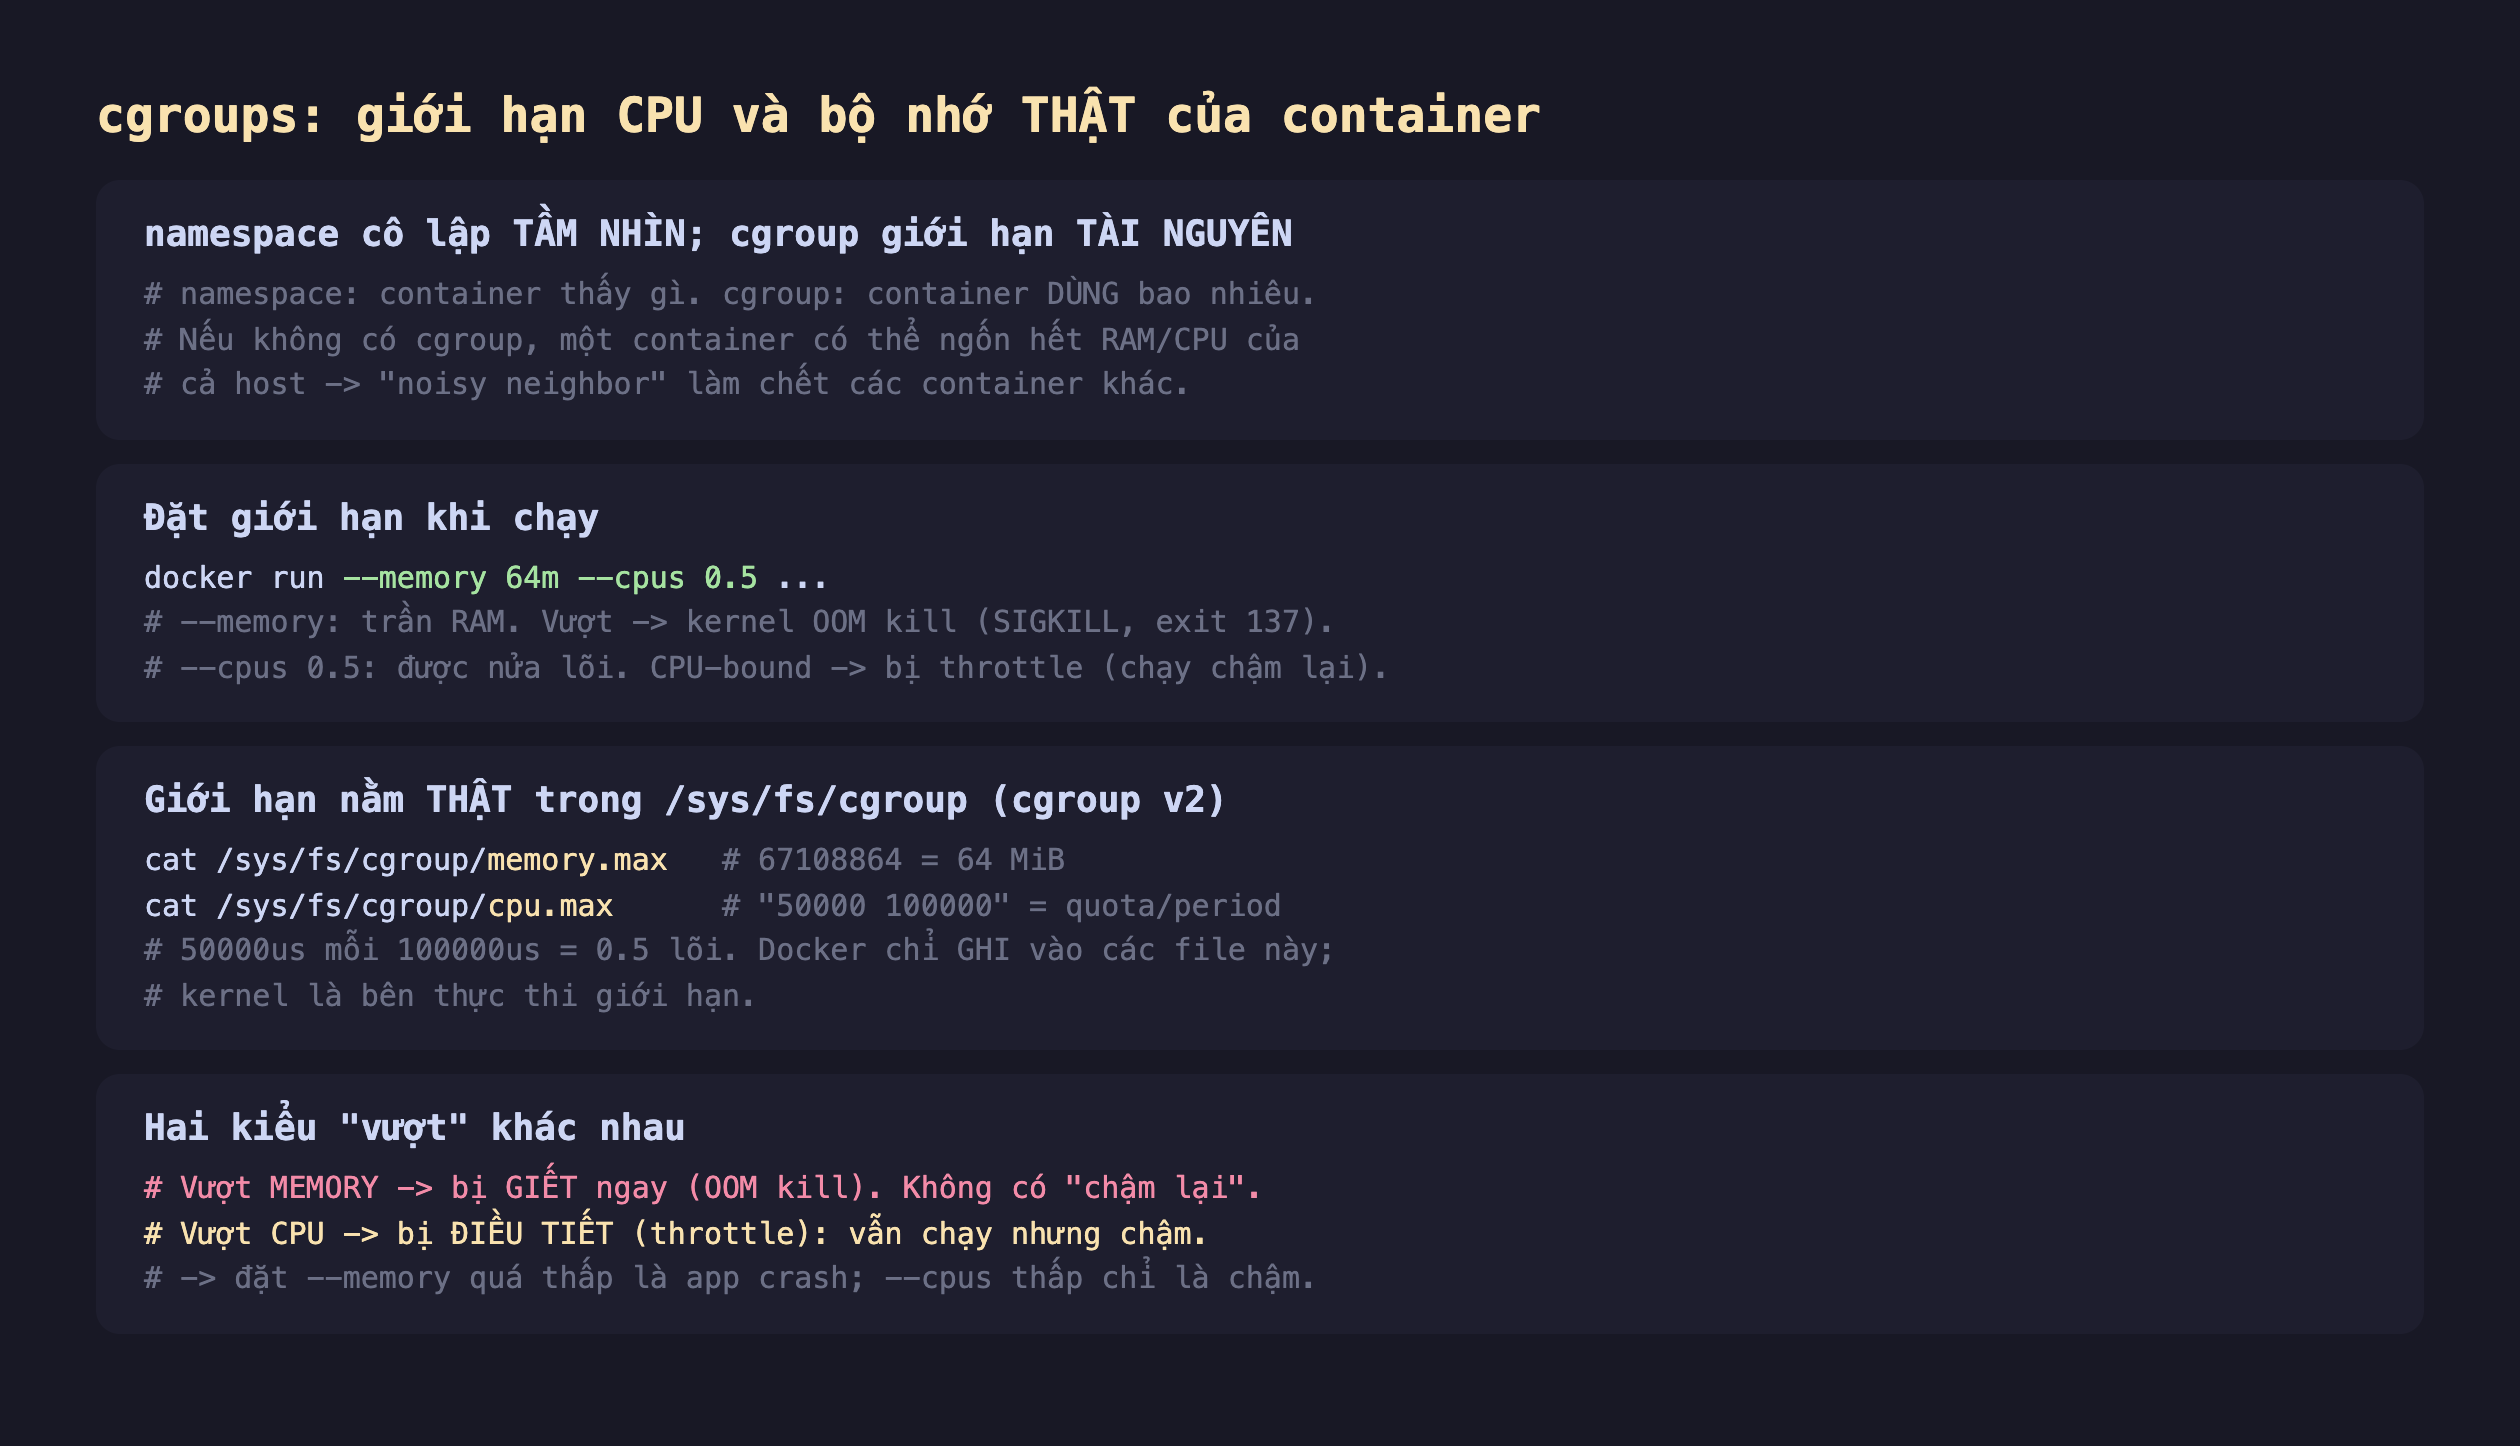
Hình 1: namespace cô lập tầm nhìn, cgroup giới hạn tài nguyên; --memory/--cpus ghi vào file cgroup trong /sys/fs/cgroup; vượt RAM → OOM kill (exit 137), vượt CPU → throttle (chậm lại).
Đo thật: throttle, file cgroup, và OOM kill
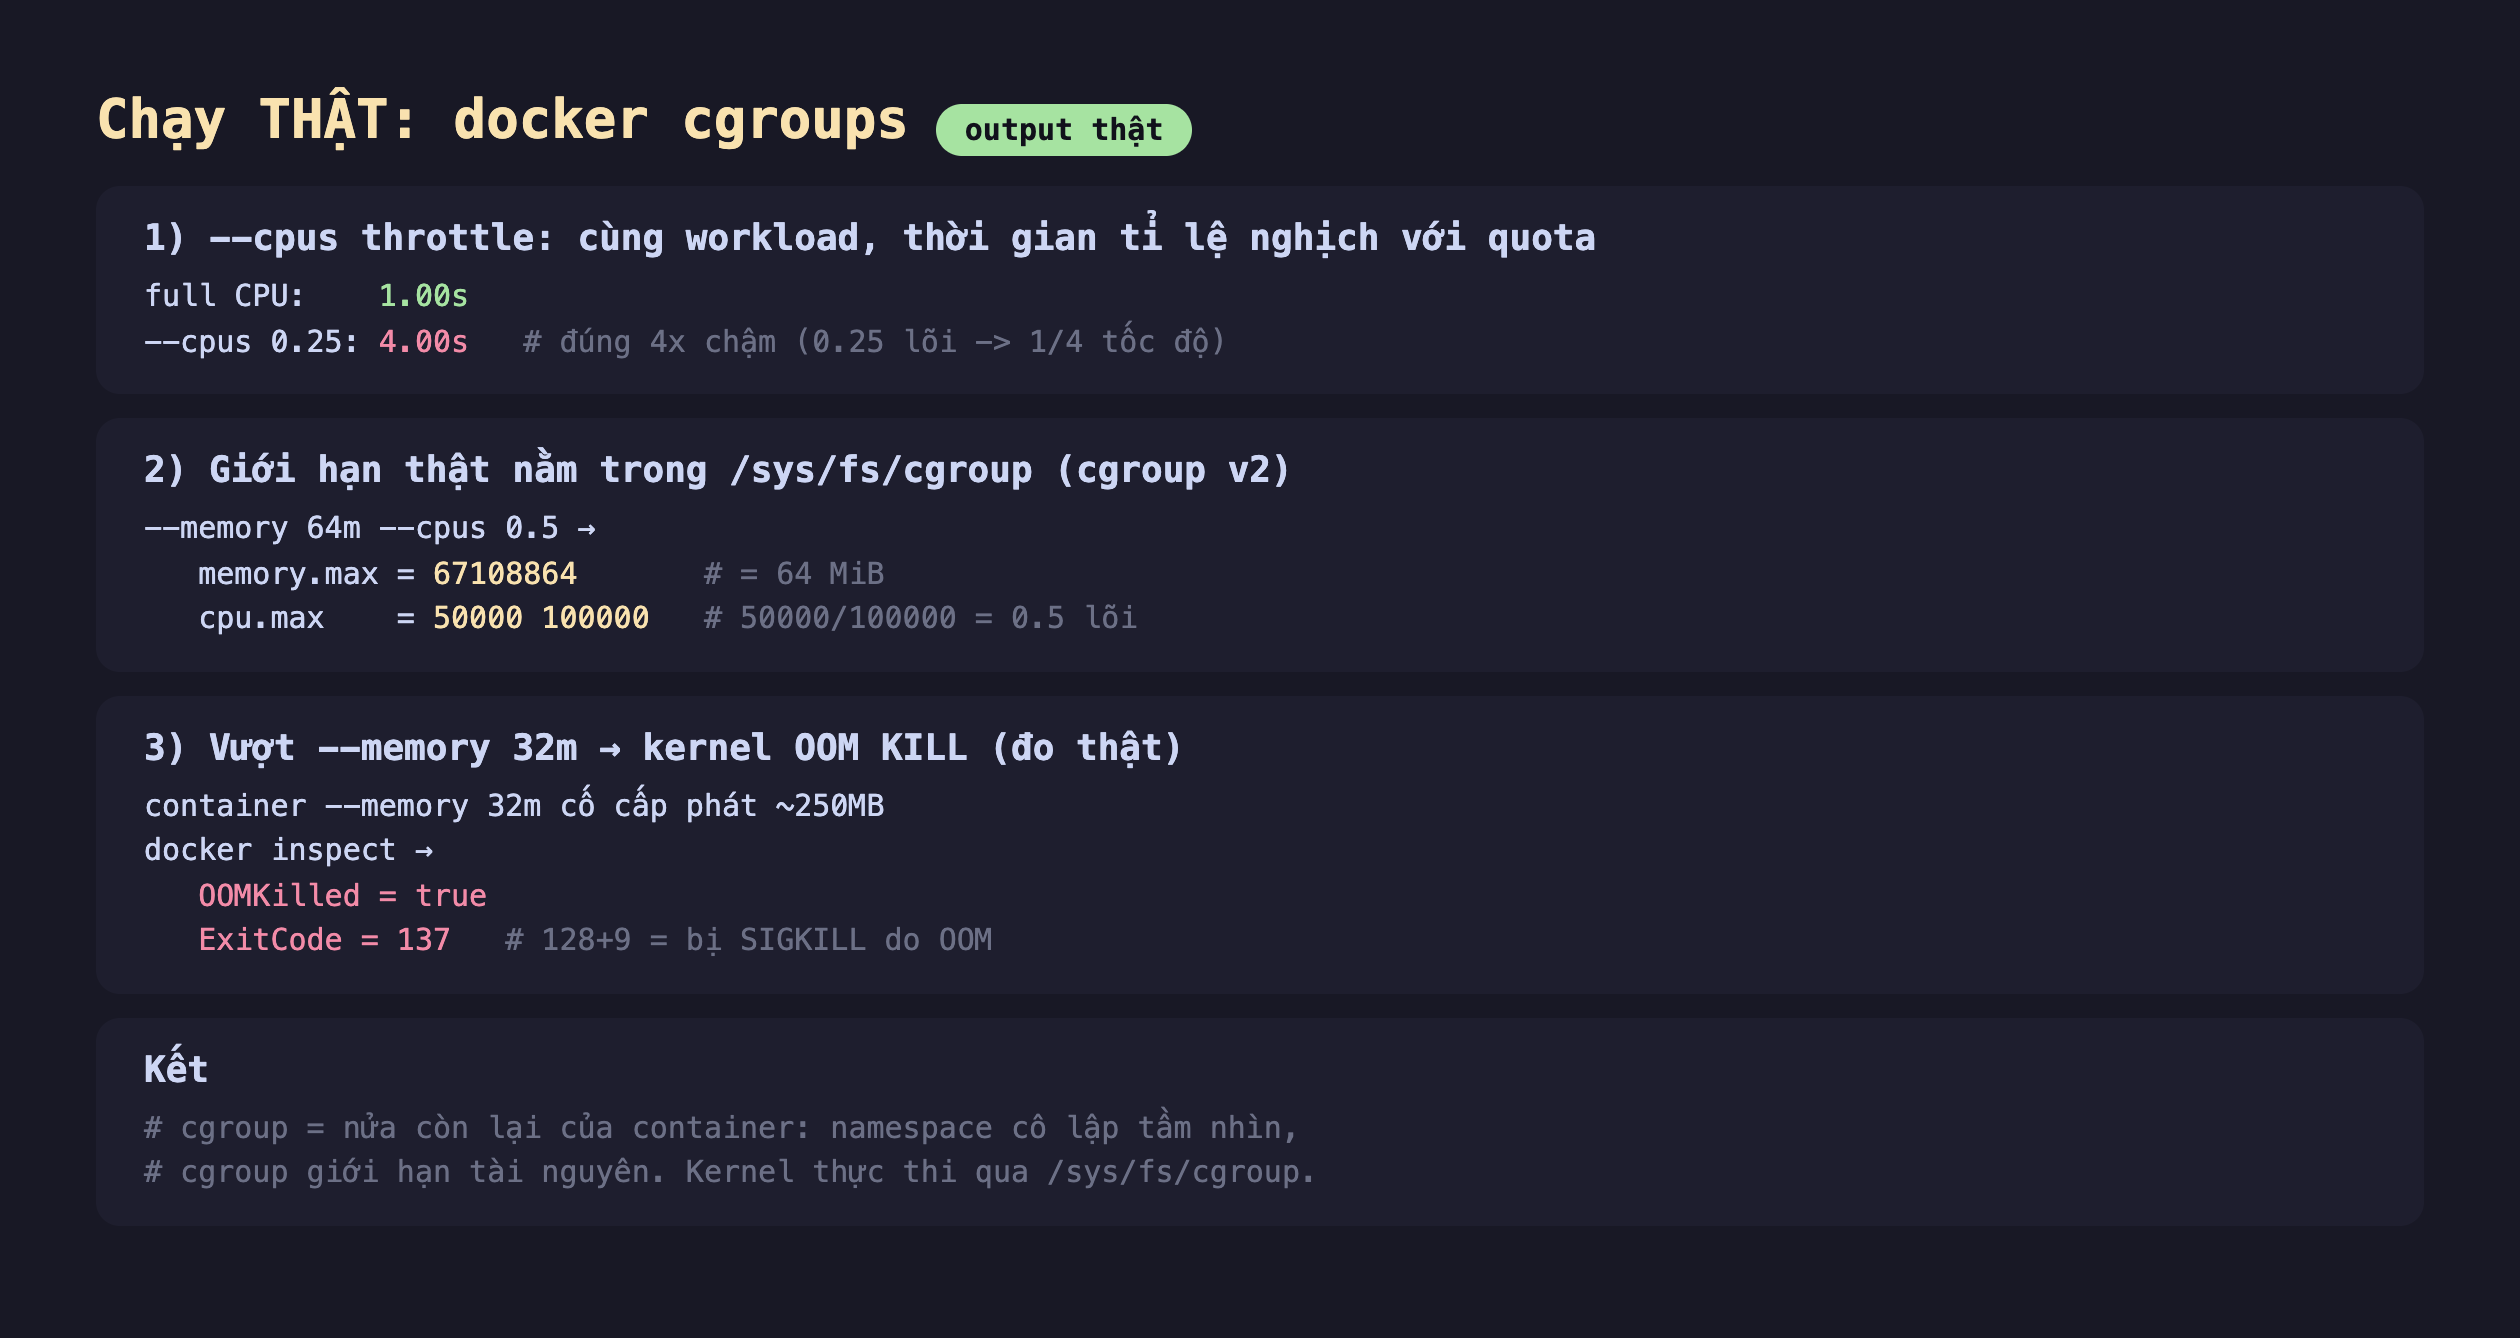
Hình 2: Chạy thật — cùng workload chạy 1,00s full CPU nhưng 4,00s với --cpus 0.25 (đúng 4×); --memory 64m --cpus 0.5 cho memory.max=67108864 (64 MiB) và cpu.max=50000 100000 (0,5 lõi); container --memory 32m cấp phát vượt → OOMKilled=true, ExitCode=137.
- CPU throttle tỉ lệ với quota: cùng một tác vụ tính toán chạy 1,00s khi full CPU, nhưng 4,00s với
--cpus 0.25— đúng 4 lần chậm hơn (0,25 lõi = 1/4 tốc độ). CPU limit không "cấm" tính toán; nó điều tiết tốc độ. - Giới hạn nằm trong
/sys/fs/cgroup: đây là điều nhiều người không biết.--memory/--cpuschỉ ghi vào các file cgroup:memory.max=67108864(chính xác 64 MiB),cpu.max=50000 100000(được chạy 50000µs mỗi chu kỳ 100000µs = 0,5 lõi). Kernel mới là bên thực thi. Docker chỉ là công cụ cấu hình — bạn có thểechovào các file này bằng tay và có kết quả y hệt. - Vượt RAM → OOM kill thật: container
--memory 32mcố cấp phát ~250MB. Kernel không cho vượt trần — nó giết tiến trình.docker inspectxác nhậnOOMKilled=truevàExitCode=137(128+9 = bịSIGKILL). Đây là lỗi rất hay gặp trong sản xuất: app bị giết bí ẩn, log trống, exit 137 — gần như luôn là vượt--memory.
Hai kiểu "vượt" hoàn toàn khác nhau
Đây là điểm cốt lõi cần nhớ:
- Vượt bộ nhớ → bị GIẾT ngay (OOM kill). Không có "chậm lại", không cảnh báo — kernel
SIGKILLtiến trình để bảo vệ hệ thống. Đặt--memoryquá thấp so với nhu cầu thật của app = app crash liên tục. - Vượt CPU → bị ĐIỀU TIẾT (throttle). App vẫn chạy, chỉ chậm hơn. Đặt
--cpusthấp không làm app chết, chỉ làm nó phản hồi chậm.
Hiểu khác biệt này quyết định cách bạn đặt giới hạn: --memory phải đủ (thiếu là chết), --cpus có thể siết để chia sẻ công bằng (siết chỉ làm chậm).
Đánh đổi cần cân nhắc
Đặt --memory phải dựa trên đo thật, không đoán. Vì vượt là bị giết ngay, đặt quá thấp gây crash khó lần (exit 137, thường không có log rõ). Chạy app dưới tải thật, đo mức RAM đỉnh (qua docker stats hoặc metric), rồi đặt trần cao hơn đỉnh một khoảng đệm. Đừng đặt "cho tròn số" — con số sai nghĩa là sự cố lúc tải cao.
cgroup không làm app "biết" giới hạn của nó. Nhiều runtime (JVM cũ, Node) từng đọc tổng RAM host thay vì memory.max của cgroup, rồi đặt heap quá lớn và bị OOM kill. Runtime hiện đại đã "cgroup-aware", nhưng vẫn nên kiểm: đặt -Xmx (JVM) hay giới hạn heap phù hợp với --memory, đừng để app tưởng nó có cả host.
--cpus là giới hạn cứng; --cpu-shares là trọng số mềm. --cpus 0.5 chặn cứng ở nửa lõi kể cả khi host rảnh. Nếu bạn muốn "chia công bằng khi tranh chấp nhưng cho dùng thêm khi rảnh", dùng --cpu-shares (trọng số tương đối). Chọn theo mục tiêu: cách ly cứng (giới hạn) hay chia sẻ đàn hồi (shares).
Ba ý mang về
- cgroup là nửa còn lại của container: namespace cô lập tầm nhìn, cgroup giới hạn tài nguyên; giới hạn nằm thật trong
/sys/fs/cgroup(đo thậtmemory.max=64MiB,cpu.max=0.5 lõi), Docker chỉ ghi vào đó còn kernel thực thi. - CPU bị throttle, không bị giết: đo thật cùng workload chạy 1,00s full CPU nhưng 4,00s với
--cpus 0.25— giới hạn CPU điều tiết tốc độ, app vẫn sống. - RAM vượt là bị OOM kill ngay: đo thật
--memory 32mcấp phát vượt →OOMKilled=true, ExitCode=137— nên--memoryphải đặt đủ (dựa trên đo thật), thiếu là crash bí ẩn exit 137.
Nguồn
- man7.org — cgroups(7): https://man7.org/linux/man-pages/man7/cgroups.7.html
- Kernel docs — Control Group v2: https://docs.kernel.org/admin-guide/cgroup-v2.html
- Docker docs — Runtime options with Memory, CPUs: https://docs.docker.com/engine/containers/resource_constraints/
Phần sau ta xem image được dựng thế nào: overlayfs và cơ chế copy-on-write — vì sao nhiều container chạy cùng image chia sẻ được các lớp chỉ-đọc mà vẫn ghi riêng, tiết kiệm đĩa lớn.
