Bạn deploy một service Go lên Kubernetes với giới hạn cpu: "2", chạy trên node 64 nhân. Bên trong pod, runtime.GOMAXPROCS(0) trả về... 64. Runtime của Go dựng 64 P để chạy song song, nhưng nền tảng chỉ cấp cho pod của bạn 2 CPU-giây mỗi giây. Kết quả là một mớ P tranh nhau lượng CPU nhỏ xíu. Đây là một trong những cạm bẫy vận hành phổ biến nhất của Go, và để hiểu đúng nó ta phải phân biệt hai kiểu giới hạn CPU mà đa số người nhầm là một.
Hai kiểu "giới hạn CPU" hoàn toàn khác nhau
Go đặt GOMAXPROCS mặc định bằng runtime.NumCPU(). Vấn đề nằm ở chỗ "số CPU" nghĩa là gì trong một container, vì có hai cơ chế giới hạn CPU khác hẳn nhau:
- cpuset / affinity (
docker --cpuset-cpus,taskset, cpuset cgroup): quyết định tiến trình được phép chạy trên những CPU nào. Đây là một mặt nạ (mask) — ví dụ "chỉ CPU 0 và 1". - CFS bandwidth quota (
docker --cpus=2,cpu.maxquota, Kuberneteslimits.cpu): giới hạn tổng thời gian CPU tiến trình được dùng mỗi chu kỳ. Tiến trình vẫn "thấy" và chạy được trên mọi CPU, nhưng khi dùng hết quota trong chu kỳ, nó bị throttle (đình lại) tới chu kỳ sau.
Điểm mấu chốt: runtime.NumCPU() của Go đọc mặt nạ affinity (sched_getaffinity), không đọc CFS quota. Nên Go hiểu kiểu thứ nhất mà mù kiểu thứ hai.
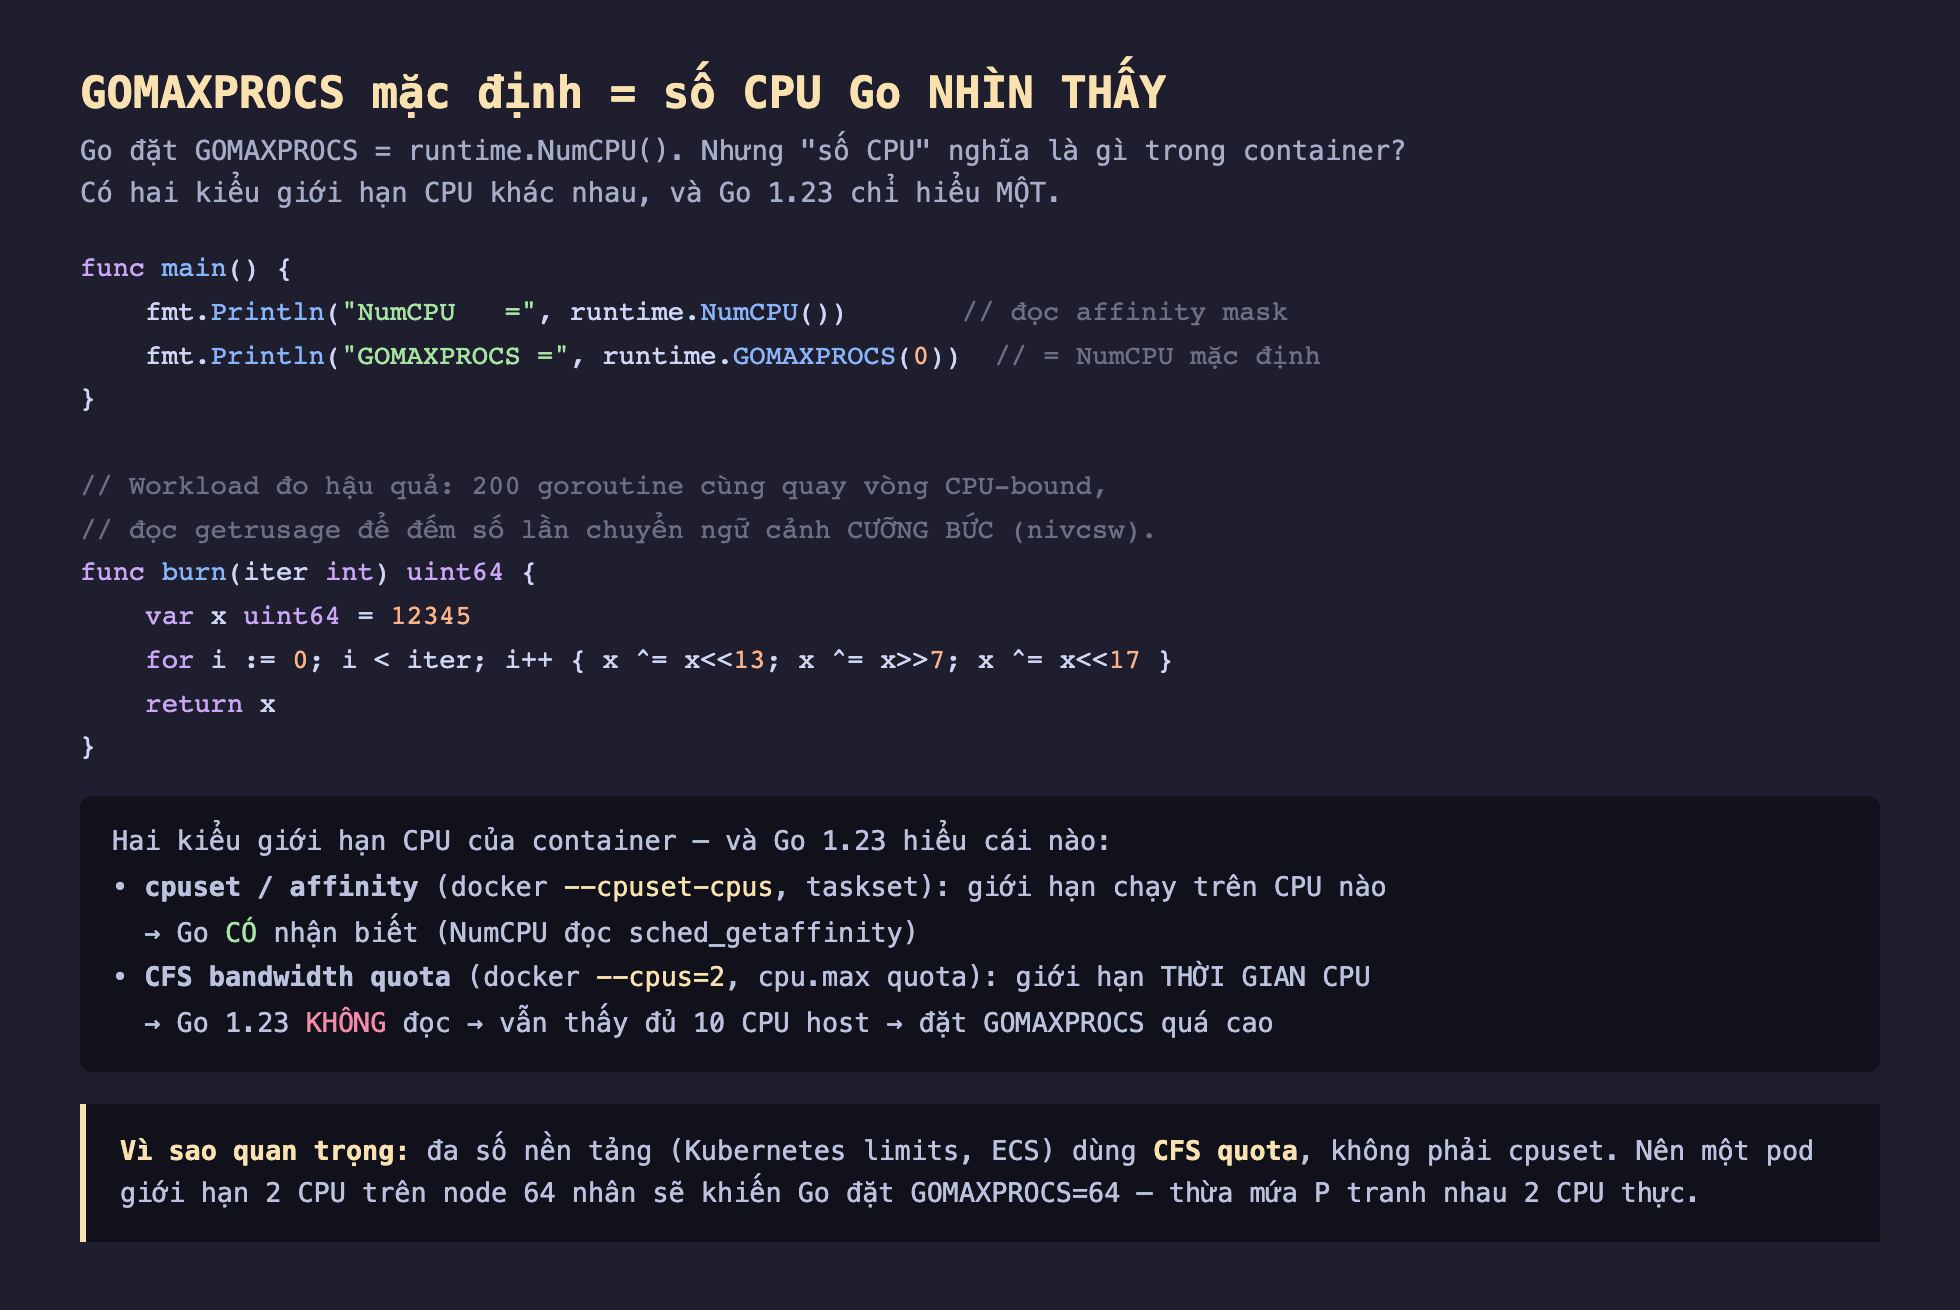
Hình 1: GOMAXPROCS = NumCPU = số CPU trong mặt nạ affinity. cpuset thì Go hiểu; CFS quota thì Go 1.23 bỏ qua — mà K8s/ECS dùng chính CFS quota.
Đo thật: Go hiểu affinity
Trước tiên chứng minh Go có nhận biết affinity. Ghim tiến trình vào 2 CPU bằng taskset -c 0,1 rồi hỏi lại NumCPU:
fmt.Println("NumCPU   =", runtime.NumCPU())
fmt.Println("GOMAXPROCS =", runtime.GOMAXPROCS(0))
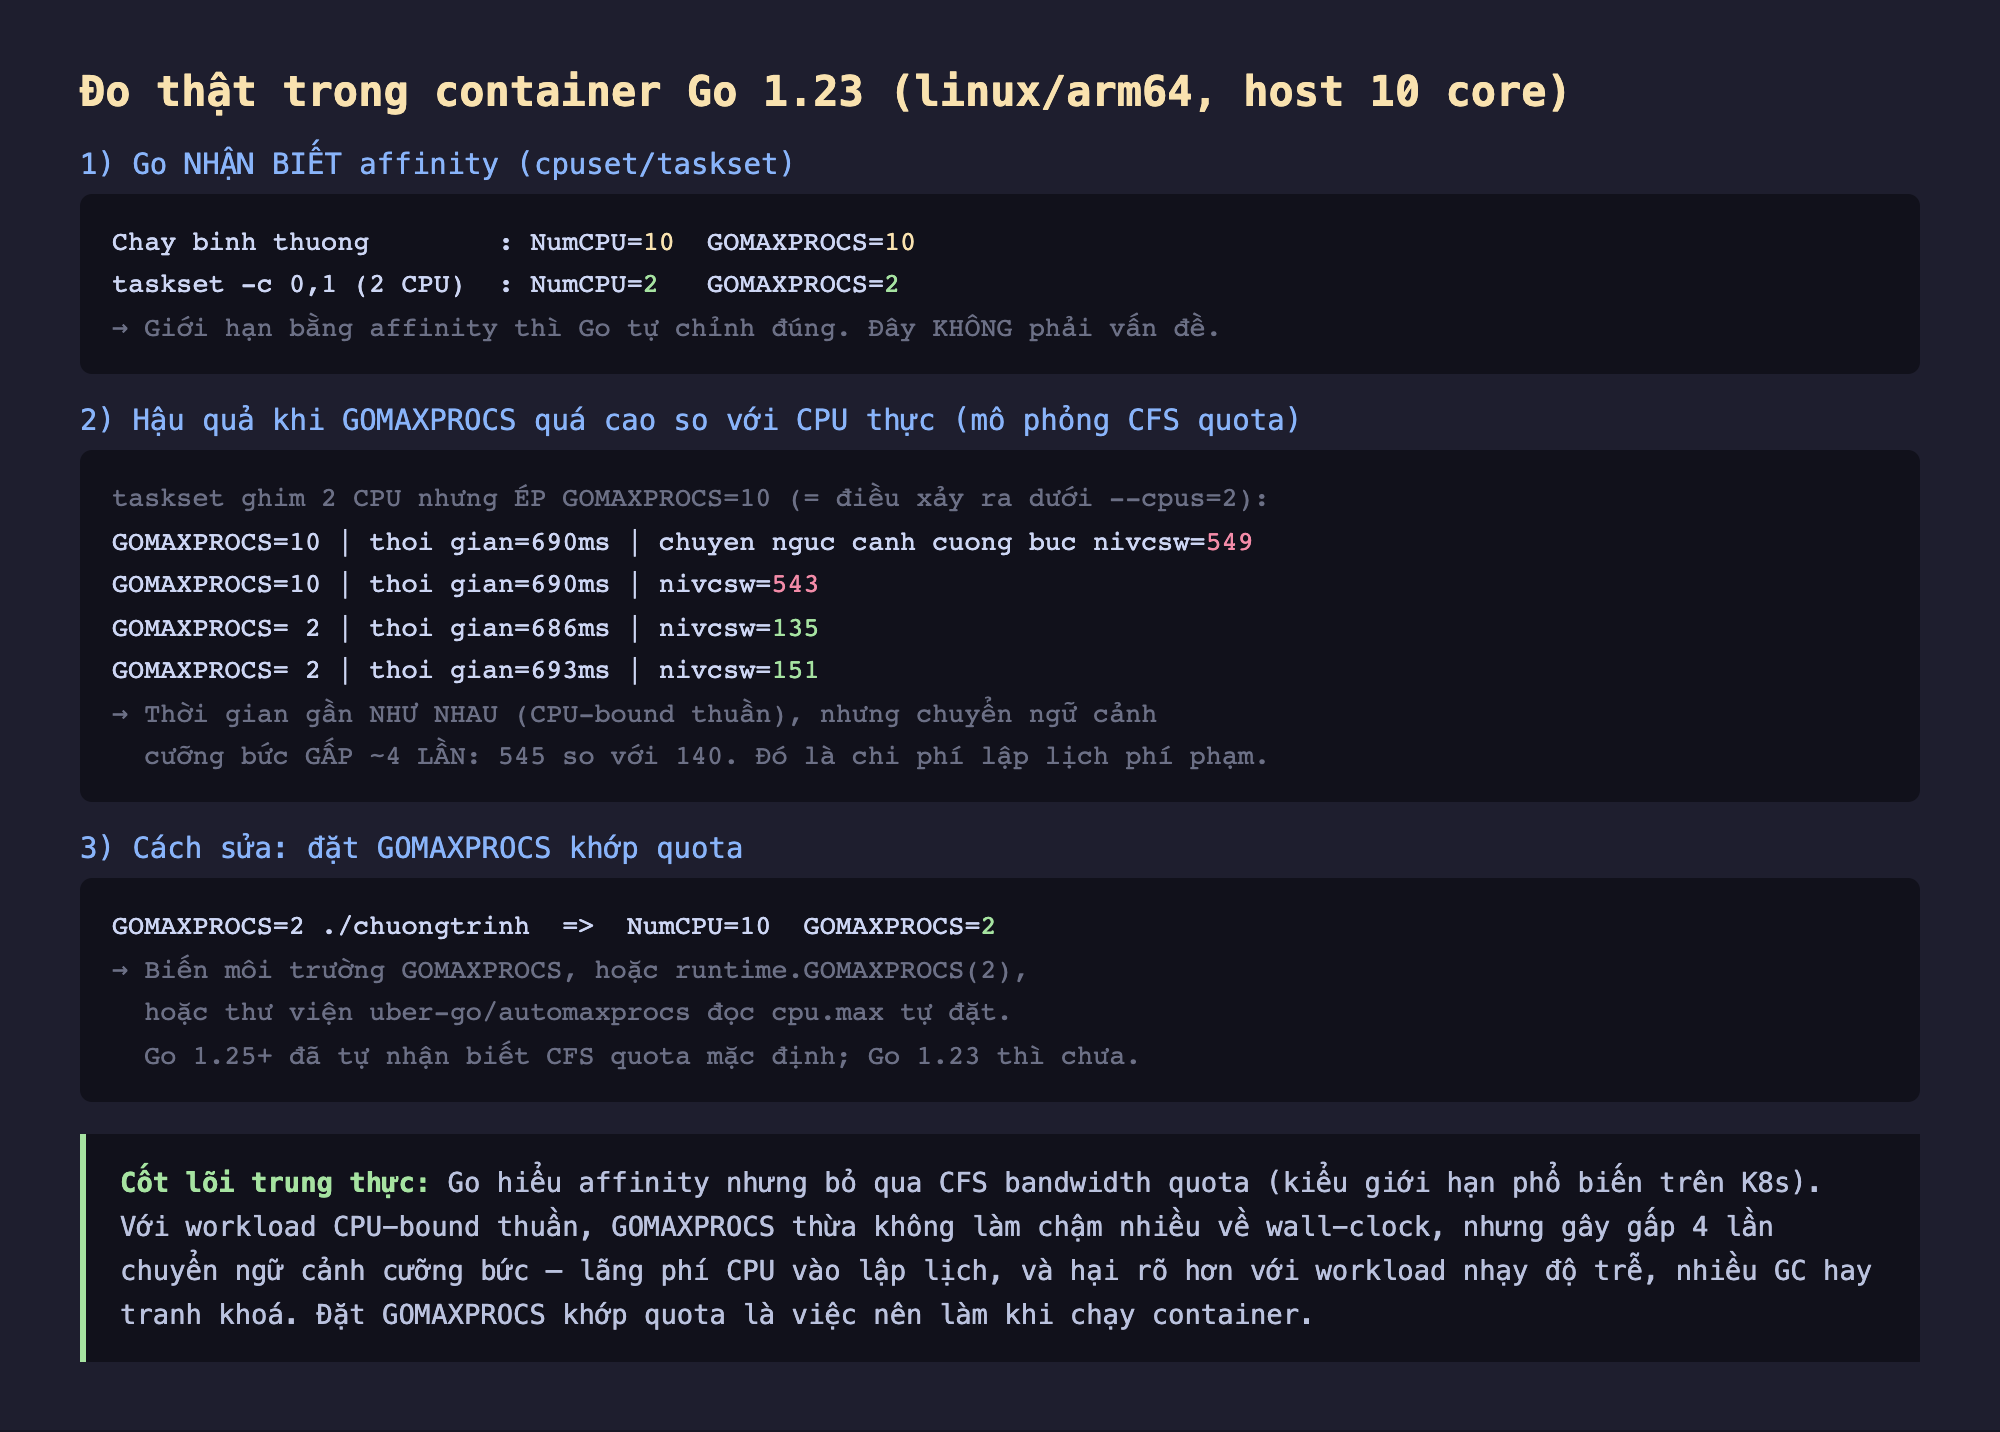
Hình 2: taskset -c 0,1 → NumCPU=2, GOMAXPROCS=2 — Go tự chỉnh đúng theo affinity. Nhưng ép GOMAXPROCS=10 trên 2 CPU thực (mô phỏng CFS quota) làm chuyển ngữ cảnh cưỡng bức gấp 4 lần.
Kết quả: chạy bình thường NumCPU=10; dưới taskset -c 0,1 thì NumCPU=2, GOMAXPROCS=2. Go tự chỉnh đúng theo affinity — đây không phải chỗ có vấn đề. Nếu bạn giới hạn container bằng --cpuset-cpus, Go làm đúng.
Đo thật: hậu quả khi GOMAXPROCS thừa
Vấn đề thật nằm ở CFS quota. Tiếc là bên trong container này cgroup ở chế độ chỉ-đọc nên tôi không đặt được quota thật để đo. Nhưng tôi mô phỏng triệu chứng — GOMAXPROCS cao hơn số CPU thực sự chạy — bằng cách ghim 2 CPU (taskset -c 0,1) nhưng ép GOMAXPROCS=10, đúng như điều xảy ra dưới --cpus=2 với mặc định của Go. Workload là 200 goroutine CPU-bound, đo số lần chuyển ngữ cảnh cưỡng bức (nivcsw từ getrusage):
var ru0, ru1 syscall.Rusage
syscall.Getrusage(syscall.RUSAGE_SELF, &ru0)
// ... chạy 200 goroutine burn() ...
syscall.Getrusage(syscall.RUSAGE_SELF, &ru1)
fmt.Println("nivcsw =", ru1.Nivcsw-ru0.Nivcsw)  // chuyển ngữ cảnh cưỡng bức
GOMAXPROCS=10trên 2 CPU: thời gian ~690 ms, nivcsw ≈ 545.GOMAXPROCS=2trên 2 CPU: thời gian ~690 ms, nivcsw ≈ 140.
Nói thẳng và trung thực: với workload CPU-bound thuần này, thời gian gần như không đổi — vì tổng công việc là cố định và hệ điều hành vẫn chia đều 2 CPU cho dù có 10 hay 2 luồng. Nhưng số lần chuyển ngữ cảnh cưỡng bức gấp khoảng 4 lần (545 so với 140). Đó là chi phí lập lịch phí phạm thuần túy: 10 luồng OS tranh nhau 2 CPU, bị kernel ngắt qua lại liên tục, kéo theo mất mát cache mỗi lần chuyển.
Hậu quả trên wall-clock nhỏ ở đây, nhưng nó lớn hơn hẳn với các workload thực tế: nhạy độ trễ (tail latency phình vì goroutine bị throttle giữa chừng khi hết quota), nhiều GC (thừa P nghĩa là thừa goroutine assist tranh CPU khi thu gom), hoặc tranh khoá. Đây là lý do các đội vận hành Go trên K8s coi việc chỉnh GOMAXPROCS là chuẩn mực.
Cách sửa
Đặt biến môi trường GOMAXPROCS. Cách đơn giản nhất, không đổi code: đặt GOMAXPROCS=2 khớp với limits.cpu. Đo thật: GOMAXPROCS=2 ./chương-trình cho NumCPU=10 nhưng GOMAXPROCS=2.
Dùng uber-go/automaxprocs. Import _ "go.uber.org/automaxprocs" — thư viện này đọc cpu.max (CFS quota) lúc khởi động và tự đặt GOMAXPROCS khớp. Đây là giải pháp phổ biến nhất cho Go ≤ 1.24 trên K8s.
Nâng lên Go 1.25+. Từ Go 1.25, runtime tự nhận biết CFS quota cgroup theo mặc định và đặt GOMAXPROCS cho khớp (điều chỉnh được qua GODEBUG=containermaxprocs). Nếu đang ở Go 1.23 như container này, hành vi đó chưa có sẵn — phải tự lo.
Đánh đổi cần cân nhắc
Đừng đặt GOMAXPROCS quá thấp. Nếu limits.cpu là phân số (ví dụ 500m = 0,5 CPU), đặt GOMAXPROCS=0 là không hợp lệ; tối thiểu nên là 1. Và nếu request/limit chênh nhau nhiều, đặt theo limit có thể bỏ phí lúc node rảnh. Cân nhắc đặt theo request nếu bạn ưu tiên thông lượng khi có tài nguyên dư.
GOMAXPROCS không phải giới hạn số goroutine. Nó chỉ là số P (số goroutine chạy song song tối đa). Bạn vẫn spawn hàng nghìn goroutine như thường; chúng chỉ được ghép lên số P này. Giảm GOMAXPROCS không giảm khả năng đồng thời, chỉ khớp mức song song với CPU thực.
Đo trước khi chỉnh trên workload cụ thể. Như phép đo cho thấy, hại của GOMAXPROCS thừa phụ thuộc bản chất workload — CPU-bound thuần ít bị, còn nhạy-độ-trễ/nhiều-GC bị nặng. Đừng chỉnh mù; đo tail latency và mức throttle (container_cpu_cfs_throttled_periods_total) trước và sau.
Ba ý mang về
- Có hai kiểu giới hạn CPU khác nhau: affinity (cpuset/taskset) mà Go nhận biết qua
NumCPU(đo thật taskset → NumCPU=2), và CFS bandwidth quota (--cpus, K8slimits.cpu) mà Go 1.23 bỏ qua — mà K8s lại dùng chính kiểu thứ hai. - GOMAXPROCS thừa gây lãng phí lập lịch: đo thật, GOMAXPROCS=10 trên 2 CPU cho số chuyển ngữ cảnh cưỡng bức gấp ~4 lần (545 so với 140); wall-clock của CPU-bound thuần ít đổi, nhưng workload nhạy độ trễ/nhiều GC bị hại nặng hơn.
- Sửa bằng cách đặt GOMAXPROCS khớp quota: biến môi trường
GOMAXPROCS, thư việnuber-go/automaxprocsđọccpu.max, hoặc nâng lên Go 1.25+ (tự nhận biết CFS quota mặc định) — và luôn đo tail latency, throttle trước/sau khi chỉnh.
Bài tập làm thử
Bài 1 (đọc hiểu). Một pod Kubernetes chạy Go 1.23 có limits.cpu: "2" (giới hạn kiểu CFS bandwidth quota) trên một node vật lý 64 nhân, và pod không đặt --cpuset-cpus hay bất kỳ ràng buộc affinity nào. Dựa theo phân biệt trong bài giữa cpuset/affinity và CFS quota, runtime.NumCPU() và runtime.GOMAXPROCS(0) bên trong pod sẽ trả về bao nhiêu? Giải thích tại sao.
Đáp án
Cả hai sẽ trả về 64 (số CPU thực của node), không phải 2. runtime.NumCPU() đọc mặt nạ affinity qua sched_getaffinity — với limits.cpu (CFS quota), tiến trình vẫn được phép chạy trên mọi CPU của node (không có mặt nạ affinity nào giới hạn), chỉ bị giới hạn tổng thời gian CPU mỗi chu kỳ. Go 1.23 không đọc CFS quota (cpu.max), nên nó "mù" trước giới hạn thật sự mà Kubernetes áp đặt, dẫn tới GOMAXPROCS mặc định bằng 64 — thừa mứa so với 2 CPU-giây/giây thực sự được cấp.
Bài 2 (sửa lỗi). Một kỹ sư muốn "reset" GOMAXPROCS về giá trị tự động nhận diện lại (ví dụ sau khi container bị đổi giới hạn CPU khi đang chạy), nên viết:
func resetGOMAXPROCS() {
    runtime.GOMAXPROCS(0) // tưởng là "tự nhận diện lại số CPU"
    fmt.Println("Đã đặt lại GOMAXPROCS theo CPU hiện tại")
}
Đoạn code này có đạt được mục đích không? Giải thích hành vi thật của runtime.GOMAXPROCS(0).
Đáp án
Không đạt được mục đích. Gọi runtime.GOMAXPROCS(0) không đặt lại hay tính toán lại giá trị nào — theo tài liệu runtime, tham số n <= 0 chỉ khiến hàm không thay đổi gì cả và trả về giá trị GOMAXPROCS hiện tại (dùng để đọc giá trị, không phải để đặt). Nó không gọi lại sched_getaffinity hay tính lại số CPU. Muốn đổi GOMAXPROCS theo số CPU khả dụng mới, phải tự đọc lại nguồn thông tin đúng (ví dụ đọc lại affinity mask, hoặc dùng thư viện như automaxprocs đọc cpu.max) rồi gọi runtime.GOMAXPROCS(n) với n là con số dương cụ thể.
Bài 3 (vận dụng). Một dịch vụ Go 1.23 chạy trên Kubernetes với limits.cpu: "500m" (nửa CPU). Theo các lưu ý "Đánh đổi cần cân nhắc" trong bài, bạn nên đặt GOMAXPROCS bằng bao nhiêu, và vì sao không nên đặt GOMAXPROCS=0?
Đáp án
Nên đặt tối thiểu là 1. Bài nói rõ: "nếu limits.cpu là phân số (ví dụ 500m = 0,5 CPU), đặt GOMAXPROCS=0 là không hợp lệ; tối thiểu nên là 1." Vì GOMAXPROCS là số nguyên P chạy song song, không thể biểu diễn "nửa P" — 500m CPU vẫn cần ít nhất một P để có goroutine nào đó chạy được; đặt 0 không có ý nghĩa đặt (và như bài 2 đã chỉ ra, gọi GOMAXPROCS(0) chỉ là đọc giá trị chứ không đặt).
Bài 4 (bẫy/đánh đổi). Phép đo mô phỏng trong bài (taskset -c 0,1 nhưng ép GOMAXPROCS=10) cho thấy: thời gian chạy ~690ms so với ~686ms (gần như không đổi) khi GOMAXPROCS=2, nhưng số lần chuyển ngữ cảnh cưỡng bức (nivcsw) là 545 so với 140 — gấp khoảng 4 lần. Với workload CPU-bound thuần này, GOMAXPROCS thừa có đáng lo không? Loại workload nào theo bài sẽ bị ảnh hưởng nặng hơn, và nên đo chỉ số gì trước khi quyết định chỉnh?
Đáp án
Với workload CPU-bound thuần, tác động lên wall-clock gần như không đáng kể — vì tổng công việc cố định và hệ điều hành vẫn chia đều CPU thực cho dù có bao nhiêu luồng tranh nhau; chi phí thêm chỉ là chuyển ngữ cảnh cưỡng bức (~4 lần) do 10 luồng OS tranh 2 CPU thật, kèm mất mát cache mỗi lần chuyển. Nhưng bài cảnh báo các workload khác sẽ bị hại nặng hơn: workload nhạy độ trễ (tail latency phình vì goroutine bị throttle giữa chừng khi hết quota CFS) và workload nhiều GC (thừa P nghĩa là thừa goroutine assist tranh CPU lúc thu gom). Trước khi chỉnh GOMAXPROCS trên production, nên đo tail latency và mức throttle qua chỉ số container_cpu_cfs_throttled_periods_total, chứ không nên "chỉnh mù".
Phần sau ta đi sâu hơn vào chính cấu trúc mà GOMAXPROCS điều khiển: Phần sau mổ xẻ hàng đợi chạy cục bộ (mỗi P) và hàng đợi toàn cục — vì sao có hai loại, khi nào goroutine rơi vào cái nào, và ảnh hưởng tới độ trễ lập lịch.
