Khi bạn viết go f(), goroutine mới đó đi đâu để chờ tới lượt chạy? Câu trả lời không phải "một hàng đợi" mà là một hệ thống hai tầng được thiết kế tinh tế để cân bằng giữa tốc độ (không tranh khoá) và công bằng (không bỏ đói goroutine nào). Bài này mổ xẻ hai loại hàng đợi chạy của bộ lập lịch Go và đo trực tiếp bằng schedtrace để thấy chúng hoạt động thật.
Ba nơi một goroutine có thể chờ
Trong mô hình GMP, mỗi P (processor logic) không chỉ là một "khe chạy" — nó còn giữ một hàng đợi các goroutine đang chờ tới lượt. Khi lập lịch, runtime tìm goroutine kế tiếp theo thứ tự ưu tiên ở ba nơi:
runnext: một ô đặc biệt chỉ chứa một goroutine — cái vừa được đánh thức/tạo ra gần nhất. Nó được chạy ngay tiếp theo, bỏ qua cả hàng đợi. Đây là tối ưu locality: khi goroutine A gửi vào channel đánh thức B, B vàorunnextvà chạy liền, giữ dữ liệu còn nóng trong cache.- Local run queue của P hiện tại: một hàng đợi vòng, tối đa 256 slot, và quan trọng là không cần khoá — chỉ P sở hữu nó mới lấy/bỏ, nên thao tác cực nhanh không tranh chấp.
- Global run queue: một hàng đợi chung cho mọi P, có khoá. Nó nhận phần tràn khi local đầy, và là nơi các P rảnh tới lấy việc.
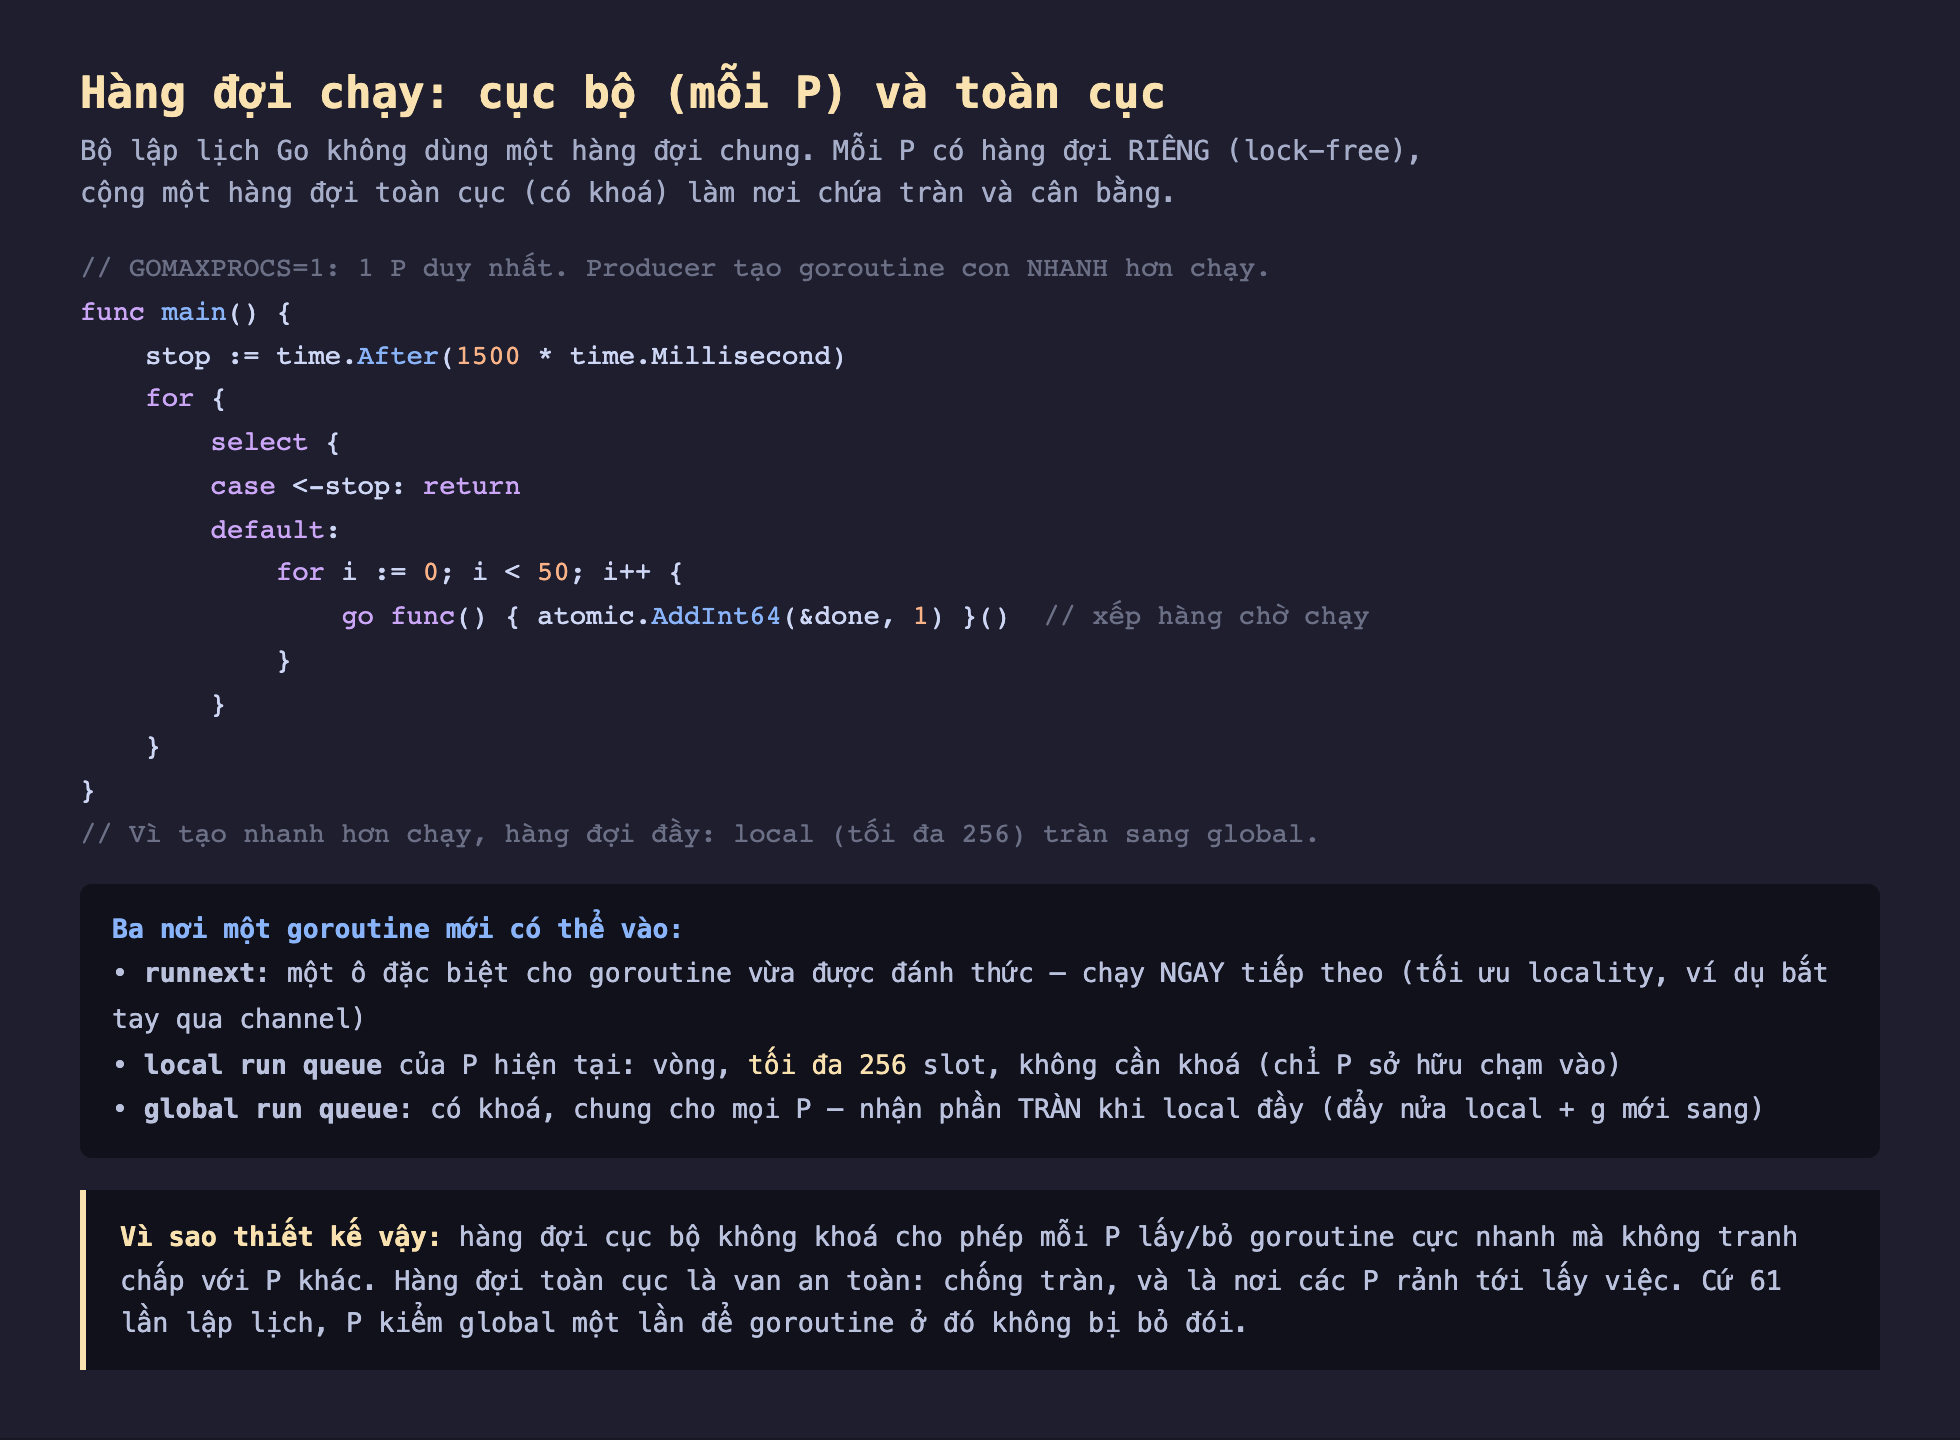
Hình 1: Ba nơi goroutine chờ chạy: runnext (một ô, ưu tiên cao nhất), local queue của P (≤256, lock-free), global queue (có khoá, nhận tràn).
Đo thật bằng schedtrace
Để thấy sự phân chia local/global, ta tạo một tình huống ép hàng đợi tràn: GOMAXPROCS=1 (một P duy nhất) và một producer liên tục tạo goroutine con nhanh hơn tốc độ chúng được chạy. Các con chỉ tăng một biến đếm rồi thoát, nên chúng xếp hàng chờ.
for {
    select {
    case <-stop: return
    default:
        for i := 0; i < 50; i++ {
            go func() { atomic.AddInt64(&done, 1) }()  // xếp hàng chờ
        }
    }
}
Bật GODEBUG=schedtrace=100 — cột [N] cuối mỗi dòng là số goroutine trong local queue của P, còn runqueue= là số trong global queue:
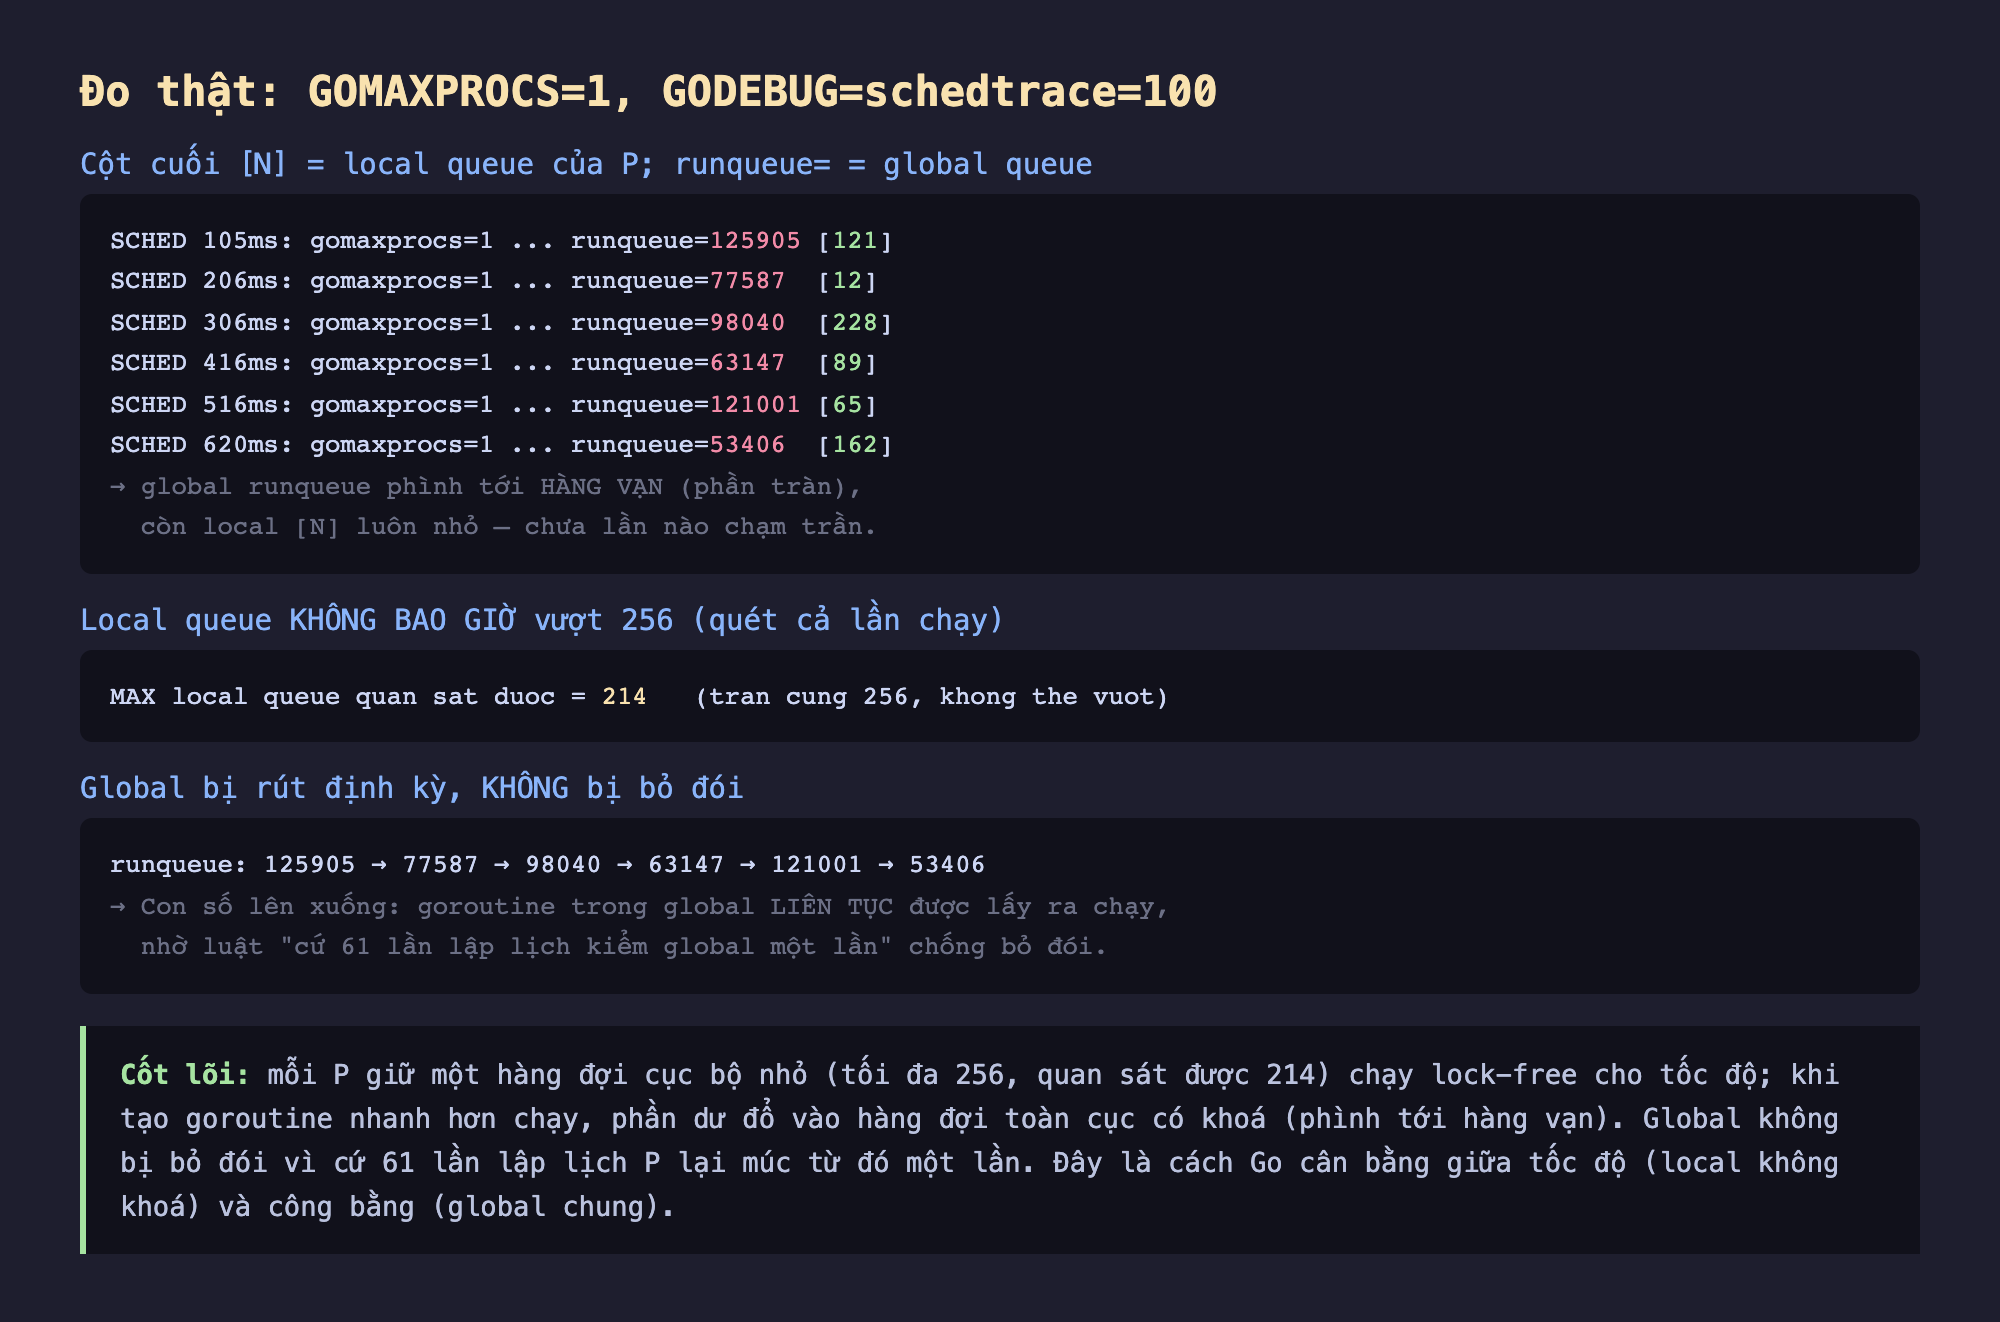
Hình 2: Global runqueue phình tới hàng vạn (phần tràn), local [N] luôn nhỏ. Quét cả lần chạy, max local = 214, không bao giờ vượt trần 256. Global lên xuống → không bị bỏ đói.
Kết quả nói rõ cơ chế:
- Local queue không bao giờ vượt 256. Quét toàn bộ lần chạy, giá trị local cao nhất quan sát được là 214 — luôn dưới trần cứng 256. Trần này là kích thước cố định của mảng
runq [256]guintptrtrong structpcủa runtime: mỗi P chỉ giữ được 256 goroutine trong hàng đợi riêng. - Global queue nhận phần tràn.
runqueue=phình tới hàng vạn (125.905, 98.040...). Khi producer tạo goroutine mà local đầy, runtime đẩy nửa local queue cộng goroutine mới sang global — một lần chuyển theo lô, không phải từng cái. - Global không bị bỏ đói. Con số global lên xuống (125905 → 77587 → 98040...), nghĩa là goroutine trong global liên tục được lấy ra chạy. Đây là nhờ một luật quan trọng: cứ 61 lần lập lịch, P kiểm tra global queue một lần thay vì luôn ưu tiên local — nếu không, goroutine lỡ rơi vào global sẽ chờ mãi khi local luôn có việc.
Vì sao thiết kế hai tầng
Câu hỏi tự nhiên: sao không dùng một hàng đợi chung cho gọn? Vì tranh khoá. Nếu mọi P dùng chung một hàng đợi có khoá, thì với GOMAXPROCS=10, mười P sẽ liên tục giành khoá đó mỗi lần lấy/bỏ goroutine — một điểm nghẽn kinh khủng. Hàng đợi cục bộ giải quyết: mỗi P thao tác trên queue riêng không cần khoá, vì không P nào khác chạm vào (trừ lúc bị "trộm việc" — work stealing, đã đo ở bài trước). Global queue chỉ là van an toàn cho phần tràn và điểm gặp cho các P rảnh.
Sự kết hợp này cho cả tốc độ (đường nóng lock-free) lẫn cân bằng (P rảnh lấy được việc từ global hoặc trộm từ P bận).
Ứng dụng thực tế
Hiểu runnext để hiểu vì sao channel nhanh. Khi hai goroutine bắt tay qua channel không đệm, goroutine được đánh thức vào runnext và chạy ngay — đó là lý do ping-pong channel chỉ ~150 ns (bài chuyển ngữ cảnh đã đo). Nếu bạn thấy một mẫu producer-consumer chạy nhanh bất ngờ, runnext thường là công thần.
Bùng nổ goroutine đổ gánh nặng lên global queue. Nếu code tạo hàng vạn goroutine ngắn trong thời gian ngắn (như phép đo này), phần lớn rơi vào global queue có khoá — thao tác chậm hơn local. Với workload tạo goroutine cực nhiều, gộp việc (worker pool tái dùng goroutine) giảm áp lực này. Nhưng đừng tối ưu sớm: với đa số ứng dụng, chi phí này không đáng kể.
schedtrace là công cụ chẩn đoán tồn đọng lập lịch. Cột runqueue và [N] cho biết goroutine có đang chất đống chờ chạy không. runqueue lớn kéo dài nghĩa là bạn tạo việc nhanh hơn CPU xử lý — cần thêm P (nếu bị giới hạn GOMAXPROCS) hoặc giảm tốc tạo goroutine.
Đánh đổi cần cân nhắc
runnext có thể gây bất công cục bộ. Vì goroutine mới đánh thức nhảy vào runnext và chạy trước cả hàng đợi, một cặp goroutine "nói chuyện" liên tục qua channel có thể tạm chiếm P, đẩy các goroutine trong local queue chờ. Runtime chống điều này bằng cách giới hạn thời gian và luật kiểm global 61-tick, nhưng đây là đánh đổi có chủ đích: ưu tiên locality hơn công bằng tuyệt đối ở quy mô nhỏ.
Trần 256 là cố định. Bạn không chỉnh được kích thước local queue. Nếu workload tạo goroutine theo cụm lớn, phần tràn bắt buộc qua global có khoá — không có cách "nới" local. Cách duy nhất giảm áp lực global là tạo goroutine đều hơn hoặc dùng worker pool.
Trộm việc và global queue là hai cơ chế cân bằng khác nhau. P rảnh trước tiên thử lấy từ global, rồi mới trộm từ local queue của P khác. Đừng nhầm: global queue là nơi chứa tràn chủ động, còn trộm việc là cơ chế kéo khi cả global cũng cạn (chi tiết ở bài work-stealing).
Ba ý mang về
- Bộ lập lịch Go dùng hàng đợi hai tầng: mỗi P có local run queue lock-free tối đa 256 slot (đo thật max 214, không bao giờ vượt), cộng một global run queue có khoá nhận phần tràn — đo thật global phình tới hàng vạn khi tạo goroutine nhanh hơn chạy.
runnextlà ô ưu tiên cao nhất cho goroutine vừa đánh thức, chạy ngay để giữ locality — đây là nền tảng khiến bắt tay qua channel nhanh.- Local lock-free cho tốc độ, global chung cho công bằng: global không bị bỏ đói nhờ luật "cứ 61 lần lập lịch kiểm global một lần" (đo thật global liên tục được rút) — thiết kế cân bằng giữa tránh tranh khoá và không bỏ sót goroutine.
Bài tập làm thử
Bài 1 (đọc hiểu). Bài viết đo bằng GODEBUG=schedtrace=100 với GOMAXPROCS=1 và một producer liên tục tạo 50 goroutine mỗi vòng lặp:
for {
    select {
    case <-stop:
        return
    default:
        for i := 0; i < 50; i++ {
            go func() { atomic.AddInt64(&done, 1) }() // xếp hàng chờ
        }
    }
}
Kết quả quan sát được gồm các dòng như SCHED 105ms runqueue=125905 [121], SCHED 206ms runqueue=77587 [12], SCHED 306ms runqueue=98040 [228]... với giá trị [N] cao nhất quan sát được trong cả lần chạy là 214. Dựa vào ba nơi một goroutine có thể chờ (runnext, local queue, global queue) mà bài mô tả, hãy giải thích ý nghĩa của cột runqueue= và cột [N], và tại sao [N] không bao giờ vượt quá 256 dù producer tạo goroutine liên tục.
Đáp án
runqueue= là số goroutine đang chờ trong global run queue (hàng đợi chung có khoá, dùng cho phần tràn), còn [N] là số goroutine trong local run queue của P hiện tại (hàng đợi vòng lock-free, chỉ P đó thao tác được). [N] không bao giờ vượt 256 vì đó là trần cứng cố định của local queue (hằng số kích thước trong runtime) — khi local queue đầy, runtime không cho phép thêm goroutine mới vào đó nữa mà đẩy phần tràn (nửa local queue cộng goroutine mới) sang global queue theo lô. Đó là lý do runqueue (global) phình tới hàng vạn trong khi [N] (local) luôn ở mức thấp, max quan sát được chỉ là 214.
Bài 2 (sửa lỗi/hiểu sai). Một comment trong code review viết:
// Runtime luôn ưu tiên phục vụ global run queue trước, vì nó chứa
// những goroutine "chờ lâu nhất" — local queue của P chỉ được xét
// đến khi global queue đã rỗng hoàn toàn.
Nhận định này có đúng với cơ chế lập lịch mà bài mô tả không? Sửa lại cho đúng.
Đáp án
Sai. Runtime ưu tiên theo thứ tự ngược lại: đầu tiên là runnext (một ô đặc biệt, ưu tiên cao nhất, cho goroutine vừa được đánh thức/tạo ra gần nhất), rồi mới đến local run queue của P hiện tại (lock-free, nhanh vì không tranh chấp), và global queue chỉ được kiểm tra định kỳ — cứ mỗi 61 lần lập lịch thì P mới ghé kiểm tra global queue một lần, chứ không phải chờ local rỗng. Luật 61-tick này tồn tại chính là để chống bỏ đói global queue (vì nếu chỉ ưu tiên tuyệt đối local/runnext, goroutine rơi vào global có thể chờ mãi khi local luôn có việc).
Bài 3 (vận dụng). Với GOMAXPROCS=1 và producer tạo goroutine nhanh hơn tốc độ tiêu thụ (như phép đo trong bài), hãy mô tả từng bước điều gì xảy ra với một goroutine mới được tạo ra bằng go func(){...}(): nó vào đâu trước, và khi nào nó bị đẩy sang global queue?
Đáp án
Goroutine mới trước tiên cố gắng vào local run queue của P đang tạo ra nó (hàng đợi vòng tối đa 256 slot, lock-free). Khi local queue đã đầy (chạm 256), runtime thực hiện một lần chuyển theo lô: đẩy nửa local queue hiện tại cộng với goroutine mới sang global run queue (có khoá) trong một thao tác, chứ không đẩy từng cái một. Vì producer trong phép đo tạo nhanh hơn nhiều so với tốc độ P xử lý (chỉ một P), phần lớn khối lượng goroutine dồn về global queue, khiến runqueue= phình tới hàng vạn trong khi local [N] luôn ở mức thấp.
Bài 4 (bẫy/đánh đổi). Bài viết chỉ ra runnext có thể gây "bất công cục bộ". Giải thích cơ chế gây bất công đó là gì, và runtime dùng luật nào để hạn chế nó mà vẫn giữ được lợi ích locality của runnext?
Đáp án
Vì goroutine vừa được đánh thức/tạo ra nhảy thẳng vào runnext và được chạy ngay tiếp theo, bỏ qua toàn bộ hàng đợi — nếu hai goroutine liên tục "nói chuyện" qua lại với nhau (ví dụ ping-pong qua channel), chúng có thể tạm thời chiếm dụng P, đẩy lùi các goroutine đang xếp hàng trong local queue. Runtime hạn chế điều này bằng cách giới hạn thời gian chiếm dụng và áp dụng luật kiểm tra global queue định kỳ (cứ 61 lần lập lịch một lần) để không goroutine nào bị bỏ đói vĩnh viễn. Đây là đánh đổi có chủ đích: ưu tiên locality (giữ dữ liệu nóng trong cache, giải thích vì sao ping-pong qua channel chỉ tốn ~150ns) hơn là công bằng tuyệt đối ở quy mô nhỏ.
Phần sau ta chuyển sang một trụ cột khác của hiệu năng Go — quyết định biến nằm ở đâu: Phần sau mổ xẻ escape analysis, cách trình biên dịch quyết định biến ở lại stack hay thoát lên heap, và đọc chính output -gcflags=-m để biết.
