Ai cũng biết "goroutine rẻ hơn thread", nhưng câu đó thường dừng ở kích thước stack (bài trước đã đo: 2KB so với 8MB). Có một chiều thứ hai quan trọng không kém: chi phí chuyển ngữ cảnh — mỗi lần trao quyền chạy từ đơn vị này sang đơn vị kia tốn bao nhiêu. Bài này đo trực tiếp trong container Go 1.23, so chuyển giữa hai goroutine với chuyển giữa hai OS thread, và con số chênh nhau tới 130 lần.
Hai kiểu chuyển ngữ cảnh
"Chuyển ngữ cảnh" (context switch) là hành động dừng đơn vị đang chạy, lưu trạng thái của nó (thanh ghi, con trỏ stack), rồi khôi phục và chạy tiếp một đơn vị khác. Điểm mấu chốt là ai làm việc đó và ở đâu:
- Chuyển goroutine: do bộ lập lịch của Go làm, hoàn toàn trong user-space. Nó chỉ lưu vài thanh ghi cần thiết rồi đổi sang stack của goroutine khác. Không gọi vào kernel.
- Chuyển OS thread: do bộ lập lịch của kernel làm. Phải đi qua syscall (trap vào kernel), kernel chọn thread kế, khôi phục toàn bộ trạng thái, và thường làm mất hiệu lực một phần TLB/cache. Đắt hơn nhiều bậc.
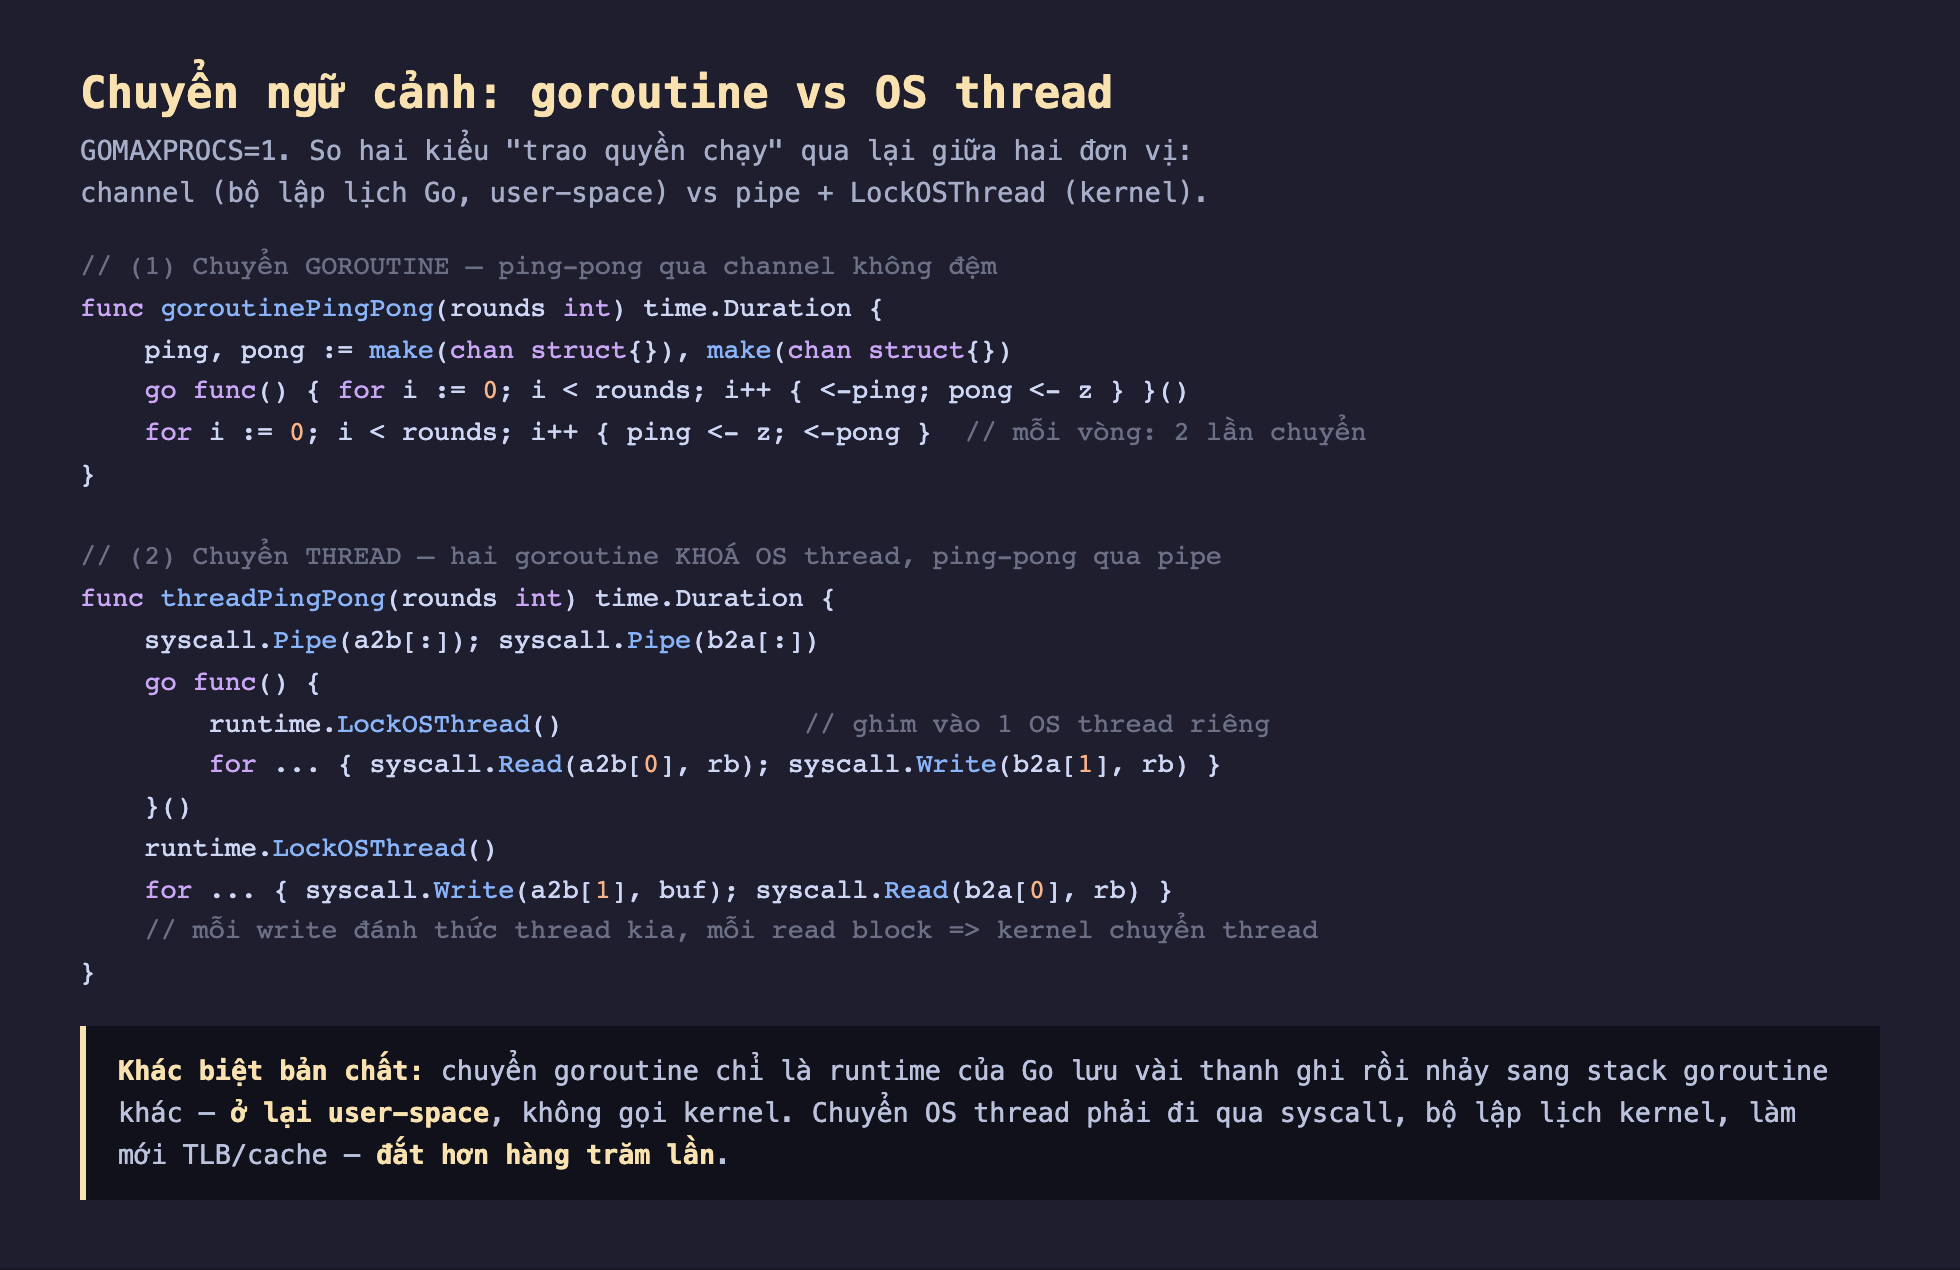
Hình 1: Hai cách trao quyền chạy. Channel dùng bộ lập lịch Go (user-space); pipe + LockOSThread buộc kernel chuyển giữa hai OS thread thật.
Đo thật: ping-pong 1 triệu vòng
Cách đo công bằng nhất là cho hai đơn vị "ném bóng" qua lại đúng một triệu lần và bấm giờ. Với goroutine, ta dùng hai channel không đệm; với thread, ta khoá mỗi goroutine vào một OS thread riêng (runtime.LockOSThread) và cho chúng ping-pong qua pipe bằng syscall.
func goroutinePingPong(rounds int) time.Duration {
    ping, pong := make(chan struct{}), make(chan struct{})
    go func() { for i := 0; i < rounds; i++ { <-ping; pong <- struct{}{} } }()
    start := time.Now()
    for i := 0; i < rounds; i++ { ping <- struct{}{}; <-pong }  // mỗi vòng 2 lần chuyển
    return time.Since(start)
}
Đặt GOMAXPROCS(1) để cả hai goroutine buộc phải luân phiên trên cùng một P — mỗi lần gửi/nhận là một lần bộ lập lịch thực sự chuyển ngữ cảnh. Kết quả:
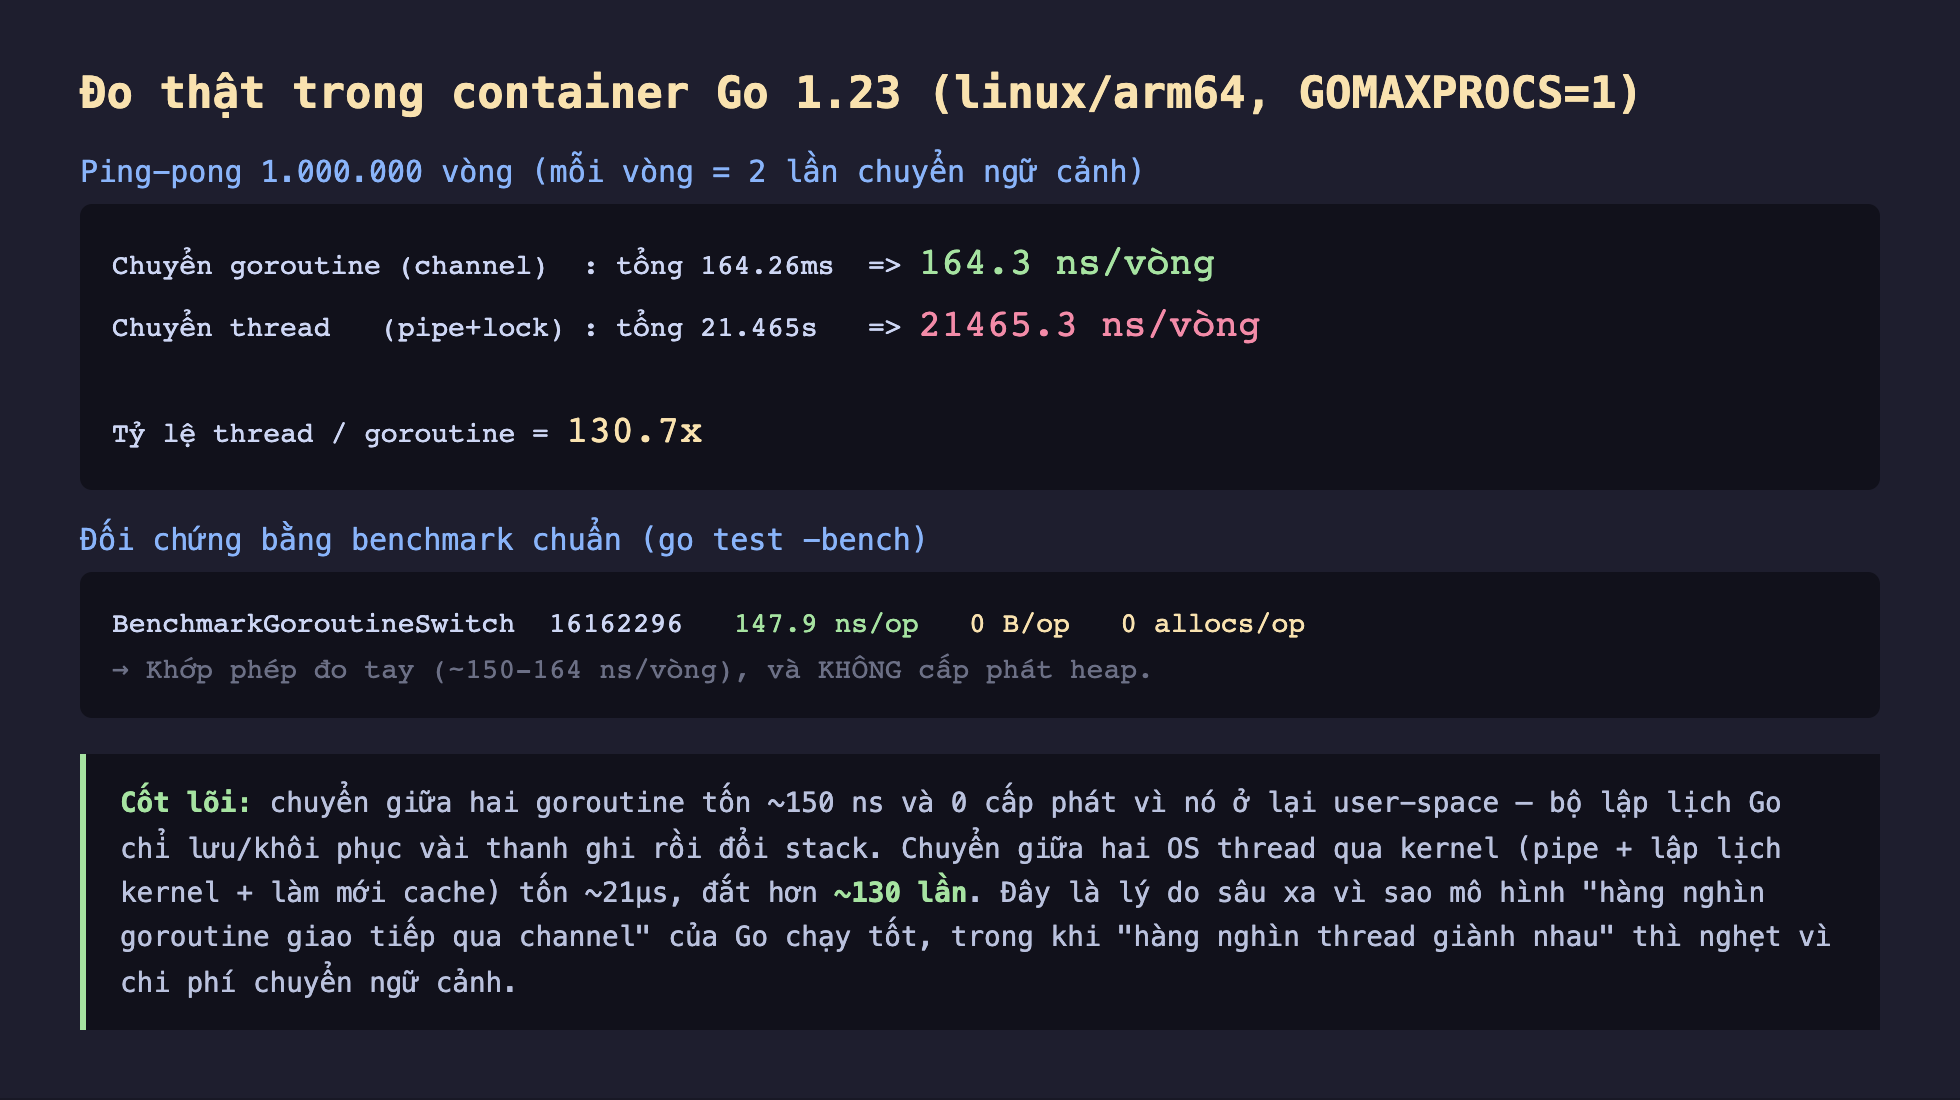
Hình 2: Chuyển goroutine 164 ns/vòng; chuyển thread 21465 ns/vòng — chênh 130,7 lần. Benchmark chuẩn xác nhận 147,9 ns/op và 0 cấp phát.
Con số rõ ràng: 164,3 ns mỗi vòng cho goroutine, 21.465 ns mỗi vòng cho OS thread — thread đắt hơn 130,7 lần. Vì mỗi vòng gồm hai lần chuyển (đi và về), chi phí một lần chuyển goroutine là khoảng 80 ns, còn một lần chuyển thread khoảng 10,7 µs.
Để chắc chắn con số goroutine không phải ngẫu nhiên, tôi chạy lại bằng benchmark chuẩn: BenchmarkGoroutineSwitch cho 147,9 ns/op và quan trọng là 0 B/op, 0 allocs/op — chuyển goroutine không hề chạm tới heap, nên không tạo áp lực cho GC. Con số khớp phép đo tay.
Vì sao thread đắt đến vậy
Phần lớn 21 µs của thread đến từ việc phải xuống kernel: mỗi syscall.Write là một trap đánh thức thread đang block trong syscall.Read, và kernel phải chạy bộ lập lịch của nó để chọn và khôi phục thread kia. Ngoài chi phí trap thuần, còn có cái giá gián tiếp: chuyển thread thường kéo theo mất mát cache và TLB vì hai thread có thể có không gian làm việc khác nhau. Goroutine tránh toàn bộ điều đó — nó ở trong cùng một tiến trình, cùng một OS thread (khi chưa cần đổi M), bộ lập lịch Go chỉ đổi con trỏ stack và vài thanh ghi.
Cần nói thẳng cho công bằng: phép đo thread ở đây bao gồm chi phí syscall pipe, vì đó là cách hiện thực một lần trao quyền qua lại giữa hai thread. Đó chính là điểm mấu chốt — không có cách nào để hai OS thread "bắt tay" mà không đi qua kernel, trong khi hai goroutine thì có (qua channel, thuần user-space).
Ứng dụng thực tế
Mô hình "goroutine cho mỗi việc + channel" là khả thi nhờ điều này. Một pipeline Go có thể có hàng chục tầng, mỗi tầng là goroutine nối nhau bằng channel, và dữ liệu chảy qua với chi phí chuyển ~150 ns mỗi bước. Nếu mỗi tầng là một OS thread giao tiếp qua pipe, chi phí đó nhân lên 130 lần và pipeline sẽ nghẹt.
Nhưng đừng lạm dụng channel cho đường siêu nóng. 150 ns vẫn là chi phí thật. Trong một vòng lặp chạy hàng trăm triệu lần, nếu mỗi lần lặp phải qua một channel thì 150 ns/lần cộng dồn thành vấn đề. Khi đó, gộp công việc theo lô (batch) để giảm số lần chuyển, hoặc dùng cấu trúc chia sẻ có khoá nhẹ, thường tốt hơn.
GOMAXPROCS thay đổi bức tranh. Phép đo này ép GOMAXPROCS=1 để buộc luân phiên trên một P. Với nhiều P, hai goroutine giao tiếp có thể chạy song song trên hai lõi và chi phí "chuyển" biến thành chi phí đồng bộ hoá qua channel giữa hai lõi — một câu chuyện khác (liên quan cache coherency). Điểm cần nhớ: con số 150 ns là chi phí chuyển ngữ cảnh trên cùng một P, không phải mọi tình huống.
Đánh đổi cần cân nhắc
Rẻ không có nghĩa là miễn phí. Chuyển goroutine rẻ hơn thread 130 lần, nhưng vẫn tốn ~80 ns mỗi lần. Thiết kế "một goroutine cho mỗi phần tử nhỏ xíu" trong vòng lặp cực nóng vẫn có thể thua một vòng lặp tuần tự đơn giản. Đo trước khi chia nhỏ.
LockOSThread có công dụng riêng, đừng dùng bừa. Trong bài này ta dùng LockOSThread để cố tình tạo chi phí thread thật cho phép đo. Trong thực tế nó dùng cho việc cần cùng một OS thread (gọi thư viện C giữ trạng thái theo thread, khởi tạo đồ hoạ, runtime.LockOSThread cho signal handling). Khoá goroutine vào thread làm mất lợi thế lập lịch nhẹ — chỉ dùng khi thật cần.
Chuyển goroutine không cấp phát, nên không gây áp lực GC. Đây là điểm cộng ẩn: 0 allocs/op nghĩa là dù bạn chuyển goroutine hàng triệu lần, GC không bị kéo vào. Đó là lý do các hàng đợi/pipeline dựa trên channel không làm phình heap.
Ba ý mang về
- Chuyển giữa hai goroutine tốn ~150 ns và 0 cấp phát (đo thật 164 ns/vòng tay, 147,9 ns/op benchmark) vì nó ở lại user-space — bộ lập lịch Go chỉ đổi stack và vài thanh ghi, không gọi kernel.
- Chuyển giữa hai OS thread tốn ~21 µs, đắt hơn 130 lần, vì bắt buộc đi qua syscall, bộ lập lịch kernel và làm mới cache/TLB — không có cách nào để hai thread bắt tay mà không xuống kernel.
- Đây là lý do sâu xa của mô hình đồng thời Go: hàng nghìn goroutine giao tiếp qua channel chạy mượt, nhưng 150 ns vẫn là chi phí thật — đường siêu nóng nên gộp lô để giảm số lần chuyển, và
GOMAXPROCSđổi hẳn bức tranh khi có song song thật.
Bài tập làm thử
Bài 1 (đọc hiểu). Đây là hàm đo chi phí chuyển ngữ cảnh giữa hai goroutine trong bài:
func goroutinePingPong(rounds int) time.Duration {
    ping, pong := make(chan struct{}), make(chan struct{})
    go func() {
        for i := 0; i < rounds; i++ {
            <-ping
            pong <- struct{}{}
        }
    }()
    start := time.Now()
    for i := 0; i < rounds; i++ {
        ping <- struct{}{}
        <-pong
    }
    return time.Since(start)
}
Bài viết đặt runtime.GOMAXPROCS(1) trước khi gọi hàm này. Vì sao bước đó là bắt buộc để phép đo phản ánh đúng "chi phí chuyển ngữ cảnh", và điều gì sẽ xảy ra với ý nghĩa của con số đo được nếu bỏ qua bước đó (chạy với GOMAXPROCS mặc định nhiều lõi)?
Đáp án
Với GOMAXPROCS(1), chỉ có một P nên hai goroutine buộc phải luân phiên chạy trên cùng một P — mỗi lần gửi/nhận trên channel không đệm là một lần bộ lập lịch Go thực sự dừng goroutine này và chạy goroutine kia, đúng nghĩa "chuyển ngữ cảnh". Nếu để nhiều P, hai goroutine có thể chạy song song thật trên hai lõi khác nhau; khi đó thời gian đo được không còn là chi phí chuyển ngữ cảnh nữa mà là chi phí đồng bộ hoá dữ liệu giữa hai lõi qua channel (liên quan cache coherency) — một câu chuyện khác hẳn, như chính bài đã lưu ý ở phần "Ứng dụng thực tế".
Bài 2 (sửa lỗi). Một người muốn đo chi phí chuyển ngữ cảnh giữa hai OS thread bằng pipe, viết lại như sau:
func threadPingPong(rounds int) time.Duration {
    var a2b, b2a [2]int
    syscall.Pipe(a2b[:])
    syscall.Pipe(b2a[:])

    go func() {
        runtime.LockOSThread()
        buf := make([]byte, 1)
        for i := 0; i < rounds; i++ {
            syscall.Read(a2b[0], buf)
            syscall.Write(b2a[1], []byte{1})
        }
    }()

    start := time.Now()
    buf := make([]byte, 1)
    for i := 0; i < rounds; i++ {
        syscall.Write(a2b[1], []byte{1})
        syscall.Read(b2a[0], buf)
    }
    return time.Since(start)
}
So với thiết kế trong bài ("hai goroutine gọi runtime.LockOSThread ghim vào OS thread riêng"), đoạn code trên thiếu gì, và thiếu sót đó làm hỏng phép đo như thế nào?
Đáp án
Chỉ goroutine con gọi runtime.LockOSThread(), còn goroutine chạy vòng lặp đo ở hàm chính (phía gọi threadPingPong) thì không. Vì goroutine đo không bị ghim, bộ lập lịch Go có thể chạy nó trên các M/P khác nhau theo thời gian, nghĩa là một phần "chuyển ngữ cảnh" đo được có thể chỉ là chuyển goroutine (rẻ, ~150ns) thay vì chuyển OS thread thật (đắt, ~21µs) như chủ đích phép đo. Phải gọi runtime.LockOSThread() ở cả hai phía ping-pong để đảm bảo mỗi bên bị ghim cứng vào một OS thread riêng, buộc mọi lần trao quyền phải đi qua kernel thật sự như bài đã mô tả.
Bài 3 (vận dụng). Bài đo được: chuyển goroutine tốn khoảng 164,3 ns/vòng (mỗi vòng = 2 lần chuyển), chuyển OS thread tốn khoảng 21.465 ns/vòng. Nếu bạn thiết kế một pipeline xử lý dữ liệu gồm 20 tầng nối tiếp bằng channel, mỗi phần tử dữ liệu đi qua đủ 20 lần chuyển ngữ cảnh giữa các tầng. Ước tính sơ bộ tổng chi phí chuyển ngữ cảnh cho một phần tử, nếu (a) dùng goroutine + channel, và (b) dùng OS thread + pipe. Từ đó giải thích vì sao mô hình pipeline nhiều tầng chỉ khả thi với goroutine.
Đáp án
Với chi phí một lần chuyển ~80ns (goroutine) và ~10,7µs (thread) — tính từ việc mỗi vòng ping-pong gồm 2 lần chuyển: (a) goroutine: 20 × 80ns = 1.600 ns ≈ 1,6 µs mỗi phần tử. (b) thread: 20 × 10.700ns = 214.000 ns ≈ 214 µs mỗi phần tử — đắt hơn khoảng 130 lần, đúng tỷ lệ bài đã đo (130,7 lần). Với pipeline chạy hàng triệu phần tử/giây, chênh lệch 130 lần này là khác biệt giữa "chạy mượt" và "nghẹt hoàn toàn" — đây là lý do mô hình "mỗi tầng một goroutine nối bằng channel" khả thi trong Go còn mô hình tương đương bằng OS thread + pipe thì không.
Bài 4 (bẫy/đánh đổi). Bài viết nhấn mạnh "150 ns vẫn là chi phí thật", không phải miễn phí. Trong trường hợp nào việc dùng channel để chuyển goroutine ở tốc độ cao có thể trở thành vấn đề, và cách khắc phục được gợi ý trong bài là gì?
Đáp án
Trong một vòng lặp chạy hàng trăm triệu lần, nếu mỗi lần lặp đều phải đi qua một channel (một lần chuyển ngữ cảnh), chi phí ~150ns/lần sẽ cộng dồn thành vấn đề đáng kể trên "đường siêu nóng" (hot path). Bài gợi ý hai hướng khắc phục: gộp công việc theo lô (batch) để giảm số lần chuyển ngữ cảnh cần thiết, hoặc dùng cấu trúc dữ liệu chia sẻ với khoá nhẹ thay vì channel cho từng phần tử nhỏ. Bài cũng lưu ý phải đo trước khi chia nhỏ — đừng giả định "một goroutine cho mỗi phần tử nhỏ xíu" luôn tốt hơn một vòng lặp tuần tự đơn giản.
Phần sau ta đi vào một tham số điều khiển toàn bộ mức song song đó: Phần sau mổ xẻ GOMAXPROCS và bài toán nhận biết container — vì sao Go có thể hiểu sai số lõi khả dụng khi chạy trong Docker/Kubernetes, và cách sửa.
