Câu thần chú "goroutine rẻ" ai cũng nghe, nhưng ít người đo xem rẻ tới đâu và nhờ đâu. Bí mật nằm ở stack: một OS thread trên Linux cấp stack cố định mặc định 8MB ngay lúc sinh ra, còn một goroutine bắt đầu chỉ với 2KB và tự phình khi cần. Bài này không kể lý thuyết — ta chạy code trong container Go 1.23 và đo từng con số: stack ban đầu là bao nhiêu bytes, nó lớn lên theo quy luật nào, và cái giá phải trả.
Ý tưởng: stack nhỏ, tự lớn
OS thread phải đoán trước dung lượng stack tối đa và cấp cả khối ngay từ đầu — vì thay đổi stack của thread giữa chừng là chuyện của kernel, rất đắt. Go đảo ngược: mỗi goroutine khởi đầu với một stack tí hon (2KB), và khi một lời gọi hàm phát hiện stack sắp hết chỗ, runtime chèn một đoạn kiểm tra (morestack) cấp một stack lớn gấp đôi, copy toàn bộ khung hàm cũ sang, chỉnh lại các con trỏ, rồi chạy tiếp. Vì goroutine được runtime quản lý (không phải kernel), việc này rẻ và làm được bất cứ lúc nào.
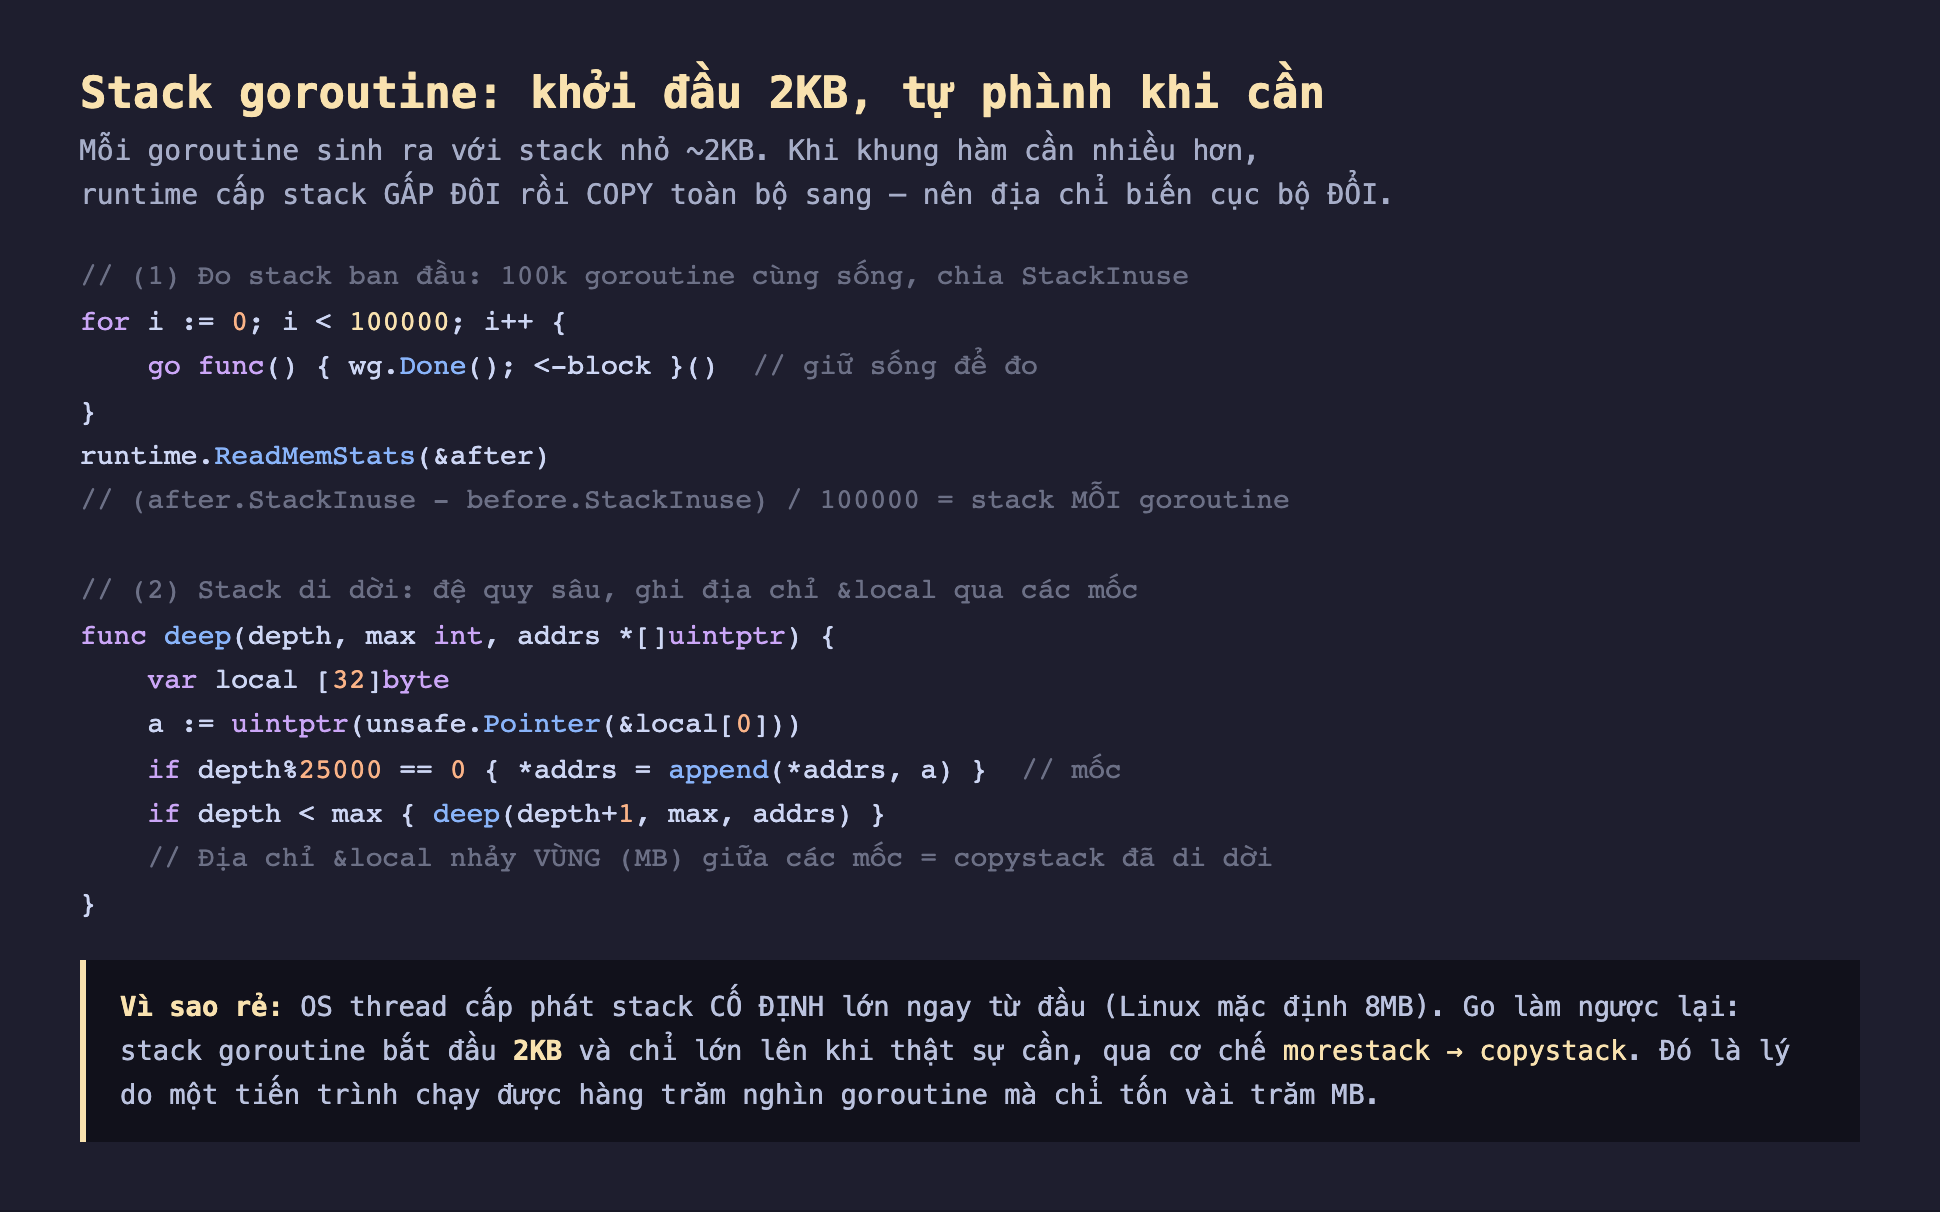
Hình 1: Hai phép đo — chia StackInuse cho số goroutine để lấy stack ban đầu; và ghi địa chỉ &local qua các mốc đệ quy để bắt khoảnh khắc stack di dời.
Đo thật 1: stack ban đầu đúng 2KB
Cách đo sạch nhất: sinh 100.000 goroutine, giữ tất cả cùng sống (block trên một channel), rồi đọc runtime.MemStats.StackInuse trước và sau. Chia hiệu số cho số goroutine ra stack trung bình mỗi cái.
const N = 100000
for i := 0; i < N; i++ {
    go func() { wg.Done(); <-block }()  // giữ sống để đo
}
wg.Wait()
runtime.ReadMemStats(&after)
grew := after.StackInuse - before.StackInuse
fmt.Printf("Mỗi goroutine: %d bytes\n", grew/N)
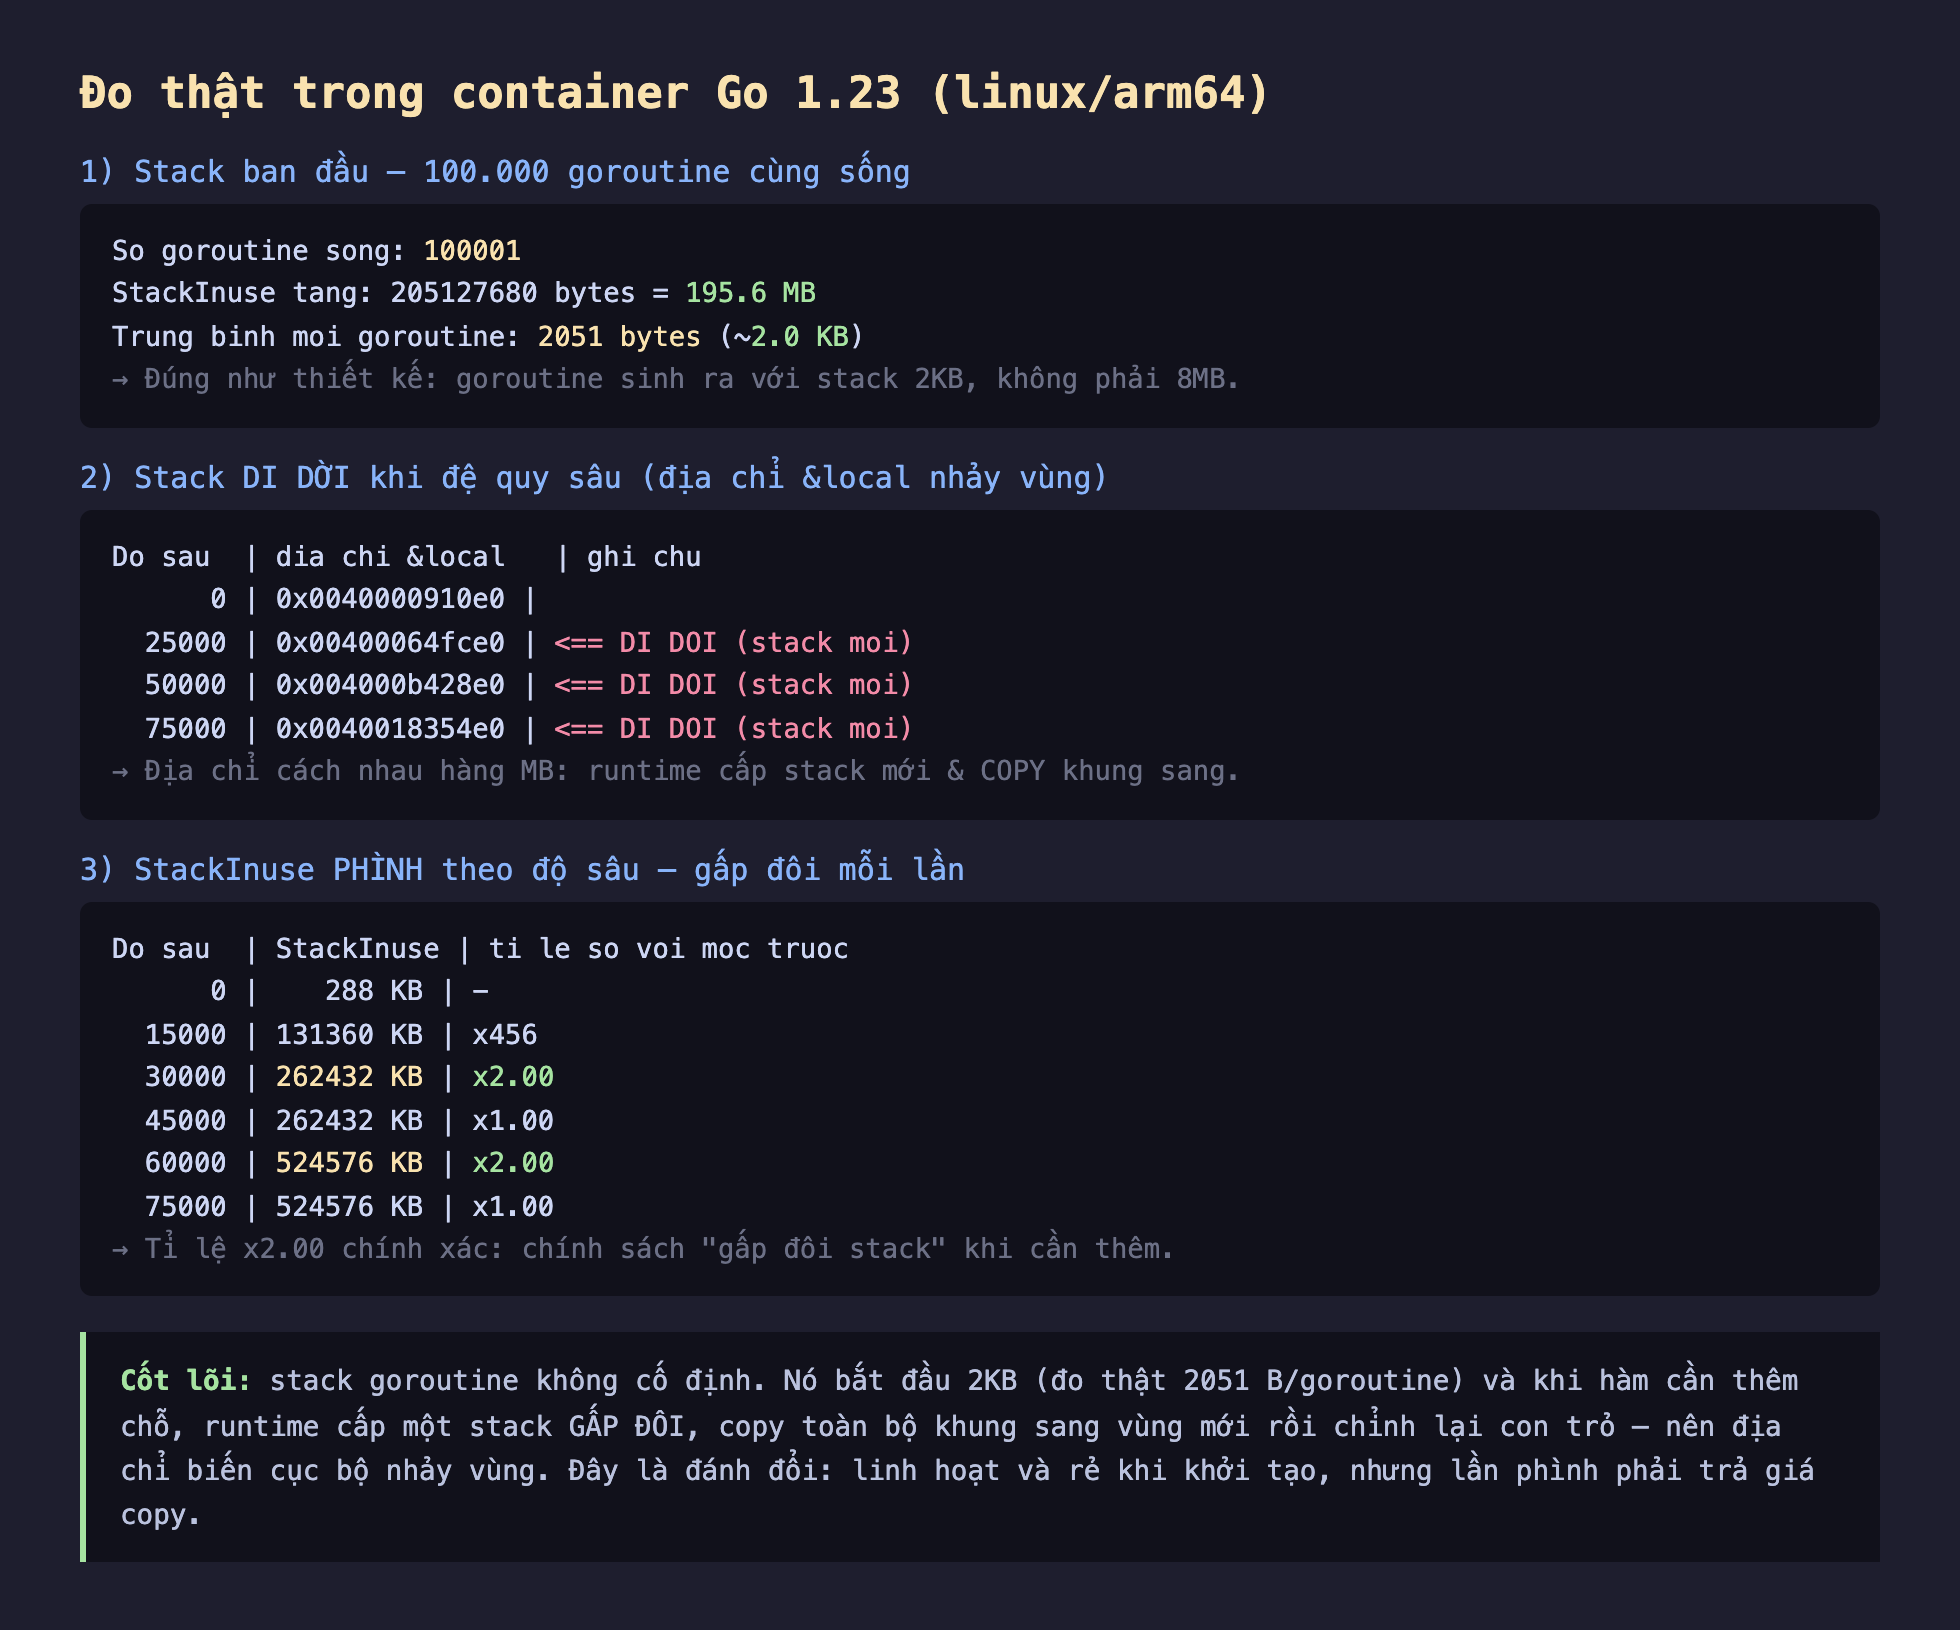
Hình 2: 100.000 goroutine tốn 195,6 MB stack — 2051 bytes mỗi cái, đúng con số 2KB thiết kế. Đệ quy sâu làm &local nhảy vùng hàng MB (di dời). Và StackInuse phình theo tỉ lệ x2.00 — gấp đôi.
Kết quả: 2051 bytes mỗi goroutine (~2.0 KB). Con số này khớp chính xác kích thước stack tối thiểu (_StackMin = 2048) mà runtime dùng khi tạo goroutine, cộng chút lề. Để so sánh: cùng 100.000 đơn vị thực thi mà là OS thread với stack 8MB thì cần 800GB địa chỉ stack — bất khả thi. Với goroutine, chỉ 195,6 MB.
Đo thật 2: stack di dời khi phình
Điều thú vị là khi stack lớn lên, nó không "nối thêm" mà được cấp mới hoàn toàn và copy sang — nghĩa là địa chỉ bộ nhớ của các biến cục bộ thay đổi. Ta chứng minh bằng cách đệ quy sâu và ghi lại địa chỉ một biến cục bộ ở vài mốc:
func deep(depth, max int, addrs *[]uintptr) {
    var local [32]byte
    a := uintptr(unsafe.Pointer(&local[0]))
    if depth%25000 == 0 { *addrs = append(*addrs, a) }
    if depth < max { deep(depth+1, max, addrs) }
}
Địa chỉ &local ở độ sâu 0, 25000, 50000, 75000 lần lượt cách nhau hàng MB (0x...910e0 → 0x...64fce0 → 0x...b428e0 → 0x...8354e0). Nếu stack chỉ nối thêm liền mạch, địa chỉ sẽ trôi đều một chiều theo bước khung; ở đây chúng nhảy sang vùng khác hẳn, vì mỗi lần phình runtime cấp một stack mới ở chỗ khác và copy toàn bộ khung sang. Đây chính là copystack trong runtime.
Điều này giải thích một quy tắc quan trọng của Go: con trỏ tới biến trên stack vẫn an toàn dù stack di dời, vì runtime biết mọi con trỏ trong stack và chỉnh chúng khi copy. Nhưng con trỏ đó không phải là một địa chỉ cố định theo thời gian — bạn không được lưu uintptr của biến stack rồi dùng lại sau, vì stack có thể đã dời đi.
Đo thật 3: quy luật gấp đôi
Đo StackInuse tại các mốc độ sâu tăng dần cho thấy quy luật cấp phát rõ ràng: 262432 KB → 524576 KB là tỉ lệ x2.00 chính xác. Runtime không phình từng chút một (sẽ tốn quá nhiều lần copy) mà nhân đôi mỗi lần cần thêm — chiến lược khấu hao giống append slice hay vector C++: số lần copy giảm về O(log n) theo tổng kích thước, nên chi phí copy trung bình cho mỗi lần gọi hàm là hằng số.
Ứng dụng thực tế
Hàng trăm nghìn goroutine là khả thi thật. Vì stack khởi đầu chỉ 2KB, một server Go có thể mở một goroutine cho mỗi kết nối/mỗi request mà không lo cạn bộ nhớ như mô hình thread-per-connection. Đây là nền tảng của mô hình đồng thời "cứ spawn goroutine" trong Go.
Đệ quy quá sâu vẫn có giới hạn. Stack goroutine có trần (mặc định 1GB, chỉnh bằng debug.SetMaxStack). Đệ quy không đáy sẽ fatal error: stack overflow khi chạm trần — tôi gặp đúng lỗi này khi thử pad khung quá lớn. Với thuật toán đệ quy sâu không kiểm soát, hãy chuyển sang vòng lặp + stack tường minh.
Lần phình stack có chi phí. Nếu một hàm nóng liên tục vượt/tụt qua ngưỡng stack (gọi sâu rồi trả về rồi lại gọi sâu), nó có thể bị copy stack lặp đi lặp lại — "stack thrashing". Hiếm, nhưng nếu pprof cho thấy thời gian bất thường ở runtime.morestack/copystack, đó là dấu hiệu. Cách giảm: tránh khung quá lớn trên đường nóng, hoặc cấu trúc lại để độ sâu ổn định hơn.
Đánh đổi cần cân nhắc
Rẻ khi khởi tạo, trả giá khi phình. Stack nhỏ ban đầu là thứ khiến goroutine rẻ, nhưng cái giá là mỗi lần vượt ngưỡng phải cấp mới + copy. Chiến lược gấp đôi giữ tổng chi phí copy ở mức khấu hao thấp, nhưng nó không phải bằng không — với workload biết trước cần stack lớn, không có cách "cấp sẵn" (Go cố ý không cho, để giữ mô hình đơn giản).
Đừng phụ thuộc địa chỉ stack cố định. Vì stack di dời, mọi mánh khoé giữ uintptr trỏ vào biến stack đều sai. Đây là lý do unsafe.Pointer có luật rất nghiêm ngặt về việc không được "ẩn" con trỏ dưới dạng uintptr qua các lời gọi có thể phình stack.
Stack và heap là hai câu chuyện khác nhau. Bài này đo stack; biến "thoát" (escape) lên heap lại là chuyện của escape analysis — quyết định biến nào ở lại stack (được copy/thu hồi tự do khi hàm trả về) và biến nào lên heap (do GC quản). Đó là chủ đề ta sẽ đo riêng.
Ba ý mang về
- Goroutine khởi đầu với stack 2KB (đo thật 2051 bytes/goroutine trên 100.000 goroutine), khác hẳn OS thread cấp cố định 8MB — đây là lý do gốc rễ khiến "spawn hàng trăm nghìn goroutine" là khả thi thật.
- Stack phình bằng cách gấp đôi và copy: đo thật tỉ lệ x2.00 chính xác, và địa chỉ biến cục bộ nhảy vùng hàng MB giữa các mốc đệ quy — bằng chứng runtime cấp stack mới rồi di dời toàn bộ khung (
copystack). - An toàn nhưng có trần và có giá: runtime chỉnh mọi con trỏ khi di dời nên con trỏ stack luôn đúng, nhưng đừng lưu
uintptrcủa biến stack; đệ quy sâu chạm trần 1GB sẽstack overflow, và lần phình phải trả giá copy.
Phần sau ta so trực tiếp chi phí một thao tác cơ bản nhất: Phần sau đo chi phí chuyển ngữ cảnh giữa goroutine so với giữa OS thread — vì sao chuyển goroutine rẻ hơn nhiều và con số thực là bao nhiêu.
