Suốt sê-ri này, nhiều phép màu của Parquet, từ predicate pushdown tới column projection tới count(*) tức thì, đều dựa vào một thứ: metadata trong footer của file. Phần này nhìn thẳng vào lớp đó. Mỗi file Parquet kết thúc bằng một footer mô tả toàn bộ file: có những cột gì, kiểu dữ liệu ra sao, thống kê min max của từng row group, và vị trí từng khối cột. Engine đọc footer này trước để lập kế hoạch truy vấn, trước khi chạm vào một byte dữ liệu nào. Bài này đo chi phí đọc metadata so với đọc dữ liệu, xem Parquet lưu kiểu lồng nhau như struct và list thế nào, và cách schema evolution cho phép thêm cột mà không viết lại file cũ.
Footer là tấm bản đồ của file, nằm ở cuối
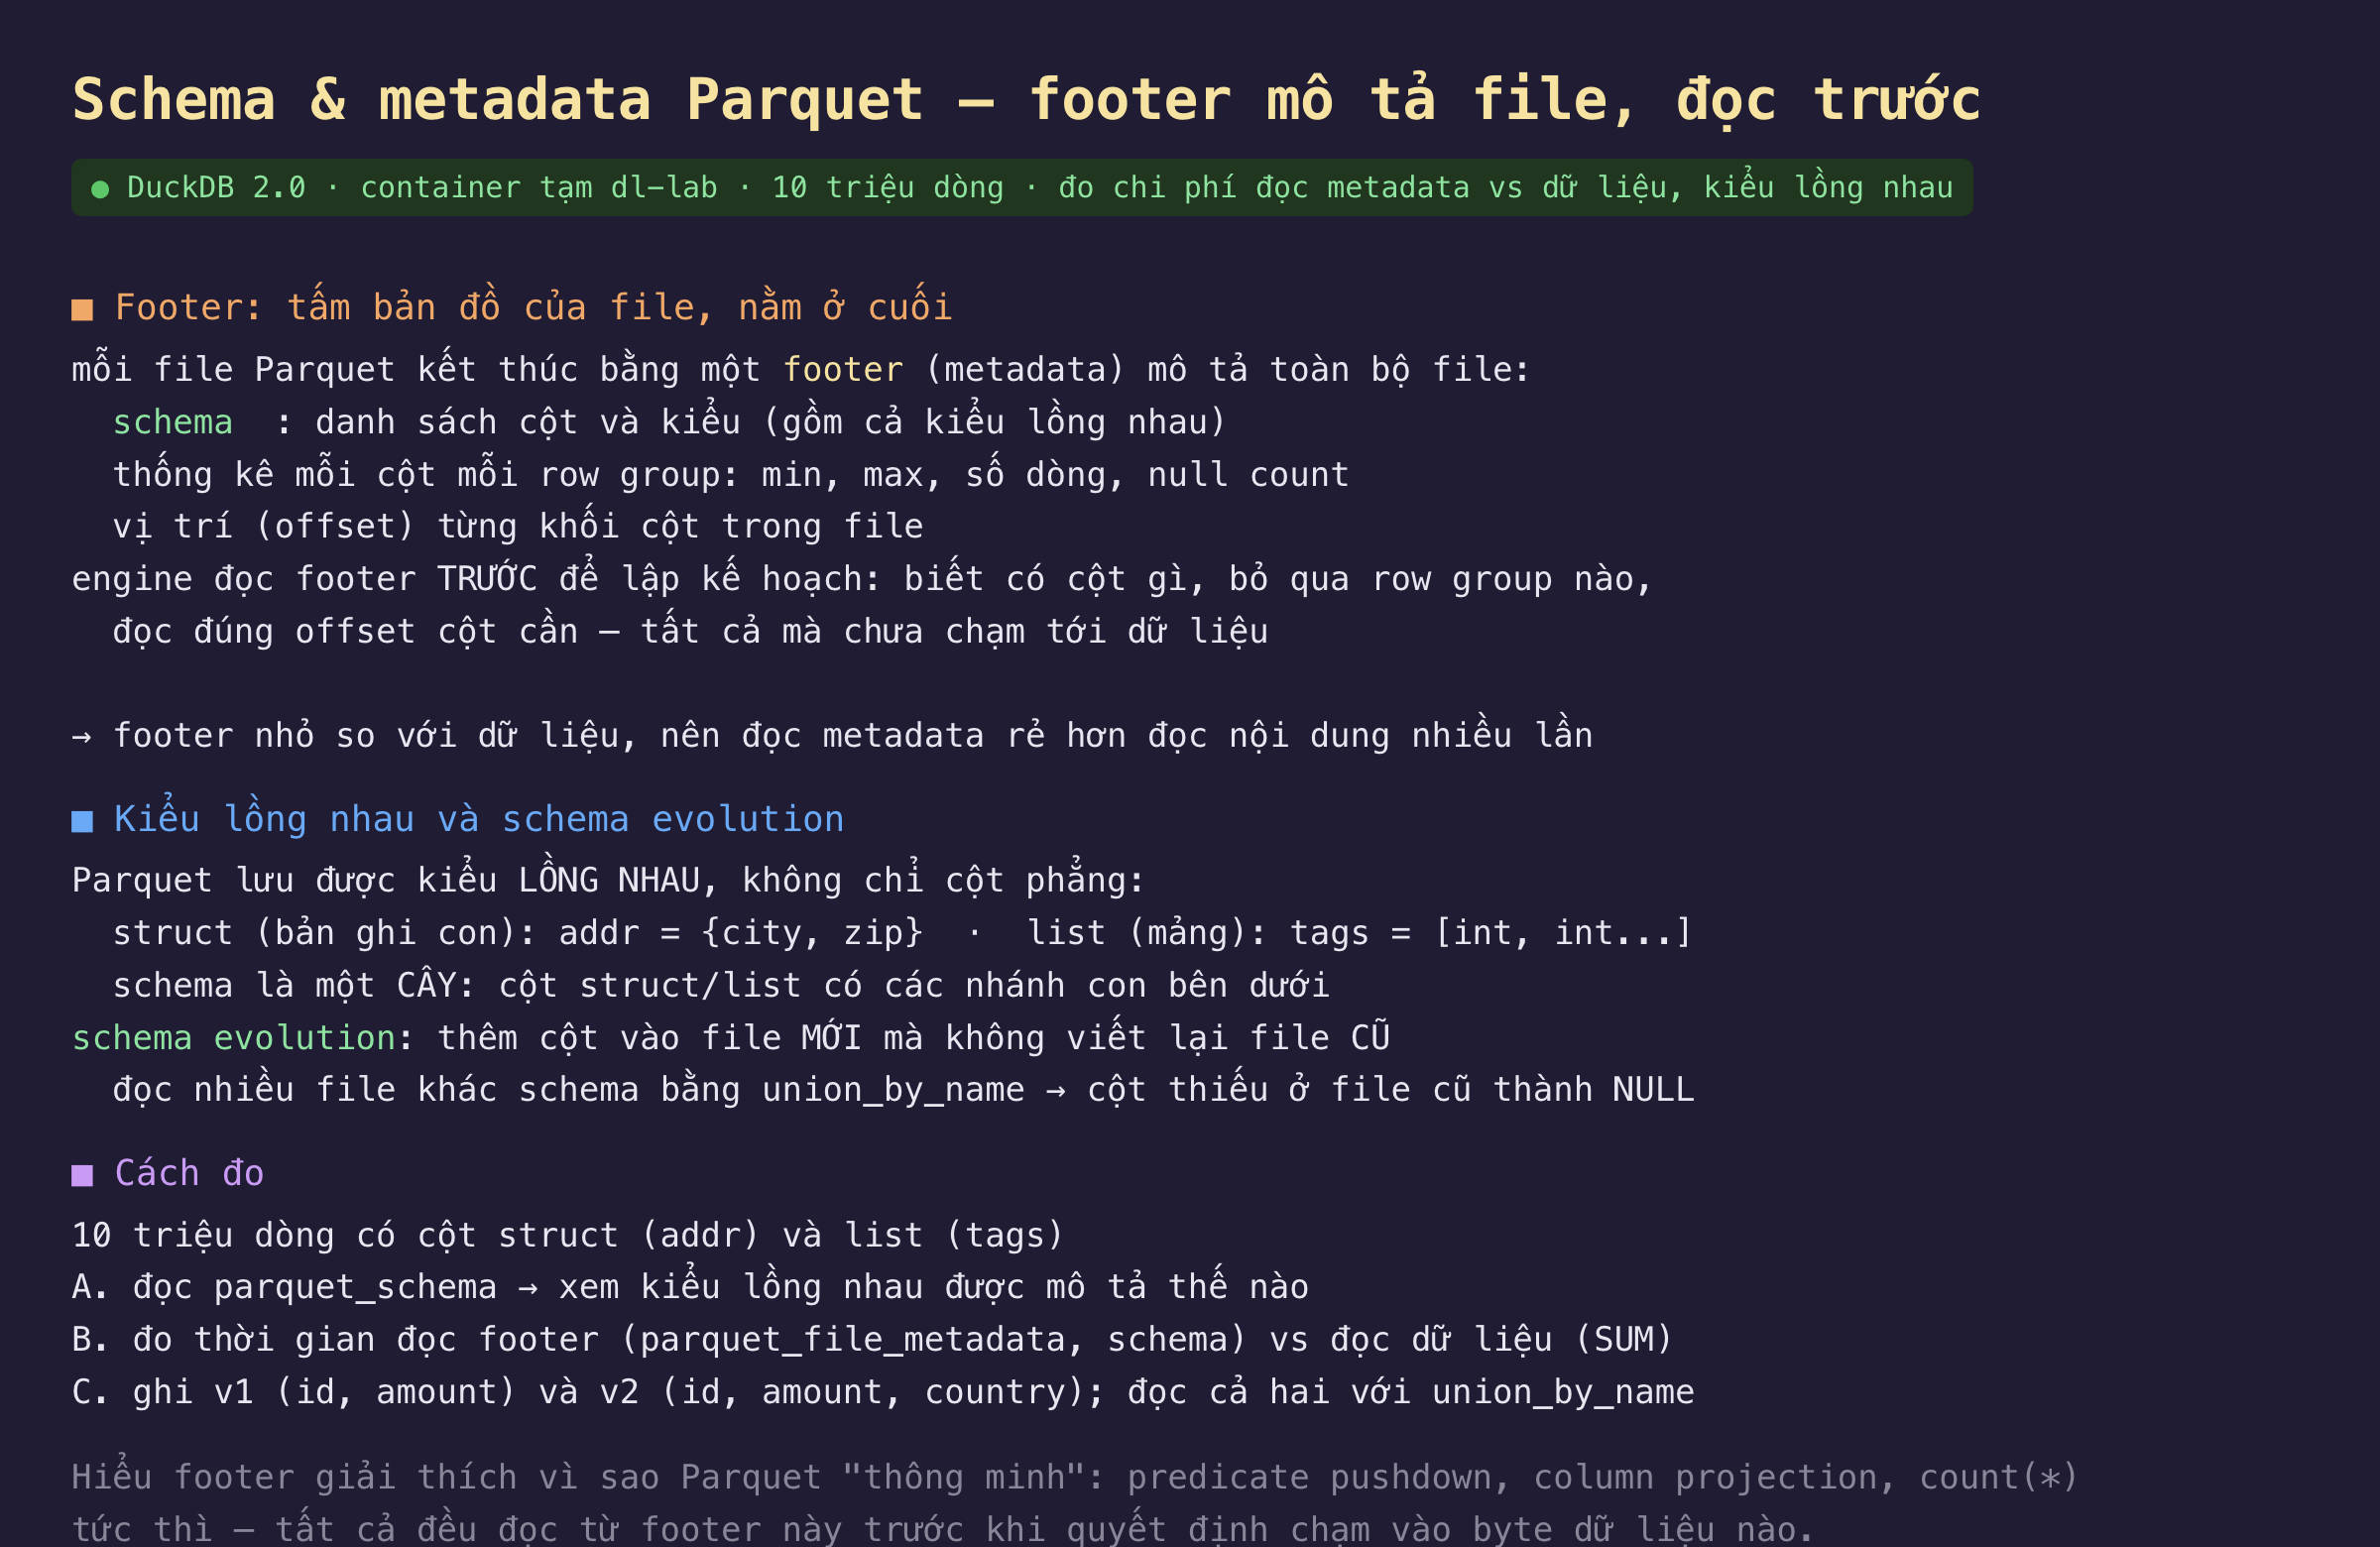
Hình 1: Footer của Parquet mô tả schema, kiểu và thống kê; đọc trước để lập kế hoạch, và lưu được cả kiểu lồng nhau.
Mỗi file Parquet kết thúc bằng một footer, phần metadata mô tả toàn bộ file. Footer chứa ba thứ chính: schema, tức danh sách cột và kiểu dữ liệu của chúng gồm cả kiểu lồng nhau; thống kê của mỗi cột trong mỗi row group, như min, max, số dòng, số null; và vị trí, tức offset, của từng khối cột trong file. Nhờ footer này, engine đọc một lượng metadata nhỏ ở cuối file là biết được toàn bộ cấu trúc.
Engine đọc footer trước để lập kế hoạch truy vấn. Nó biết file có những cột gì để quyết định cột nào cần đọc, dùng min max để bỏ qua row group không chứa kết quả như phần về predicate pushdown đã đo, và dùng offset để nhảy thẳng tới đúng khối cột cần mà không đọc cột khác. Tất cả những quyết định này được đưa ra khi chưa chạm vào một byte dữ liệu nào. Vì footer nhỏ so với toàn bộ dữ liệu, đọc metadata rẻ hơn đọc nội dung nhiều lần, và đây chính là cơ sở cho mọi tối ưu của Parquet.
Parquet còn lưu được kiểu lồng nhau, không chỉ các cột phẳng. Một cột struct là một bản ghi con, ví dụ addr gồm city và zip; một cột list là một mảng, ví dụ tags là một dãy số nguyên. Khi đó schema không phẳng mà là một cây: cột struct hay list có các nhánh con bên dưới mô tả cấu trúc bên trong. Và schema evolution cho phép dữ liệu tiến hóa theo thời gian: thêm cột vào file mới mà không viết lại file cũ, rồi đọc nhiều file khác schema cùng lúc bằng union_by_name, khi đó cột thiếu ở file cũ tự thành NULL. Cách đo: mười triệu dòng có cột struct addr và list tags; đọc parquet_schema để xem kiểu lồng nhau được mô tả thế nào; đo thời gian đọc footer bằng parquet_file_metadata và parquet_schema so với đọc dữ liệu bằng SUM; và ghi v1 với hai cột, v2 với ba cột, rồi đọc cả hai bằng union_by_name.
Đo thật: đọc metadata rẻ hơn đọc dữ liệu 43 lần
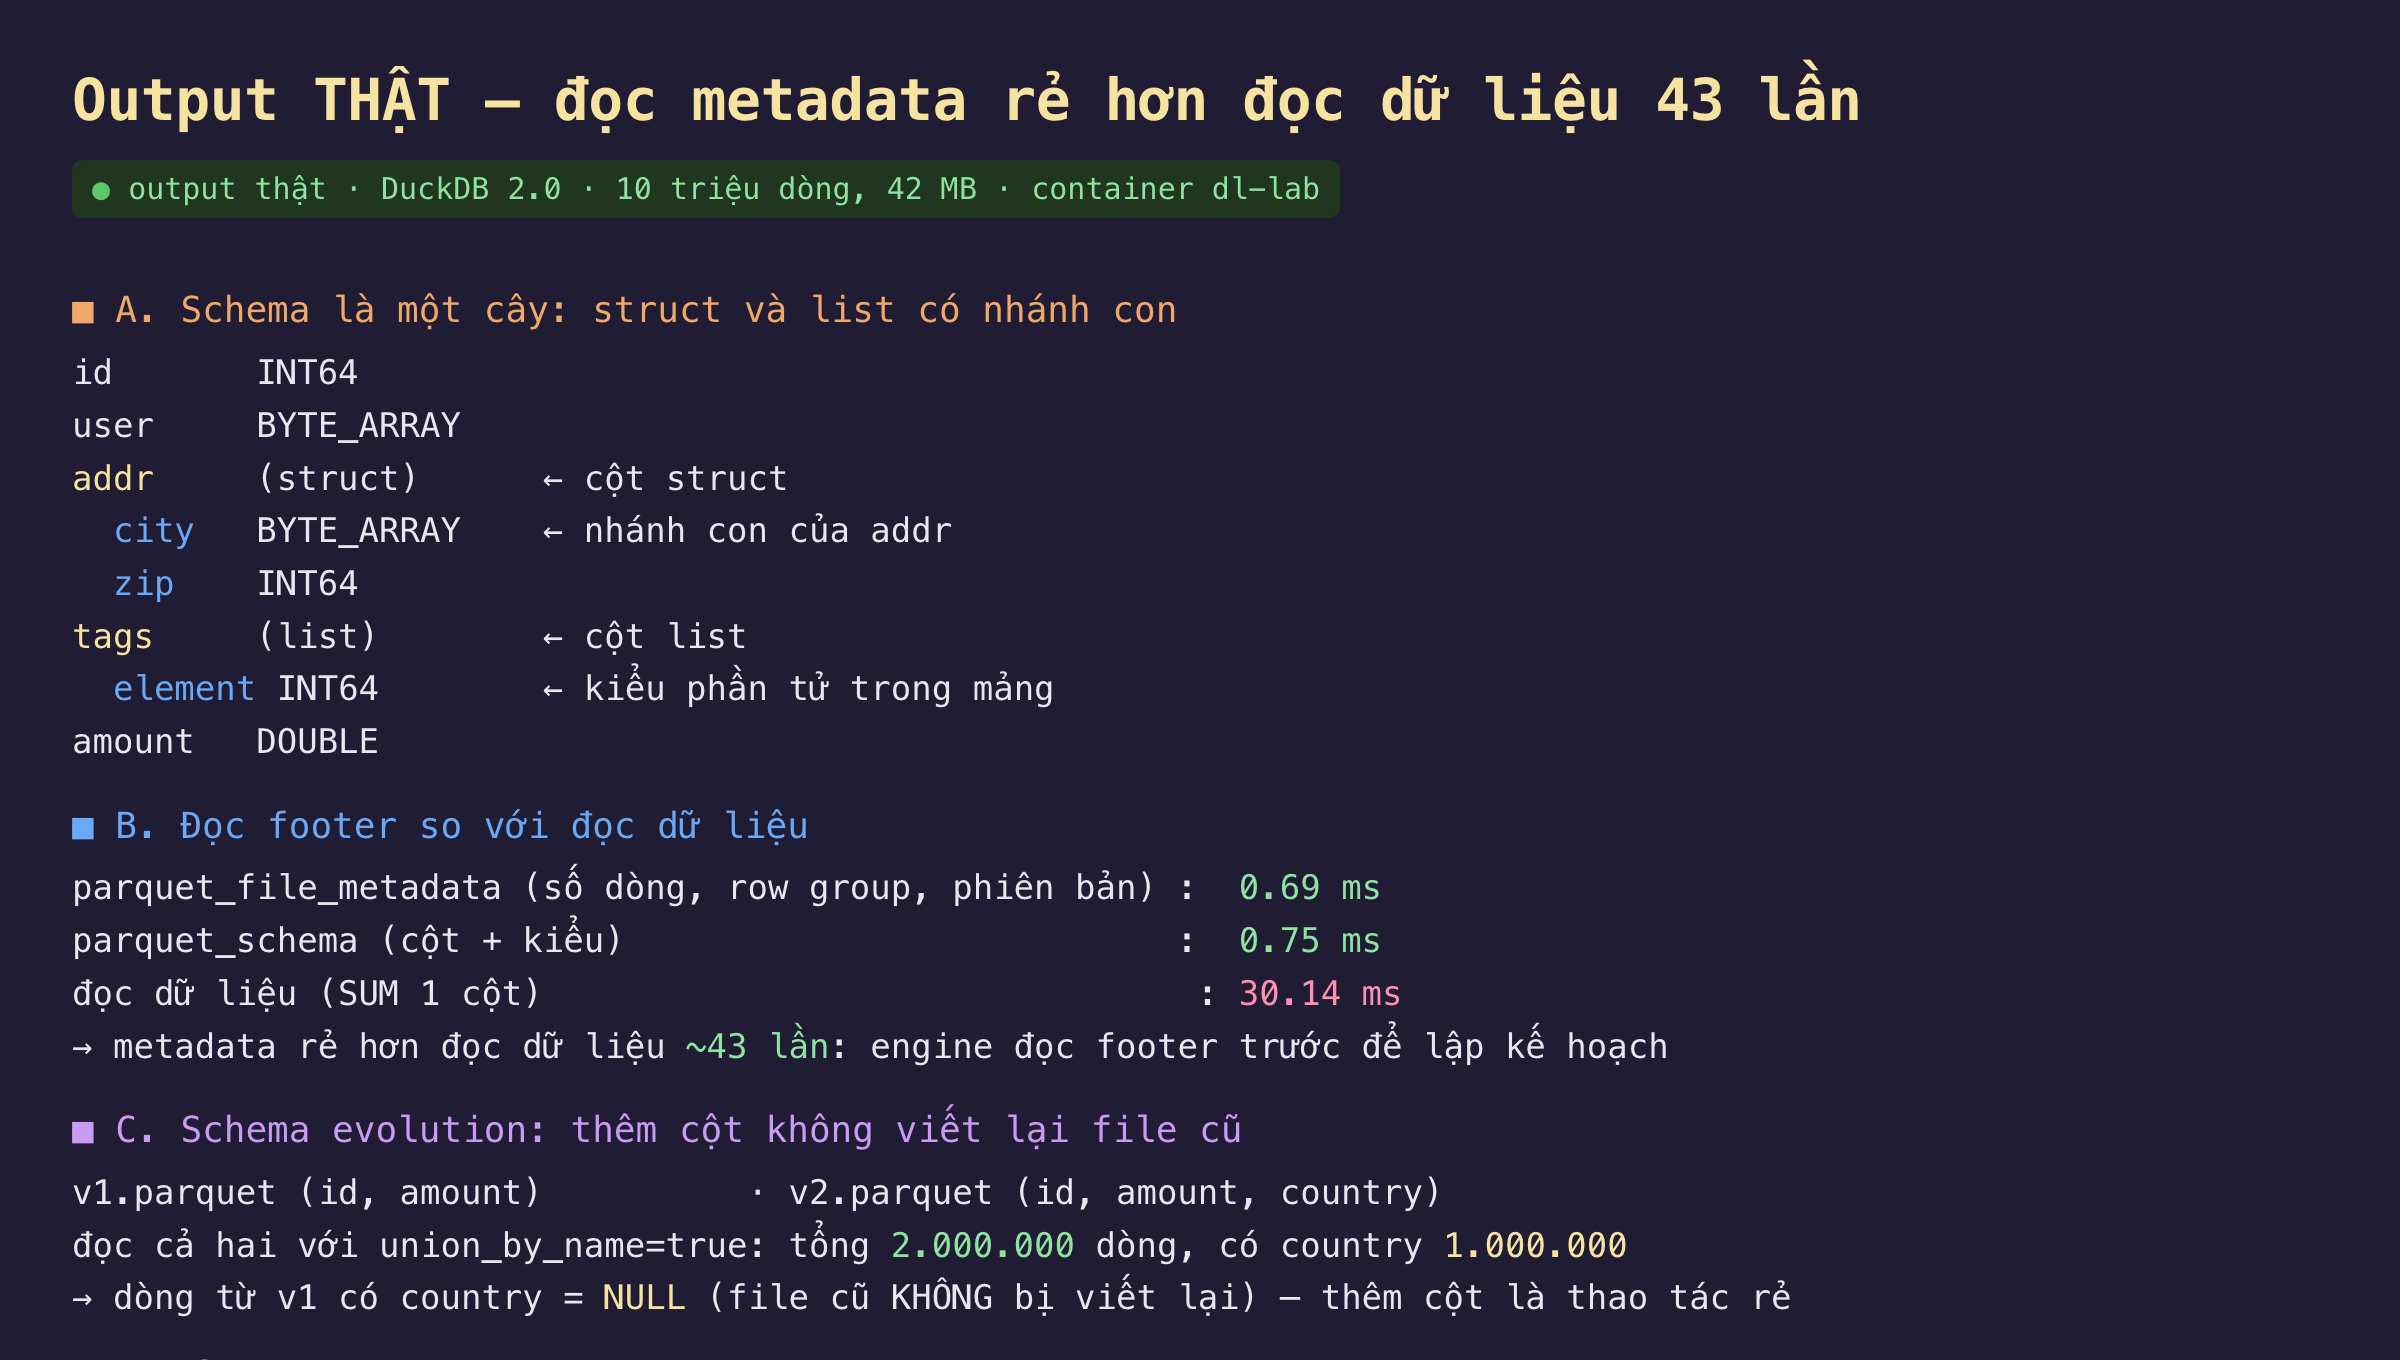
Hình 2: Schema dạng cây với struct và list, chi phí đọc metadata so với dữ liệu, và schema evolution qua union_by_name.
| phép đo | kết quả |
|---|---|
| đọc parquet_file_metadata | 0,69 ms |
| đọc parquet_schema | 0,75 ms |
| đọc dữ liệu (SUM 1 cột) | 30,14 ms |
| union_by_name v1 + v2 | 2 triệu dòng, 1 triệu có country |
Schema là một cây, lưu được struct và list cùng nhánh con. Đọc parquet_schema của file cho thấy cấu trúc cây rõ ràng. Các cột phẳng như id kiểu INT64, user kiểu BYTE_ARRAY, amount kiểu DOUBLE nằm ở mức trên. Cột struct addr có hai nhánh con bên dưới, city kiểu BYTE_ARRAY và zip kiểu INT64, mô tả cấu trúc bản ghi con. Cột list tags có một nhánh element kiểu INT64, mô tả kiểu của phần tử trong mảng. Đây là cách Parquet biểu diễn dữ liệu lồng nhau: không làm phẳng mà giữ cây schema, nên một cột có thể là một cấu trúc phức tạp, và engine vẫn đọc chọn lọc được từng nhánh con nếu cần.
Đọc metadata rẻ hơn đọc dữ liệu 43 lần. Đọc parquet_file_metadata, cho biết số dòng, số row group, phiên bản file, mất 0,69 ms. Đọc parquet_schema, cho danh sách cột và kiểu, mất 0,75 ms. Còn đọc dữ liệu thật bằng SUM một cột mất 30,14 ms. Metadata rẻ hơn khoảng bốn mươi ba lần vì nó là một lượng thông tin nhỏ ở footer, trong khi đọc dữ liệu phải quét qua nội dung cột. Đây là lý do engine luôn đọc footer trước để lập kế hoạch: với chi phí gần như không đáng kể, nó biết đủ để quyết định đọc gì và bỏ gì, rồi mới trả cái giá lớn hơn cho việc đọc đúng phần dữ liệu cần. Mọi tối ưu như pushdown và projection đều dựa vào bước đọc metadata rẻ này.
Schema evolution cho thêm cột mà không viết lại file cũ. Ghi hai file: v1 với cột id và amount, v2 thêm cột country. Đọc cả hai cùng lúc với union_by_name=true cho tổng hai triệu dòng, trong đó một triệu dòng có country, đúng là các dòng từ v2. Các dòng từ v1 có country bằng NULL, vì file cũ không có cột đó và không hề bị viết lại. Đây là schema evolution: khi dữ liệu cần thêm một thuộc tính mới, chỉ các file mới cần có cột đó, còn hàng nghìn file cũ vẫn nguyên vẹn, và truy vấn đọc tất cả cùng lúc mà không lỗi. Thêm cột trở thành một thao tác rẻ, không phải viết lại toàn bộ kho dữ liệu lịch sử.
Đánh đổi cần cân nhắc
Dùng kiểu lồng nhau khi dữ liệu thật sự lồng nhau, không lạm dụng. Struct và list tiện khi dữ liệu có cấu trúc tự nhiên lồng nhau, như một bản ghi sự kiện kèm danh sách thẻ hay một địa chỉ nhiều trường. Chúng giữ dữ liệu gọn và tránh phải tách thành nhiều bảng rồi join lại. Nhưng truy vấn trên cột lồng nhau phức tạp hơn và một số công cụ hỗ trợ kém hơn cột phẳng, nên với dữ liệu phân tích đơn giản, cột phẳng thường dễ làm việc hơn. Lựa chọn tùy bản chất dữ liệu: lồng nhau khi cấu trúc đòi hỏi, phẳng khi có thể.
Schema evolution có giới hạn: thêm cột dễ, đổi kiểu hay xóa cột khó. Thêm cột mới là thao tác an toàn vì file cũ chỉ thiếu cột đó và đọc ra NULL. Nhưng các thay đổi schema khác khó hơn: đổi kiểu một cột, ví dụ từ số nguyên sang chuỗi, khiến các file cũ và mới không tương thích kiểu khi đọc chung; xóa hay đổi tên cột cũng gây rắc rối khi union_by_name cố khớp theo tên. Quy ước an toàn là chỉ thêm cột, không đổi kiểu hay đổi tên cột đã có, và nếu buộc phải đổi, thêm một cột mới thay vì sửa cột cũ. Nhiều định dạng bảng như Iceberg và Delta Lake xây thêm một lớp quản lý schema evolution chặt chẽ hơn trên Parquet chính vì lý do này.
Phạm vi đo. Bài đo trên một file đơn và hai file schema khác nhau, không đo trường hợp hàng nghìn file với nhiều phiên bản schema, nơi chi phí khớp schema khi đọc tăng lên. Thời gian đọc metadata ở đây là trên đĩa cục bộ đã cache; trên lưu trữ từ xa, mỗi lần đọc footer là một request mạng nên tỉ lệ chi phí khác. Bài không đi sâu vào các kiểu Parquet khác như map, decimal, hay timestamp với múi giờ, mỗi kiểu có cách lưu riêng trong schema nhưng không đổi nguyên lý footer đọc trước.
Ba ý mang về
- Footer mô tả file và được đọc trước, rất rẻ. Đọc metadata mất 0,69 ms so với 30 ms đọc dữ liệu, rẻ hơn bốn mươi ba lần; mọi tối ưu của Parquet dựa vào bước đọc footer này.
- Schema là cây, lưu được kiểu lồng nhau. Struct
addrcó nhánh concityvàzip, listtagscóelement; Parquet giữ cấu trúc lồng nhau thay vì làm phẳng. - Schema evolution cho thêm cột mà không viết lại file cũ. Đọc file cũ và mới cùng lúc bằng
union_by_name, cột thiếu ở file cũ thành NULL; thêm cột là thao tác rẻ, đổi kiểu thì không.
Nguồn
- Apache Parquet — File Format, cấu trúc footer và metadata: https://parquet.apache.org/docs/file-format/
- Apache Parquet — Nested Encoding, struct và list (repetition và definition level): https://parquet.apache.org/docs/file-format/nestedencoding/
- DuckDB — Parquet Metadata,
parquet_schemavàparquet_file_metadata: https://duckdb.org/docs/data/parquet/metadata - DuckDB — Multiple Files và
union_by_name: https://duckdb.org/docs/data/multiple_files/combining_schemas - Apache Iceberg — Schema Evolution, lớp quản lý trên Parquet: https://iceberg.apache.org/docs/latest/evolution/
Phần sau là bài tổng kết sê-ri: gom mọi phép đo từ định dạng cột, nén, pushdown, projection, vectorized, join, aggregation, partitioning, spill tới metadata thành một pipeline phân tích dữ liệu hoàn chỉnh và một checklist chọn định dạng, nén, cấu hình cho công việc dữ liệu lớn trên một máy.
