Mười một phần trước của sê-ri này đo từng khía cạnh của việc xử lý dữ liệu lớn bằng định dạng cột Parquet và công cụ DuckDB: vì sao cột thắng hàng, nén hai tầng, predicate pushdown, column projection, quét tại chỗ, vectorized execution, hash join, hash aggregation, Hive partitioning, xử lý dữ liệu lớn hơn RAM, và metadata. Mỗi phần một cơ chế, mỗi kết luận một phép đo thật. Bài cuối này gom tất cả thành hai thứ: một pipeline hoàn chỉnh cho thấy các kỹ thuật cộng dồn ra sao khi dùng cùng nhau, và một checklist các quyết định cụ thể bạn áp dụng được ngay cho công việc dữ liệu của mình. Thông điệp xuyên suốt: dữ liệu lớn trên một máy không cần cụm, chỉ cần chọn đúng định dạng, bố trí dữ liệu, và cách viết truy vấn.
Checklist: từ mỗi phép đo thành một quyết định
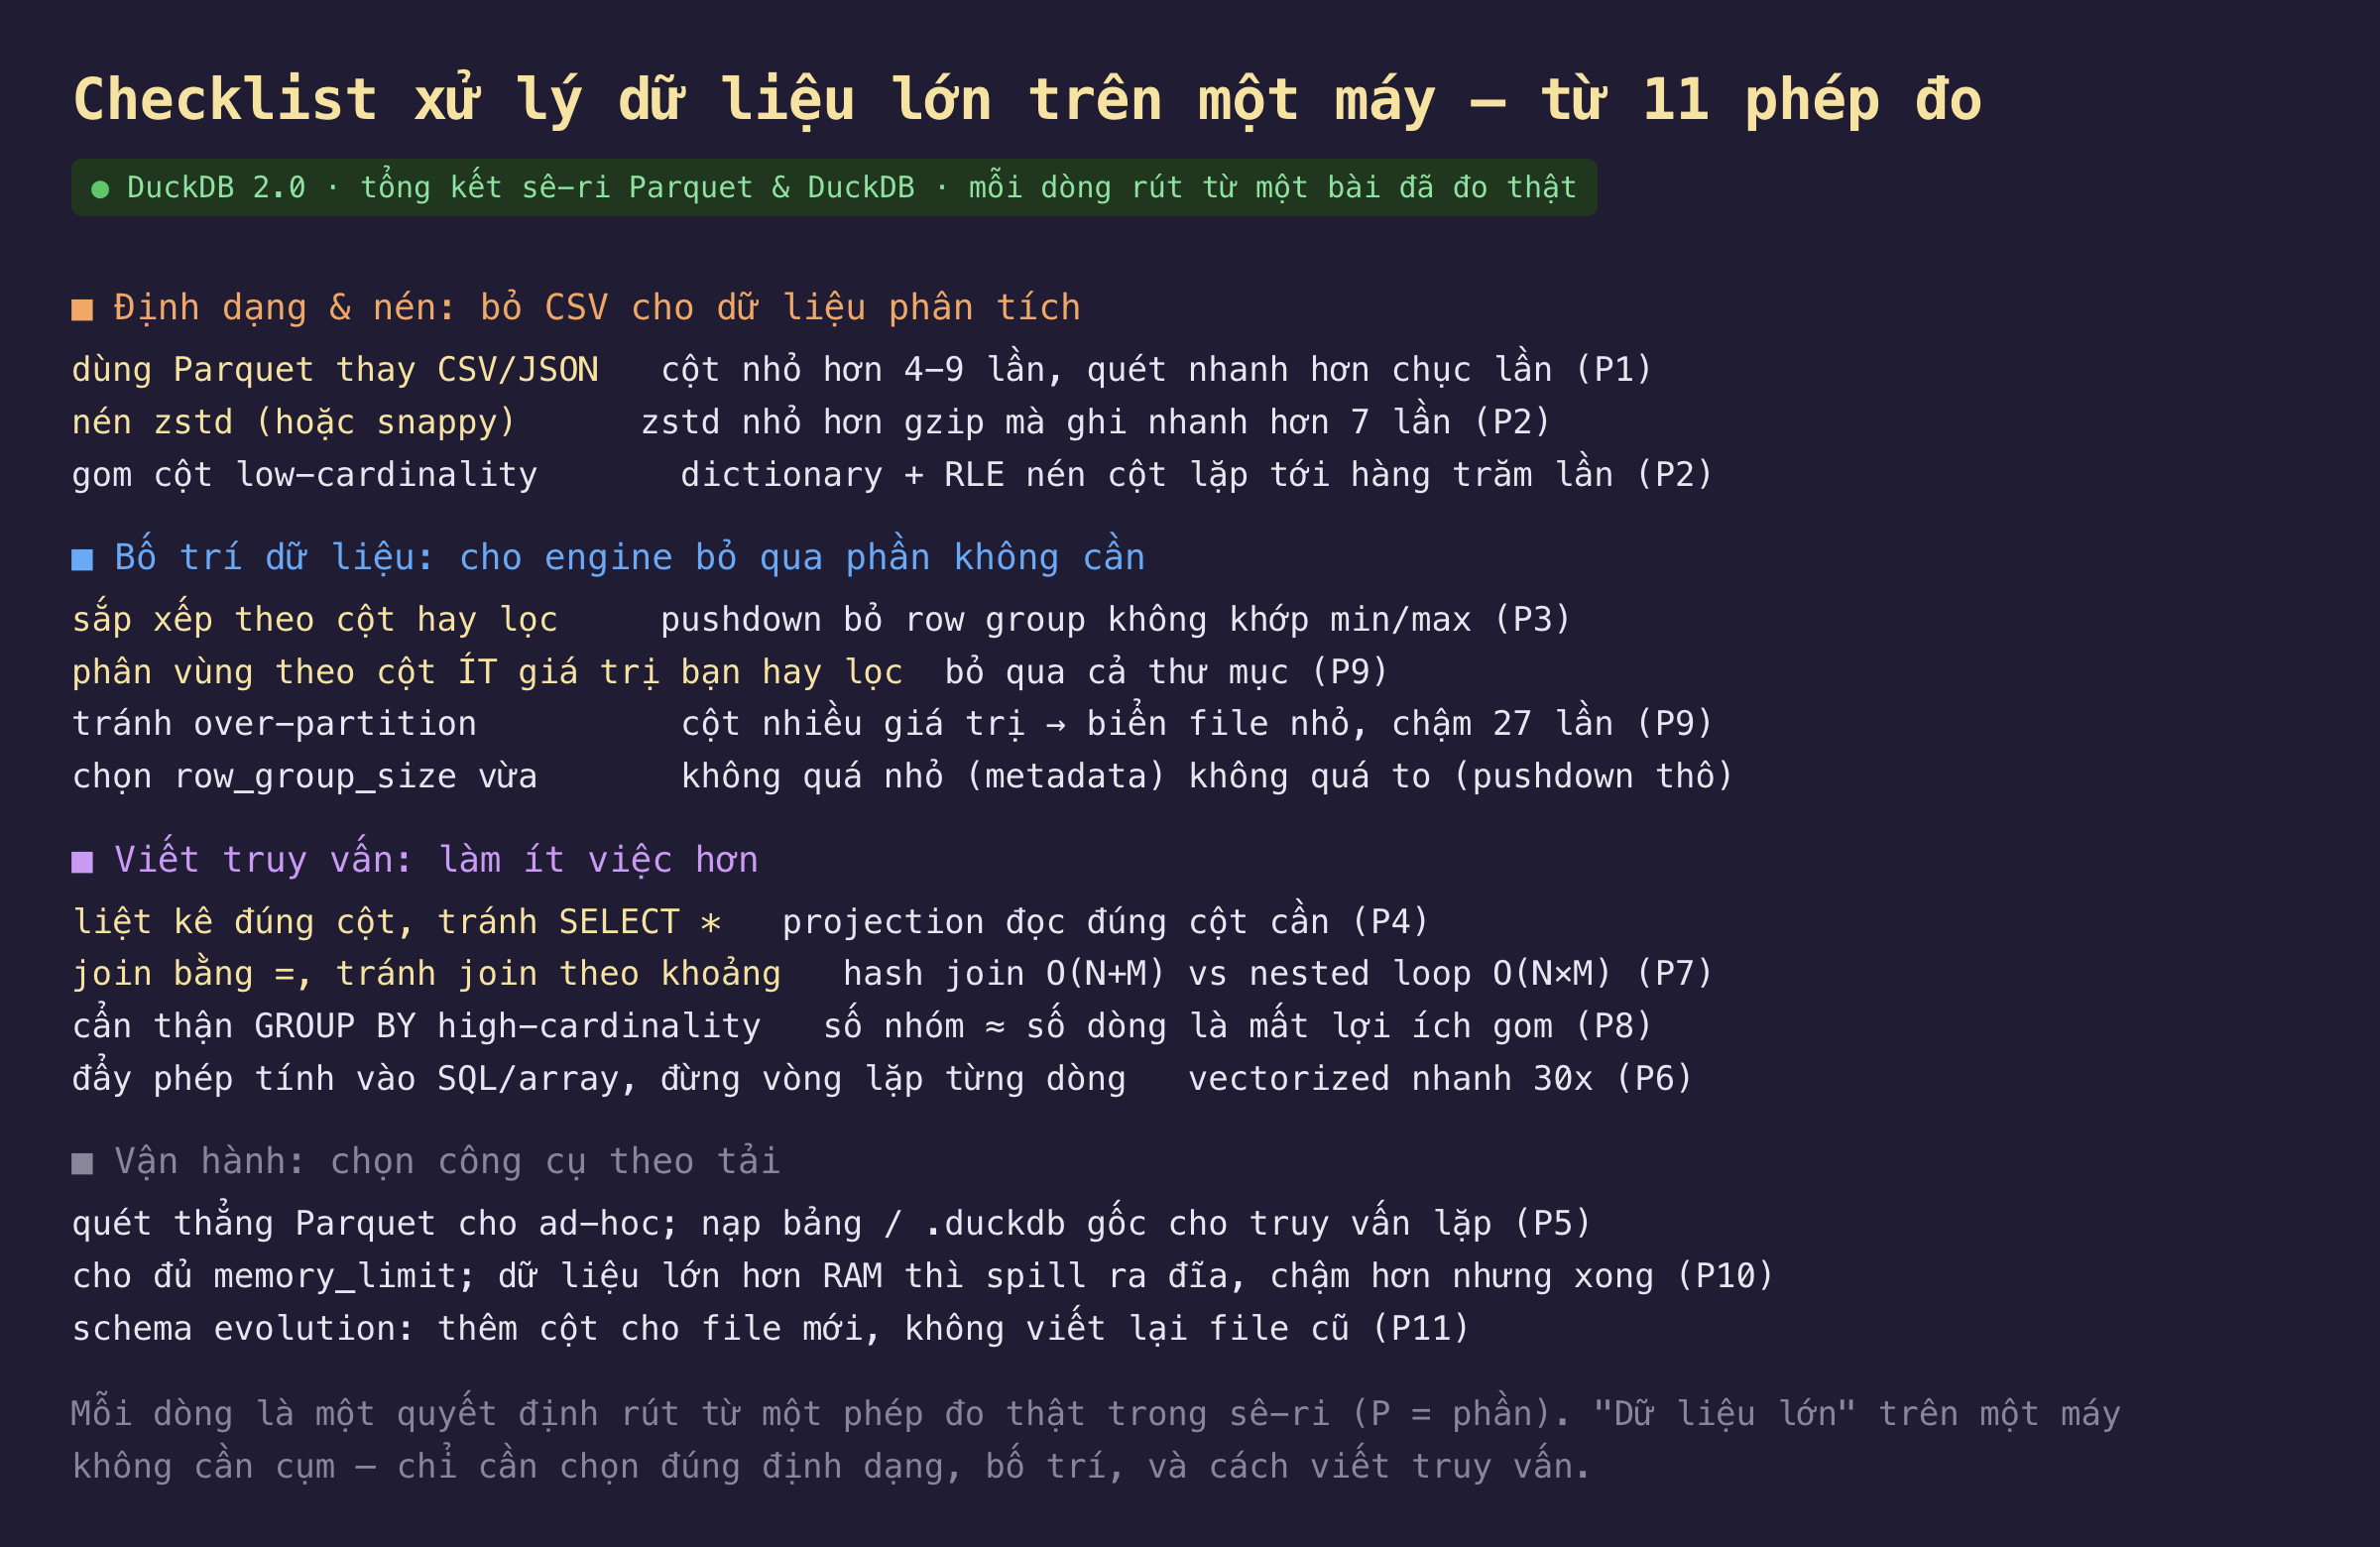
Hình 1: Checklist bốn nhóm — định dạng và nén, bố trí dữ liệu, viết truy vấn, vận hành — mỗi dòng rút từ một phép đo trong sê-ri.
Checklist chia thành bốn nhóm theo mạch của sê-ri. Nhóm thứ nhất là định dạng và nén: dùng Parquet thay CSV và JSON cho dữ liệu phân tích, vì cột nhỏ hơn bốn tới chín lần và quét nhanh hơn chục lần như phần 1 đo; nén bằng zstd hoặc snappy, với zstd nhỏ hơn gzip mà ghi nhanh hơn bảy lần như phần 2 đo; và thiết kế để gom các cột low-cardinality, nơi dictionary và RLE nén cột lặp tới hàng trăm lần.
Nhóm thứ hai là bố trí dữ liệu để engine bỏ qua phần không cần. Sắp xếp theo cột hay lọc để predicate pushdown bỏ được row group không khớp min max như phần 3 đo. Phân vùng theo cột ít giá trị mà bạn hay lọc để bỏ qua cả thư mục như phần 9 đo, nhưng tránh over-partition theo cột nhiều giá trị vì sẽ đẻ ra biển file nhỏ chậm hơn hai mươi bảy lần. Chọn kích thước row group vừa phải, không quá nhỏ kẻo tốn metadata, không quá to kẻo pushdown thô.
Nhóm thứ ba là viết truy vấn để làm ít việc hơn. Liệt kê đúng cột cần thay vì SELECT * để projection chỉ đọc cột cần như phần 4 đo. Join theo điều kiện bằng và tránh join theo khoảng, vì hash join là O(N cộng M) còn nested loop là O(N nhân M) như phần 7 đo. Cẩn thận khi GROUP BY theo cột high-cardinality, vì khi số nhóm xấp xỉ số dòng thì mất lợi ích gộp như phần 8 đo. Và đẩy phép tính vào SQL hay array thay vì viết vòng lặp từng dòng, vì vectorized nhanh hơn ba mươi lần như phần 6 đo.
Nhóm thứ tư là vận hành, chọn công cụ theo tải. Quét thẳng Parquet cho truy vấn ad-hoc, nạp vào bảng hay lưu .duckdb gốc cho truy vấn lặp như phần 5 đo. Cho đủ memory_limit, và khi dữ liệu lớn hơn RAM thì DuckDB spill ra đĩa, chậm hơn nhưng vẫn xong như phần 10 đo. Và dùng schema evolution để thêm cột cho file mới mà không viết lại file cũ như phần 11 đo. Mỗi dòng trong checklist là một quyết định rút từ một phép đo thật, không phải lý thuyết.
Pipeline đầy đủ: nhỏ hơn 6,8 lần, nhanh hơn 44 lần
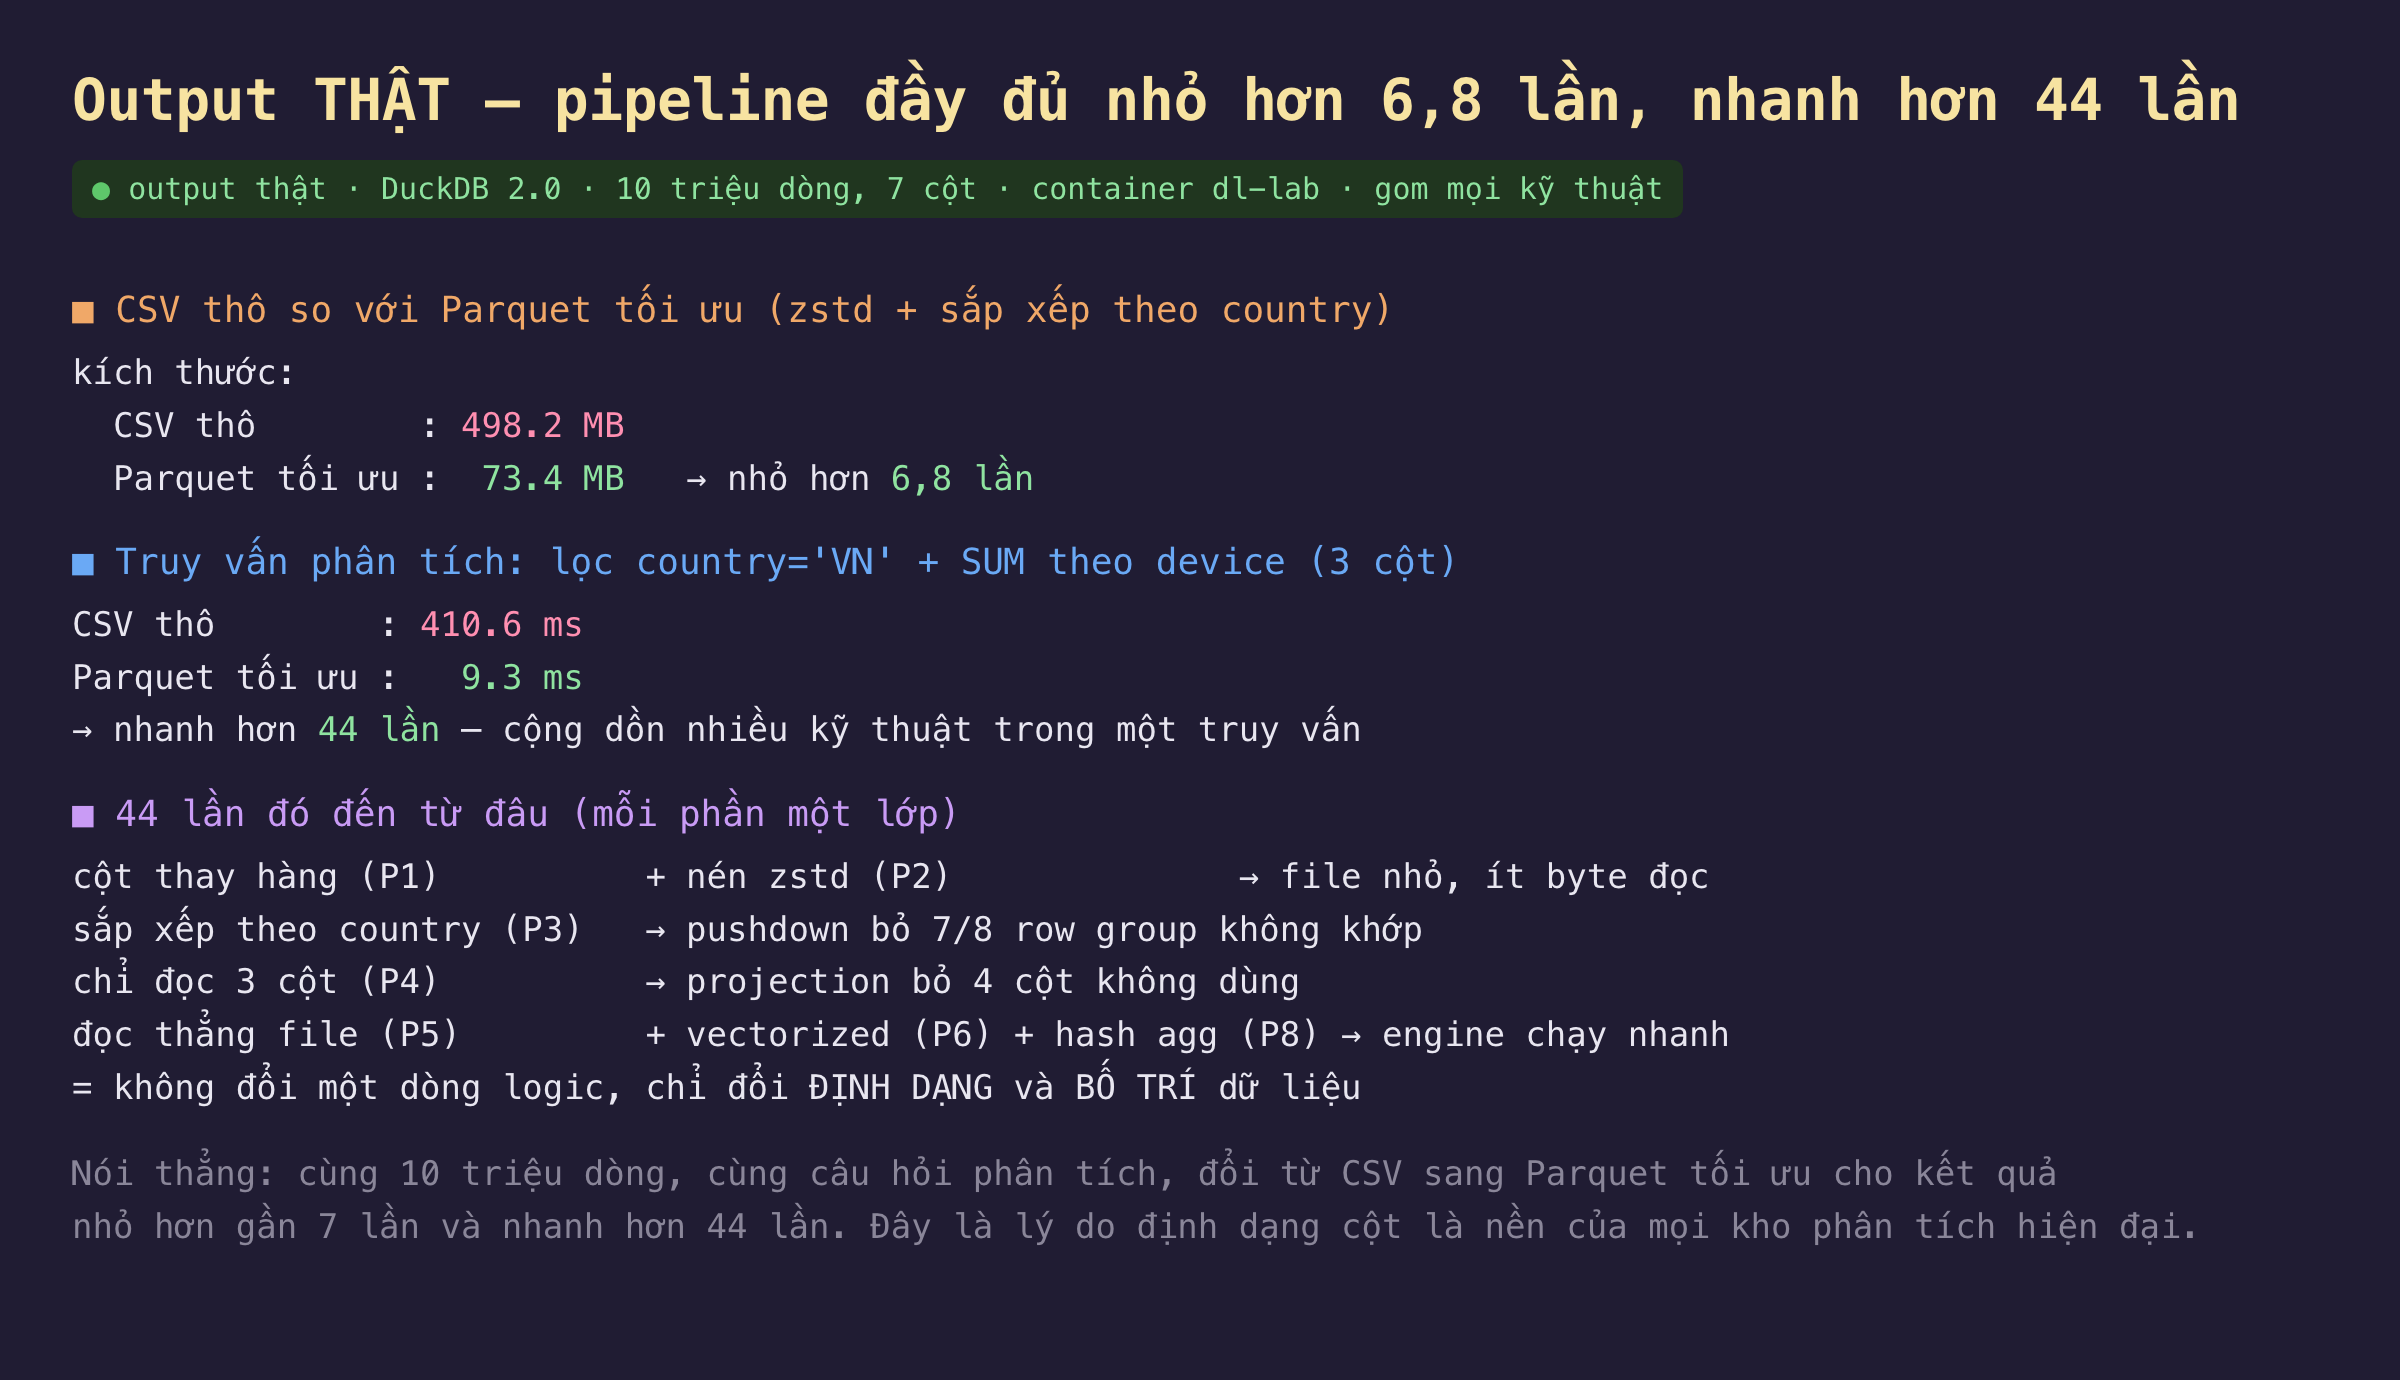
Hình 2: Pipeline end-to-end trên 10 triệu dòng — Parquet tối ưu nhỏ hơn CSV 6,8 lần và truy vấn nhanh hơn 44 lần, cộng dồn mọi kỹ thuật.
| phép đo | CSV thô | Parquet tối ưu |
|---|---|---|
| kích thước | 498,2 MB | 73,4 MB (6,8 lần nhỏ hơn) |
| truy vấn lọc + tổng | 410,6 ms | 9,3 ms (44 lần nhanh hơn) |
Chuyển cùng mười triệu dòng từ CSV sang Parquet tối ưu cho file nhỏ hơn 6,8 lần. Dữ liệu gốc dạng CSV nặng 498,2 MB. Ghi lại thành Parquet với nén zstd, sắp xếp theo cột country là cột hay lọc, và kích thước row group vừa phải, cho file chỉ 73,4 MB, nhỏ hơn sáu phẩy tám lần. Khác biệt này gom hai kỹ thuật: định dạng cột với encoding dictionary cho các cột lặp, và codec zstd nén nốt byte còn dư. Chỉ riêng việc đổi định dạng lưu, không đổi nội dung dữ liệu, đã tiết kiệm phần lớn dung lượng.
Cùng một truy vấn phân tích nhanh hơn 44 lần. Chạy một truy vấn điển hình, lọc theo một quốc gia rồi tính tổng theo thiết bị, chỉ cần ba cột trong bảy. Trên CSV mất 410,6 ms; trên Parquet tối ưu chỉ 9,3 ms, nhanh hơn bốn mươi bốn lần. Con số này không đến từ một kỹ thuật mà là tất cả cộng dồn: định dạng cột và nén làm file nhỏ nên đọc ít byte; sắp xếp theo country cho pushdown bỏ bảy phần tám row group không khớp; projection chỉ đọc ba cột và bỏ bốn cột không dùng; và engine đọc thẳng file với vectorized execution cùng hash aggregation chạy nhanh. Điều đáng chú ý nhất: không một dòng logic truy vấn nào thay đổi, chỉ định dạng và bố trí dữ liệu khác đi.
Bốn mươi bốn lần đó là minh họa cô đọng cho cả sê-ri. Mỗi lớp tăng tốc tương ứng một phần đã đo: cột thay hàng ở phần 1, nén zstd ở phần 2, pushdown nhờ sắp xếp ở phần 3, projection ở phần 4, quét tại chỗ ở phần 5, vectorized ở phần 6, hash aggregation ở phần 8. Chúng không loại trừ nhau mà chồng lên nhau, nên hiệu quả tổng lớn hơn bất kỳ kỹ thuật đơn lẻ nào. Đây là lý do định dạng cột là nền tảng của mọi kho dữ liệu phân tích hiện đại: nó cho phép nhiều tối ưu cùng hoạt động trên cùng một dữ liệu.
Những điều mang theo
Bắt đầu từ định dạng, đó là thay đổi rẻ nhất. Nếu chỉ làm được một việc từ sê-ri này, hãy chuyển dữ liệu phân tích từ CSV sang Parquet. Nó không đòi đổi công cụ truy vấn, không đổi logic, mà cho ngay file nhỏ hơn nhiều lần và truy vấn nhanh hơn hàng chục lần. Các kỹ thuật khác, sắp xếp, phân vùng, chọn cột, là những lớp tối ưu thêm trên nền đó, mỗi lớp cải thiện thêm tùy đặc tính dữ liệu và truy vấn. Nhưng bước đầu tiên và có tỉ lệ lợi ích cao nhất là bỏ định dạng hàng cho dữ liệu phân tích.
DuckDB đưa sức mạnh kho dữ liệu lên một máy. Trước đây, phân tích hàng chục triệu tới hàng trăm triệu dòng thường đòi một cụm Spark hay một kho dữ liệu đám mây. Sê-ri này cho thấy một công cụ như DuckDB, chạy trên một máy, xử lý được quy mô đó nhờ định dạng cột, vectorized execution, và khả năng spill ra đĩa khi vượt RAM. Với nhiều bài toán phân tích thực tế, một máy với DuckDB và dữ liệu Parquet là đủ, đơn giản hơn và rẻ hơn nhiều so với dựng hạ tầng phân tán. Biết khi nào một máy là đủ giúp tránh phức tạp không cần thiết.
Hiểu cơ chế quan trọng hơn thuộc công cụ. Sê-ri dùng DuckDB và Parquet làm ví dụ cụ thể, nhưng các nguyên lý, định dạng cột, pushdown, projection, vectorized, hash join, partitioning, áp dụng cho mọi hệ thống phân tích hiện đại, từ Spark tới Trino tới các kho đám mây. Hiểu vì sao cột thắng hàng, vì sao sắp xếp giúp pushdown, vì sao join bằng rẻ hơn join khoảng, giúp bạn viết truy vấn tốt và đọc kế hoạch thực thi trên bất kỳ công cụ nào, không chỉ DuckDB. Công cụ thay đổi, cơ chế thì bền.
Ba ý mang về từ cả sê-ri
- Định dạng cột là nền của phân tích hiệu quả. Parquet nhỏ hơn và nhanh hơn CSV nhiều lần, và cho phép pushdown, projection, nén cùng hoạt động; chuyển từ CSV sang Parquet là thay đổi rẻ nhất, hiệu quả nhất.
- Các kỹ thuật cộng dồn. Pipeline đầy đủ nhỏ hơn 6,8 lần và nhanh hơn 44 lần so với CSV thô, gom định dạng, nén, sắp xếp, projection và engine nhanh, mà không đổi một dòng logic.
- Dữ liệu lớn trên một máy không cần cụm. DuckDB xử lý hàng chục triệu dòng nhờ cột, vectorized và spill; chọn đúng định dạng, bố trí và cách viết truy vấn là đủ cho phần lớn bài toán phân tích.
Nguồn
- DuckDB — tài liệu chính thức và hướng dẫn hiệu năng: https://duckdb.org/docs/guides/performance/overview
- Apache Parquet — tài liệu định dạng file: https://parquet.apache.org/docs/
- Hannes Mühleisen và Mark Raasveldt — DuckDB: an Embeddable Analytical Database: https://dl.acm.org/doi/10.1145/3299869.3320212
- Daniel Abadi — The Design and Implementation of Modern Column-Oriented Database Systems: https://www.cs.umd.edu/~abadi/papers/abadi-column-stores.pdf
- DuckDB — Why DuckDB, triết lý xử lý dữ liệu trên một máy: https://duckdb.org/why_duckdb
Sê-ri xử lý dữ liệu lớn với Parquet và DuckDB dừng ở đây. Mười hai phần đã đi từ "vì sao cột thắng hàng" tới một pipeline hoàn chỉnh nhanh hơn CSV bốn mươi bốn lần, mỗi bước kiểm bằng phép đo thật. Hy vọng bạn rời sê-ri với một niềm tin thực tế: phần lớn bài toán dữ liệu lớn không cần hạ tầng phức tạp, mà cần hiểu đúng định dạng, bố trí, và cách công cụ đọc dữ liệu.
