Đây là bài cuối của sê-ri "Go chuyên sâu: Runtime, Hiệu năng và Hệ thống" — 132 bài, mỗi bài một cơ chế được mổ xẻ và một phép đo thật chạy trong container để chứng minh. Ta đã đi từ scheduler G-M-P và escape analysis, qua GC ba màu và sync.Pool, qua channel/mutex/context, qua pprof và trace, tới database pool, Raft, gRPC, và một REST API capstone 16.000 req/s bằng thư viện chuẩn. Bài tổng kết này làm hai việc: vẽ bản đồ để bạn quay lại tra cứu, và chạy một benchmark cuối gói lại hai bài học lớn nhất vào hai con số.
Bản đồ tám chủ đề
Cả sê-ri có thể xếp vào tám nhóm — dùng đây như mục lục để quay lại:
- Runtime: scheduler G-M-P và work-stealing, escape analysis, GC ba màu và write barrier, cách con trỏ và interface được biểu diễn, preemption.
- Bộ nhớ: stack vs heap,
sync.Pool, đọcGODEBUG=gctrace=1, tinh chỉnhGOGC/GOMEMLIMIT, bố cục struct và cache line. - Đồng thời: goroutine, channel có/không đệm, mutex vs atomic,
contexttruyền huỷ,errgroup, các mẫu song song (fan-out/fan-in, worker pool, pipeline). - Hiệu năng: viết benchmark đúng (tránh DCE), pprof CPU/heap/mutex/block,
go tool trace, inline, hồ sơ liên tục. - Hệ thống:
net/http, gRPC,database/sqlpool, Redis, Kafka, Raft, service discovery, distributed lock. - Chất lượng: test bảng, fuzzing, property-based, mock, golden file, coverage đúng nghĩa,
govulncheck,staticcheck. - Chẩn đoán: panic trace,
runtime.Stack, phát hiện rò rỉ goroutine, Delve, core dump. - Capstone: gộp tất cả vào một dịch vụ REST production-grade.
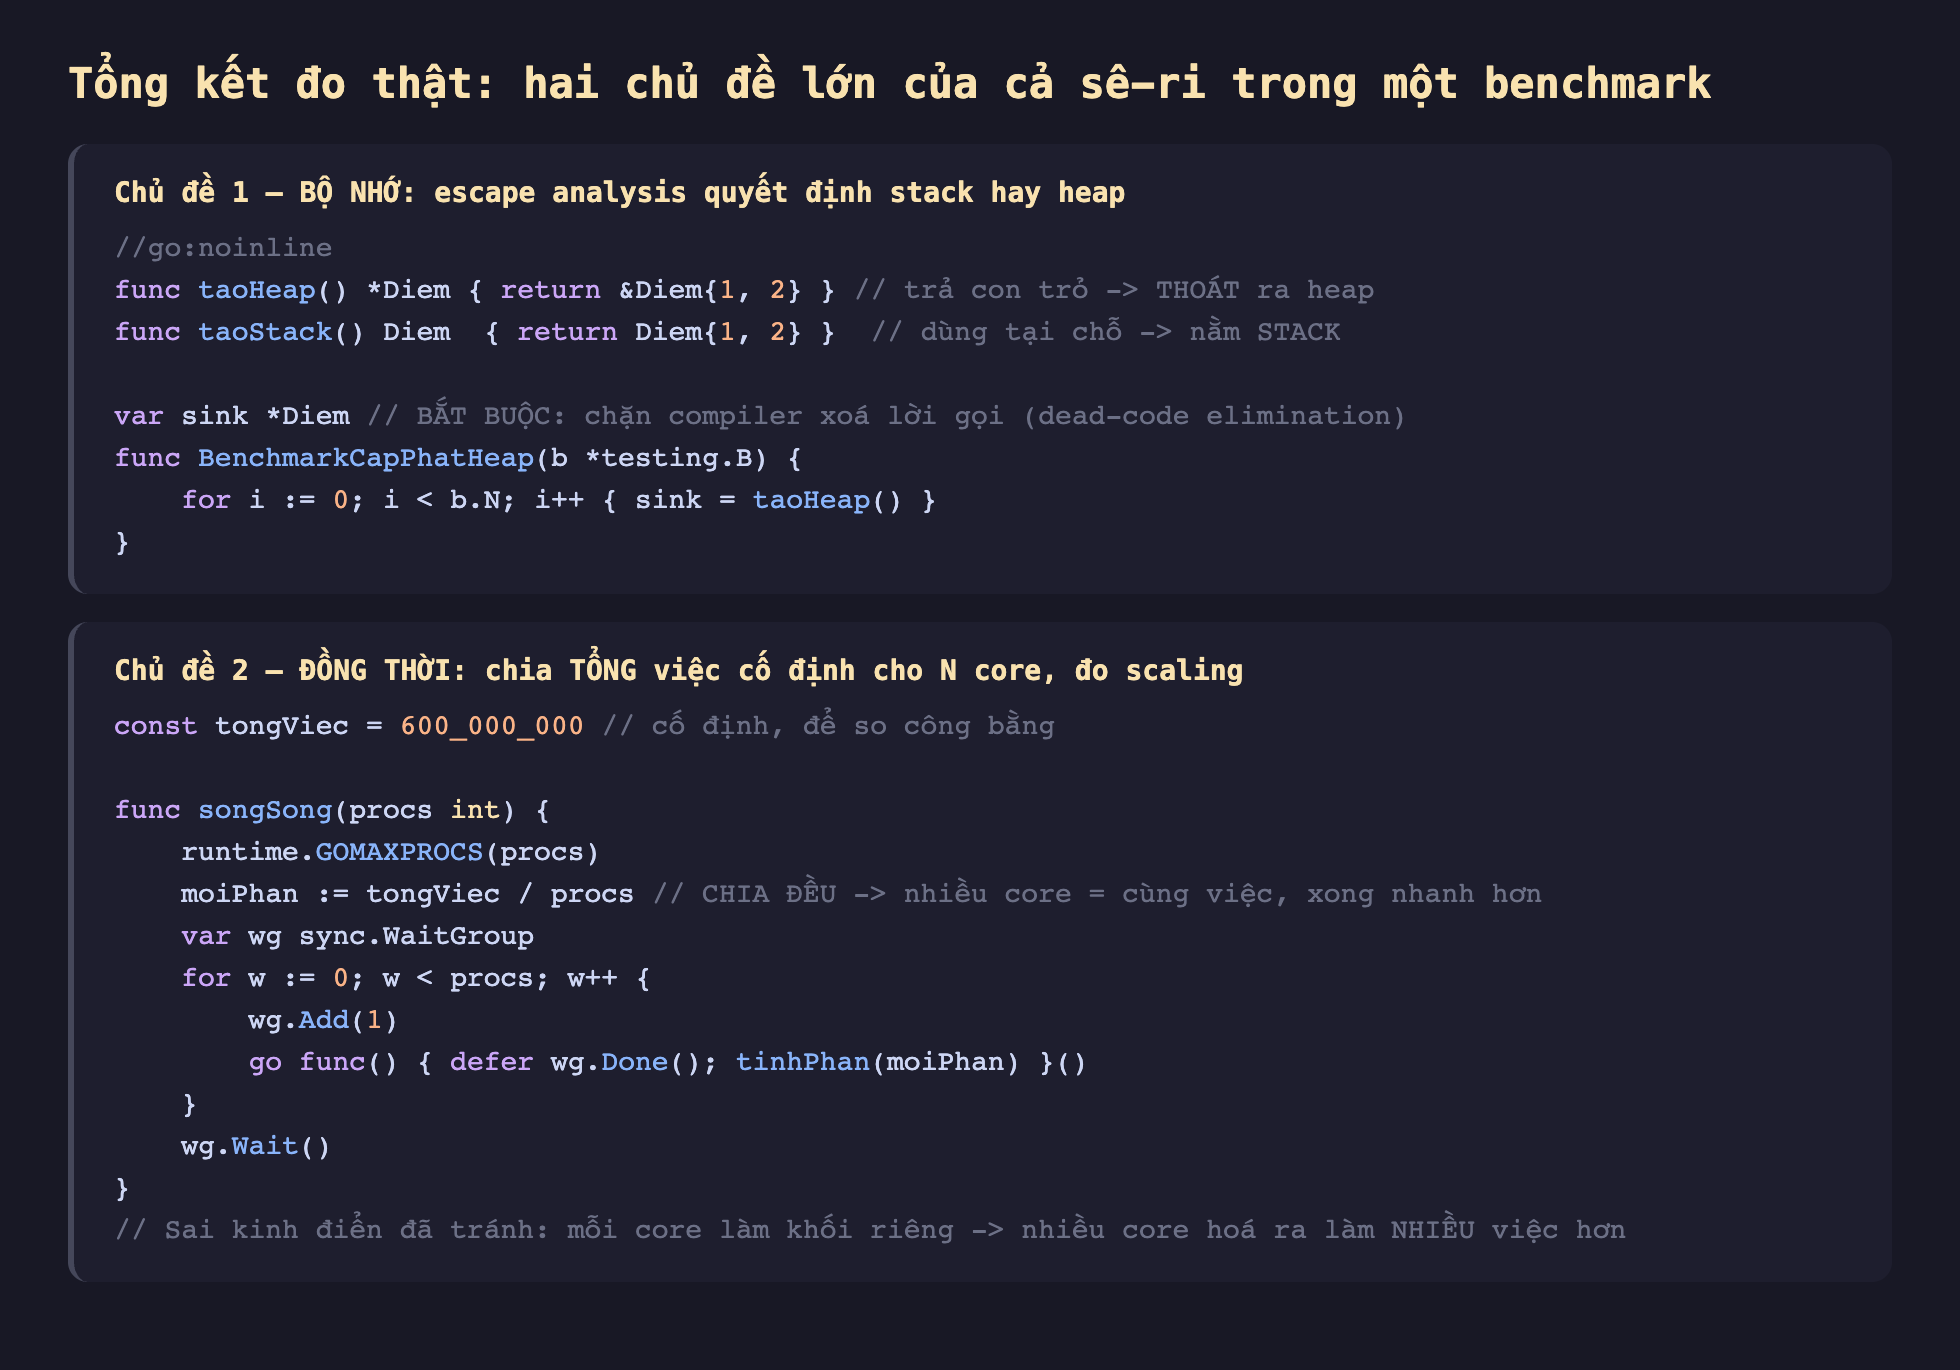
Hình 1: Benchmark tổng hợp gói hai chủ đề lớn — escape analysis (stack vs heap, có sink chặn DCE) và scaling theo core (chia đều một tổng việc cố định để so công bằng).
Hai con số gói lại cả sê-ri
Ta chạy một benchmark cuối, đo thật hai điều cốt lõi nhất:
BenchmarkCapPhatHeap    10,56 ns/op   16 B/op   1 allocs/op
BenchmarkCapPhatStack   0,7251 ns/op   0 B/op   0 allocs/op
-> stack nhanh ~14,5 lần, KHÔNG cấp phát, KHÔNG gánh nặng GC

Benchmark1Core    292,6 ms/op   (mốc)
Benchmark2Core    148,5 ms/op   nhanh 1,97x  -> gần tuyến tính
Benchmark10Core    63,6 ms/op   nhanh 4,60x  -> dưới tuyến tính
Bài học bộ nhớ: cùng một struct, cấp trên stack (taoStack) chạy 0,73 ns với 0 cấp phát, còn cấp trên heap (taoHeap, vì trả về con trỏ nên escape) chạy 10,56 ns với 1 cấp phát 16 byte — nhanh hơn ~14,5 lần. Đây là lý do escape analysis là chủ đề nền tảng: mỗi cấp phát heap không chỉ tốn lúc cấp, mà còn thêm việc cho GC sau này. Giảm cấp phát là đòn bẩy hiệu năng lớn nhất trong Go, và nó bắt đầu từ hiểu cái gì escape.
Bài học đồng thời: cùng 600 triệu phép tính, chia cho nhiều core. Từ 1 lên 2 core: nhanh 1,97x — gần tuyến tính hoàn hảo. Nhưng từ 1 lên 10 core: chỉ 4,6x, không phải 10x. Đây là sự thật quan trọng nhất về song song mà cả sê-ri nhấn đi nhấn lại: thêm core giúp thật, nhưng lợi ích giảm dần — do phần tuần tự không chia được (Amdahl), do băng thông bộ nhớ bão hoà, do phí lịch và đồng bộ. Song song không phải phép nhân miễn phí.
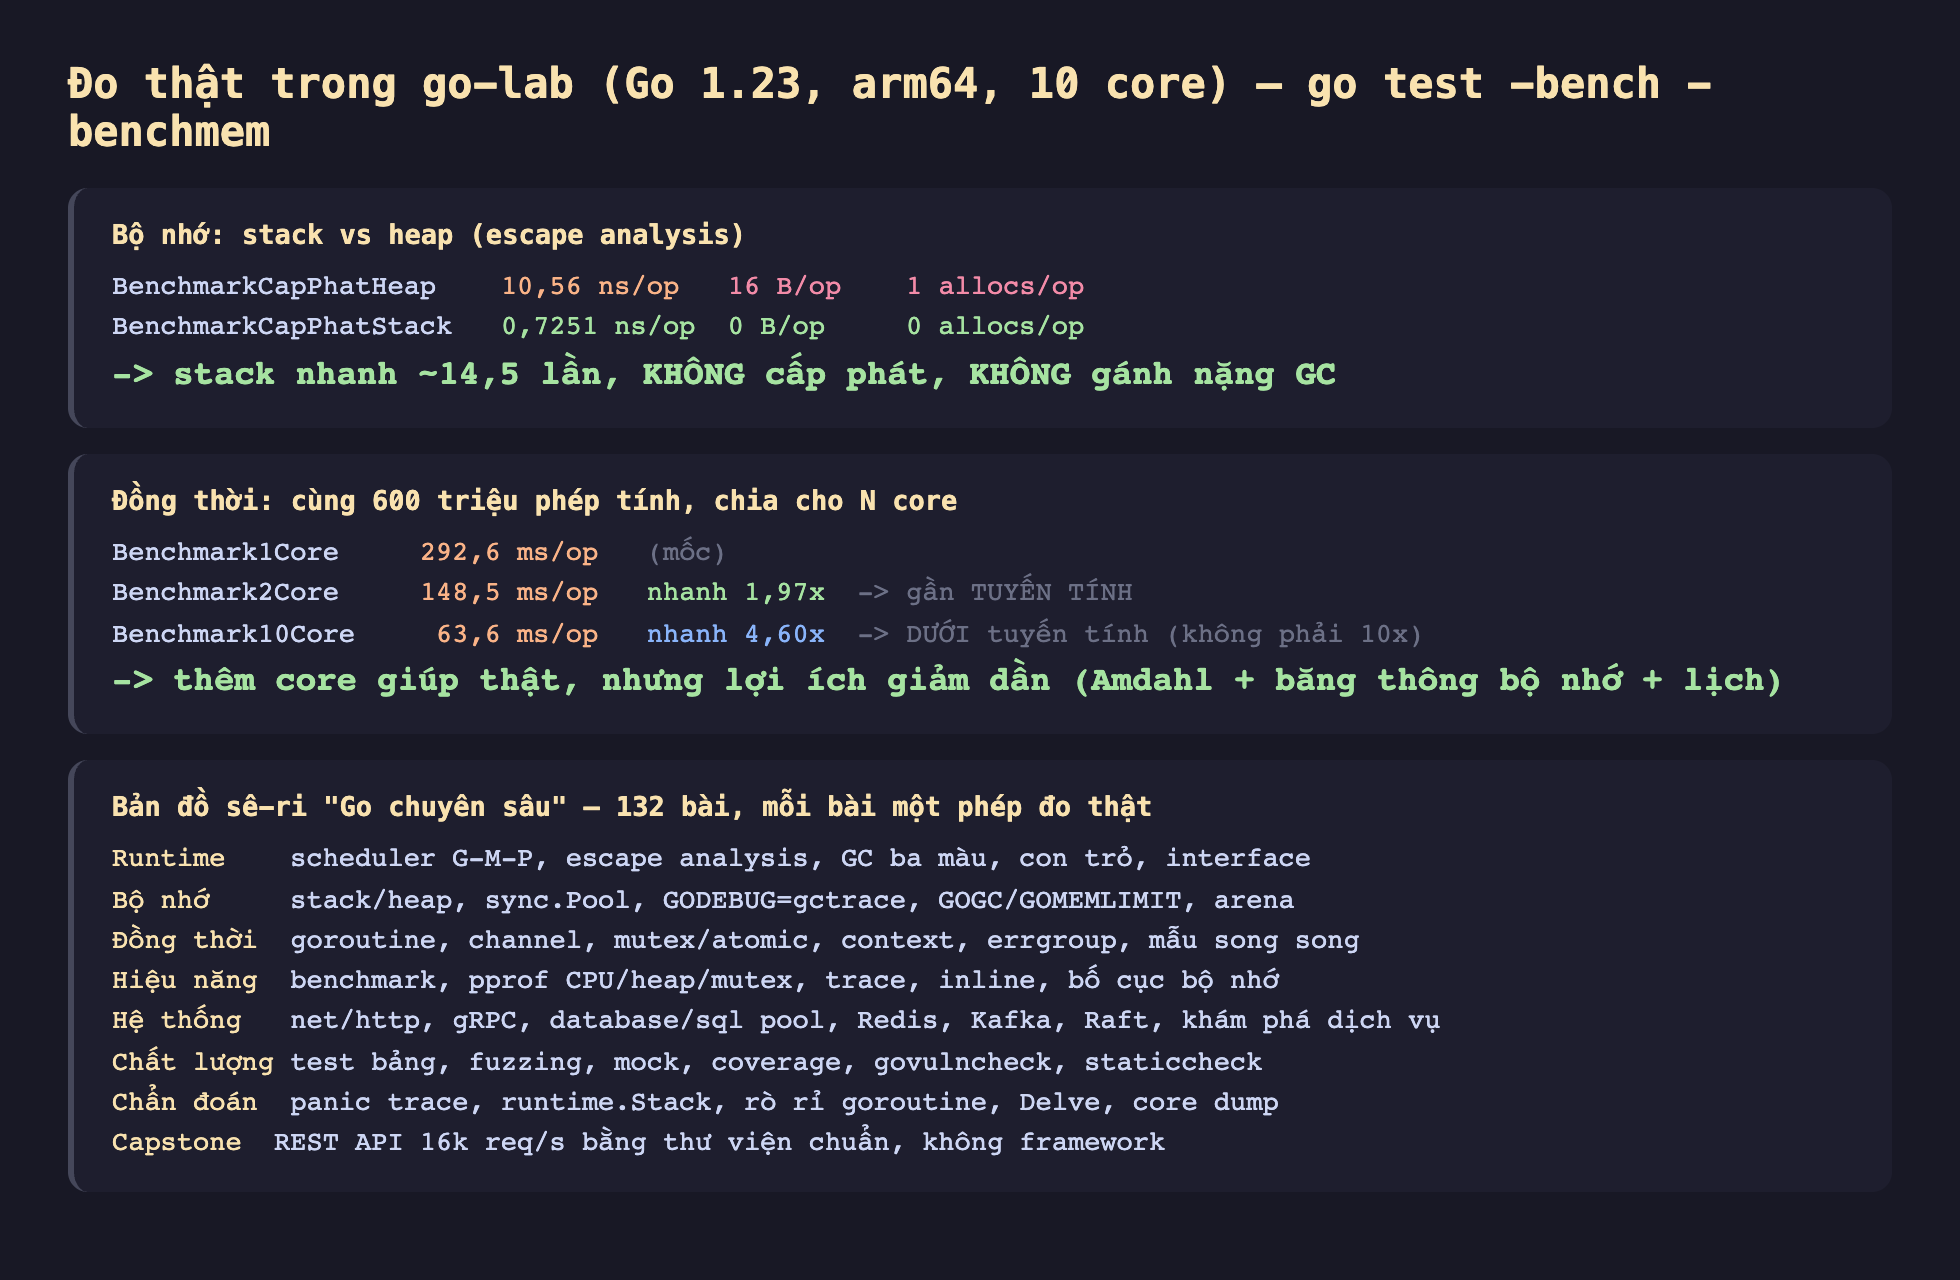
Hình 2: Đo thật — stack nhanh hơn heap ~14,5 lần với 0 cấp phát; scaling theo core gần tuyến tính ở 2 core (1,97x) nhưng dưới tuyến tính ở 10 core (4,6x); cùng bản đồ tám chủ đề của sê-ri.
Cách tư duy đọng lại sau 132 bài
Đo, đừng đoán — nhưng đo cho đúng. Xuyên suốt sê-ri, mỗi khẳng định đều kèm một con số chạy thật. Nhưng đo sai còn tệ hơn không đo: benchmark heap ở trên ban đầu cho 0 alloc vì compiler xoá luôn lời gọi không dùng kết quả (dead-code elimination) — phải thêm sink mới thấy con số thật. Đo scaling ban đầu cho 10 core chậm hơn 1 core vì mỗi core làm khối việc riêng (nhiều core = nhiều việc), phải chia một tổng cố định mới công bằng. Công cụ mạnh nhất của bạn — pprof, benchmark, trace — chỉ đúng khi bạn hiểu cái bẫy của chúng.
Đơn giản trước, tối ưu sau khi profile. Capstone đạt 16.000 req/s bằng thư viện chuẩn không tinh chỉnh. Rất nhiều "tối ưu" chỉ thêm phức tạp mà không đo được lợi ích. Quy trình đúng: viết code rõ ràng trước, đo để tìm điểm nóng thật, rồi mới tối ưu đúng chỗ đó — và đo lại để xác nhận. sync.Pool, lock sharding, GOGC tuning đều là dao hai lưỡi; dùng khi profile chỉ ra, không dùng theo tin đồn.
Nêu đánh đổi, không tuyệt đối hoá. Không có "luôn nhanh hơn". Subquery tương quan rẻ khi có index; channel gọn nhưng mutex đôi khi nhanh hơn; thêm core giúp tới một ngưỡng. Kỹ sư giỏi không thuộc lòng "cái nào tốt" mà hiểu khi nào cái nào tốt, và biết đo để kiểm chứng trong ngữ cảnh của mình. Đó là điều 132 bài này cố gắng truyền lại — không phải một danh sách mẹo, mà một cách nhìn: cơ chế bên dưới quyết định hành vi, và phép đo thật là trọng tài cuối cùng.
Cảm ơn bạn đã đi hết sê-ri. Go là một ngôn ngữ mà càng hiểu sâu runtime càng viết được hệ thống tốt hơn — và mọi thứ ở đây đều có thể tự chạy lại, tự đo, tự kiểm chứng. Đó mới là phần quan trọng nhất.
Ba ý mang về
- Giảm cấp phát heap là đòn bẩy hiệu năng lớn nhất trong Go: đo thật, cùng struct cấp trên stack nhanh hơn heap ~14,5 lần (0,73 ns vs 10,56 ns) với 0 cấp phát và 0 gánh nặng GC — hiểu escape analysis là nền tảng của mọi tối ưu bộ nhớ.
- Song song giúp thật nhưng dưới tuyến tính: đo thật, cùng khối việc chia cho core cho 1,97x ở 2 core (gần tuyến tính) nhưng chỉ 4,6x ở 10 core (không phải 10x) — vì Amdahl, băng thông bộ nhớ và phí lịch; đừng kỳ vọng thêm core là nhân đôi mù quáng.
- Cách tư duy đọng lại: đo đừng đoán nhưng phải đo cho đúng (cả hai benchmark trên ban đầu đều cho số sai vì DCE và so sánh không công bằng), đơn giản trước rồi tối ưu sau khi profile, và luôn nêu đánh đổi thay vì tuyệt đối hoá — cơ chế bên dưới quyết định hành vi, phép đo thật là trọng tài cuối cùng.
