Đây là bài cuối của series. Sau 131 bài đo từng kỹ thuật — từ EXPLAIN, index, JOIN, giao dịch, phân vùng, nhân bản, tới giám sát và các quy trình chẩn đoán — câu hỏi còn lại là: làm sao để tất cả không thành một đống kiến thức rời rạc chỉ dùng khi cháy nhà? Câu trả lời là một quy trình bền vững: tối ưu không phải việc làm một lần rồi quên, mà là một vòng lặp giữ database khoẻ mạnh lâu dài. Bài này chốt lại vòng lặp đó và ba nguyên tắc đã xuyên suốt cả series.
Vòng lặp năm bước
Tối ưu không có đích đến. Hệ thống thay đổi — dữ liệu lớn lên, tải đổi, phiên bản nâng cấp — nên tối ưu là một chu trình lặp mãi:
  ĐO  ──►  XÁC ĐỊNH  ──►  SỬA  ──►  XÁC NHẬN  ──►  GIÁM SÁT
  ▲                                                    │
  └────────────────────────────────────────────────────┘
- ĐO: bắt đầu bằng số liệu (
pg_stat_statements,EXPLAIN), không phải cảm tính. - XÁC ĐỊNH: tìm nút thắt thật — query? cấu hình? bloat? khoá? (dùng wait events,
pg_stat_user_tables). - SỬA: một thay đổi mỗi lần — thêm index, chỉnh config, viết lại query.
- XÁC NHẬN: đo lại để chắc chắn thật sự tốt hơn, không phải tưởng tượng.
- GIÁM SÁT: đặt cảnh báo để bắt vấn đề mới trước khi thành sự cố, rồi vòng lại.
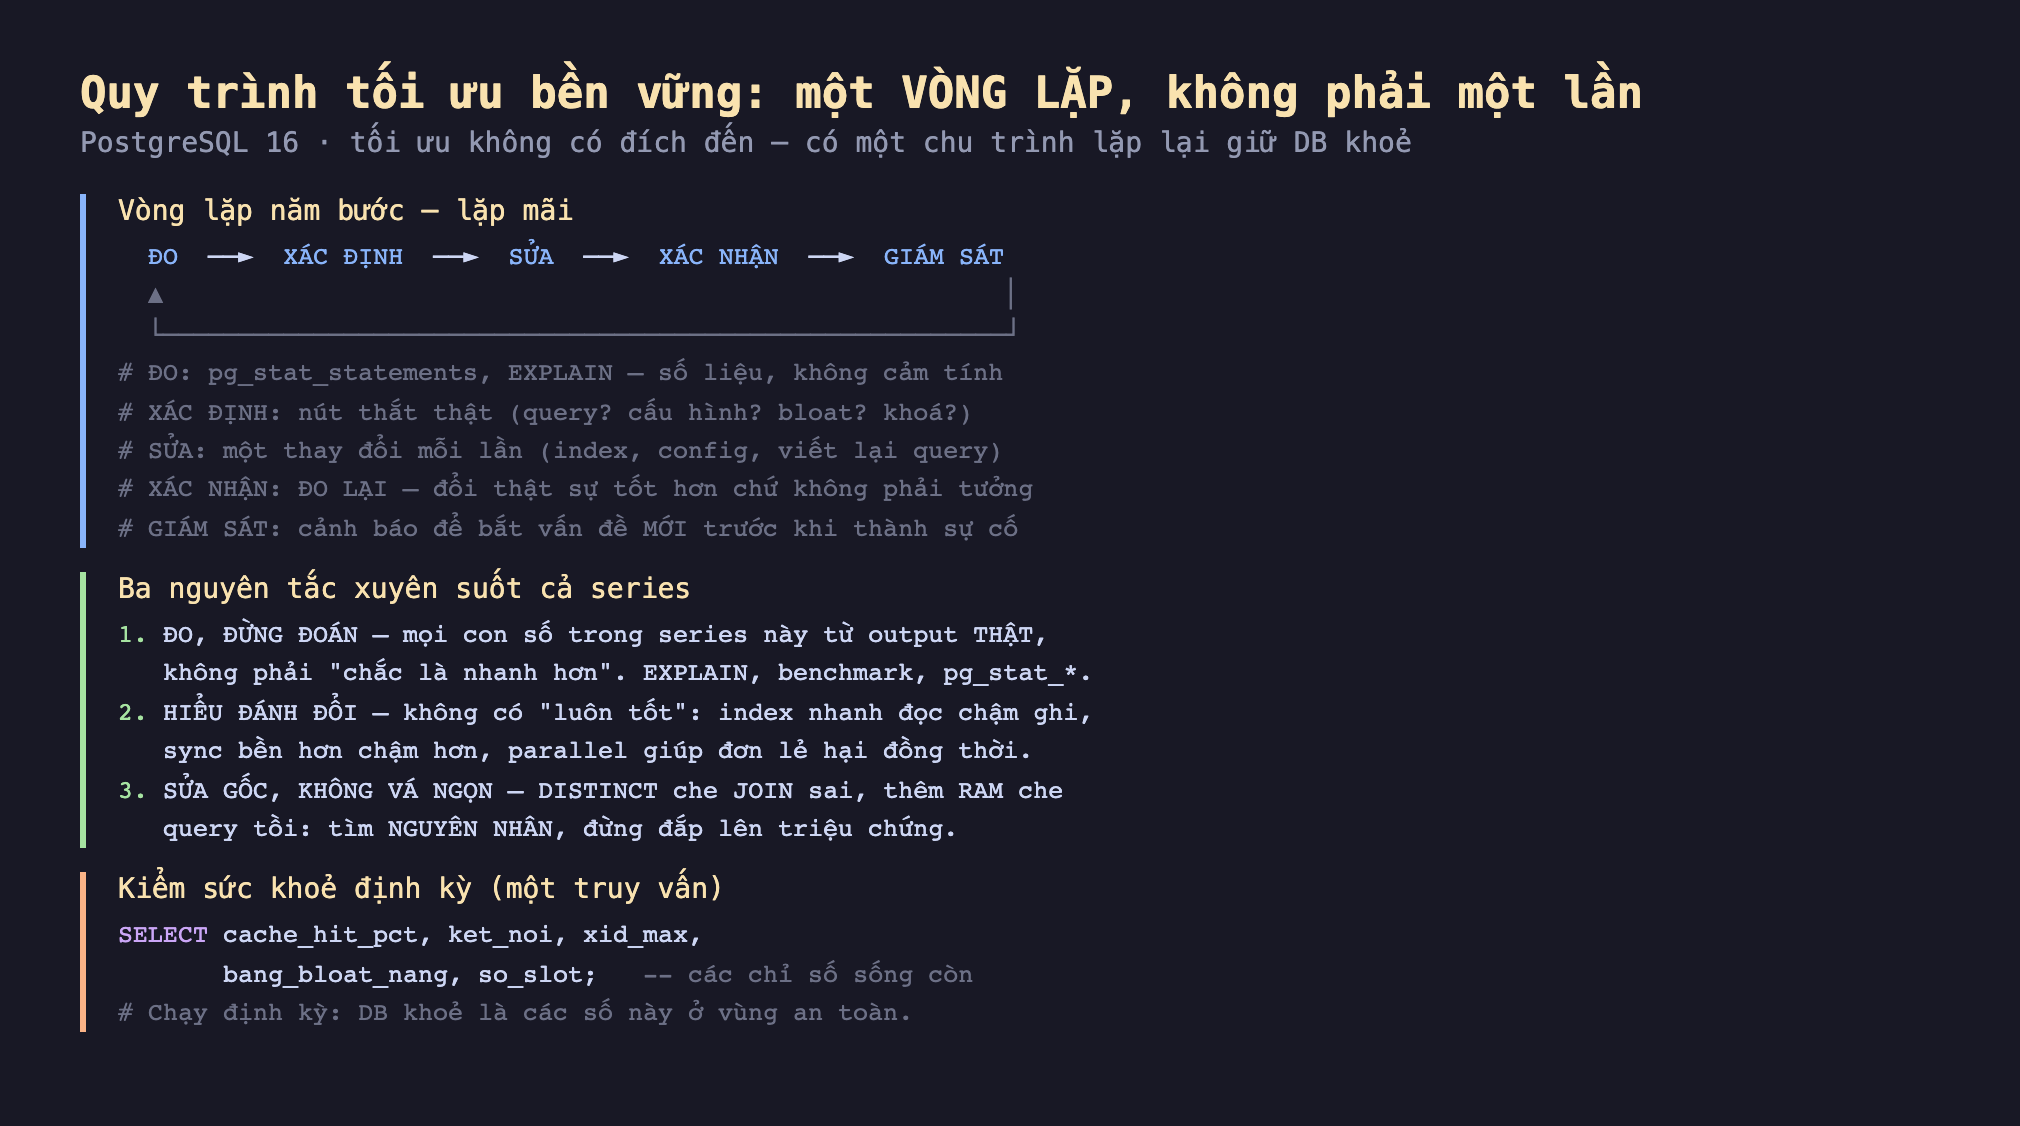
Hình 1: Vòng lặp tối ưu năm bước (đo → xác định → sửa → xác nhận → giám sát → lặp lại), ba nguyên tắc xuyên suốt series, và một truy vấn kiểm sức khoẻ định kỳ.
Bằng chứng: một database khoẻ
Quy trình này cho ra thứ gì? Một database mà các chỉ số sống còn luôn ở vùng an toàn. Tôi chạy một truy vấn kiểm sức khoẻ trên lab và đây là kết quả thật:
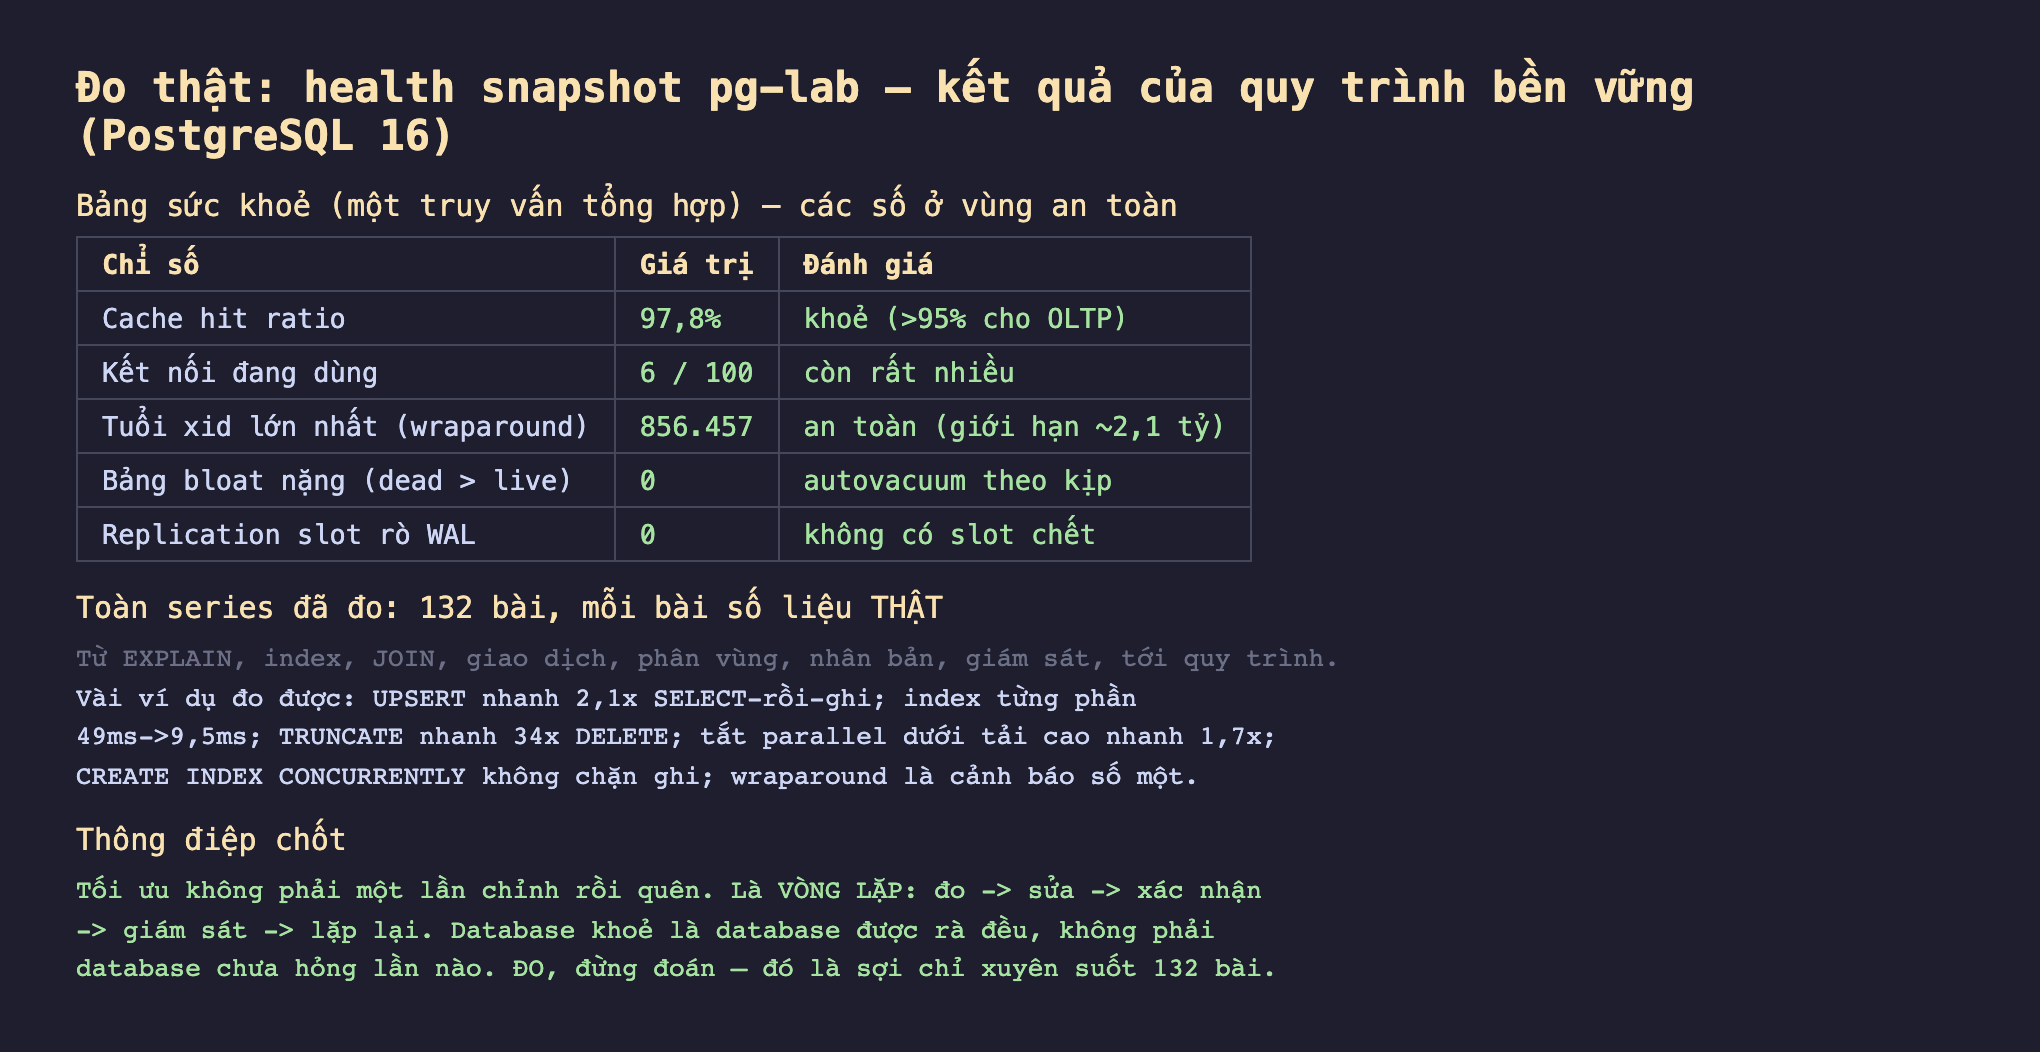
Hình 2: Health snapshot thật — cache hit 97,8%, 6/100 kết nối, tuổi xid 856.457 (an toàn), 0 bảng bloat nặng, 0 slot rò WAL. Tất cả ở vùng an toàn — kết quả của một quy trình được duy trì, không phải may mắn.
Các số đều xanh: cache hit 97,8%, kết nối 6/100, tuổi xid 856.457 (rất xa giới hạn 2,1 tỷ), 0 bảng bloat nặng (autovacuum theo kịp), 0 slot rò WAL. Đây không phải may mắn — nó là kết quả của việc duy trì quy trình. Một database khoẻ là database được rà đều, không phải database chưa hỏng lần nào.
Ba nguyên tắc xuyên suốt 132 bài
Nếu chỉ mang về ba điều từ cả series, hãy là ba nguyên tắc này:
1. Đo, đừng đoán. Mọi con số trong series này đến từ output thật — EXPLAIN (ANALYZE, BUFFERS), benchmark pgbench, các view pg_stat_* — không phải "chắc là nhanh hơn". Trực giác về hiệu năng thường sai: bài đo cho thấy subquery tương quan có index còn nhanh hơn JOIN, parallel query hại dưới tải cao, maintenance_work_mem cao không giúp khi sort không tràn đĩa. Chỉ đo mới biết.
2. Hiểu đánh đổi. Gần như không có gì "luôn tốt". Index tăng tốc đọc nhưng làm chậm ghi và tốn đĩa. Nhân bản đồng bộ bền hơn nhưng chậm hơn. TRUNCATE nhanh hơn DELETE 34 lần nhưng khoá cả bảng và không có WHERE. Mỗi quyết định tối ưu là một đánh đổi — biết mình đổi gì lấy gì mới chọn đúng cho hoàn cảnh của mình.
3. Sửa gốc, không vá ngọn. SELECT DISTINCT che dòng trùng do JOIN sai, thêm RAM che một query tồi, tắt cảnh báo thay vì sửa nguyên nhân — đó là vá ngọn. Series này nhiều lần chỉ ra: tìm nguyên nhân (JOIN thừa, thiếu index, giao dịch dài giữ khoá), đừng đắp lên triệu chứng. Vá ngọn khiến vấn đề quay lại lớn hơn.
Đánh đổi cần cân nhắc
Quy trình cần kỷ luật, không phải công cụ đắt tiền. Bạn không cần công cụ thương mại đắt đỏ để tối ưu bền vững — pg_stat_statements, EXPLAIN, các view pg_stat_* đều miễn phí và sẵn có. Cái khó là duy trì thói quen: chạy kiểm sức khoẻ định kỳ, rà checklist mỗi quý, đo lại sau mỗi thay đổi. Kỷ luật quan trọng hơn công cụ.
Đừng tối ưu quá sớm hay quá đà. Vòng lặp bắt đầu bằng ĐO là có lý do: tối ưu thứ chưa đo là đoán mò, và tối ưu thứ không phải nút thắt là lãng phí. Một database nhỏ chạy tốt không cần phân vùng hay read replica — thêm chúng chỉ tăng độ phức tạp. Tối ưu khi đo thấy cần, ở đúng chỗ nút thắt.
Kiến thức là điểm khởi đầu, ngữ cảnh của bạn là quyết định. Mọi con số trong series đo trên một lab cụ thể (PostgreSQL 16, phần cứng nhất định, dữ liệu tổng hợp). Chúng minh hoạ cơ chế và hướng, không phải con số tuyệt đối cho hệ thống của bạn. Dùng chúng để hiểu vì sao, rồi đo lại trên chính hệ thống thật của mình.
Ba ý mang về
- Tối ưu là một vòng lặp, không phải một lần chỉnh rồi quên: đo → xác định nút thắt → sửa một thứ → xác nhận bằng đo lại → giám sát để bắt vấn đề mới → lặp lại; database khoẻ (health snapshot thật: cache hit 97,8%, 0 bảng bloat nặng, xid an toàn) là kết quả của quy trình được duy trì, không phải may mắn.
- Ba nguyên tắc xuyên suốt 132 bài: đo đừng đoán (mọi số từ output thật, trực giác hiệu năng hay sai), hiểu đánh đổi (gần như không gì "luôn tốt" — index, sync, parallel đều có mặt trái), sửa gốc không vá ngọn (tìm nguyên nhân, đừng đắp lên triệu chứng).
- Quy trình cần kỷ luật hơn công cụ, và ngữ cảnh của bạn mới quyết định:
pg_stat_statements/EXPLAIN/pg_stat_*miễn phí là đủ — cái khó là duy trì thói quen rà đều; đừng tối ưu quá sớm (đo trước), và luôn kiểm chứng mọi con số trên chính hệ thống thật của mình.
Cảm ơn bạn đã theo hết series Tối ưu hóa database với PostgreSQL — 132 bài, mỗi bài một phép đo thật. Mong nó giúp bạn không chỉ biết cách làm mà còn hiểu vì sao, và trên hết: đo, đừng đoán.
