Sau cả một series đo đạc từng kỹ thuật, dễ rơi vào tình trạng "biết nhiều mà không nhớ hết khi cần". Bài này gom mọi thứ thành một checklist thực dụng — năm nhóm cần rà khi tối ưu một PostgreSQL thật, để không bỏ sót điều quan trọng. Và để chứng minh checklist không phải lý thuyết suông, tôi audit thật một database đang chạy: kết quả cho thấy nhiều tham số vẫn ở giá trị mặc định chưa hề chỉnh theo phần cứng — đúng loại vấn đề mà một lần rà checklist bắt được ngay.
Năm nhóm rà soát
1. CẤU HÌNH — shared_buffers, work_mem, random_page_cost... theo RAM/CPU/đĩa thật
2. INDEX — đủ index cho điều kiện lọc, bỏ index thừa, REINDEX bloat
3. TRUY VẤN — EXPLAIN query nặng, tránh N+1, NOT EXISTS thay NOT IN
4. BẢO TRÌ — autovacuum khoẻ, theo dõi bloat, canh wraparound
5. GIÁM SÁT — pg_stat_statements, cảnh báo wraparound/kết nối/lag, pgBadger
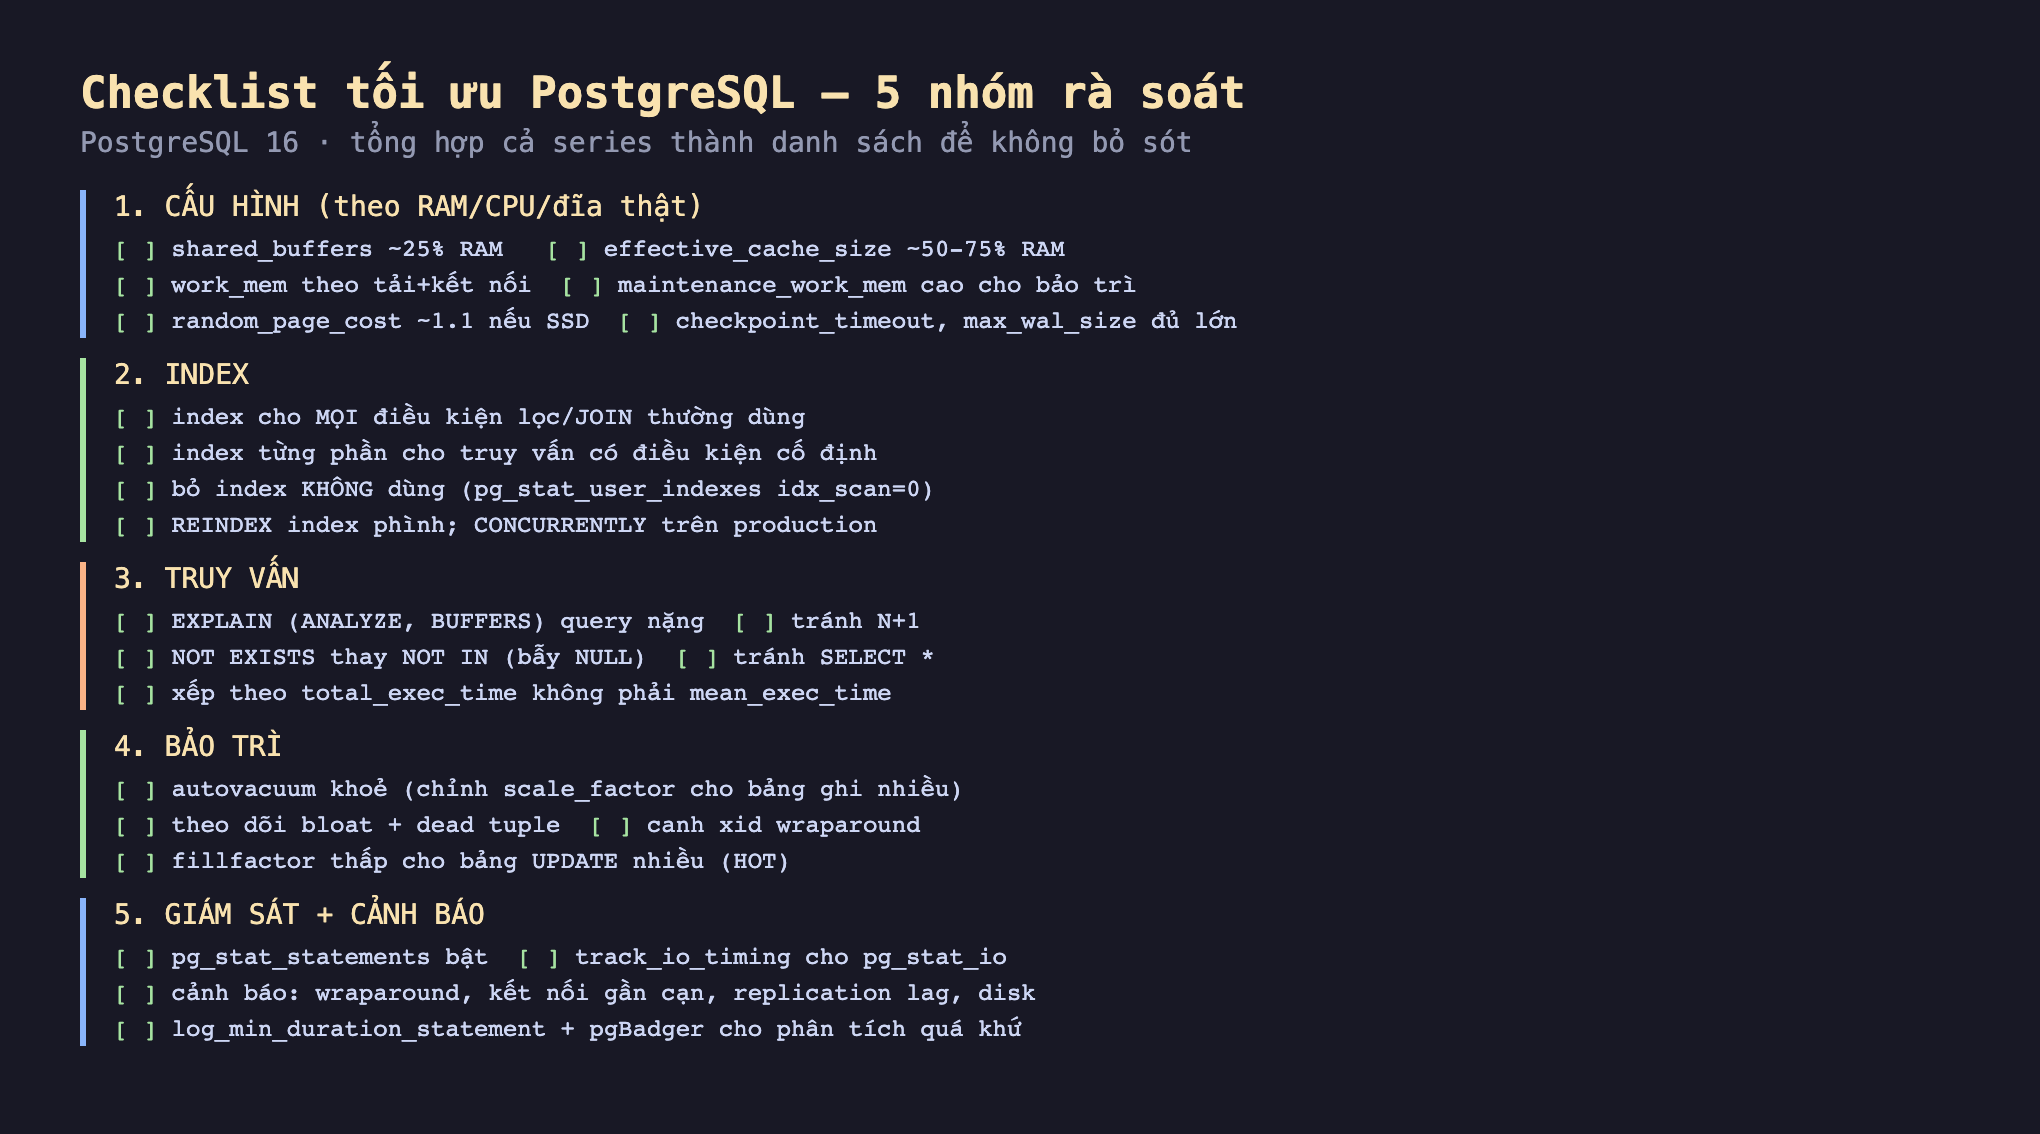
Hình 1: Checklist năm nhóm — cấu hình, index, truy vấn, bảo trì, giám sát+cảnh báo. Mỗi nhóm gom lại các kỹ thuật cả series đã đo, thành các mục cần rà.
Audit thật: mặc định không phải tối ưu
Tôi chạy audit cấu hình trên database lab (máy 7,7 GB RAM, 10 core) — và đây là điều một lần rà checklist phát hiện:
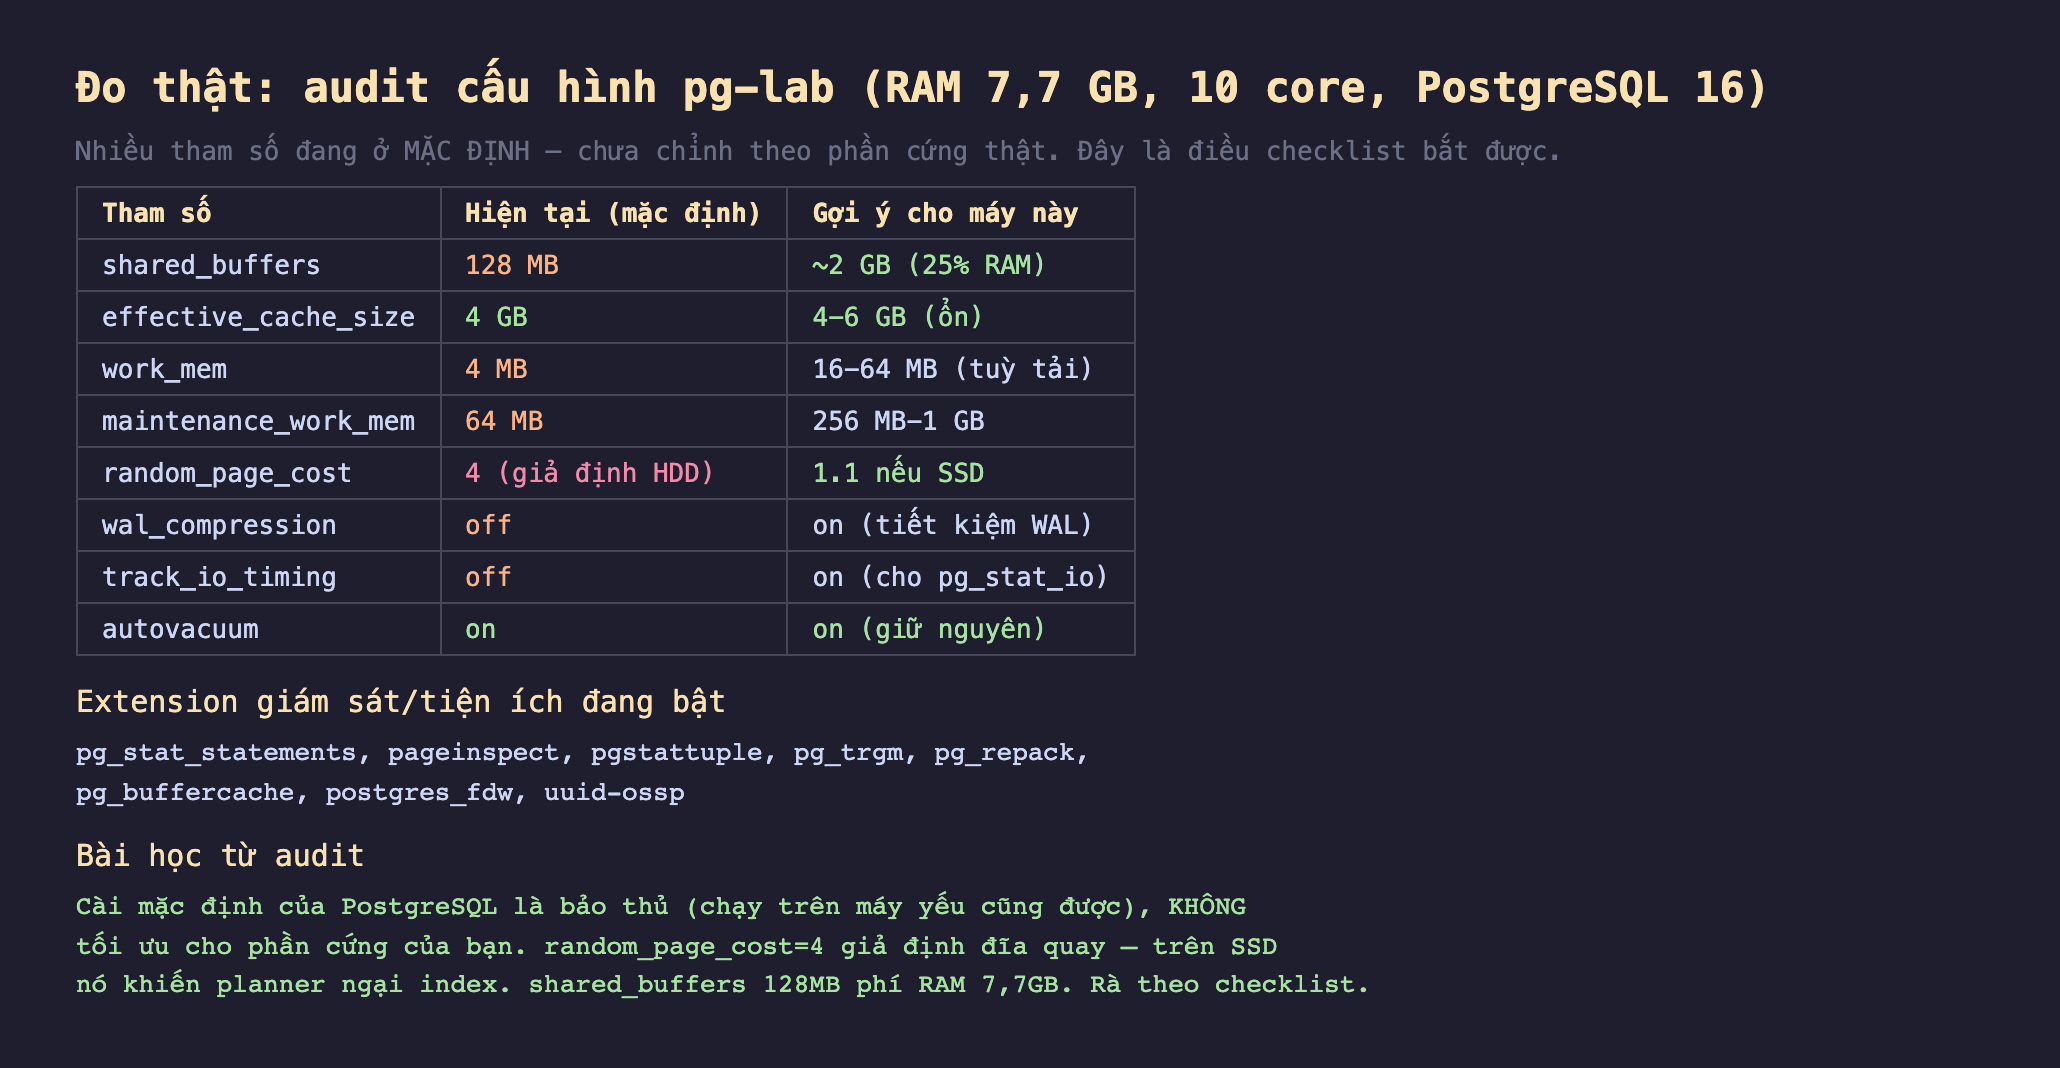
Hình 2: Audit thật — shared_buffers vẫn 128 MB (phí RAM 7,7 GB), random_page_cost = 4 (giả định HDD, khiến planner ngại index trên SSD), work_mem/maintenance_work_mem ở mặc định, wal_compression/track_io_timing tắt. Nhiều thứ đáng chỉnh.
Kết quả cho thấy hầu hết tham số quan trọng đang ở mặc định:
shared_buffers= 128 MB trên máy 7,7 GB RAM — nên khoảng 2 GB (25% RAM). Đang phí phần lớn RAM.random_page_cost= 4 — giá trị giả định đĩa quay (HDD). Trên SSD nên là ~1,1; giữ 4 khiến planner ngại dùng index (tưởng đọc ngẫu nhiên đắt), như bài vềrandom_page_costđã đo.work_mem= 4 MB,maintenance_work_mem= 64 MB — mặc định thấp; nâng lên giúp sort/hash không tràn đĩa và bảo trì nhanh hơn.wal_compression= off,track_io_timing= off — nên bật (tiết kiệm WAL, và chopg_stat_iocó số liệu thời gian).
Điểm sáng: autovacuum bật, và một loạt extension giám sát/tiện ích đã cài (pg_stat_statements, pageinspect, pg_repack, pg_buffercache, postgres_fdw...). Bài học lớn: cài mặc định của PostgreSQL cố ý bảo thủ để chạy được trên cả máy yếu — nó không tối ưu cho phần cứng của bạn. Rà cấu hình theo RAM/CPU/đĩa thật gần như luôn là thứ đầu tiên đáng làm.
Dùng checklist thế nào
Rà theo thứ tự ưu tiên, không làm hết một lúc. Cấu hình (nhóm 1) thường cho lợi ích lớn nhất với công ít nhất — chỉnh shared_buffers, random_page_cost một lần, cả hệ thống hưởng lợi. Sau đó tới index (nhóm 2) cho các query cụ thể. Đừng cố tối ưu mọi thứ cùng lúc; đo trước, chỉnh thứ tác động lớn nhất, đo lại.
Mỗi mục đều có công cụ đo trong series. Không đoán "chắc thiếu index" — dùng pg_stat_user_tables (bài đã đo) để tìm bảng seq scan nhiều. Không đoán "chắc query này chậm" — dùng pg_stat_statements xếp theo tổng thời gian. Không đoán "chắc bị bloat" — kiểm n_dead_tup. Checklist chỉ chỗ cần nhìn; các bài trước cho cách đo.
Đánh đổi cần cân nhắc
Checklist là điểm khởi đầu, không phải luật cứng. "shared_buffers 25% RAM" là quy tắc ngón tay cái tốt, nhưng workload thật có thể cần khác (data warehouse quét lớn dựa nhiều vào OS cache có thể để thấp hơn). Mọi gợi ý trong checklist cần đo trên chính hệ thống của bạn — như cả series đã nhấn mạnh: đo, đừng đoán.
Đừng chỉnh mù theo checklist. Nâng work_mem quá cao với nhiều kết nối có thể làm hết RAM (mỗi phiên dùng work_mem cho mỗi sort). Bật mọi extension giám sát tốn tài nguyên. Rà checklist là để phát hiện điều đáng xem, rồi cân nhắc từng thứ theo ngữ cảnh — không phải áp dụng máy móc mọi gợi ý.
Tối ưu là việc lặp lại, không phải một lần. Hệ thống thay đổi: dữ liệu lớn lên, tải đổi, phiên bản nâng cấp. Checklist này nên chạy định kỳ (ví dụ mỗi quý), không phải một lần rồi quên. Cấu hình đúng hôm nay có thể cần chỉnh lại sau sáu tháng.
Ba ý mang về
- Checklist tối ưu PostgreSQL gom thành năm nhóm: cấu hình (theo RAM/CPU/đĩa), index (đủ và không thừa), truy vấn (EXPLAIN, tránh bẫy), bảo trì (autovacuum, bloat, wraparound), giám sát+cảnh báo — rà theo thứ tự ưu tiên, chỉnh thứ tác động lớn trước.
- Audit thật cho thấy mặc định không phải tối ưu: trên máy 7,7 GB RAM,
shared_buffersvẫn 128 MB,random_page_cost= 4 (giả định HDD, ngại index trên SSD), nhiều tham số ở mặc định — cài mặc định của PostgreSQL cố ý bảo thủ, không chỉnh theo phần cứng của bạn. - Checklist chỉ chỗ cần nhìn, các bài trước cho cách đo: mỗi mục đều có công cụ đo cụ thể (
pg_stat_user_tables,pg_stat_statements,n_dead_tup...) — đừng đoán, đo; và nhớ mọi gợi ý là điểm khởi đầu cần kiểm chứng trên chính hệ thống của bạn, chạy lại định kỳ.
Phần sau khép lại series bằng bức tranh lớn: Phần sau tổng kết một quy trình tối ưu bền vững — không phải một lần chỉnh cho nhanh rồi quên, mà một vòng lặp đo-chỉnh-theo dõi giữ database khoẻ mạnh lâu dài.
