Bạn có 1 triệu phần tử và cần trả lời nhanh câu hỏi "phần tử này đã thấy chưa?". Một map[string]struct{} làm được, nhưng nó lưu cả 1 triệu chuỗi — tốn hàng chục MB. Nếu bạn chấp nhận một tỉ lệ sai nhỏ có kiểm soát, có một cấu trúc dữ liệu tiết kiệm bộ nhớ đến kinh ngạc: Bloom filter.
Bloom filter là một cấu trúc xác suất. Nó trả lời hai loại: "phần tử có thể có trong tập" hoặc "phần tử chắc chắn không có". Nó không lưu phần tử — chỉ một mảng bit và vài hàm băm. Đánh đổi: có thể dương tính giả (báo "có thể có" khi thực ra không), nhưng không bao giờ âm tính giả (đã thêm thì luôn báo "có thể"). Bài này tự cài Bloom filter từ đầu trong Go, đo thật tỉ lệ dương tính giả so với thiết kế, và so bộ nhớ với một set đầy đủ.
Cơ chế: mảng bit + k hàm băm
type Bloom struct { bits []uint64; m uint64; k int }
- Thêm một phần tử: băm nó bằng
khàm băm rakvị trí, và bậtkbit đó. - Kiểm một phần tử: băm ra
kvị trí y hệt; nếu cảkbit đều bật → "có thể có"; nếu bất kỳ bit nào tắt → "chắc chắn không" (vì nếu đã thêm, mọi bit của nó phải bật).
Dương tính giả xảy ra khi k bit của một phần tử chưa thêm tình cờ đều đã bị bật bởi các phần tử khác. Âm tính giả không thể xảy ra — đó là bảo đảm cốt lõi.
Chọn m và k tối ưu
Số bit m và số hàm băm k không chọn tùy ý — có công thức tối ưu từ số phần tử dự kiến n và tỉ lệ dương tính giả p bạn muốn:
m := uint64(math.Ceil(-float64(n) * math.Log(p) / (math.Ln2 * math.Ln2)))
k := int(math.Round(float64(m) / float64(n) * math.Ln2))
Công thức này (dẫn xuất từ lý thuyết xác suất) cho m và k sao cho đạt đúng tỉ lệ p với ít bit nhất. Ta sẽ kiểm chứng nó bằng đo thật.
Thêm và kiểm bằng double hashing
func (b *Bloom) Them(data string) {
	h1, h2 := b.viTri(data)          // 2 hàm băm cơ sở
	for i := 0; i < b.k; i++ {
		pos := (h1 + uint64(i)*h2) % b.m  // double hashing: k vị trí
		b.bits[pos/64] |= 1 << (pos % 64) // bật bit
	}
}
func (b *Bloom) CoThe(data string) bool {
	h1, h2 := b.viTri(data)
	for i := 0; i < b.k; i++ {
		pos := (h1 + uint64(i)*h2) % b.m
		if b.bits[pos/64]&(1<<(pos%64)) == 0 {
			return false // 1 bit tắt -> CHẮC CHẮN không có
		}
	}
	return true // cả k bit bật -> CÓ THỂ có
}
Một mẹo quan trọng: thay vì cài k hàm băm độc lập (tốn kém), ta dùng double hashing — sinh k vị trí từ hai hàm băm cơ sở theo công thức g_i(x) = h1(x) + i·h2(x). Chỉ cần băm FNV-64 một lần rồi tách 32 bit thấp/cao thành h1, h2. Kỹ thuật chuẩn này cho phân bố tốt gần như k hàm độc lập thật.
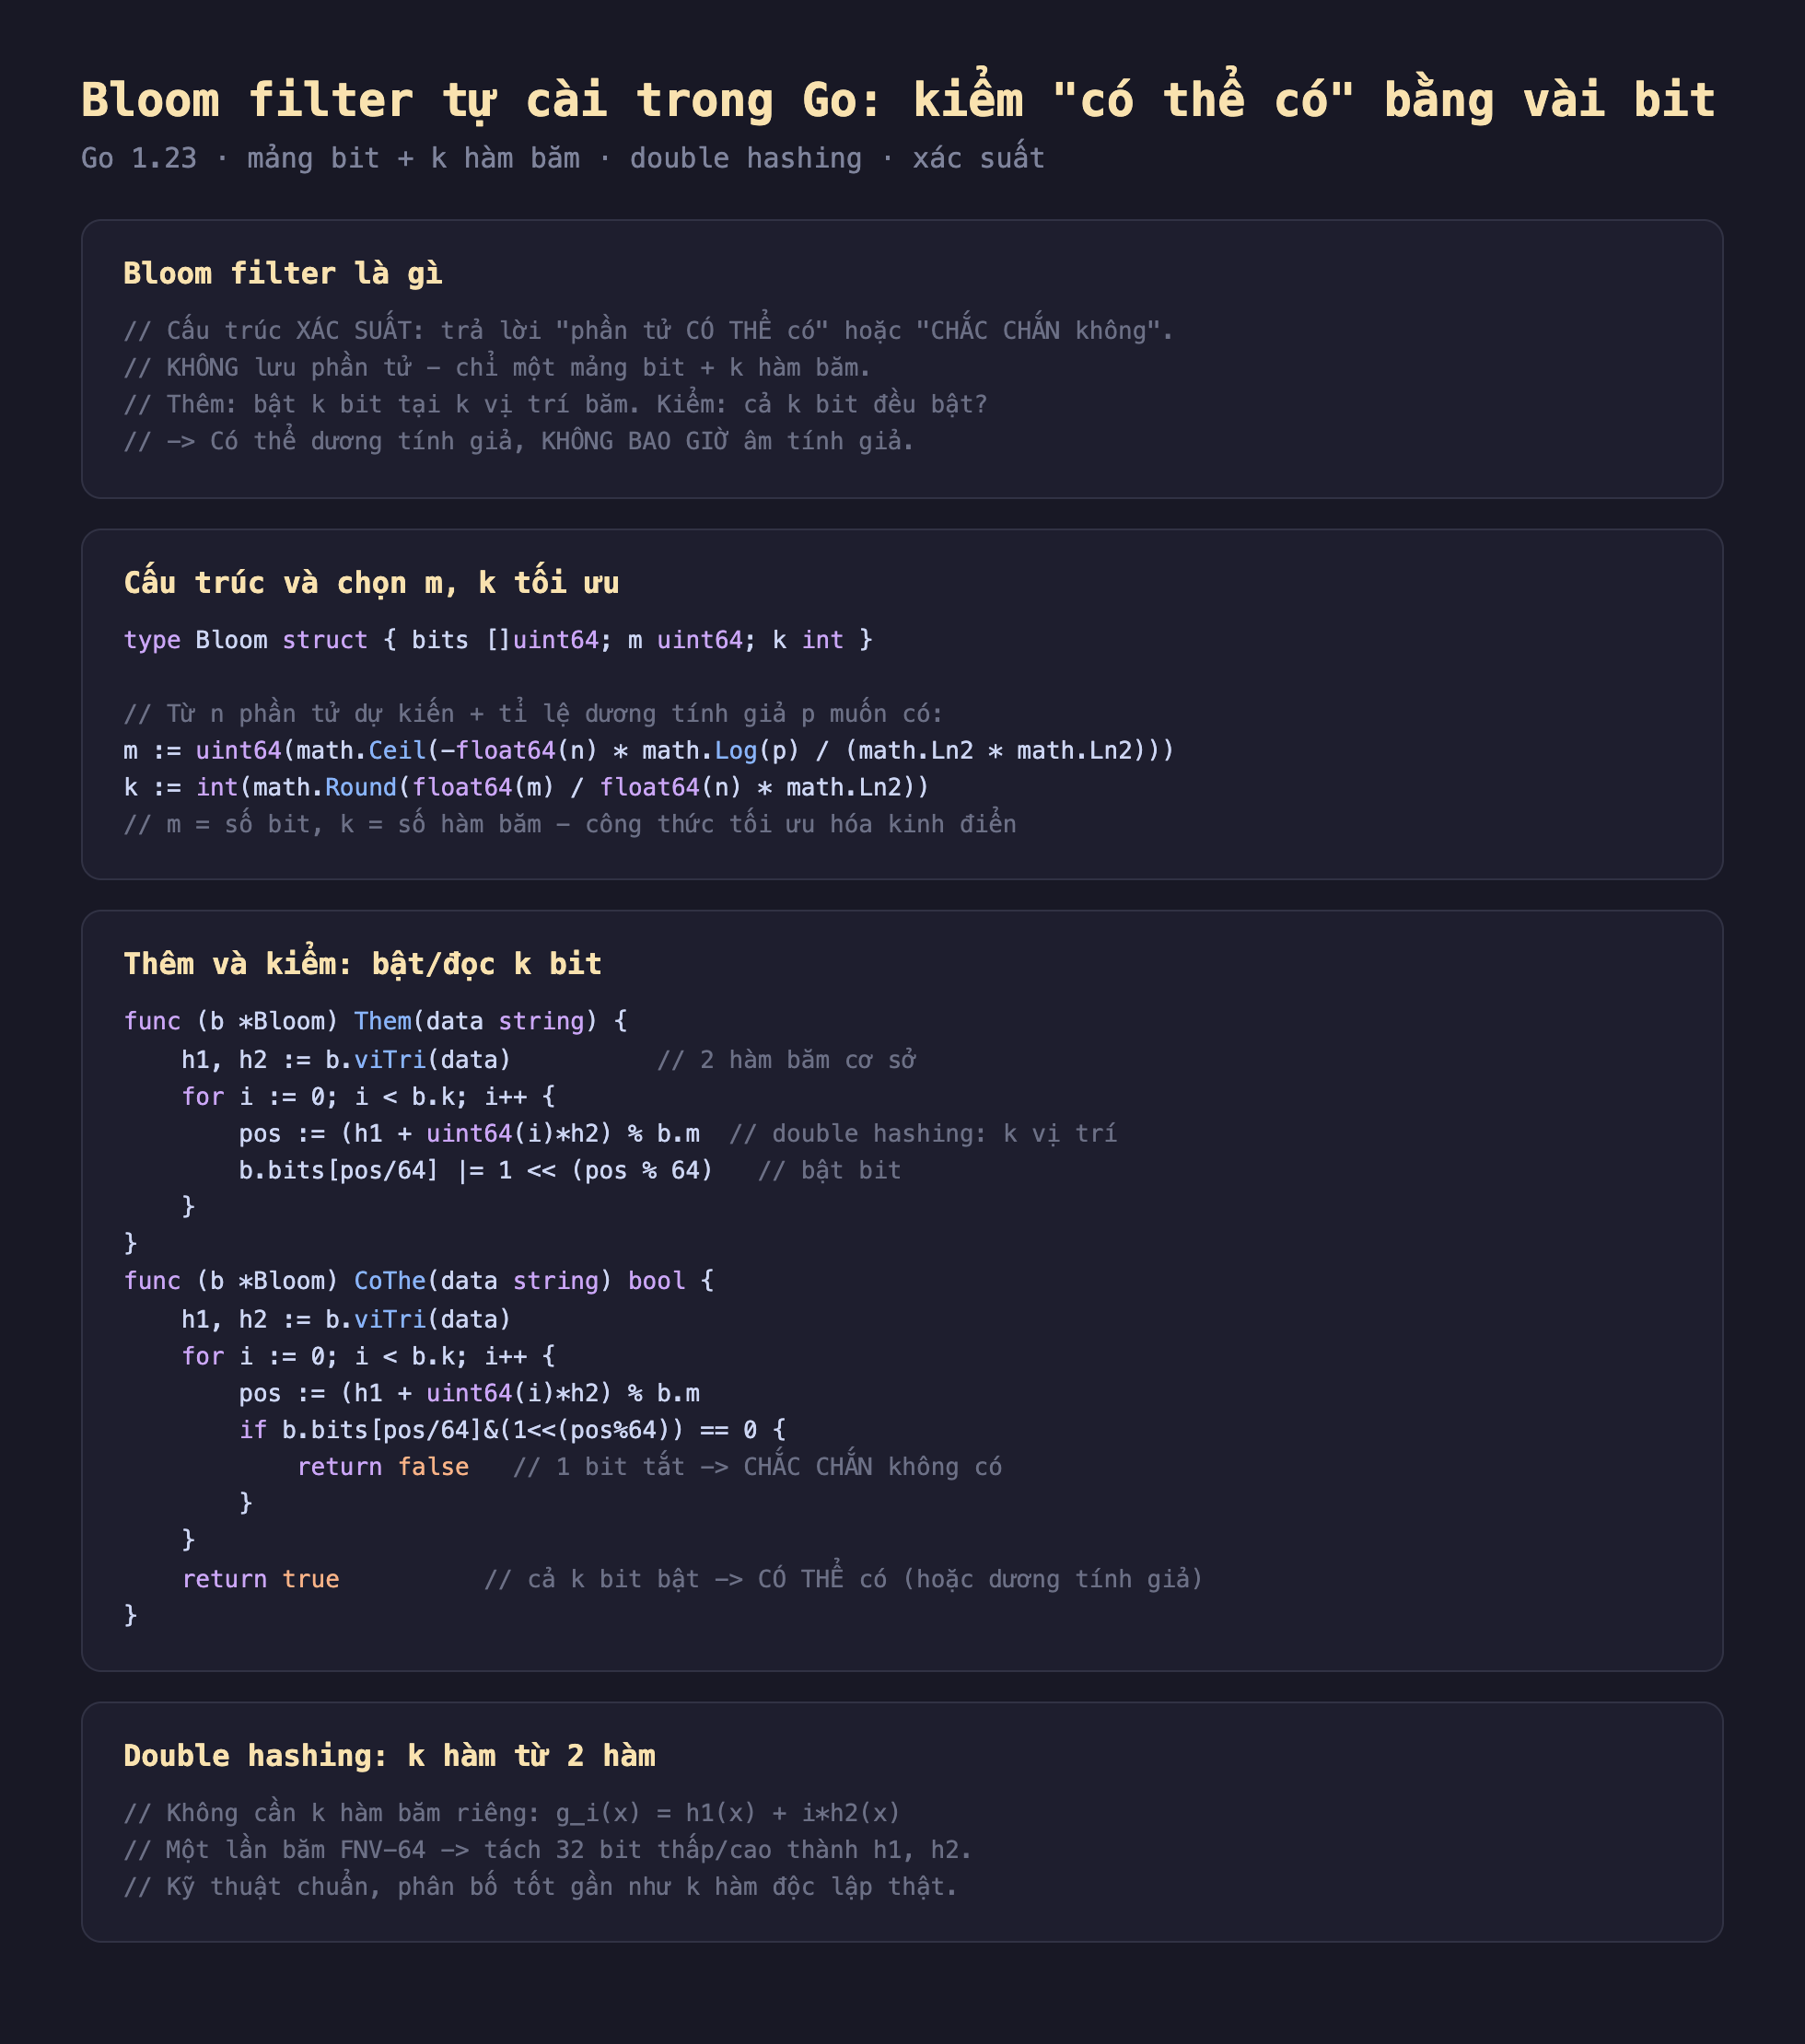
Hình 1: Bloom filter tự cài — mảng bit + k hàm băm; thêm bật k bit, kiểm đọc k bit (một bit tắt là chắc chắn không có); chọn m, k tối ưu bằng công thức từ n và p; double hashing sinh k vị trí từ hai hàm băm.
Đo thật: tính đúng và bộ nhớ
Dựng Bloom filter cho 1 triệu phần tử, mục tiêu dương tính giả 1%:
m = 9585059 bit (1.20 MB), k = 7 hàm băm
Công thức tự tính ra 9.585.059 bit (1.20 MB) và 7 hàm băm. Thêm 1 triệu phần tử item-0..item-999999, rồi kiểm hai điều:
Âm tính giả (đã thêm mà báo không): 0   <- PHẢI là 0
Dương tính giả: 9986/1000000 = 1.00% (mục tiêu 1%)
- Không âm tính giả (0): mọi phần tử đã thêm đều được báo "có thể có" — đúng bảo đảm cốt lõi. Bloom filter không bao giờ bỏ sót thứ đã thêm.
- Dương tính giả 1.00%: kiểm 1 triệu phần tử chưa thêm, có 9.986 bị báo nhầm "có thể có" — đúng 1.00%, khớp chính xác mục tiêu thiết kế. Đây là bằng chứng công thức chọn
m,kđúng.
So bộ nhớ thật (đo HeapAlloc):
Bloom filter          = 1.20 MB  (chỉ mảng bit)
map[string]struct{}   = 56.1 MB  (lưu cả 1 triệu chuỗi)
Bloom ít hơn: ~47 lần
Bloom filter dùng 1.20 MB so với 56.1 MB của một set đầy đủ — ít hơn ~47 lần. Vì Bloom không lưu phần tử (chỉ bit), bộ nhớ của nó gần như độc lập với độ dài chuỗi — dù mỗi phần tử là chuỗi dài hay URL cả trăm ký tự, filter vẫn chỉ tốn số bit đã tính.
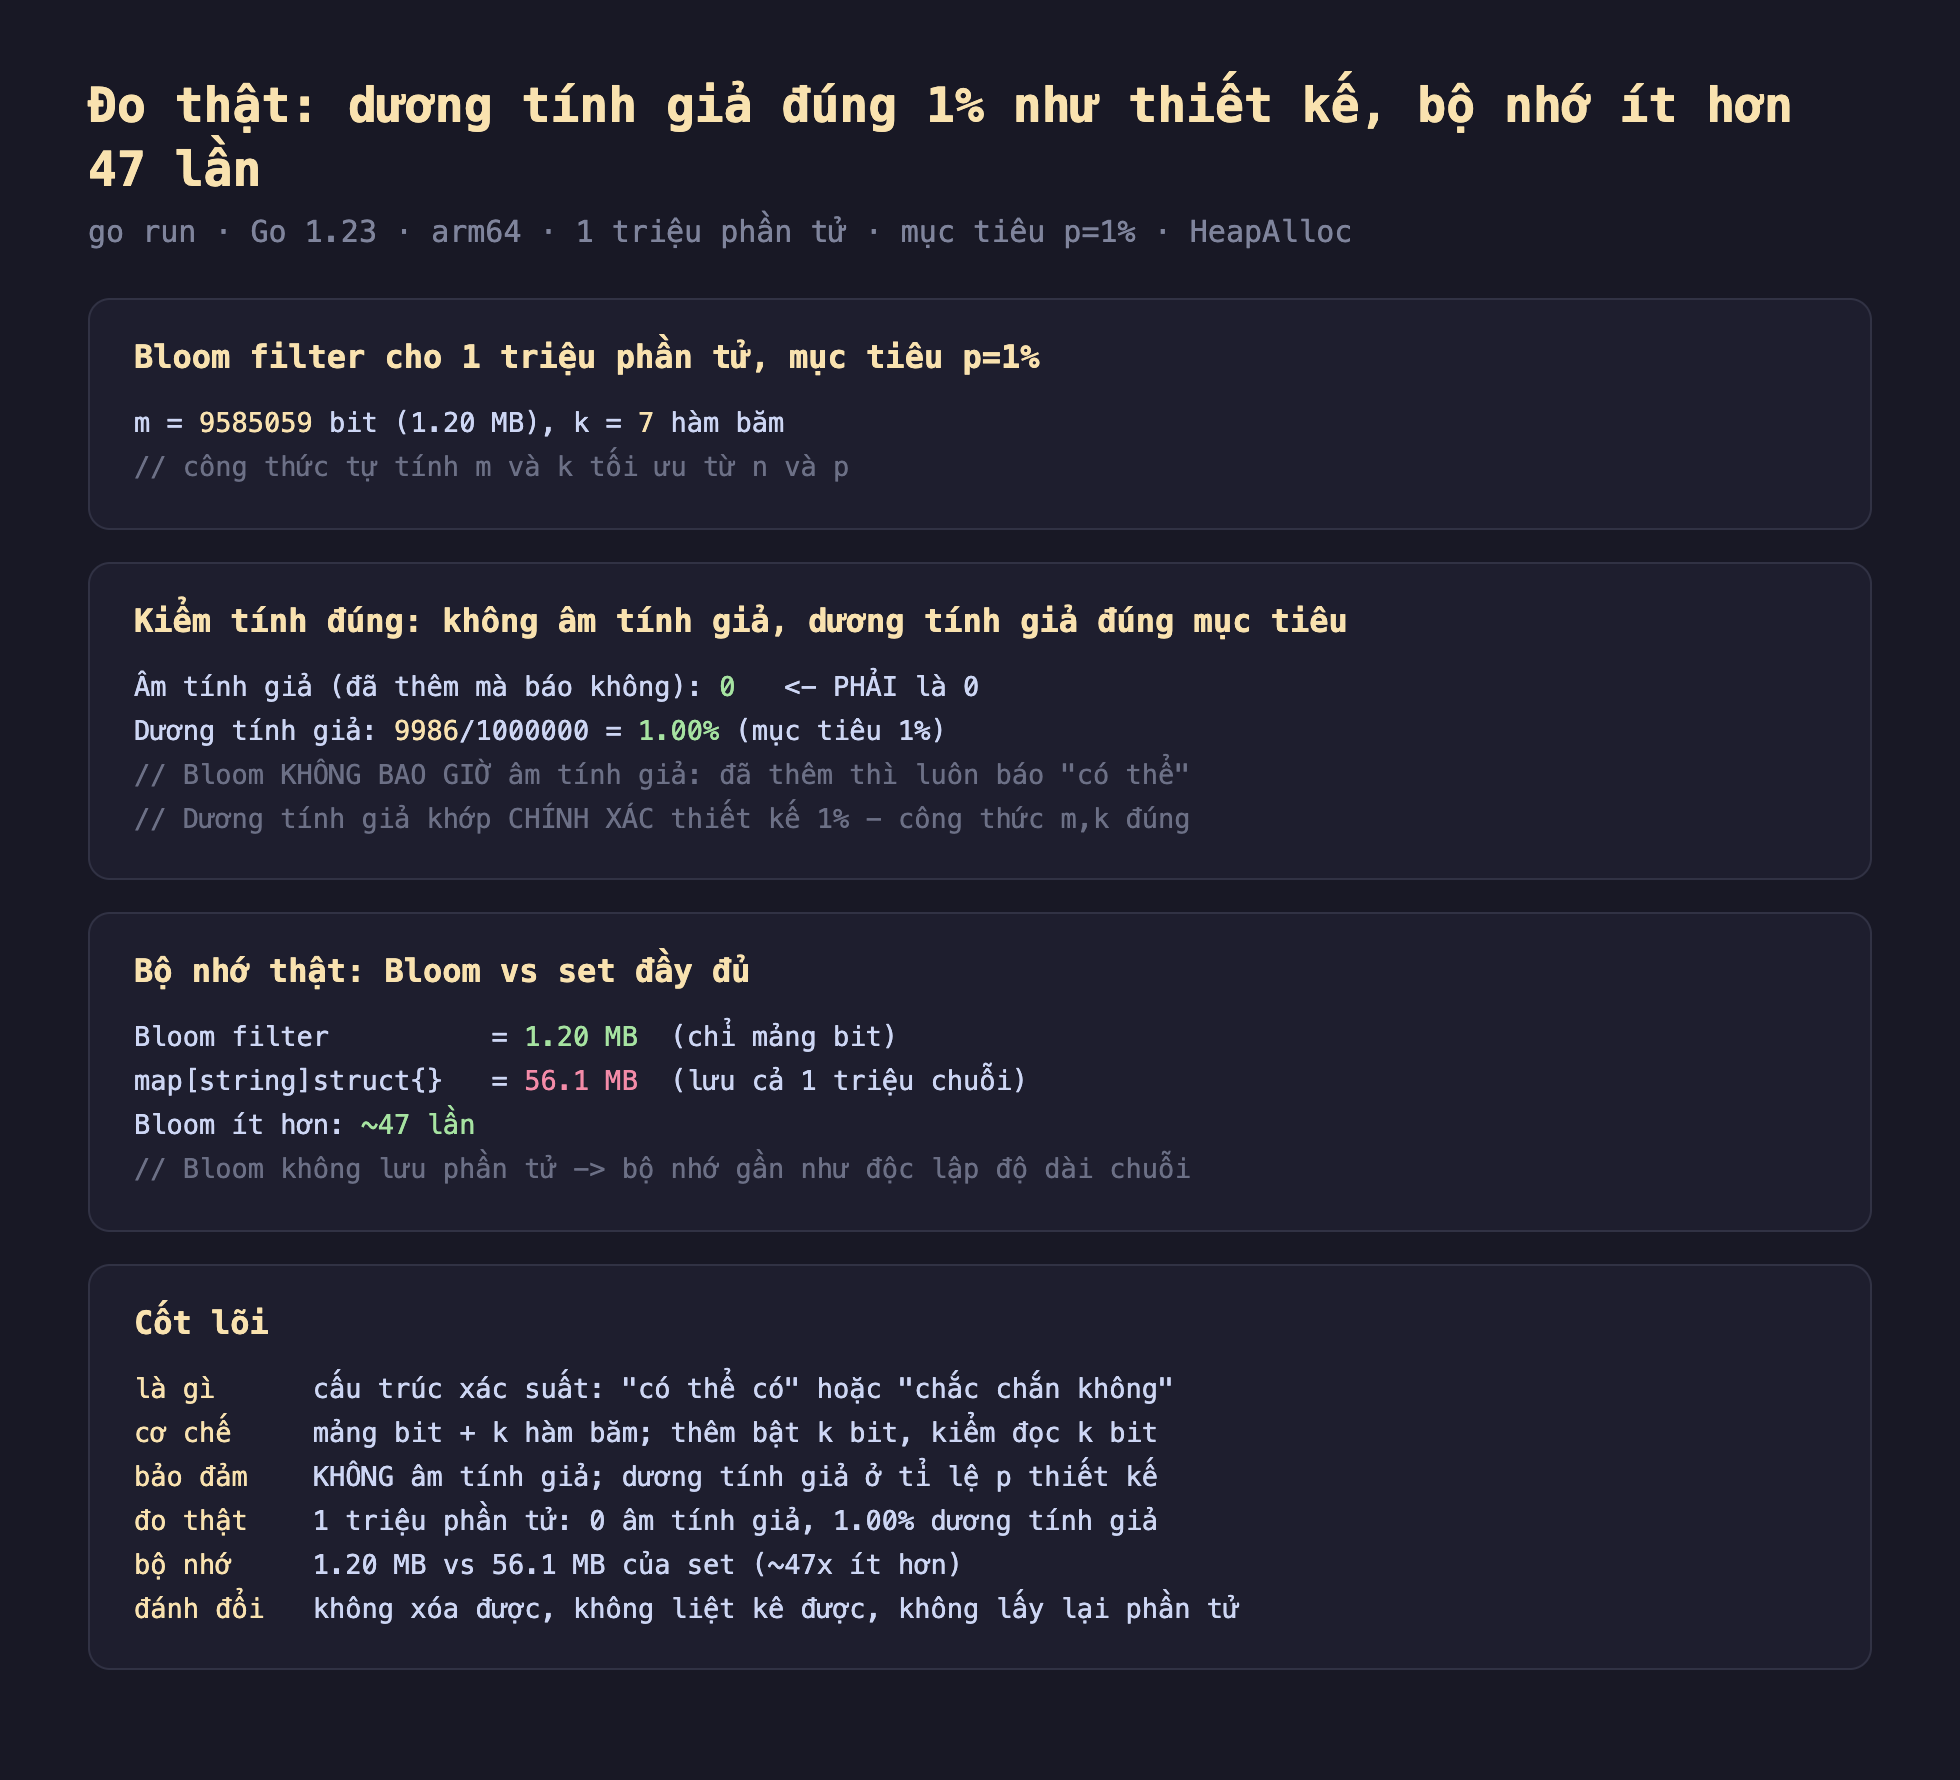
Hình 2: Đo thật Bloom filter cho 1 triệu phần tử — m=9585059 bit (1.20 MB), k=7; 0 âm tính giả, dương tính giả đúng 1.00% như mục tiêu thiết kế; bộ nhớ 1.20 MB so với 56.1 MB của map[string]struct{} (~47 lần ít hơn).
Đánh đổi cần cân nhắc
Dương tính giả là bản chất, phải chấp nhận được. Bloom filter chỉ hữu ích khi ứng dụng của bạn chịu được một tỉ lệ dương tính giả nhỏ. Mẫu dùng kinh điển: dùng Bloom làm lớp lọc trước rẻ tiền. Ví dụ "URL này đã crawl chưa?" — nếu Bloom nói "chắc chắn không", bỏ qua kiểm tra đắt tiền (query DB); nếu nói "có thể có", mới đi kiểm tra thật. Dương tính giả chỉ khiến bạn kiểm tra thừa vài lần, không cho kết quả sai cuối cùng. Nếu một câu trả lời sai là không thể chấp nhận, đừng dùng Bloom.
Không xóa được, không liệt kê được, không lấy lại phần tử. Vì nhiều phần tử chia sẻ bit, bạn không thể "tắt" bit để xóa một phần tử (sẽ xóa nhầm phần tử khác). Bạn cũng không liệt kê được các phần tử đã thêm, hay lấy lại giá trị gốc từ filter — nó chỉ trả lời câu hỏi thành viên. Cần xóa thì dùng biến thể Counting Bloom filter (mỗi vị trí là bộ đếm thay vì bit, tốn nhiều bộ nhớ hơn).
Tỉ lệ dương tính giả xấu đi nếu vượt n dự kiến. Công thức m, k tối ưu cho đúng n phần tử. Nếu bạn thêm nhiều hơn n đã tính, các bit bật dày hơn dự kiến và tỉ lệ dương tính giả tăng vọt (có thể tới gần 100% nếu quá tải nặng). Phải ước lượng n sát thực tế khi thiết kế; nếu số phần tử tăng động, cân nhắc Scalable Bloom filter tự mở rộng.
Ba ý mang về
- Bloom filter kiểm thành viên bằng mảng bit + k hàm băm, không lưu phần tử: trả lời "có thể có" hoặc "chắc chắn không" — bảo đảm không bao giờ âm tính giả (đo thật 0), đổi lại có dương tính giả ở tỉ lệ thiết kế.
- Công thức chọn m, k cho tỉ lệ dương tính giả chính xác: đo thật 1 triệu phần tử với mục tiêu 1% cho ra đúng 1.00% dương tính giả — bằng chứng công thức đúng; double hashing sinh k vị trí từ hai hàm băm cho hiệu quả cao.
- Tiết kiệm bộ nhớ đột phá, kèm giới hạn rõ: đo thật 1.20 MB so với 56.1 MB của set (~47 lần ít hơn) và gần như độc lập độ dài phần tử — nhưng không xóa/liệt kê được, dương tính giả phải chấp nhận được, và tỉ lệ xấu đi nếu vượt n dự kiến.
Phần sau ta tự cài một cấu trúc cache kinh điển: LRU cache trong Go — kết hợp map và danh sách liên kết đôi để get/put O(1) và loại phần tử ít dùng nhất, đo thật hiệu năng và hành vi loại bỏ.
