Bài trước về streaming JSON, ta thấy os.ReadFile nạp toàn bộ tệp vào bộ nhớ. Với tệp 200 MB, đó là 200 MB nằm trong heap Go — và bộ thu gom rác (GC) phải quản lý khối đó, quét qua nó mỗi chu kỳ. Có một cách đọc tệp lớn hoàn toàn khác, ở tầng hệ điều hành: memory-mapped file (mmap).
Thay vì sao chép nội dung tệp vào heap, mmap ánh xạ tệp thẳng vào không gian địa chỉ của tiến trình. Nó trả về một slice byte trỏ vào vùng nhớ ảo; khi bạn chạm tới một vị trí, hệ điều hành nạp trang (mỗi trang 4KB) chứa nó theo nhu cầu — không sao chép trước, không chiếm heap Go. Bài này dựng mmap thật trong Go, đo khác biệt bộ nhớ và tốc độ so với đọc thường, và nêu rõ những rủi ro của nó.
mmap khác đọc thường thế nào
// os.ReadFile: sao chép TOÀN BỘ nội dung tệp vào heap Go.
// mmap: ánh xạ tệp thẳng vào KHÔNG GIAN ĐỊA CHỈ tiến trình.
// Trả về một slice byte trỏ vào vùng nhớ ảo; HĐH nạp TRANG
// (4KB) theo NHU CẦU khi bạn chạm tới - không copy trước, không heap.
Khác biệt cốt lõi: ReadFile là một hành động sao chép (từ tệp vào RAM của heap), còn mmap là một hành động ánh xạ (cho tệp và bộ nhớ ảo dùng chung page cache của hệ điều hành). Bạn không copy gì cả — bạn nhìn thẳng vào cache của HĐH.
Ánh xạ tệp bằng unix.Mmap
f, _ := os.Open(path)
data, _ := unix.Mmap(int(f.Fd()), 0, int(size),
	unix.PROT_READ, unix.MAP_SHARED) // chỉ đọc, chia sẻ
defer unix.Munmap(data) // gỡ ánh xạ khi xong
unix.Mmap (trong golang.org/x/sys/unix) nhận file descriptor, offset, độ dài, cờ bảo vệ (PROT_READ = chỉ đọc) và cờ chia sẻ. Nó trả về một []byte mà mỗi phần tử ứng với một byte trong tệp. Munmap gỡ ánh xạ — phải nhớ gọi, vì đây là tài nguyên hệ điều hành, không phải bộ nhớ Go mà GC tự dọn.
Đọc: truy cập slice như bình thường
for i := 0; i < N; i++ {
	v := uint32(data[i*4]) | uint32(data[i*4+1])<<8 |
	     uint32(data[i*4+2])<<16 | uint32(data[i*4+3])<<24
	tong += uint64(v)
}
Từ góc nhìn code Go, data chỉ là một slice byte bình thường. Nhưng bên dưới, lần đầu bạn chạm data[k], nếu trang chứa nó chưa trong RAM, CPU sinh một page fault và HĐH nạp đúng trang đó vào page cache. Bạn không bao giờ nạp phần tệp mình không đọc tới — đây là tính lười (lazy) mạnh mẽ của mmap.
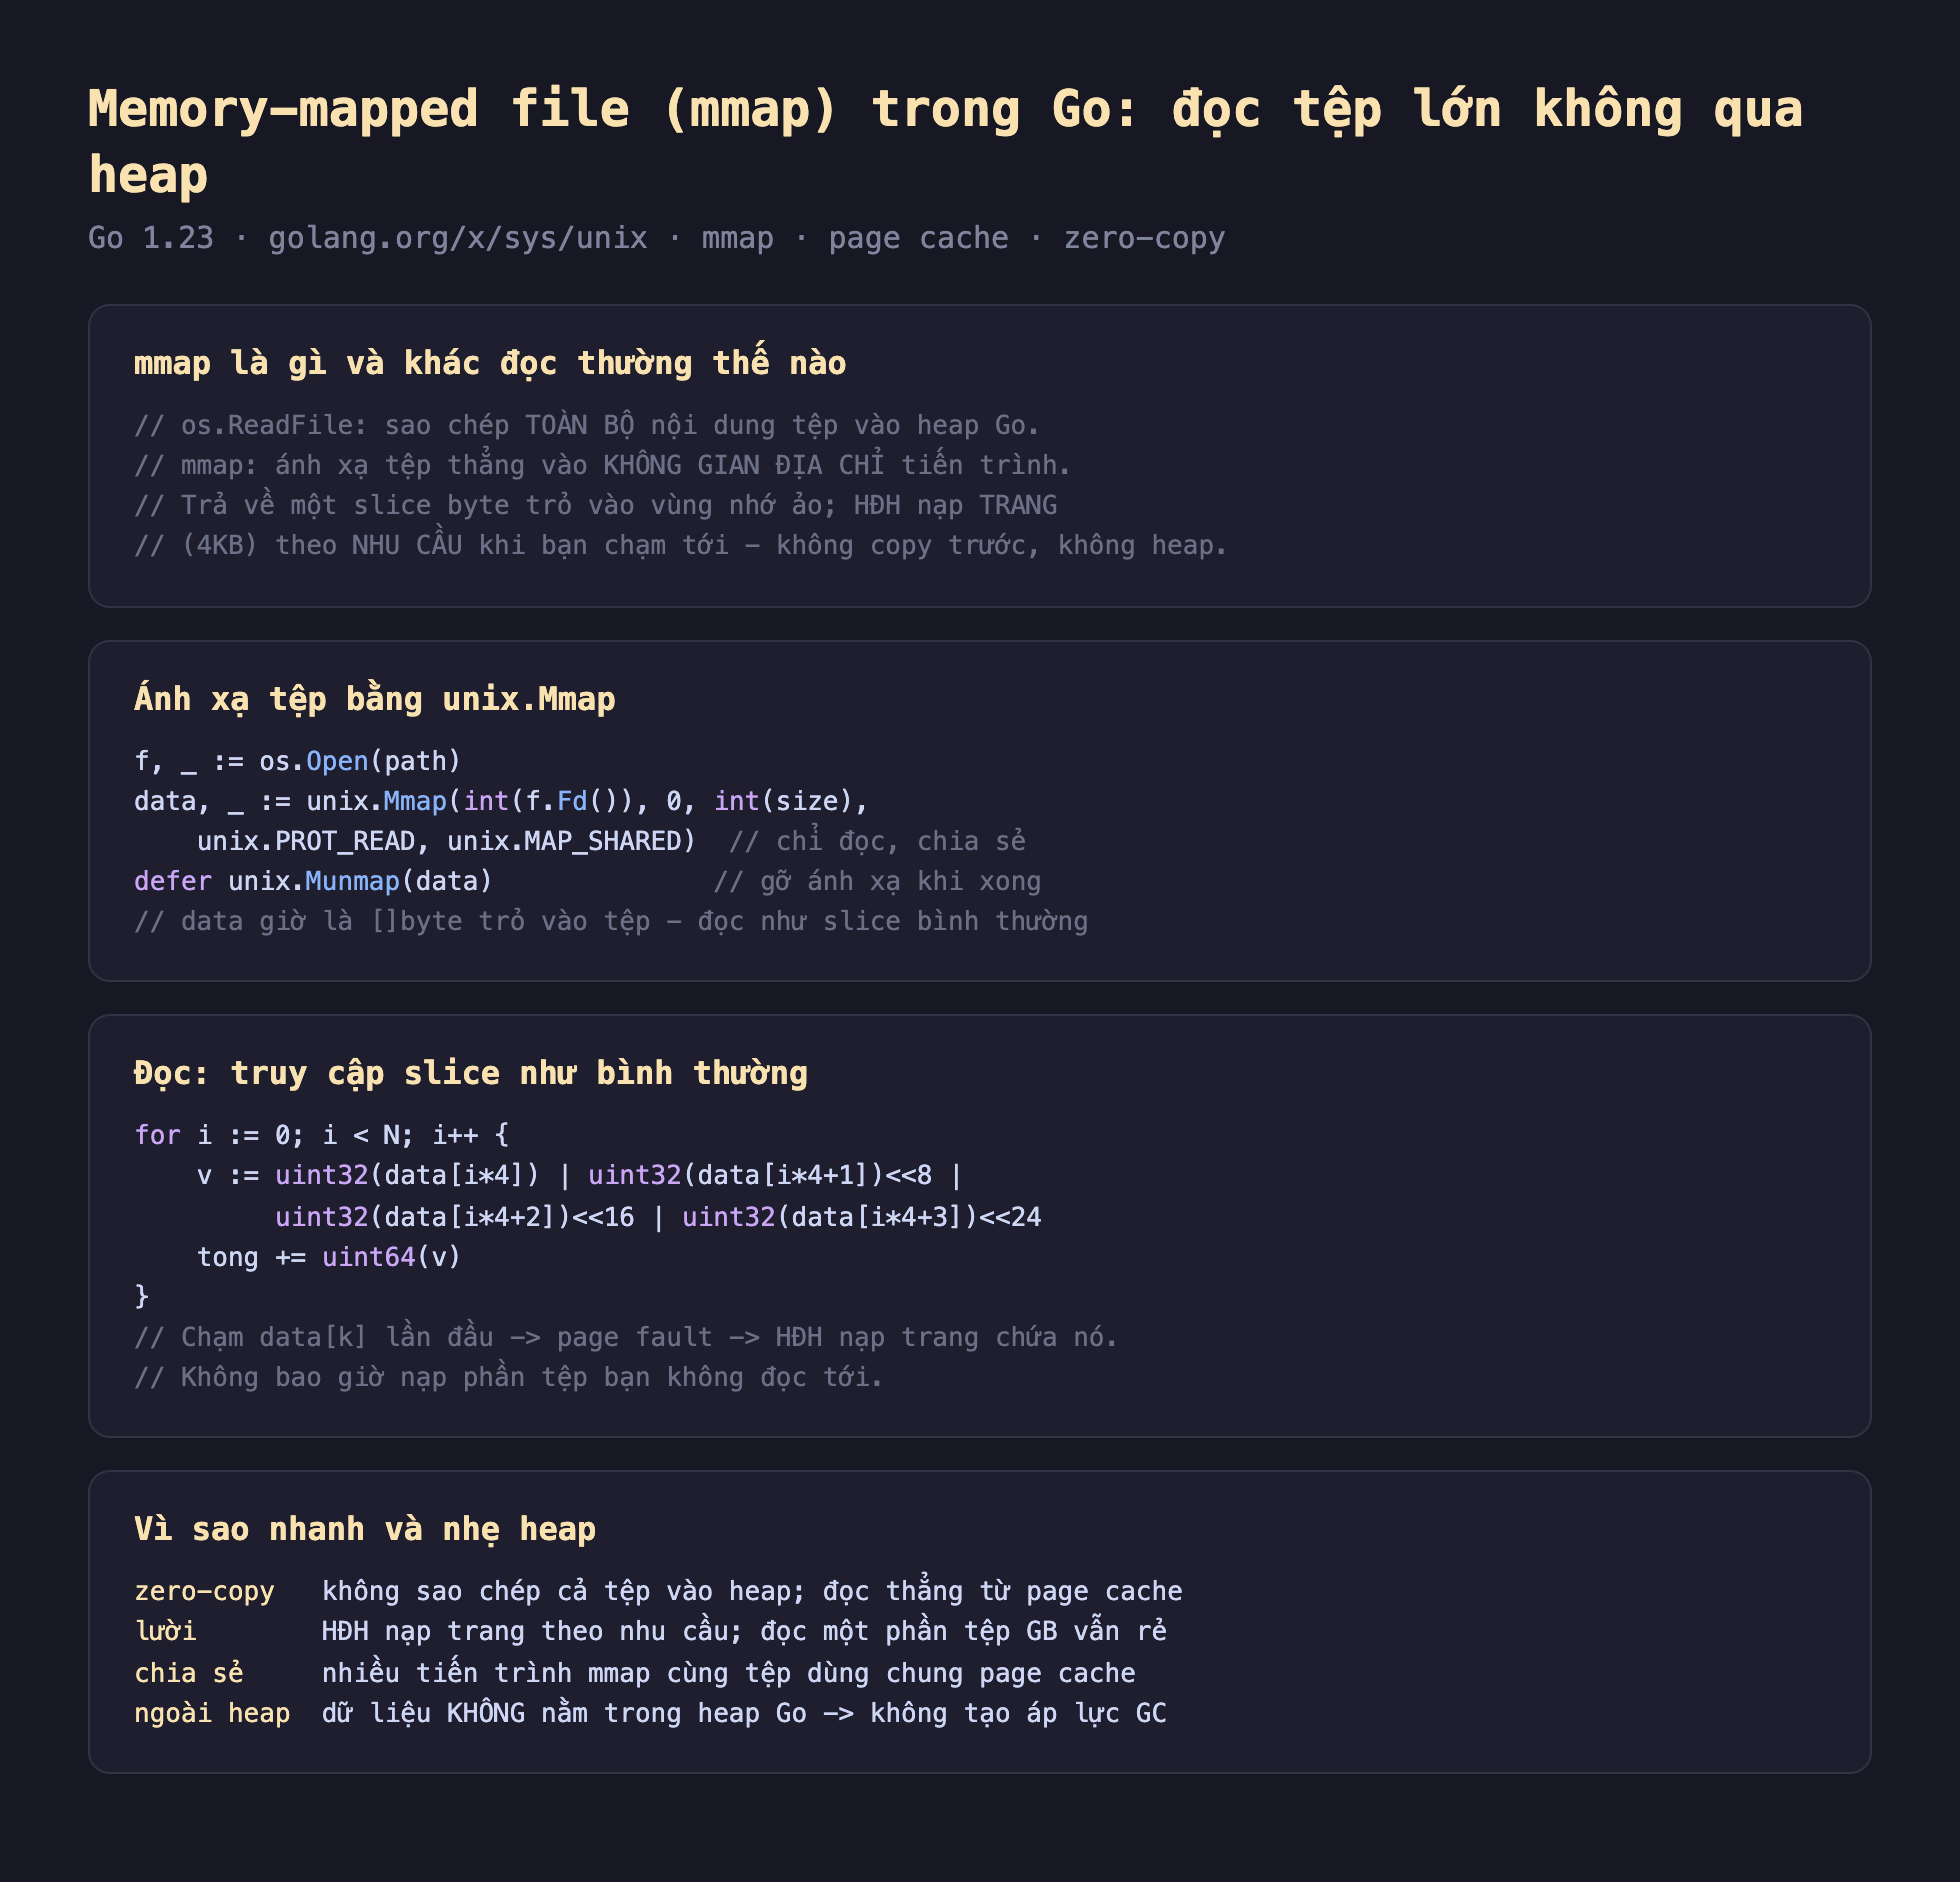
Hình 1: mmap ánh xạ tệp vào không gian địa chỉ (không sao chép vào heap); đọc như slice byte bình thường nhưng HĐH nạp trang 4KB theo nhu cầu qua page fault — zero-copy, lười, ngoài heap Go.
Đo thật: 200 MB, +191 MB hay +0 MB heap
Tạo tệp nhị phân 200 MB (50 triệu uint32), đọc và tổng tất cả hai cách, đo HeapAlloc tăng thêm và thời gian:
Cách         heap tăng thêm  thời gian đọc  kết quả
os.ReadFile  +191 MB         125 ms         1249999975000000
mmap         +0 MB           31 ms          1249999975000000

Hai cách CÙNG kết quả: đúng
mmap: heap ít hơn 191 MB, nhanh hơn ~4 lần
Khác biệt rất lớn trên cả hai trục:
- Heap: +191 MB so với +0 MB.
os.ReadFilesao chép cả 200 MB tệp vào heap Go, nên heap phình +191 MB — và toàn bộ khối đó giờ là gánh nặng cho GC. mmap để dữ liệu nằm trong page cache của HĐH ngoài heap Go, nên heap Go gần như không đổi. Với tệp 200 MB hay 20 GB, heap Go vẫn gần 0 — HĐH lo phần nạp trang. - Tốc độ: 125 ms so với 31 ms (~4 lần). mmap nhanh hơn vì nó tránh bước sao chép cả tệp từ page cache sang heap; nó đọc thẳng từ page cache. (Cả hai cho cùng kết quả 1.249.999.975.000.000, nên đây là so sánh công bằng.)
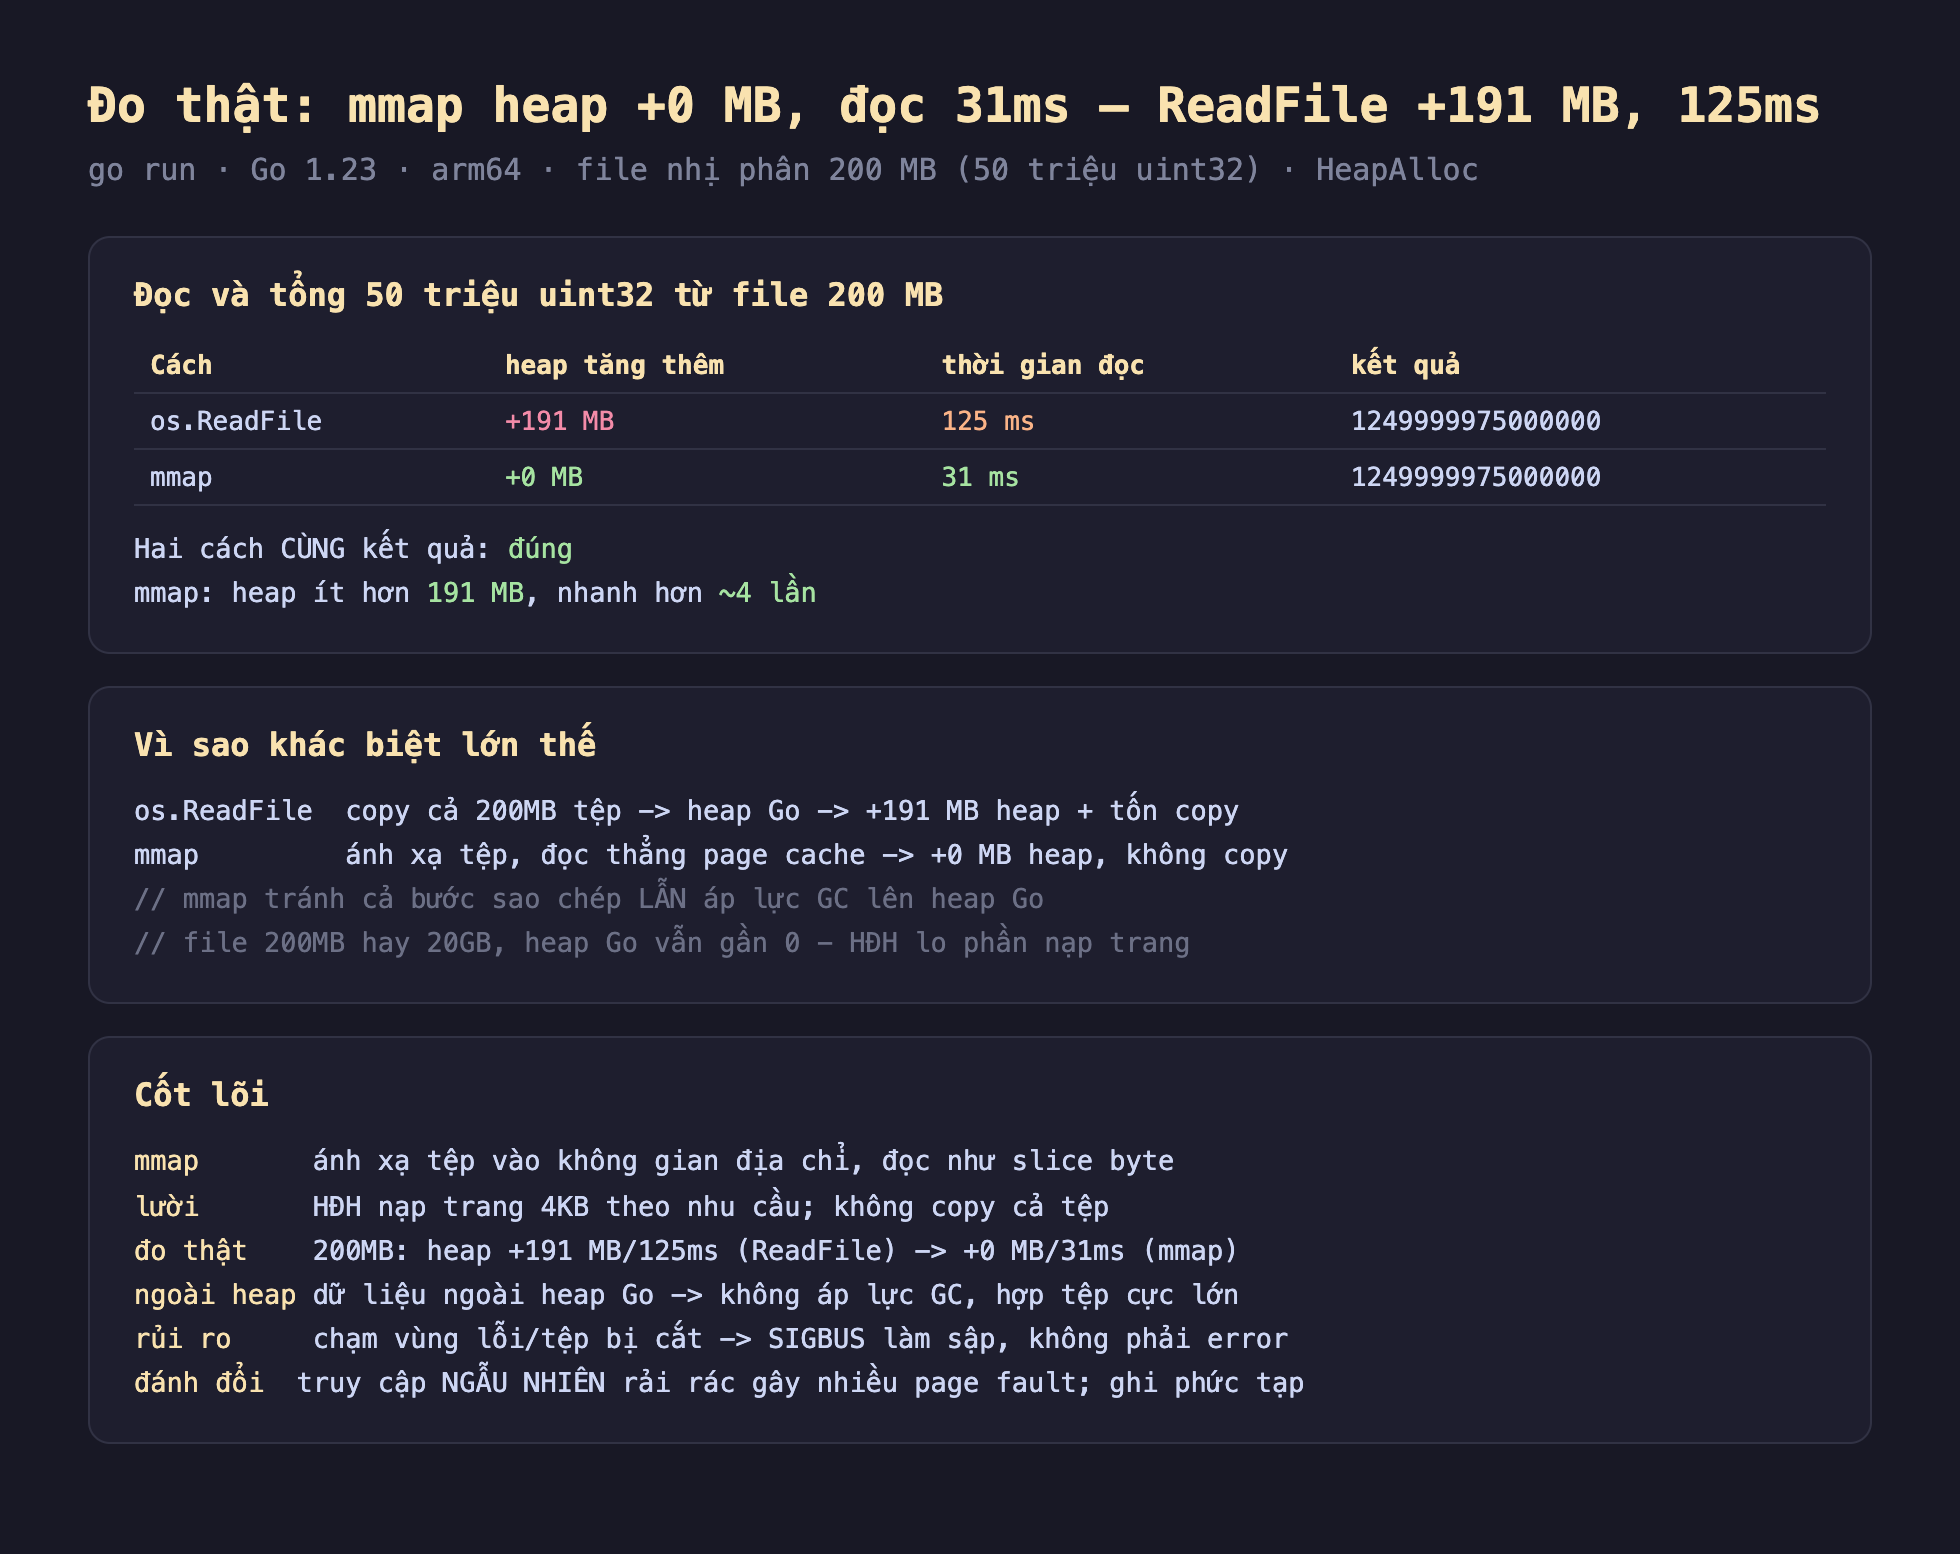
Hình 2: Đo thật đọc tệp 200 MB (50 triệu uint32) — os.ReadFile tốn +191 MB heap và 125ms, mmap chỉ +0 MB heap và 31ms (~4 lần nhanh hơn), cùng kết quả; mmap tránh cả sao chép lẫn áp lực GC vì dữ liệu nằm ngoài heap Go.
Đánh đổi cần cân nhắc
Chạm vùng lỗi gây SIGBUS làm sập, không phải error. Đây là rủi ro nguy hiểm nhất của mmap. Nếu tệp bị cắt ngắn (truncate) sau khi bạn ánh xạ, hoặc một trang không đọc được từ đĩa, việc chạm vào vùng đó sinh tín hiệu SIGBUS — làm sập chương trình, không trả về một error Go mà bạn có thể xử lý. Đọc thường thì lỗi I/O trả về error đàng hoàng. Với mmap, bạn phải chắc tệp không đổi trong lúc ánh xạ, hoặc chấp nhận rủi ro sập.
Truy cập ngẫu nhiên rải rác gây nhiều page fault. mmap tỏa sáng khi bạn đọc tuần tự hoặc đọc một phần tệp lớn. Nhưng nếu bạn nhảy loạn xạ khắp một tệp khổng lồ, mỗi lần chạm một trang mới là một page fault — và nếu tổng dữ liệu chạm tới vượt RAM vật lý, HĐH phải liên tục nạp/đẩy trang (thrashing), có thể chậm hơn cả đọc thường. mmap không phải phép màu; nó dịch chuyển việc quản lý bộ nhớ sang HĐH, và mẫu truy cập của bạn quyết định nó thắng hay thua.
Ghi qua mmap phức tạp và ít khả chuyển. Bài này chỉ đọc (PROT_READ). Ghi qua mmap (PROT_WRITE, MAP_SHARED) thêm nhiều tinh tế: khi nào dữ liệu thực sự xuống đĩa (msync), đồng bộ với các tiến trình khác, và hành vi khác nhau giữa các HĐH. Và mmap là API Unix — trên Windows phải dùng CreateFileMapping/MapViewOfFile khác hẳn, nên code mmap không tự nhiên khả chuyển (cross-platform); thường phải dùng thư viện bọc như golang.org/x/exp/mmap hoặc build-tag theo OS.
Ba ý mang về
- mmap ánh xạ tệp vào không gian địa chỉ thay vì sao chép vào heap: đọc như slice byte bình thường nhưng HĐH nạp trang theo nhu cầu — đo thật, đọc tệp 200 MB tốn +191 MB heap với
os.ReadFilenhưng +0 MB với mmap, và nhanh hơn ~4 lần (125ms → 31ms), cùng kết quả. - Lợi ích cốt lõi là zero-copy và ngoài heap Go: dữ liệu nằm trong page cache của HĐH, không tạo áp lực GC — hợp cho tệp cực lớn và đọc một phần (tệp 200MB hay 20GB heap Go vẫn gần 0).
- Rủi ro thật sự phải cân nhắc: chạm vùng lỗi/tệp bị cắt gây
SIGBUSlàm sập chứ không trả error, truy cập ngẫu nhiên rải rác gây nhiều page fault (có thể thrashing khi vượt RAM), và ghi qua mmap phức tạp lẫn ít khả chuyển — mmap không phải mặc định, chỉ dùng khi mẫu truy cập hợp.
Bài tập làm thử
Bài 1 (đọc hiểu). Giải thích khác biệt cốt lõi giữa os.ReadFile và mmap theo đúng cách bài mô tả — một bên là "sao chép", một bên là gì?
Đáp án
os.ReadFile là một hành động sao chép: nội dung tệp được copy từ đĩa/page cache vào heap Go. mmap là một hành động ánh xạ: tệp và bộ nhớ ảo của tiến trình dùng chung page cache của hệ điều hành — không có bước sao chép nào, bạn "nhìn thẳng vào cache của HĐH" thông qua một slice byte trỏ vào vùng nhớ ảo, và trang được nạp theo nhu cầu (lazy) khi chạm tới.
Bài 2 (sửa lỗi/nhận diện lỗi). Đoạn mã sau ánh xạ một tệp rồi đọc dữ liệu, nhưng thiếu một bước quan trọng khiến tài nguyên hệ điều hành bị rò rỉ. Chỉ ra thiếu gì và sửa lại.
f, _ := os.Open(path)
data, _ := unix.Mmap(int(f.Fd()), 0, int(size), unix.PROT_READ, unix.MAP_SHARED)
for i := 0; i < len(data); i += 4 {
	// xử lý data...
}
Đáp án
Thiếu gọi unix.Munmap(data) để gỡ ánh xạ. Bài nhấn mạnh: "phải nhớ gọi, vì đây là tài nguyên hệ điều hành, không phải bộ nhớ Go mà GC tự dọn" — không giống như slice Go bình thường, vùng nhớ ánh xạ mmap không được bộ thu gom rác tự động giải phóng. Sửa lại bằng cách thêm defer unix.Munmap(data) ngay sau khi ánh xạ thành công:
f, _ := os.Open(path)
data, _ := unix.Mmap(int(f.Fd()), 0, int(size), unix.PROT_READ, unix.MAP_SHARED)
defer unix.Munmap(data)
for i := 0; i < len(data); i += 4 {
	// xử lý data...
}
Bài 3 (vận dụng thực tế). Bạn cần đọc và tính tổng toàn bộ nội dung một tệp log nhị phân 50GB trên một máy chỉ có 8GB RAM, đọc tuần tự từ đầu đến cuối một lần. Dựa vào số đo và nguyên lý trong bài, mmap có giúp ích ở đây không, và vì sao?
Đáp án
Có, mmap rất phù hợp ở đây vì hai lý do trong bài: (1) mmap tỏa sáng khi "đọc tuần tự hoặc đọc một phần tệp lớn" — đúng kịch bản này; (2) dữ liệu nằm trong page cache của HĐH, ngoài heap Go, nên "tệp 200MB hay 20GB heap Go vẫn gần 0" — với tệp 50GB trên máy 8GB RAM, os.ReadFile chắc chắn sẽ thất bại (không đủ RAM để chứa cả tệp), trong khi mmap để HĐH tự nạp/đẩy trang theo nhu cầu, không đòi hỏi toàn bộ tệp phải nằm trong RAM cùng lúc.
Bài 4 (bẫy/đánh đổi). Một dịch vụ dùng mmap để đọc một tệp cấu hình, nhưng một tiến trình khác vô tình truncate (cắt ngắn) tệp đó ngay sau khi dịch vụ đã ánh xạ xong. Điều gì sẽ xảy ra khi dịch vụ chạm tới vùng dữ liệu đã bị cắt, và tại sao đây là rủi ro nghiêm trọng hơn so với đọc tệp thông thường?
Đáp án
Chương trình sẽ nhận tín hiệu SIGBUS và sập ngay lập tức — bài nói rõ đây là "rủi ro nguy hiểm nhất của mmap": nếu tệp bị cắt ngắn sau khi ánh xạ, việc chạm vào vùng đã mất sẽ sinh SIGBUS, "không trả về một error Go mà bạn có thể xử lý". Điều này nghiêm trọng hơn đọc thường vì với os.ReadFile/đọc tệp thông thường, lỗi I/O trả về một giá trị error có thể recover/xử lý bình thường trong luồng chương trình Go — còn SIGBUS làm sập cả tiến trình, không có cơ chế try-catch nào trong Go bắt được theo cách an toàn và đáng tin cậy.
Bài 5 (đọc hiểu số liệu). Từ số đo os.ReadFile: +191 MB heap, 125ms và mmap: +0 MB heap, 31ms cho tệp 200MB, hãy giải thích tại sao mmap không chỉ tiết kiệm bộ nhớ mà còn nhanh hơn, dựa trên cơ chế "zero-copy" nêu trong bài.
Đáp án
mmap nhanh hơn (~4 lần) vì nó "tránh bước sao chép cả tệp từ page cache sang heap; nó đọc thẳng từ page cache" — trong khi os.ReadFile phải thực hiện việc copy toàn bộ 200MB dữ liệu từ page cache của HĐH vào heap Go trước khi chương trình có thể đọc, tốn cả thời gian CPU cho việc sao chép lẫn không gian bộ nhớ cho bản sao đó. mmap bỏ qua hoàn toàn bước sao chép này — chương trình đọc trực tiếp từ page cache thông qua ánh xạ địa chỉ, nên vừa nhanh hơn (không tốn thời gian copy) vừa không tốn heap Go (không có bản sao nào được tạo ra).
Phần sau ta tự cài một cấu trúc dữ liệu xác suất tiết kiệm bộ nhớ đáng kinh ngạc: Bloom filter trong Go — kiểm "phần tử có thể có trong tập" bằng vài bit, đo thật tỉ lệ dương tính giả và bộ nhớ so với set thường.
