JSON tiện đến mức nó trở thành mặc định cho mọi thứ — kể cả nơi nó không nên là mặc định. JSON là định dạng văn bản, tự mô tả: mỗi bản ghi lặp lại tên field ("id":, "ten":...), số được viết thành chuỗi ASCII (99999 là 5 byte thay vì 4 byte nhị phân), và khi đọc, máy phải phân tích cú pháp từng ký tự. Với API công khai hay cấu hình cho người đọc, đó là đánh đổi đúng. Nhưng với dữ liệu nội bộ nóng — hàng triệu bản ghi truyền giữa các dịch vụ của chính bạn, cache, hàng đợi — JSON tốn cả kích thước lẫn CPU một cách không cần thiết.
Một encoding nhị phân tùy biến giải quyết cả hai: bạn tự thiết kế bố cục byte, ghi số ở dạng nhị phân, và đọc lại theo offset cố định — không phân tích cú pháp, không reflection. Bài này dựng một định dạng binary đơn giản trong Go, đo thật khác biệt kích thước và tốc độ so với JSON, và nêu rõ những rủi ro của việc tự viết.
Thiết kế định dạng: cố định + length-prefix
Với mỗi bản ghi, tôi chọn bố cục: [ID:4B][Diem:2B][len(Ten):2B][Ten:N byte]. Số ghi little-endian; chuỗi (độ dài thay đổi) ghi kèm một tiền tố độ dài (length-prefix) để lúc đọc biết đọc bao nhiêu byte.
type Ban struct { ID uint32; Diem uint16; Ten string }
Mấu chốt của mọi định dạng nhị phân: hoặc trường có kích thước cố định (số), hoặc trường có kích thước thay đổi phải kèm độ dài đứng trước — để bên đọc luôn biết ranh giới mỗi trường.
Mã hóa và giải mã
Mã hóa ghi byte trực tiếp bằng encoding/binary:
binary.LittleEndian.PutUint32(tmp[:4], b.ID)
buf.Write(tmp[:4])                         // 4 byte cho ID
binary.LittleEndian.PutUint16(tmp[:2], b.Diem)
buf.Write(tmp[:2])                         // 2 byte cho Diem
binary.LittleEndian.PutUint16(tmp[:2], uint16(len(b.Ten)))
buf.Write(tmp[:2]); buf.WriteString(b.Ten) // độ dài + chuỗi
Giải mã đọc lại đúng thứ tự byte đó, theo offset:
b.ID = binary.LittleEndian.Uint32(data[i : i+4]); i += 4
b.Diem = binary.LittleEndian.Uint16(data[i : i+2]); i += 2
n := int(binary.LittleEndian.Uint16(data[i : i+2])); i += 2
b.Ten = string(data[i : i+n]); i += n // đọc n byte chuỗi
Không có phân tích cú pháp, không reflection — chỉ đọc byte theo offset đã biết. Đây là lý do nó nhanh.
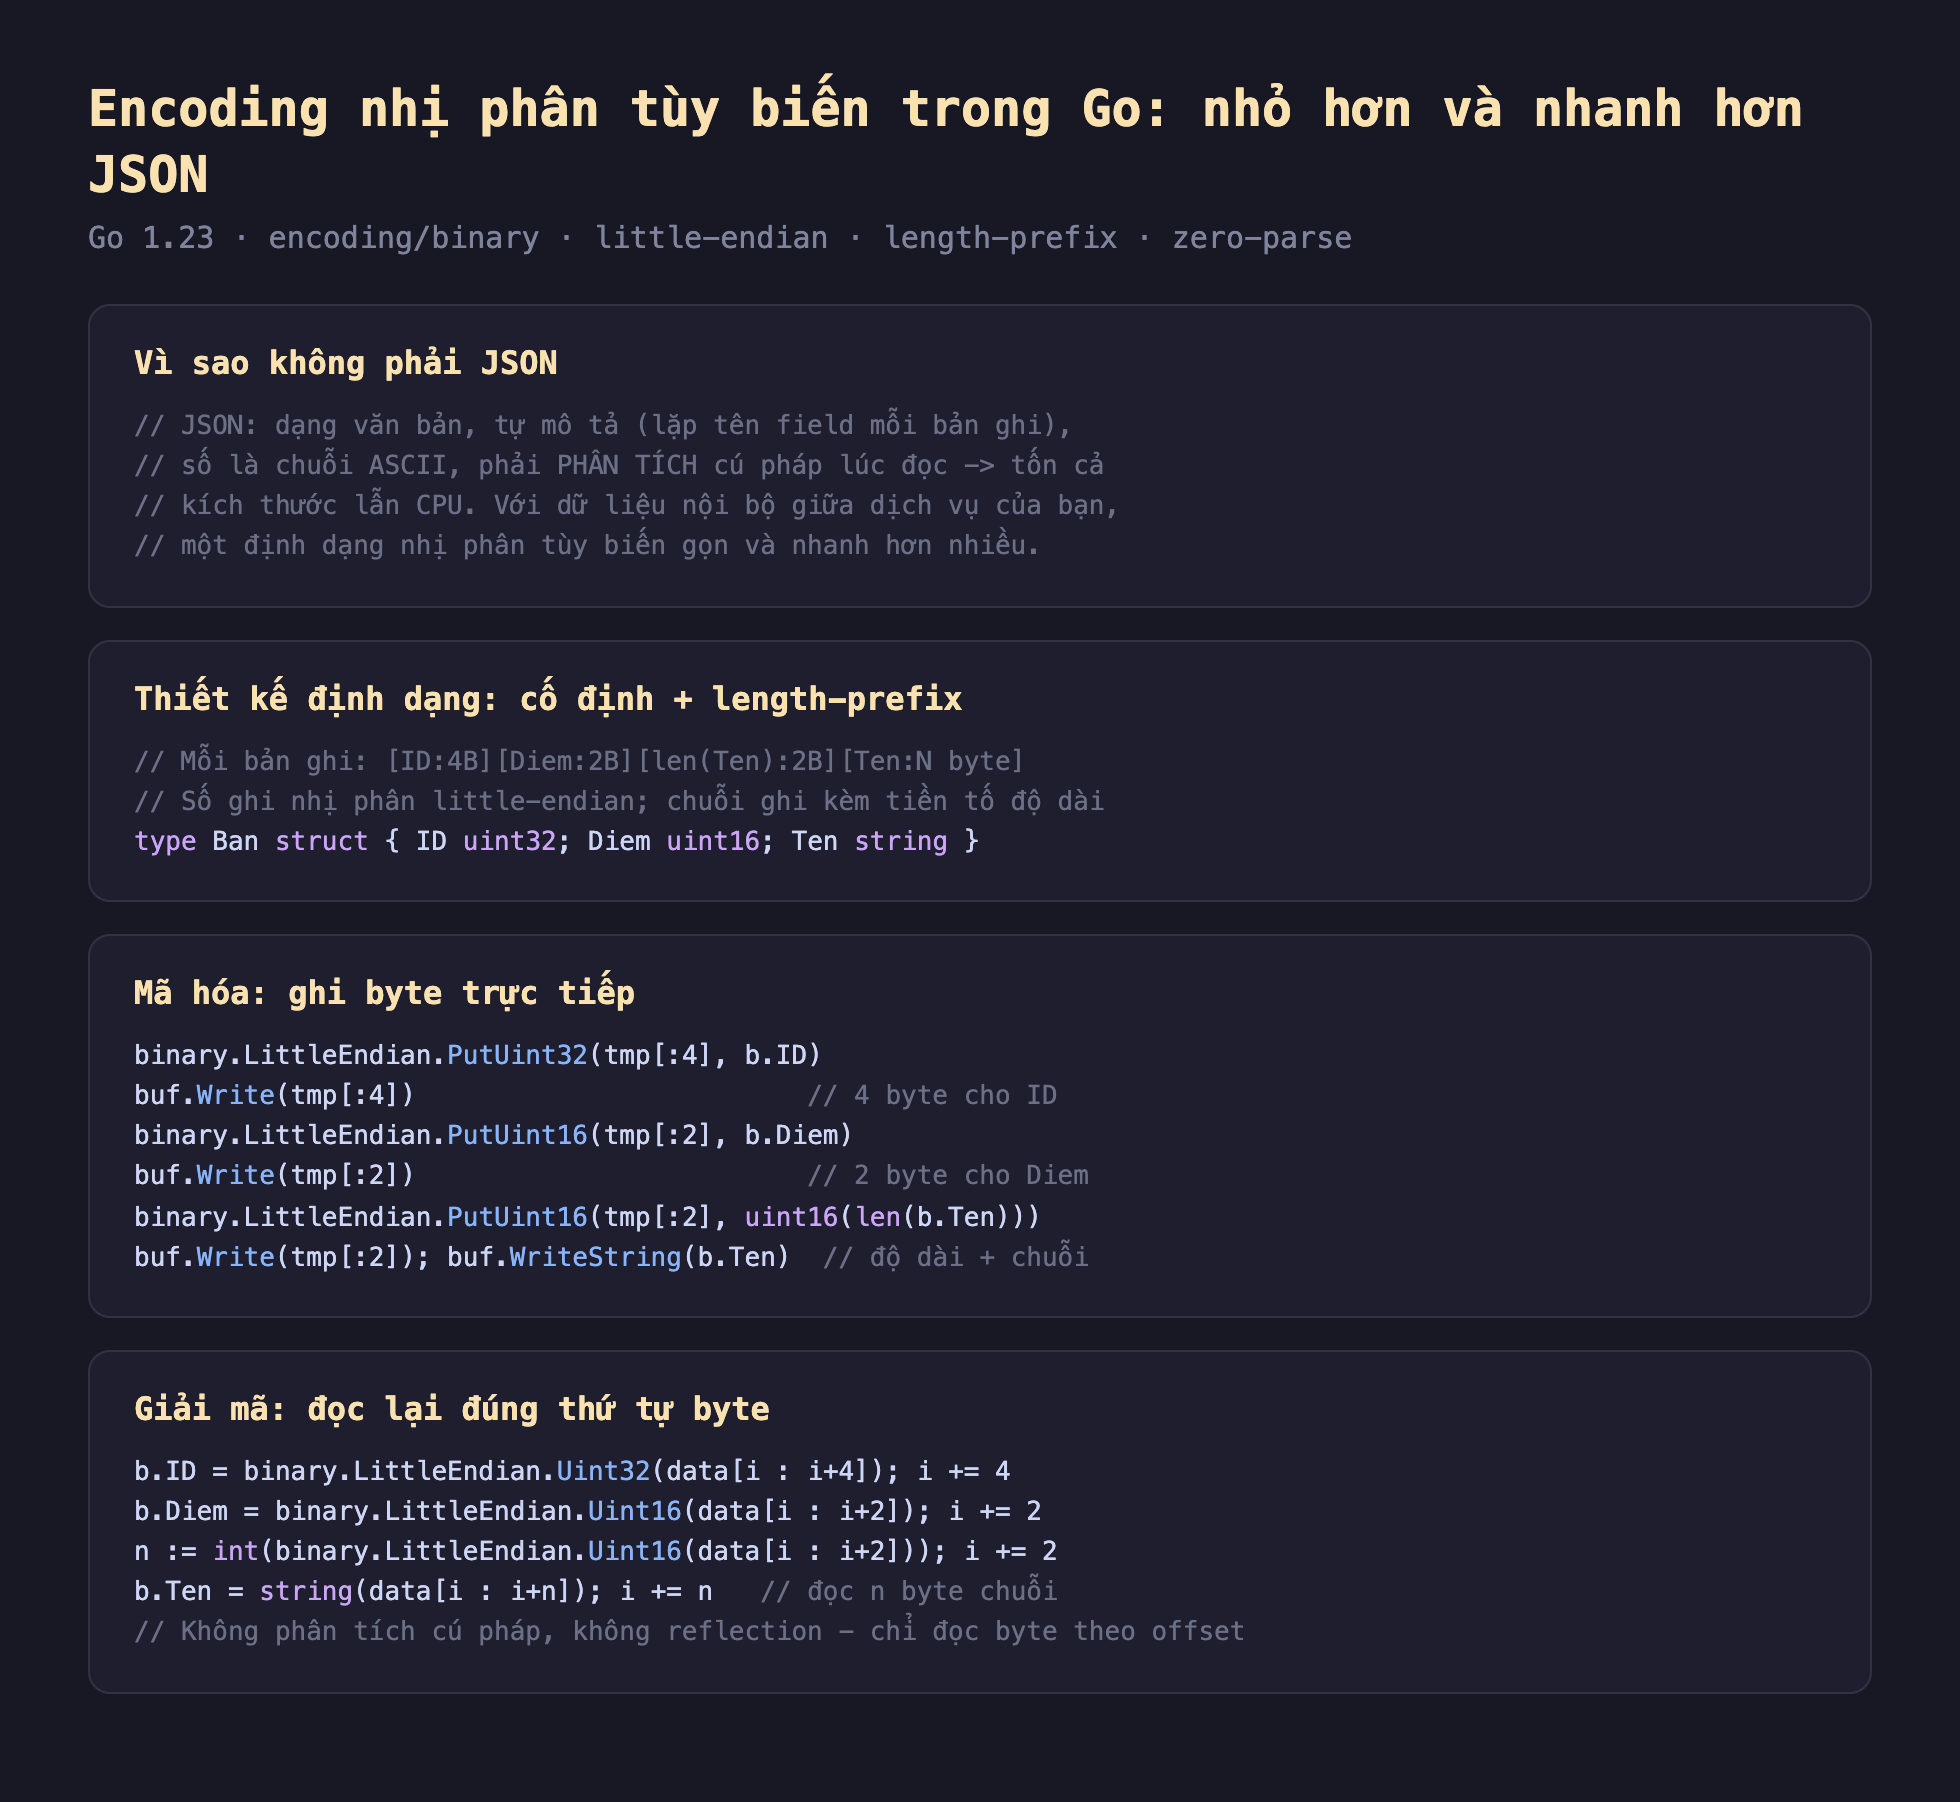
Hình 1: Định dạng nhị phân tùy biến — số little-endian và chuỗi length-prefix; mã hóa ghi byte trực tiếp bằng encoding/binary, giải mã đọc lại theo offset cố định (không phân tích cú pháp, không reflection).
Đo thật: kích thước và tốc độ
Với 100.000 bản ghi, so JSON và binary về kích thước, rồi benchmark mã hóa/giải mã:
Kích thước: JSON = 4.37 MB, Binary = 1.89 MB
Binary nhỏ hơn: 56.7% (2.3x)
Giải mã binary đúng: true (bản cuối ID=99999 Ten=nguoi-99999 Diem=999)

Thao tác          JSON       Binary     Binary nhanh hơn
Mã hóa (encode)   6.008 ms   1.488 ms   ~4x
Giải mã (decode)  31.62 ms   3.421 ms   ~9.2x
Binary thắng trên cả ba trục:
- Kích thước nhỏ hơn 2.3 lần: không lặp tên field cho mỗi bản ghi, và số ghi nhị phân (4 byte cho ID thay vì ~6 ký tự ASCII). Với dữ liệu truyền qua mạng hay lưu trữ nhiều, đây là tiết kiệm băng thông và dung lượng trực tiếp.
- Mã hóa nhanh ~4 lần: ghi byte thẳng, không phải format số thành chuỗi.
- Giải mã nhanh ~9.2 lần: đây là khác biệt lớn nhất. JSON
Unmarshaltốn 100.034 cấp phát (dựng cây token, phân tích từng chuỗi số); binary chỉ đọc byte theo offset. Trong nhiều hệ thống, giải mã xảy ra nhiều hơn mã hóa (ghi một lần, đọc nhiều lần), nên tốc độ decode thường quan trọng nhất.
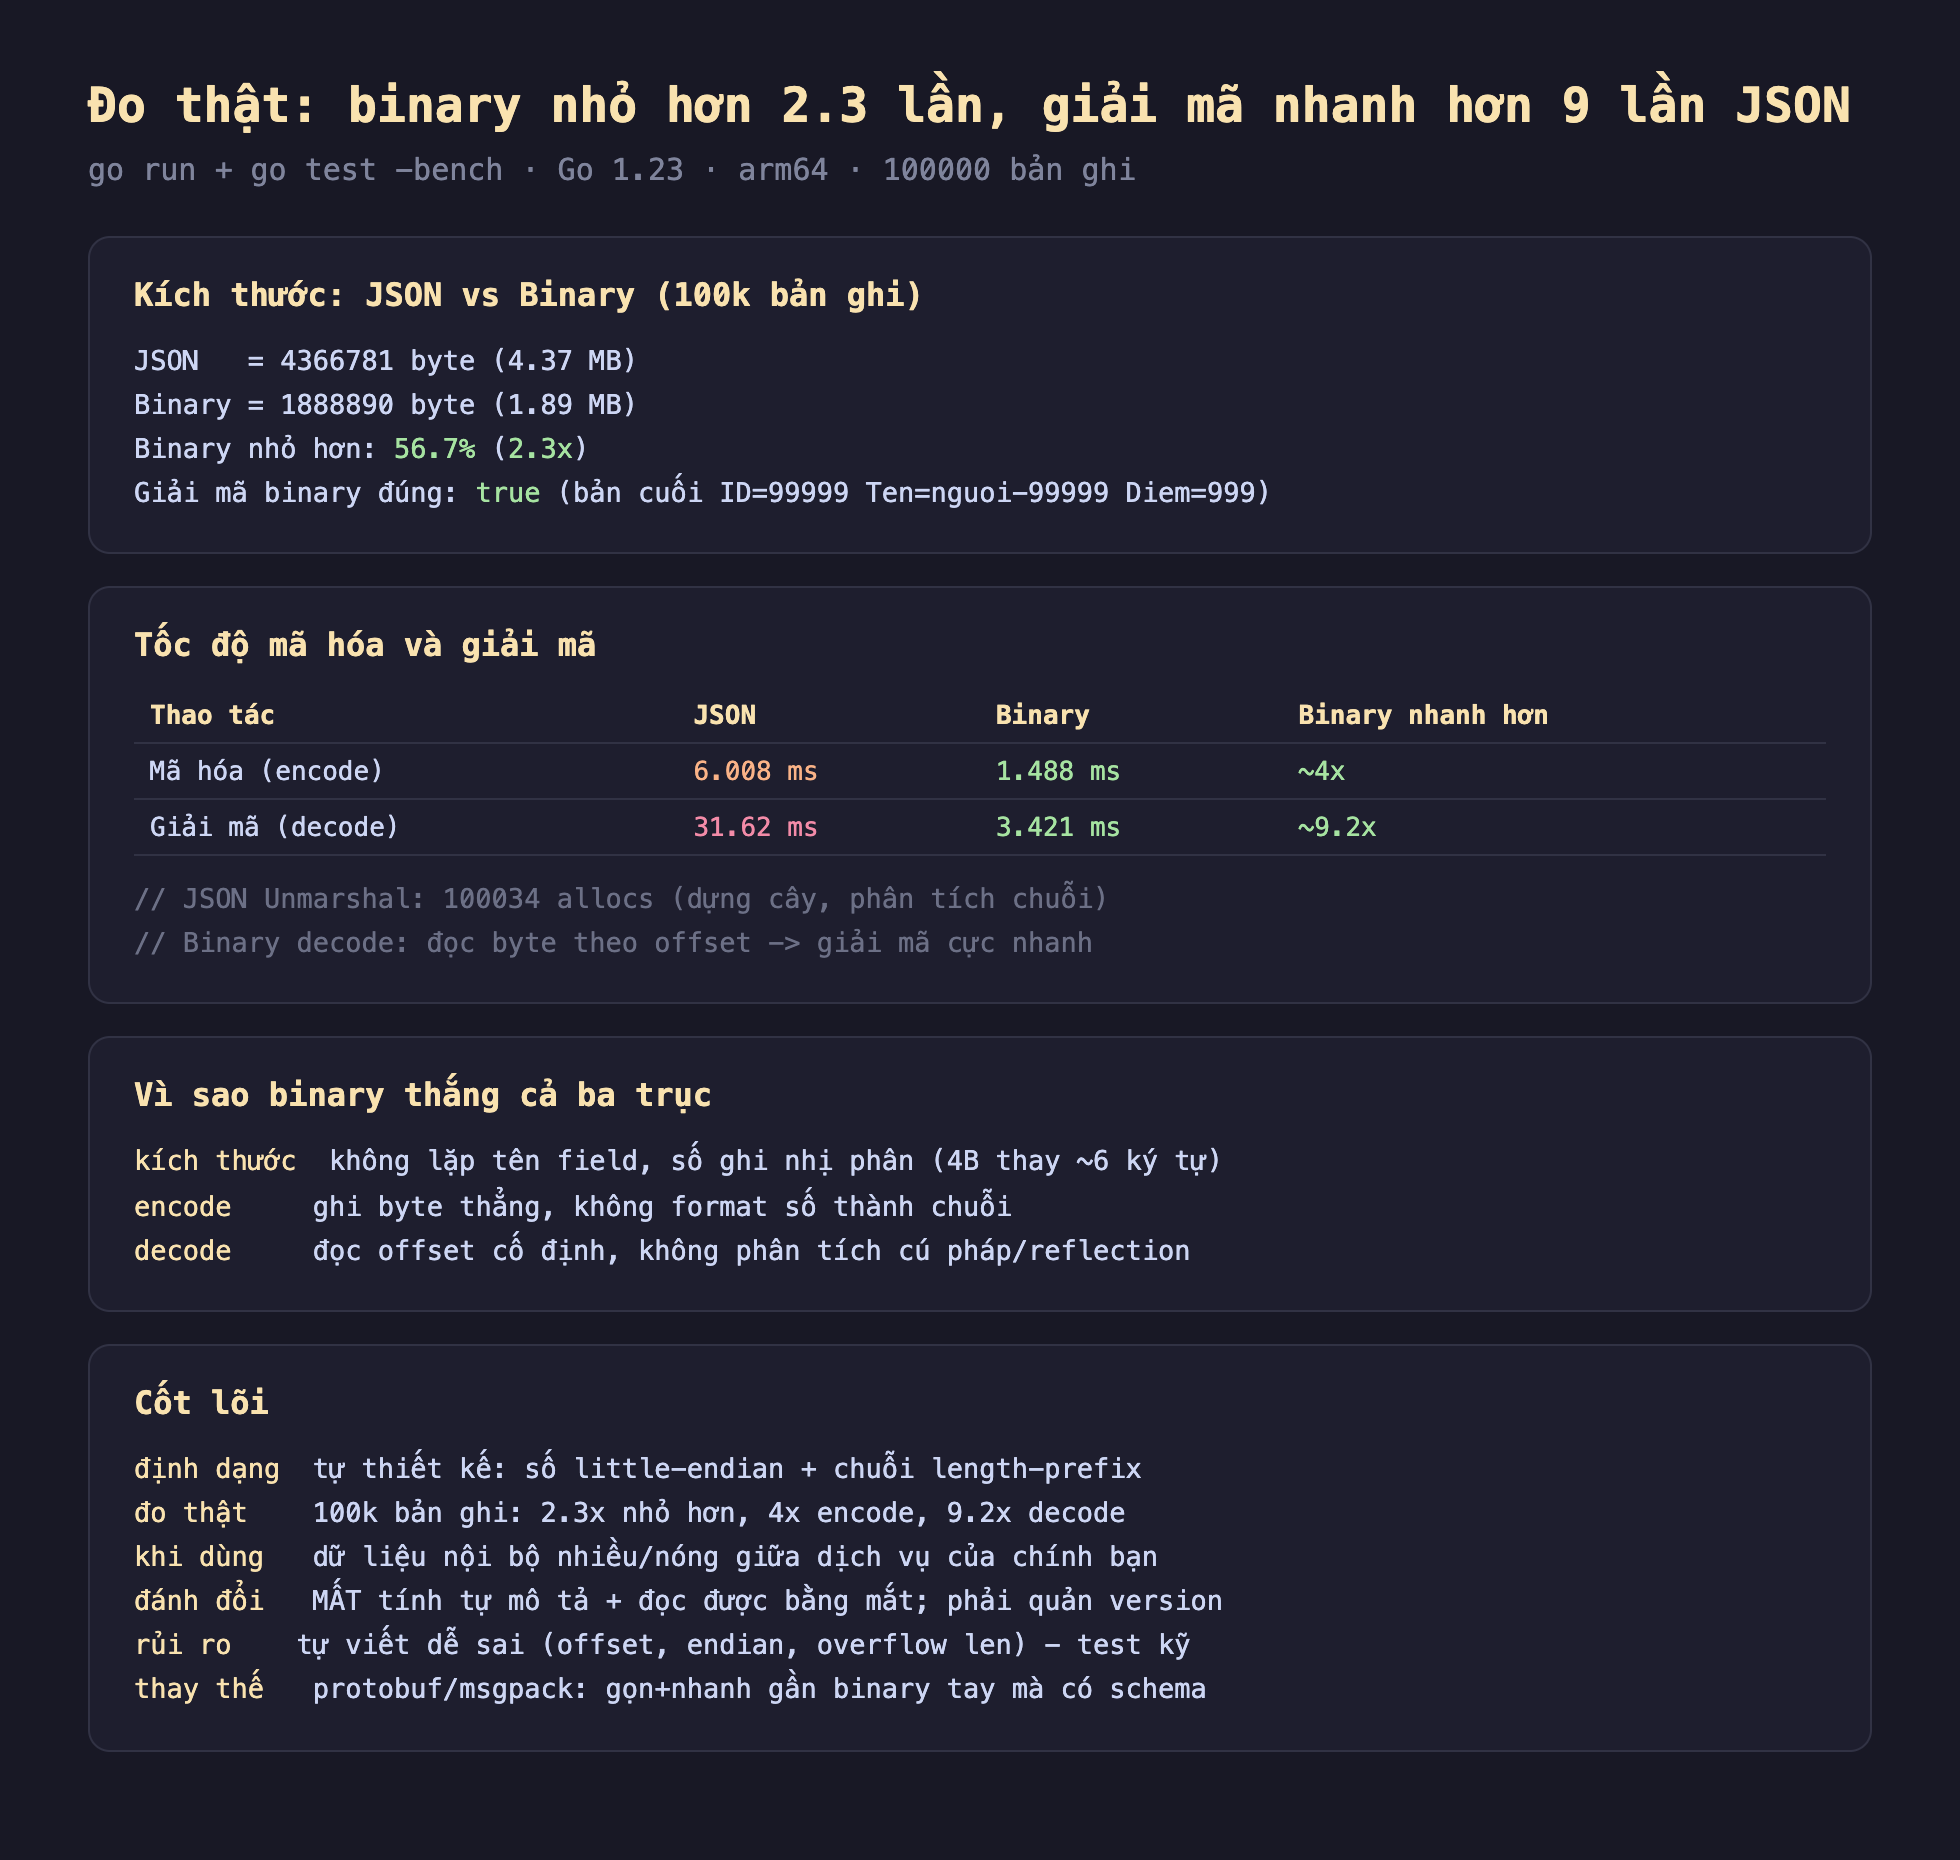
Hình 2: Đo thật 100k bản ghi — binary nhỏ hơn JSON 2.3 lần (4.37 MB → 1.89 MB), mã hóa nhanh ~4 lần, giải mã nhanh ~9.2 lần (JSON Unmarshal tốn 100034 cấp phát, binary đọc byte theo offset), giải mã đúng dữ liệu.
Đánh đổi cần cân nhắc
Mất tính tự mô tả và đọc được bằng mắt. JSON có thể mở bằng bất kỳ trình soạn thảo nào và đọc hiểu ngay; binary là một khối byte vô nghĩa nếu không có mã giải mã. Bạn mất khả năng debug bằng mắt, dùng curl | jq, hay để một hệ thống khác tự hiểu dữ liệu. Đây là lý do JSON vẫn đúng cho API công khai và dữ liệu trao đổi giữa các bên không cùng codebase.
Tự viết binary dễ sai một cách nguy hiểm. Code trên trông đơn giản, nhưng đầy cạm bẫy: đọc nhầm offset, sai endian giữa các kiến trúc, len(Ten) vượt uint16 (65535) làm tràn âm thầm, hay data[i:i+n] vượt biên gây panic khi dữ liệu hỏng. Một định dạng binary tự viết phải được test kỹ với dữ liệu biên và dữ liệu hỏng — vì lỗi ở đây thường là hỏng dữ liệu im lặng, khó lần hơn nhiều so với lỗi phân tích JSON.
Phải tự quản lý phiên bản (versioning). JSON dung thứ với thay đổi schema: thêm field mới, bên đọc cũ chỉ bỏ qua. Binary với offset cố định thì không — thêm một field là đổi bố cục, và bên đọc cũ đọc sai hoàn toàn. Bạn phải tự thiết kế cơ chế version (ví dụ byte đầu là số phiên bản) ngay từ đầu, nếu không việc tiến hóa định dạng sẽ rất đau.
Thường nên dùng protobuf hoặc msgpack thay vì tự viết. Đây là kết luận thực dụng: các định dạng như Protocol Buffers hay MessagePack cho bạn gần như toàn bộ lợi ích kích thước và tốc độ của binary tay, nhưng kèm schema, sinh code tự động, quản lý version, và tương thích đa ngôn ngữ. Tự viết binary chỉ đáng khi bạn có nhu cầu rất đặc thù (bố cục cực tối ưu cho một trường hợp nóng) và chấp nhận gánh nặng bảo trì. Bài này cho bạn hiểu cơ chế để biết các thư viện đó làm gì bên dưới.
Ba ý mang về
- Encoding nhị phân tùy biến nhỏ và nhanh hơn JSON trên cả ba trục: đo thật 100k bản ghi, binary nhỏ hơn 2.3 lần (không lặp tên field, số nhị phân), mã hóa nhanh ~4 lần, giải mã nhanh ~9.2 lần (đọc offset thay vì phân tích cú pháp) — decode thường là trục quan trọng nhất.
- Cơ chế cốt lõi là bố cục byte có ranh giới rõ: số kích thước cố định little-endian, chuỗi kèm tiền tố độ dài (length-prefix), giải mã đọc theo offset không reflection — đó là điều làm nó nhanh.
- Nêu rõ đánh đổi và rủi ro: mất tính tự mô tả và debug bằng mắt, tự viết dễ sai (offset, endian, tràn độ dài) nên phải test kỹ, và phải tự quản version — với hầu hết nhu cầu, protobuf/msgpack cho lợi ích tương tự mà an toàn hơn nhiều.
Bài tập làm thử
Bài 1 (đọc hiểu). Với bố cục [ID:4B][Diem:2B][len(Ten):2B][Ten:N byte], hãy tính chính xác số byte cần để mã hóa một bản ghi có Ten = "nguoi-99999" (11 ký tự).
Đáp án
Tổng = 4 (ID) + 2 (Diem) + 2 (độ dài của Ten) + 11 (nội dung Ten, vì "nguoi-99999" có 11 ký tự) = 19 byte. Đây là ví dụ cụ thể cho nguyên lý bố cục: trường cố định (ID, Diem) không cần tiền tố độ dài, còn trường thay đổi (Ten) luôn kèm 2 byte length-prefix đứng trước nó.
Bài 2 (sửa lỗi). Đoạn mã giải mã sau bị lỗi khi đọc trường Ten. Chỉ ra vấn đề dựa theo đúng thứ tự byte mà bài mô tả, và sửa lại.
func giaiMa(data []byte) Ban {
	var b Ban
	i := 0
	b.ID = binary.LittleEndian.Uint32(data[i : i+4]); i += 4
	n := int(binary.LittleEndian.Uint16(data[i : i+2])); i += 2
	b.Ten = string(data[i : i+n]); i += n
	b.Diem = binary.LittleEndian.Uint16(data[i : i+2]); i += 2
	return b
}
Đáp án
Lỗi: đọc len(Ten) và Ten ngay sau ID, trước khi đọc Diem — nhưng bố cục thiết kế của bài là [ID:4B][Diem:2B][len(Ten):2B][Ten:N byte], tức Diem phải được đọc trước phần độ dài và nội dung của Ten. Sửa lại đúng thứ tự:
func giaiMa(data []byte) Ban {
	var b Ban
	i := 0
	b.ID = binary.LittleEndian.Uint32(data[i : i+4]); i += 4
	b.Diem = binary.LittleEndian.Uint16(data[i : i+2]); i += 2
	n := int(binary.LittleEndian.Uint16(data[i : i+2])); i += 2
	b.Ten = string(data[i : i+n]); i += n
	return b
}
Bài 3 (vận dụng thực tế). Đội của bạn xây dựng giao tiếp nội bộ tốc độ cao giữa hai dịch vụ do chính đội quản lý, xử lý hàng triệu bản ghi/giây. Dựa vào số đo trong bài (nhỏ hơn 2.3 lần, mã hóa nhanh ~4 lần, giải mã nhanh ~9.2 lần), việc chuyển từ JSON sang binary tùy biến có hợp lý không? Kết luận thực dụng của bài khuyên gì thay vì tự viết binary hoàn toàn từ đầu?
Đáp án
Có hợp lý về mặt kỹ thuật — đây đúng là kịch bản "dữ liệu nội bộ nóng" mà bài khuyến nghị dùng binary thay JSON, vì lợi ích đo được rất lớn trên cả ba trục (kích thước, mã hóa, giải mã). Tuy nhiên, kết luận thực dụng của bài là: "thường nên dùng protobuf hoặc msgpack thay vì tự viết" — các định dạng này cho gần như toàn bộ lợi ích của binary tay nhưng kèm schema, sinh code tự động, quản lý version và tương thích đa ngôn ngữ, tránh gánh nặng bảo trì của tự viết bằng tay.
Bài 4 (bẫy/đánh đổi). Một năm sau khi triển khai định dạng binary tùy biến [ID:4B][Diem:2B][len(Ten):2B][Ten:N byte], đội cần thêm trường mới NgayTao uint32. Vì sao việc này khó hơn nhiều so với thêm một field mới vào JSON, và rủi ro cụ thể nào có thể xảy ra nếu làm không cẩn thận?
Đáp án
JSON dung thứ thay đổi schema — bên đọc cũ bỏ qua field lạ, không sao. Binary với offset cố định thì không: thêm NgayTao vào bố cục sẽ đổi toàn bộ vị trí các byte sau nó, khiến bên đọc cũ đọc sai hoàn toàn (đọc nhầm byte của trường này thành trường khác) mà không có tín hiệu lỗi rõ ràng — đây là kiểu lỗi "hỏng dữ liệu im lặng" mà bài cảnh báo là nguy hiểm hơn lỗi phân tích JSON. Cách đúng, theo bài, là phải tự thiết kế cơ chế version (ví dụ byte đầu là số phiên bản) ngay từ đầu, trước khi triển khai, chứ không phải xử lý sau khi đã có dữ liệu cũ.
Bài 5 (đọc hiểu số liệu Go). Số đo cho biết JSON Unmarshal tốn 100.034 cấp phát (allocs) khi giải mã 100.000 bản ghi, trong khi binary decode đọc byte theo offset. Giải thích vì sao JSON cần nhiều cấp phát như vậy trong khi binary decode gần như không cần cấp phát mới cho mỗi bản ghi.
Đáp án
json.Unmarshal phải phân tích cú pháp từng ký tự: dựng cây token trung gian, chuyển chuỗi số ASCII thành kiểu số Go (cấp phát tạm cho việc parse), và tạo struct mới cho mỗi bản ghi — với ~100.000 bản ghi, số cấp phát xấp xỉ 100.034 phản ánh chi phí phân tích cú pháp lặp lại cho mỗi phần tử. Ngược lại, binary decode chỉ đọc byte tại các offset đã biết trước (data[i:i+4], data[i:i+2]...) và gán trực tiếp vào trường struct bằng các hàm binary.LittleEndian.Uint32/Uint16 — không cần dựng cây cú pháp trung gian hay chuyển đổi định dạng số, nên gần như không tốn cấp phát thêm ngoài chính struct kết quả.
Phần sau ta xét một kỹ thuật đọc tệp cực lớn không qua bộ nhớ thường: memory-mapped file (mmap) trong Go — ánh xạ tệp thẳng vào không gian địa chỉ, đọc như slice byte, và đo thật khác biệt so với đọc thường.
