Hai bài trước cho thấy phân vùng và partition pruning mạnh thế nào. Nhưng "mạnh" không đồng nghĩa "luôn nên dùng". Phân vùng là một quyết định thiết kế có đánh đổi thật, và dùng sai chỗ khiến truy vấn chậm hơn bảng thường. Bài này đo thật cả hai mặt của con dao — khi phân vùng thắng lớn và khi nó thua — để bạn quyết định có nên chia bảng của mình hay không.
Con dao hai lưỡi: đo cả hai mặt
Tôi dựng hai bảng cùng 3 triệu dòng: flat (bảng phẳng có index) và part (phân vùng theo cột k thành 50 vùng). Rồi chạy hai loại truy vấn khác nhau trên cả hai:
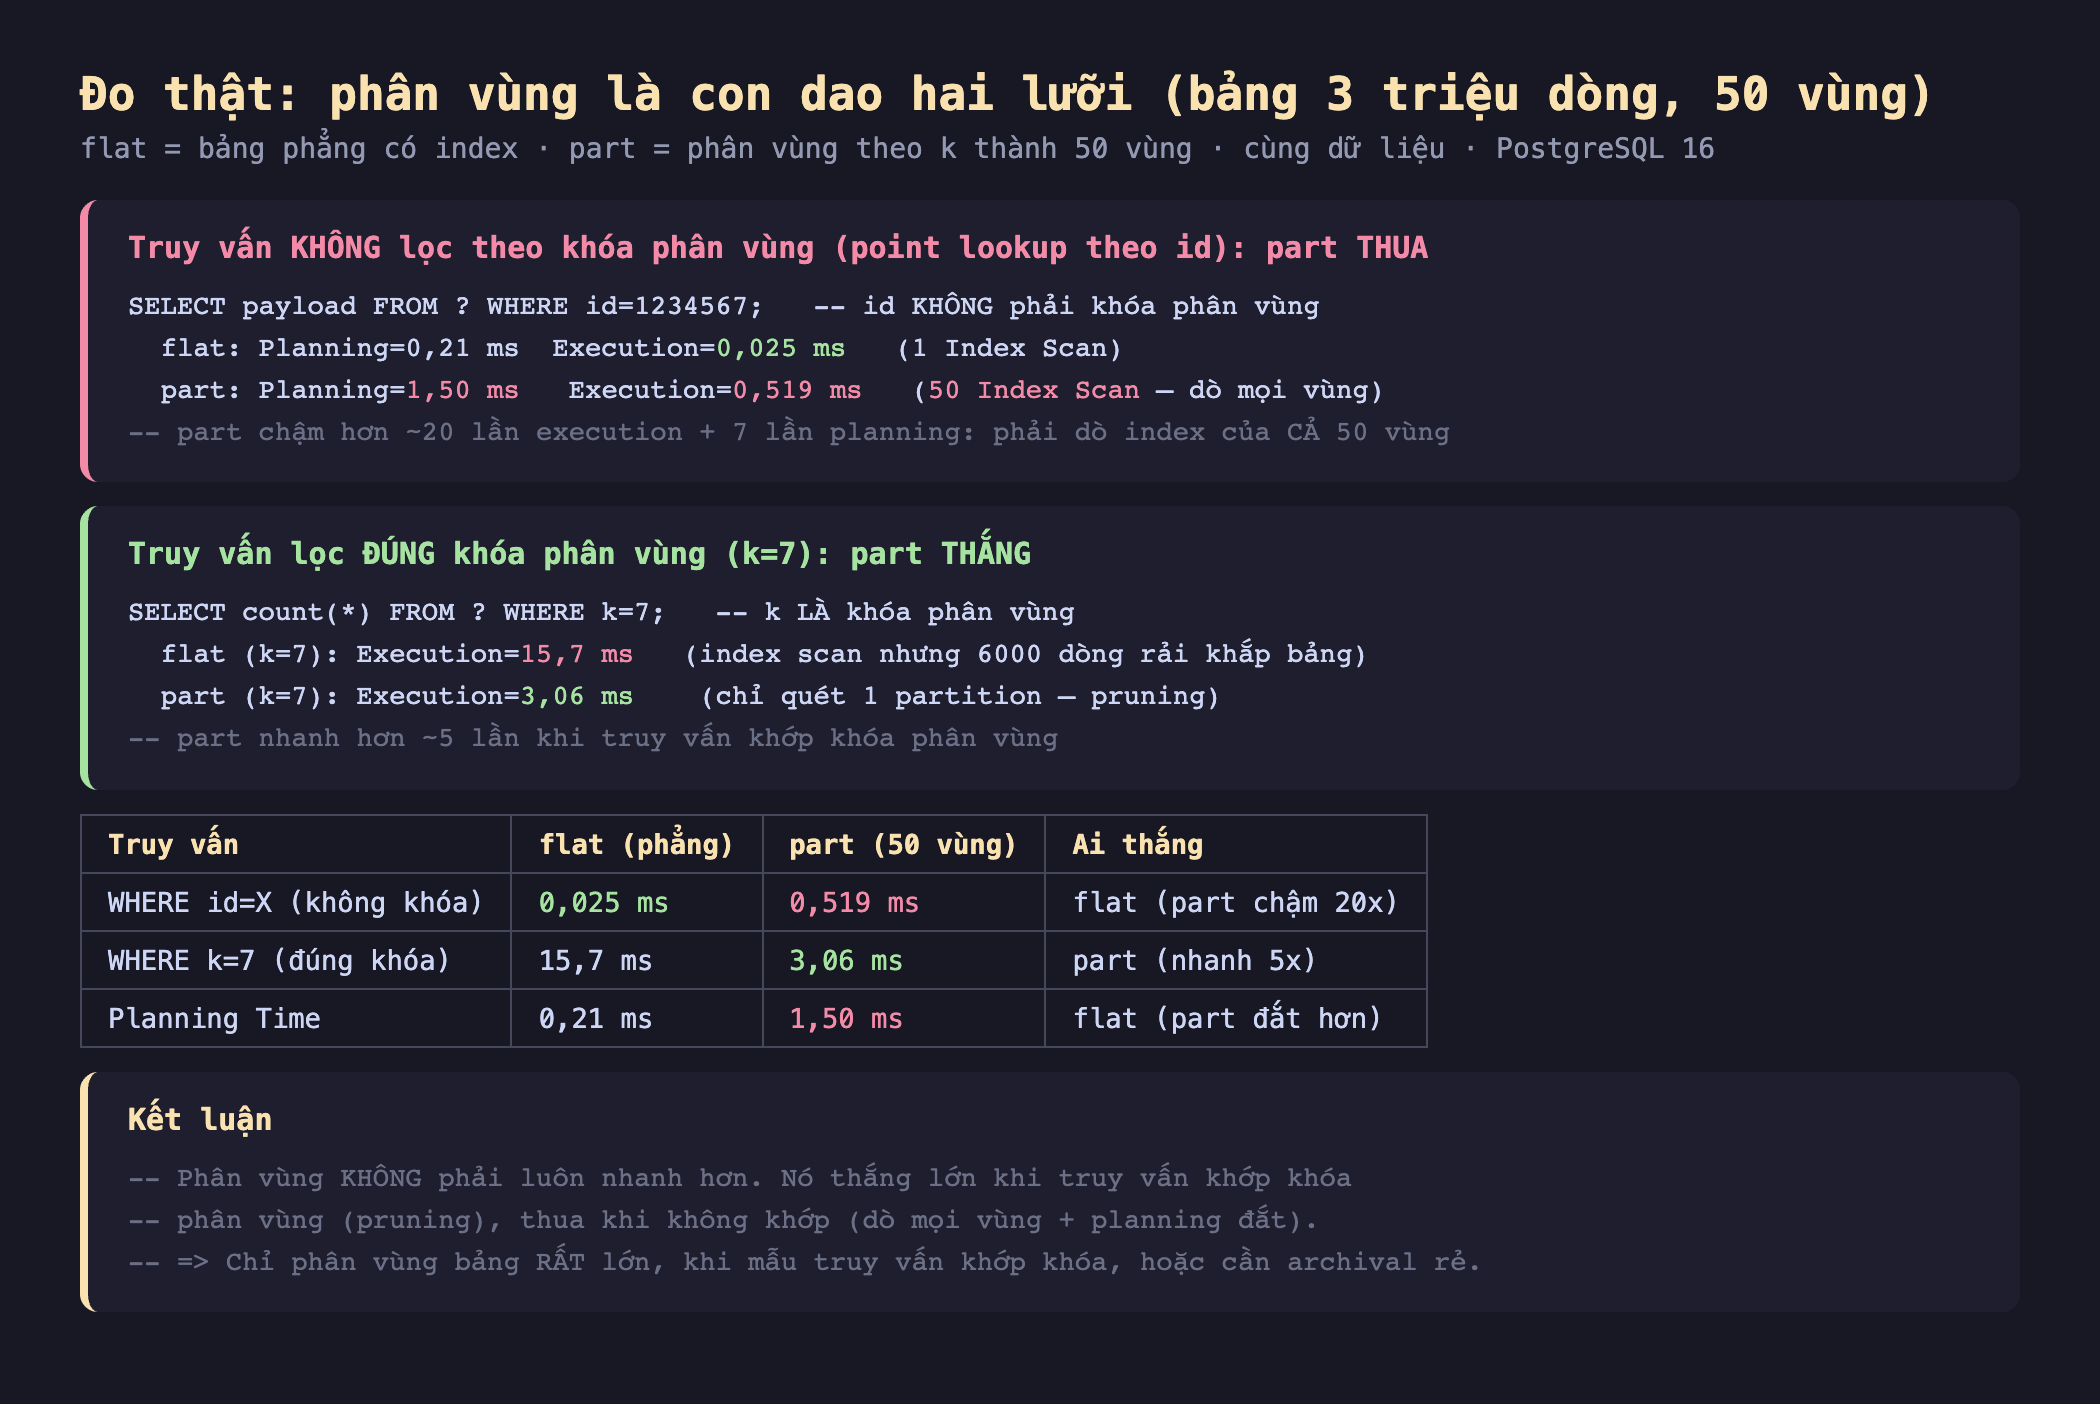
Hình 2: Truy vấn point lookup theo id (không phải khóa phân vùng): flat 0,025 ms với 1 Index Scan, part 0,519 ms với 50 Index Scan (dò mọi vùng) — chậm gấp ~20 lần, planning đắt gấp 7 lần. Truy vấn theo khóa k=7: part 3,06 ms thắng flat 15,7 ms nhờ pruning.
- Truy vấn KHÔNG lọc theo khóa phân vùng (
WHERE id=X, màidkhông phải khóa):flatdùng một Index Scan, 0,025 ms;partphải dò index của cả 50 vùng (50 Index Scan trong Append), 0,519 ms — chậm gấp ~20 lần về thực thi, cộng planning 1,50 ms (đắt gấp 7 lần 0,21 ms của flat). Vìidrải khắp mọi partition, PostgreSQL không prune được và phải tìm ở từng vùng. - Truy vấn lọc ĐÚNG khóa phân vùng (
WHERE k=7):partchỉ quét một partition (pruning), 3,06 ms;flatphải index scan rồi lấy 6000 dòng rải khắp bảng, 15,7 ms —partnhanh gấp ~5 lần.
Cùng một cặp bảng, cùng dữ liệu — phân vùng thắng đậm hay thua đậm hoàn toàn phụ thuộc truy vấn có khớp khóa phân vùng hay không.
Khi nào NÊN phân vùng
Phân vùng đáng làm khi hội đủ (không phải chỉ một) các dấu hiệu:
- Bảng RẤT lớn — hàng trăm triệu dòng hoặc hàng trăm GB trở lên. Với bảng vài triệu dòng, một index tốt trên bảng phẳng thường nhanh hơn và đơn giản hơn.
- Truy vấn chính lọc theo một khóa tự nhiên (thời gian, tenant, khu vực) → được partition pruning (như đo ở bài trước, nhanh 5-10 lần).
- Cần archival rẻ — xóa dữ liệu cũ bằng
DROP TABLE part_2023(tức thì, không sinh dead tuple) thay vìDELETEhàng triệu dòng (chậm, cần VACUUM dọn sau). - Bảo trì theo vùng —
VACUUM/REINDEX/tạo index chạy trên từng partition nhỏ thay vì cả bảng khổng lồ một lần.
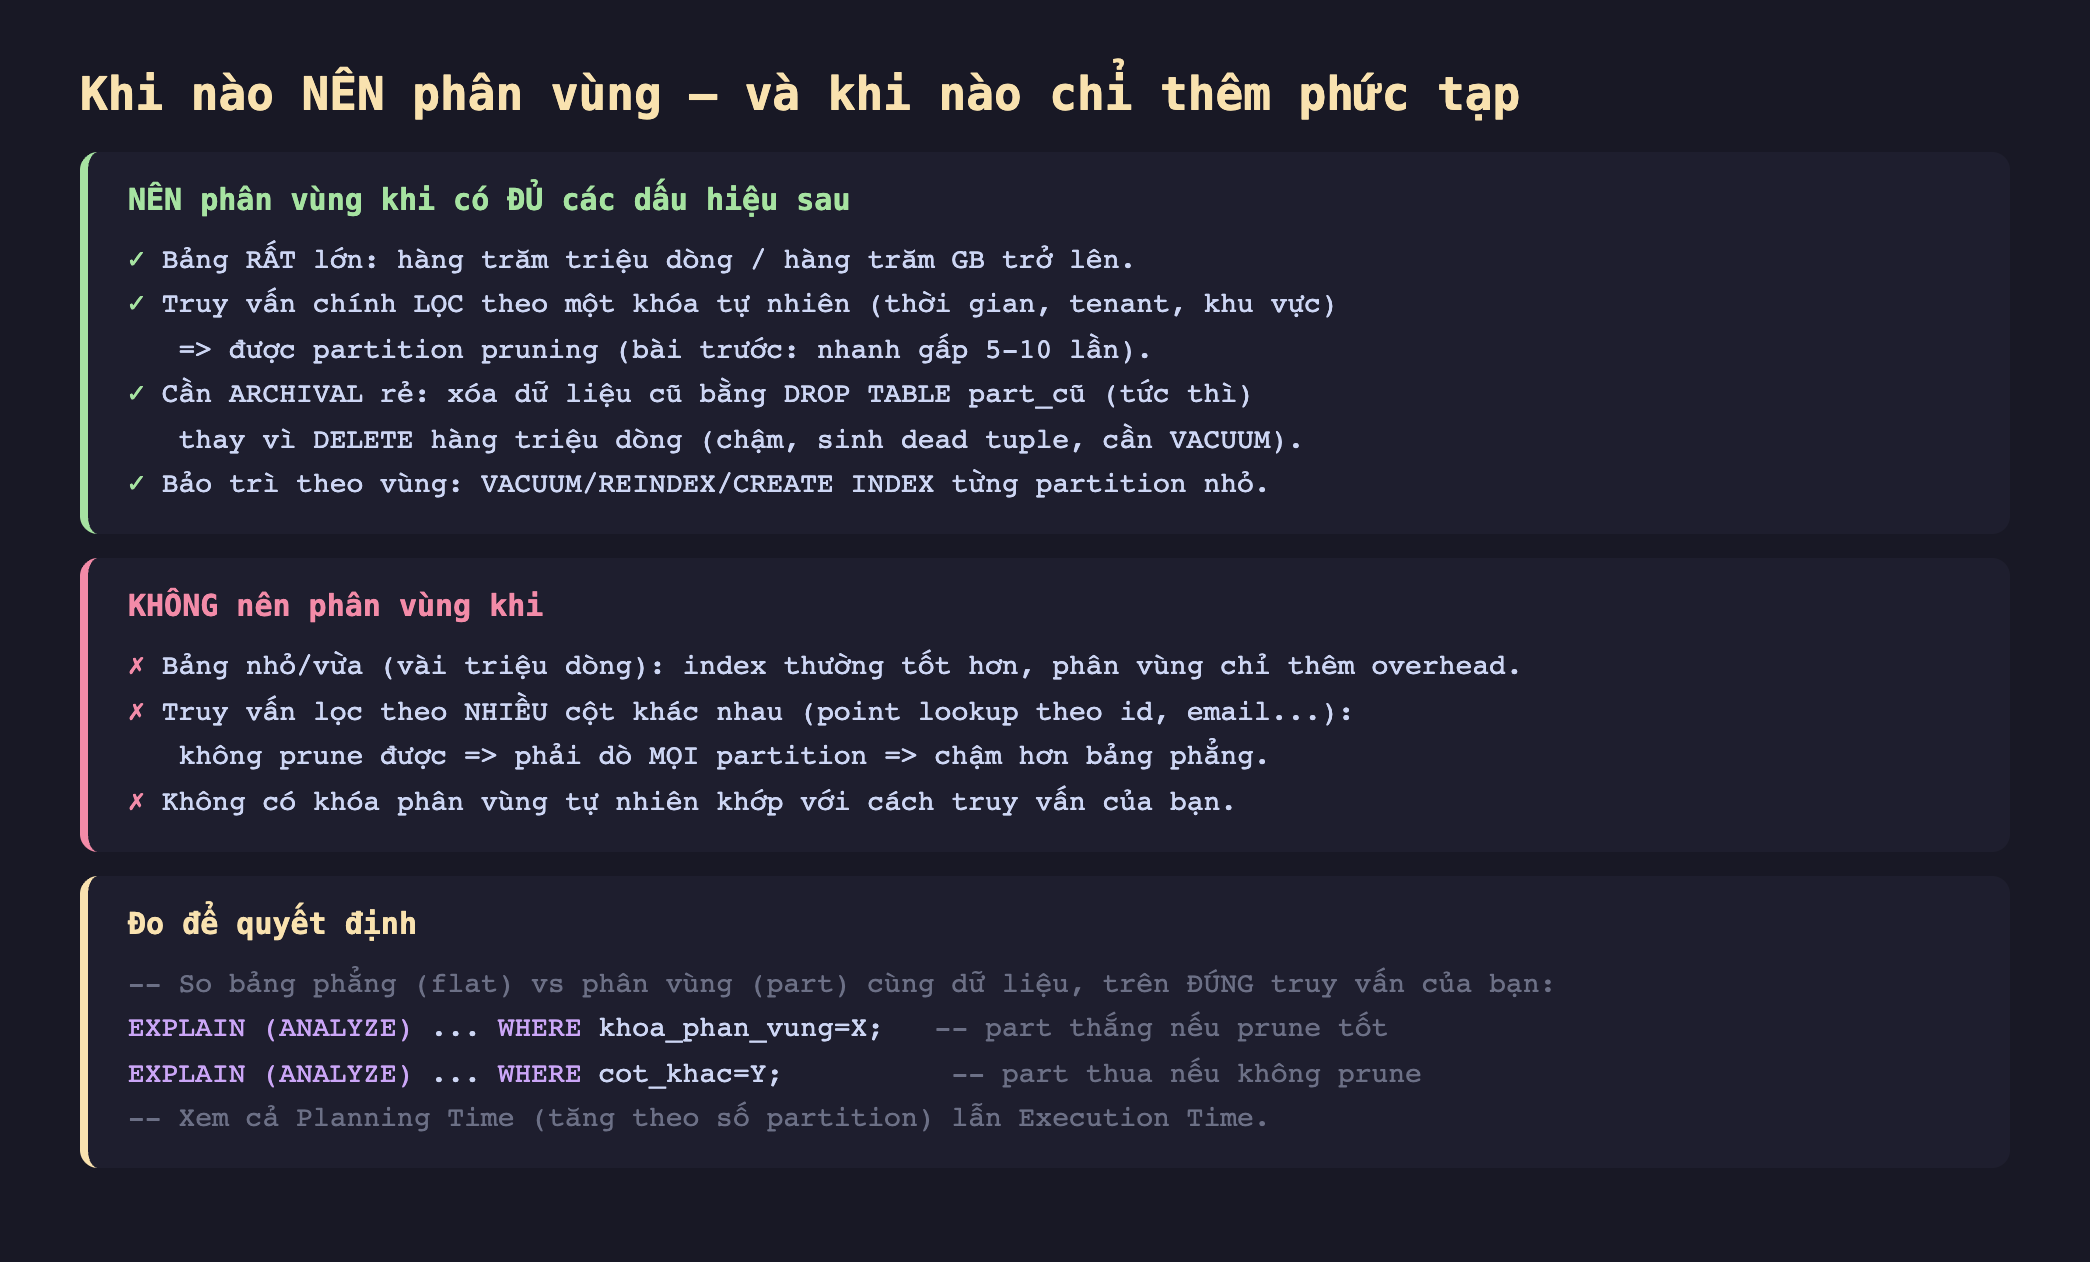
Hình 1: Danh sách quyết định — NÊN phân vùng khi bảng rất lớn + truy vấn khớp khóa + cần archival rẻ; KHÔNG nên khi bảng nhỏ, truy vấn lọc theo nhiều cột khác, hoặc không có khóa phân vùng tự nhiên. Luôn đo cả Planning lẫn Execution Time trên truy vấn thật.
Khi nào KHÔNG nên
- Bảng nhỏ/vừa (vài triệu dòng): index trên bảng phẳng thường tốt hơn; phân vùng chỉ thêm overhead quản lý và planning.
- Truy vấn lọc theo nhiều cột khác nhau (point lookup theo id, email, v.v.): như đo ở trên, không prune được thì phải dò mọi partition — chậm hơn bảng phẳng.
- Không có khóa phân vùng tự nhiên khớp với cách truy vấn của bạn: chọn khóa mà truy vấn hiếm khi lọc theo thì mất hết lợi ích pruning.
Đánh đổi cần cân nhắc
Cách quyết định đúng là đo, không phải nghe theo quy tắc chung. Dựng một bảng phẳng và một bảng phân vùng cùng dữ liệu, rồi chạy EXPLAIN (ANALYZE) trên chính những truy vấn thật của ứng dụng bạn — cả truy vấn khớp khóa lẫn không khớp. Xem cả Planning Time (tăng theo số partition) lẫn Execution Time. Nếu phần lớn truy vấn không khớp khóa phân vùng, đừng phân vùng.
Có thể index nhiều cột trên bảng phân vùng, nhưng không cứu được pruning. Bạn có thể tạo index trên id cho mọi partition (như tôi làm ở trên), nhưng truy vấn theo id vẫn phải dò từng index của từng vùng — index không thay thế pruning. Chỉ khóa phân vùng mới cho pruning.
Phân vùng thêm phức tạp vận hành thật. Cần chiến lược tạo partition tương lai, DEFAULT partition làm lưới an toàn, ràng buộc unique phải chứa khóa phân vùng, và một số thao tác (ALTER, khóa ngoại tới bảng phân vùng) có giới hạn. Đừng trả cái giá phức tạp này cho một bảng chưa đủ lớn để cần.
Ba ý mang về
- Phân vùng là con dao hai lưỡi: đo thật cùng 3 triệu dòng, truy vấn khớp khóa phân vùng nhanh gấp ~5 lần (pruning), nhưng truy vấn point lookup theo cột khác chậm gấp ~20 lần (dò index của cả 50 vùng) cộng planning đắt gấp 7 lần.
- Chỉ phân vùng khi hội đủ dấu hiệu: bảng rất lớn (hàng trăm triệu dòng), truy vấn chính khớp một khóa tự nhiên, cần archival rẻ (DROP partition) — với bảng vài triệu dòng, index trên bảng phẳng thường tốt hơn.
- Đo trước khi chia: dựng bảng phẳng vs phân vùng cùng dữ liệu, chạy EXPLAIN ANALYZE trên chính truy vấn thật của bạn (cả khớp và không khớp khóa), xem cả Planning lẫn Execution Time — index không thay được pruning, và phức tạp vận hành là có thật.
Phần sau ta xét một lợi ích nâng cao của phân vùng khi kết hợp bảng: Phần sau mổ xẻ partition-wise join và aggregate — cách PostgreSQL join/gom theo từng cặp partition tương ứng để tăng tốc và song song hóa.
