Bài trước dựng ba kiểu phân vùng và hé lộ lợi ích cốt lõi. Bài này đo sâu chính lợi ích đó: partition pruning — khả năng của PostgreSQL bỏ qua hoàn toàn các vùng không thể chứa dữ liệu khớp truy vấn. Đây không phải một tính năng phụ; nó là lý do chính để phân vùng. Bài này đo thật pruning nhanh thế nào, và một điều kiện quan trọng: nó chỉ giúp khi bạn lọc theo khóa phân vùng.
Pruning làm gì
Tôi dựng bảng sk 5 triệu dòng, phân vùng RANGE theo cột thang thành 10 vùng (sk_0..sk_9, mỗi vùng một dải giá trị). Khi truy vấn lọc theo thang, PostgreSQL biết dữ liệu chỉ có thể nằm ở đúng một vùng, và bỏ qua 9 vùng còn lại:
SELECT count(*) FROM sk WHERE thang=25; -- thang=25 chỉ có thể ở sk_2 (dải 20-30)
Pruning có hai dạng, tùy điều kiện lọc là hằng số hay tham số:
- Plan-time pruning: khi khóa phân vùng so với hằng số biết lúc lập kế hoạch (
WHERE thang=25), planner loại các vùng thừa ngay khi lập kế hoạch —EXPLAINchỉ hiện đúng một vùng. - Run-time pruning: khi khóa so với tham số (
$1) hoặc kết quả subquery chưa biết lúc lập kế hoạch. Generic plan giữ cảAppendcủa mọi vùng, nhưng lúc chạy (biết giá trị thật) executor loại các vùng thừa —EXPLAINhiệnSubplans Removed: N.
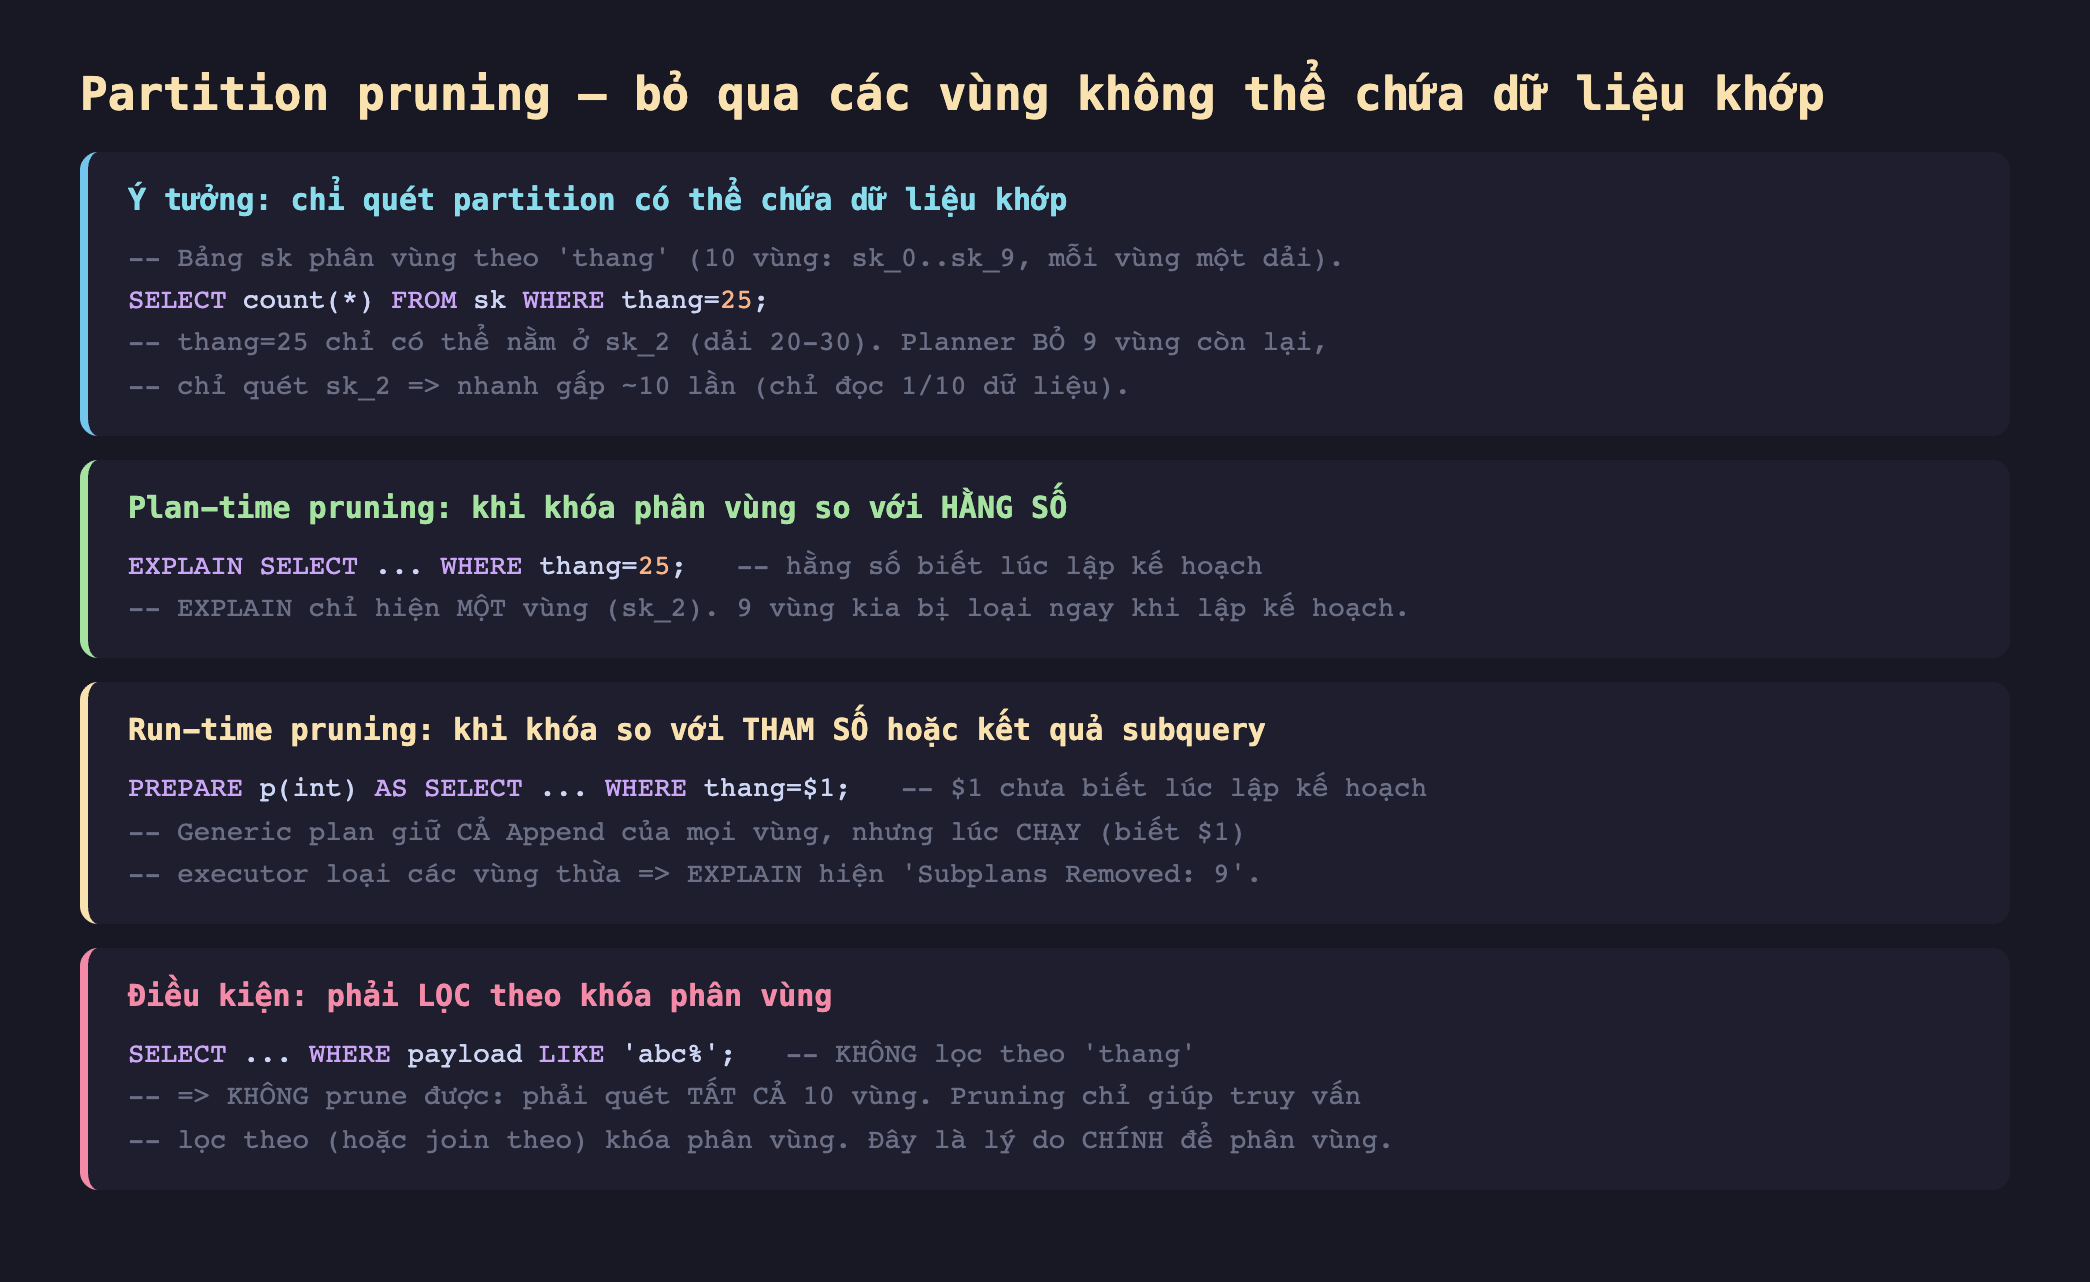
Hình 1: Partition pruning bỏ qua các vùng không thể chứa dữ liệu khớp. Plan-time pruning (khóa so với hằng số) loại vùng lúc lập kế hoạch; run-time pruning (khóa so với tham số) loại vùng lúc chạy (Subplans Removed). Chỉ hoạt động khi lọc theo khóa phân vùng.
Đo thật: nhanh gấp 10 lần
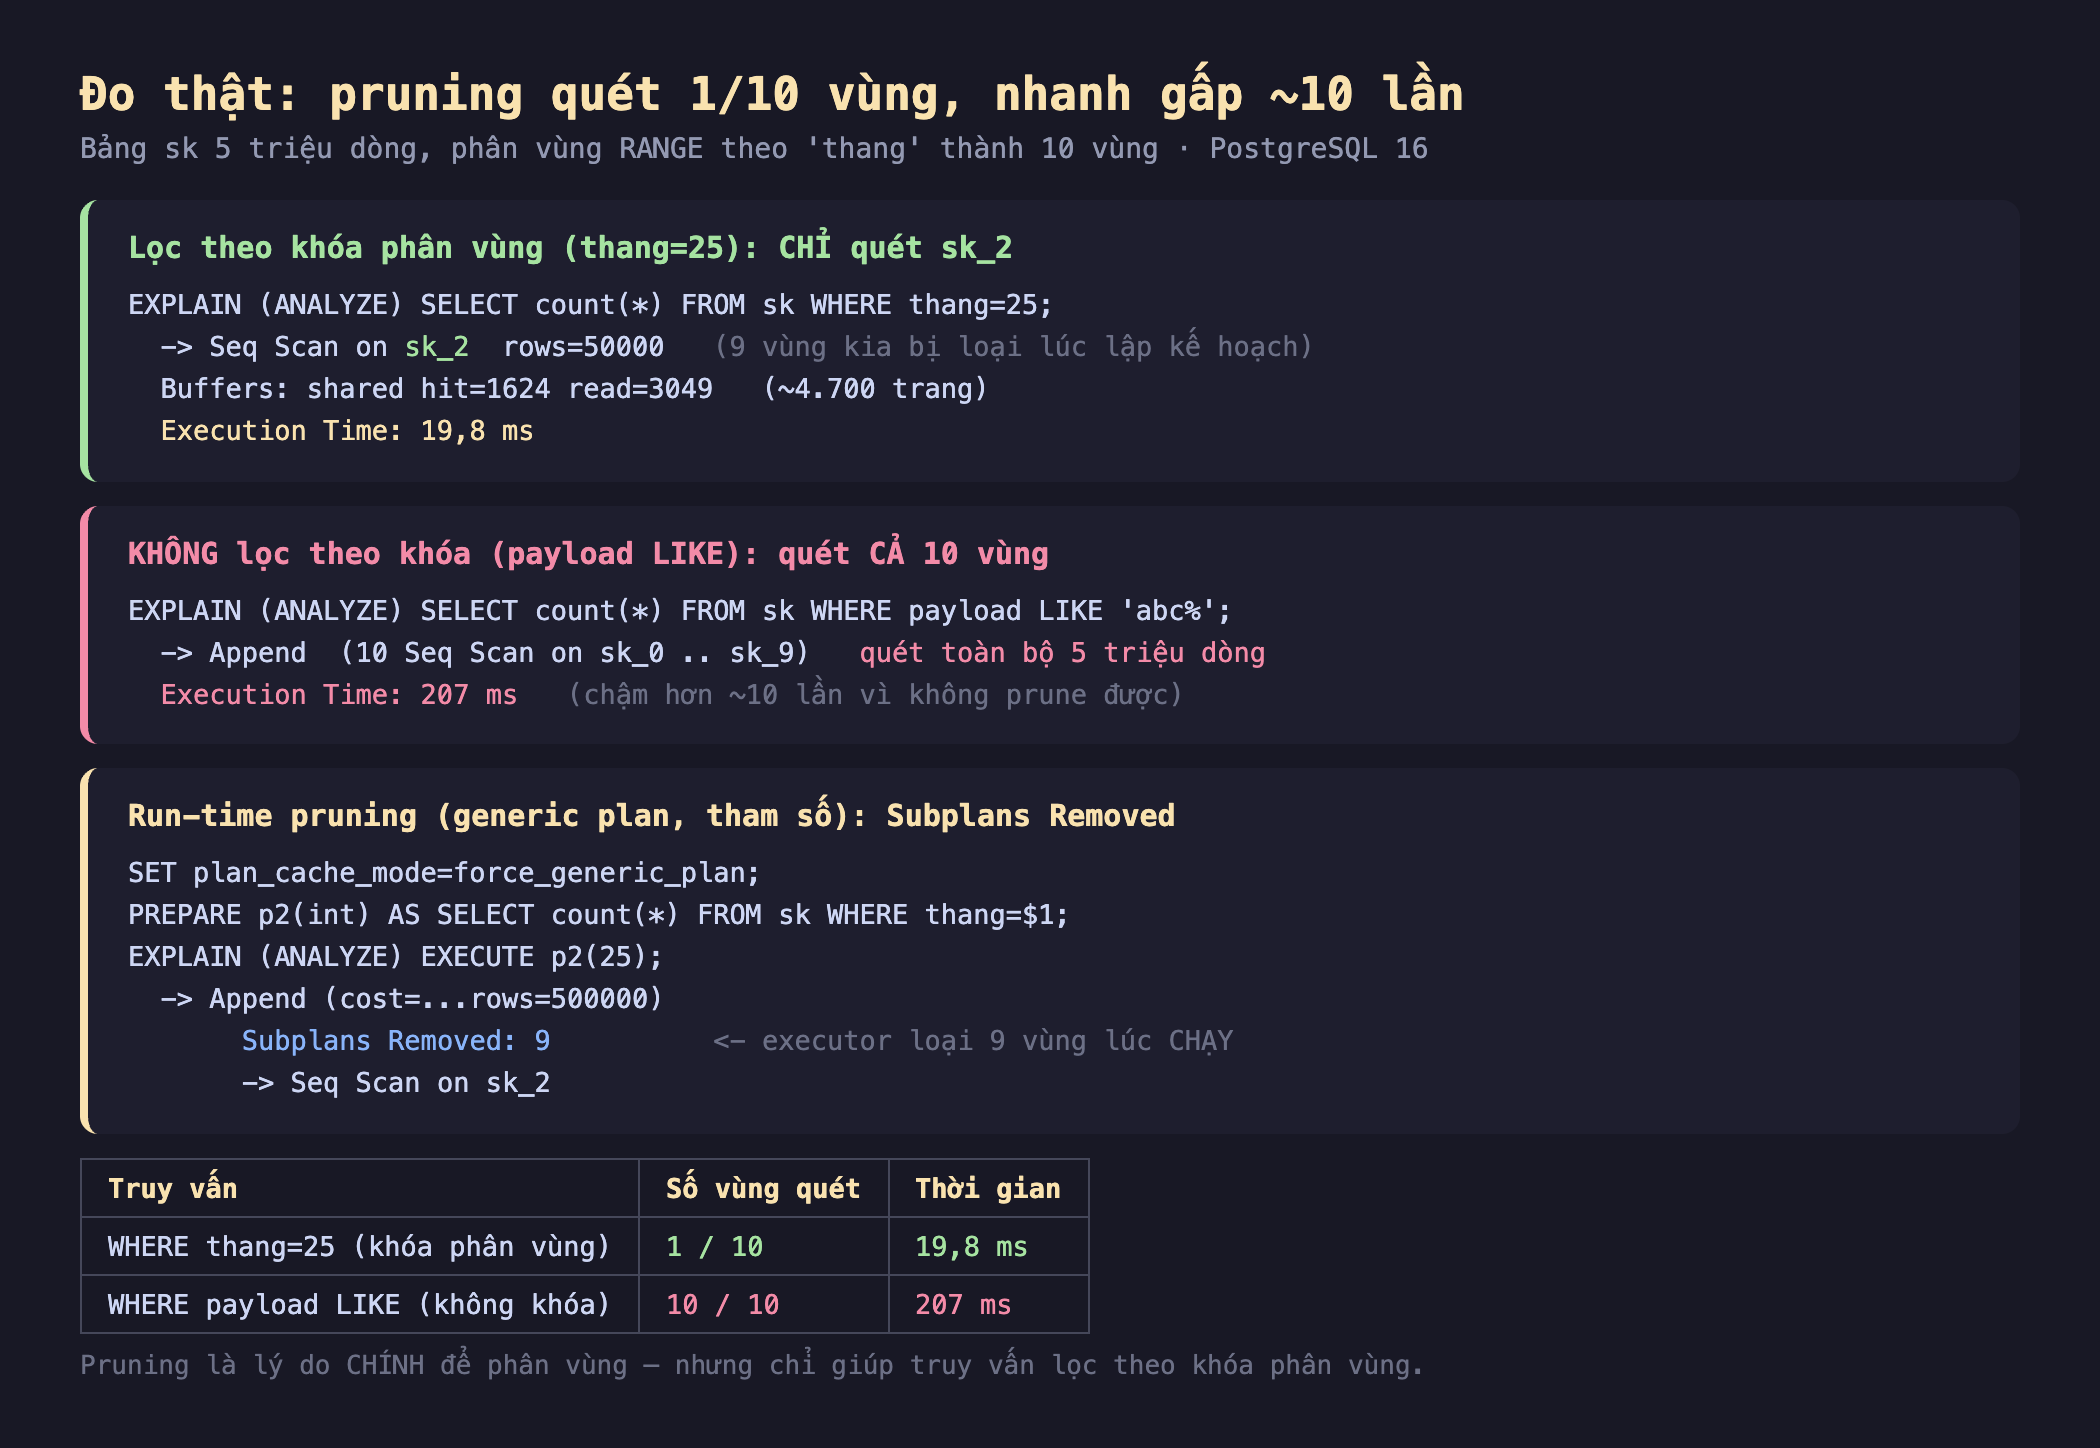
Hình 2: Lọc theo khóa thang=25 chỉ quét sk_2 (~4.700 trang, 19,8 ms). Không lọc theo khóa (payload LIKE) phải quét cả 10 vùng (207 ms) — chậm gấp ~10 lần. Run-time pruning với tham số hiện Subplans Removed: 9.
- Lọc theo khóa phân vùng (
WHERE thang=25):EXPLAINchỉ hiệnSeq Scan on sk_2— 9 vùng kia bị loại. Đọc ~4.700 trang, 19,8 ms. - Không lọc theo khóa (
WHERE payload LIKE 'abc%'): planner không biết dữ liệu ở vùng nào, phải quét cả 10 vùng (Append 10 Seq Scan), toàn bộ 5 triệu dòng — 207 ms, chậm gấp ~10 lần. - Run-time pruning (generic plan với tham số):
EXPLAIN ANALYZE EXECUTE p2(25)hiệnSubplans Removed: 9— executor loại 9 vùng lúc chạy, chỉ quétsk_2.
Con số ~10 lần này chính là tỉ lệ số vùng: chia thành 10 vùng, truy vấn lọc đúng khóa chỉ đọc 1/10 dữ liệu. Chia càng nhiều vùng, pruning càng thắng lớn — với điều kiện truy vấn lọc theo khóa phân vùng.
Điều kiện: phải lọc theo khóa phân vùng
Đây là điểm quyết định thành bại của phân vùng. Pruning chỉ giúp truy vấn có điều kiện trên khóa phân vùng (hoặc join theo khóa đó). Truy vấn lọc theo cột khác (như payload ở trên) không prune được gì và phải quét toàn bộ — thậm chí chậm hơn bảng không phân vùng (vì phải gộp kết quả từ nhiều vùng qua Append).
Hệ quả thiết kế: chọn khóa phân vùng theo cách truy vấn của bạn lọc dữ liệu. Nếu ứng dụng phần lớn truy vấn theo khoảng thời gian → phân vùng RANGE theo ngày. Nếu truy vấn theo tenant/khu vực → LIST theo cột đó. Chọn sai khóa (khóa mà truy vấn hiếm khi lọc theo) thì phân vùng chỉ thêm overhead mà không được pruning.
Đánh đổi cần cân nhắc
Quá nhiều partition làm chậm lập kế hoạch. Mỗi partition là một bảng con planner phải xét. Vài chục đến vài trăm partition thường ổn; hàng nghìn partition khiến thời gian lập kế hoạch tăng đáng kể (dù pruning vẫn chạy). Cân bằng giữa số vùng (pruning tốt hơn) và chi phí quản lý/lập kế hoạch. PostgreSQL các phiên bản mới cải thiện nhiều, nhưng đừng chia nghìn vùng vô tội vạ.
Pruning cần thống kê và điều kiện "sạch". Điều kiện phải để planner suy ra được vùng: WHERE thang=25 prune tốt, nhưng WHERE thang::text='25' (bọc hàm) hay WHERE thang+0=25 có thể phá pruning. Giữ điều kiện trên khóa phân vùng ở dạng trực tiếp (giống nguyên tắc sargability của index).
Run-time pruning cần EXPLAIN ANALYZE để thấy. Với truy vấn tham số/prepared, EXPLAIN thường (không ANALYZE) hiện cả Append của mọi vùng — dễ tưởng nhầm không prune. Chỉ EXPLAIN ANALYZE (chạy thật) mới hiện Subplans Removed. Đừng kết luận pruning hỏng chỉ vì nhìn EXPLAIN tĩnh.
Ba ý mang về
- Partition pruning là lý do chính để phân vùng: đo thật, lọc theo khóa phân vùng chỉ quét 1/10 vùng (19,8 ms) so với quét cả 10 vùng khi không lọc theo khóa (207 ms) — nhanh gấp ~10 lần, đúng bằng tỉ lệ số vùng.
- Có hai dạng pruning: plan-time (khóa so với hằng số, loại vùng lúc lập kế hoạch, EXPLAIN chỉ hiện vùng liên quan) và run-time (khóa so với tham số/subquery, loại lúc chạy, hiện
Subplans Removed— chỉ thấy qua EXPLAIN ANALYZE). - Pruning chỉ giúp truy vấn lọc theo khóa phân vùng: chọn khóa theo cách ứng dụng lọc dữ liệu; giữ điều kiện "sạch" (không bọc hàm quanh khóa); và đừng chia quá nhiều vùng kẻo chậm lập kế hoạch.
Phần sau ta lùi lại một bước để quyết định thực dụng: Phần sau bàn khi nào thật sự nên phân vùng — ngưỡng kích thước bảng, dấu hiệu cần chia, và khi nào phân vùng chỉ thêm phức tạp mà không đáng.
