Khi một bảng phình tới hàng trăm triệu dòng, mọi thao tác trên nó — quét, index, VACUUM, xóa dữ liệu cũ — đều chậm dần. Phân vùng (partitioning) chia một bảng logic lớn thành nhiều bảng con vật lý theo một khóa, để mỗi thao tác chỉ cần chạm phần liên quan. PostgreSQL hỗ trợ ba kiểu phân vùng — RANGE, LIST, HASH — và chọn đúng kiểu là quyết định thiết kế quan trọng. Bài này dựng cả ba với dữ liệu thật và cho thấy dòng tự định tuyến thế nào.
Ba kiểu phân vùng
RANGE — theo khoảng liên tục (ngày, số). Mỗi partition nhận một dải giá trị. Đây là kiểu phổ biến nhất cho dữ liệu theo thời gian:
CREATE TABLE don_range(id int, ngay date, tien int) PARTITION BY RANGE (ngay);
CREATE TABLE don_2025 PARTITION OF don_range
  FOR VALUES FROM ('2025-01-01') TO ('2026-01-01');
LIST — theo giá trị rời rạc (miền, loại, trạng thái). Mỗi partition nhận một tập giá trị cụ thể:
CREATE TABLE kh_list(id int, mien text) PARTITION BY LIST (mien);
CREATE TABLE kh_bac PARTITION OF kh_list FOR VALUES IN ('bac');
HASH — chia đều theo băm khóa, dùng khi không có khóa range/list tự nhiên nhưng vẫn muốn chia nhỏ:
CREATE TABLE acc_hash(id int) PARTITION BY HASH (id);
CREATE TABLE acc_h0 PARTITION OF acc_hash FOR VALUES WITH (MODULUS 4, REMAINDER 0);
-- ...h1, h2, h3
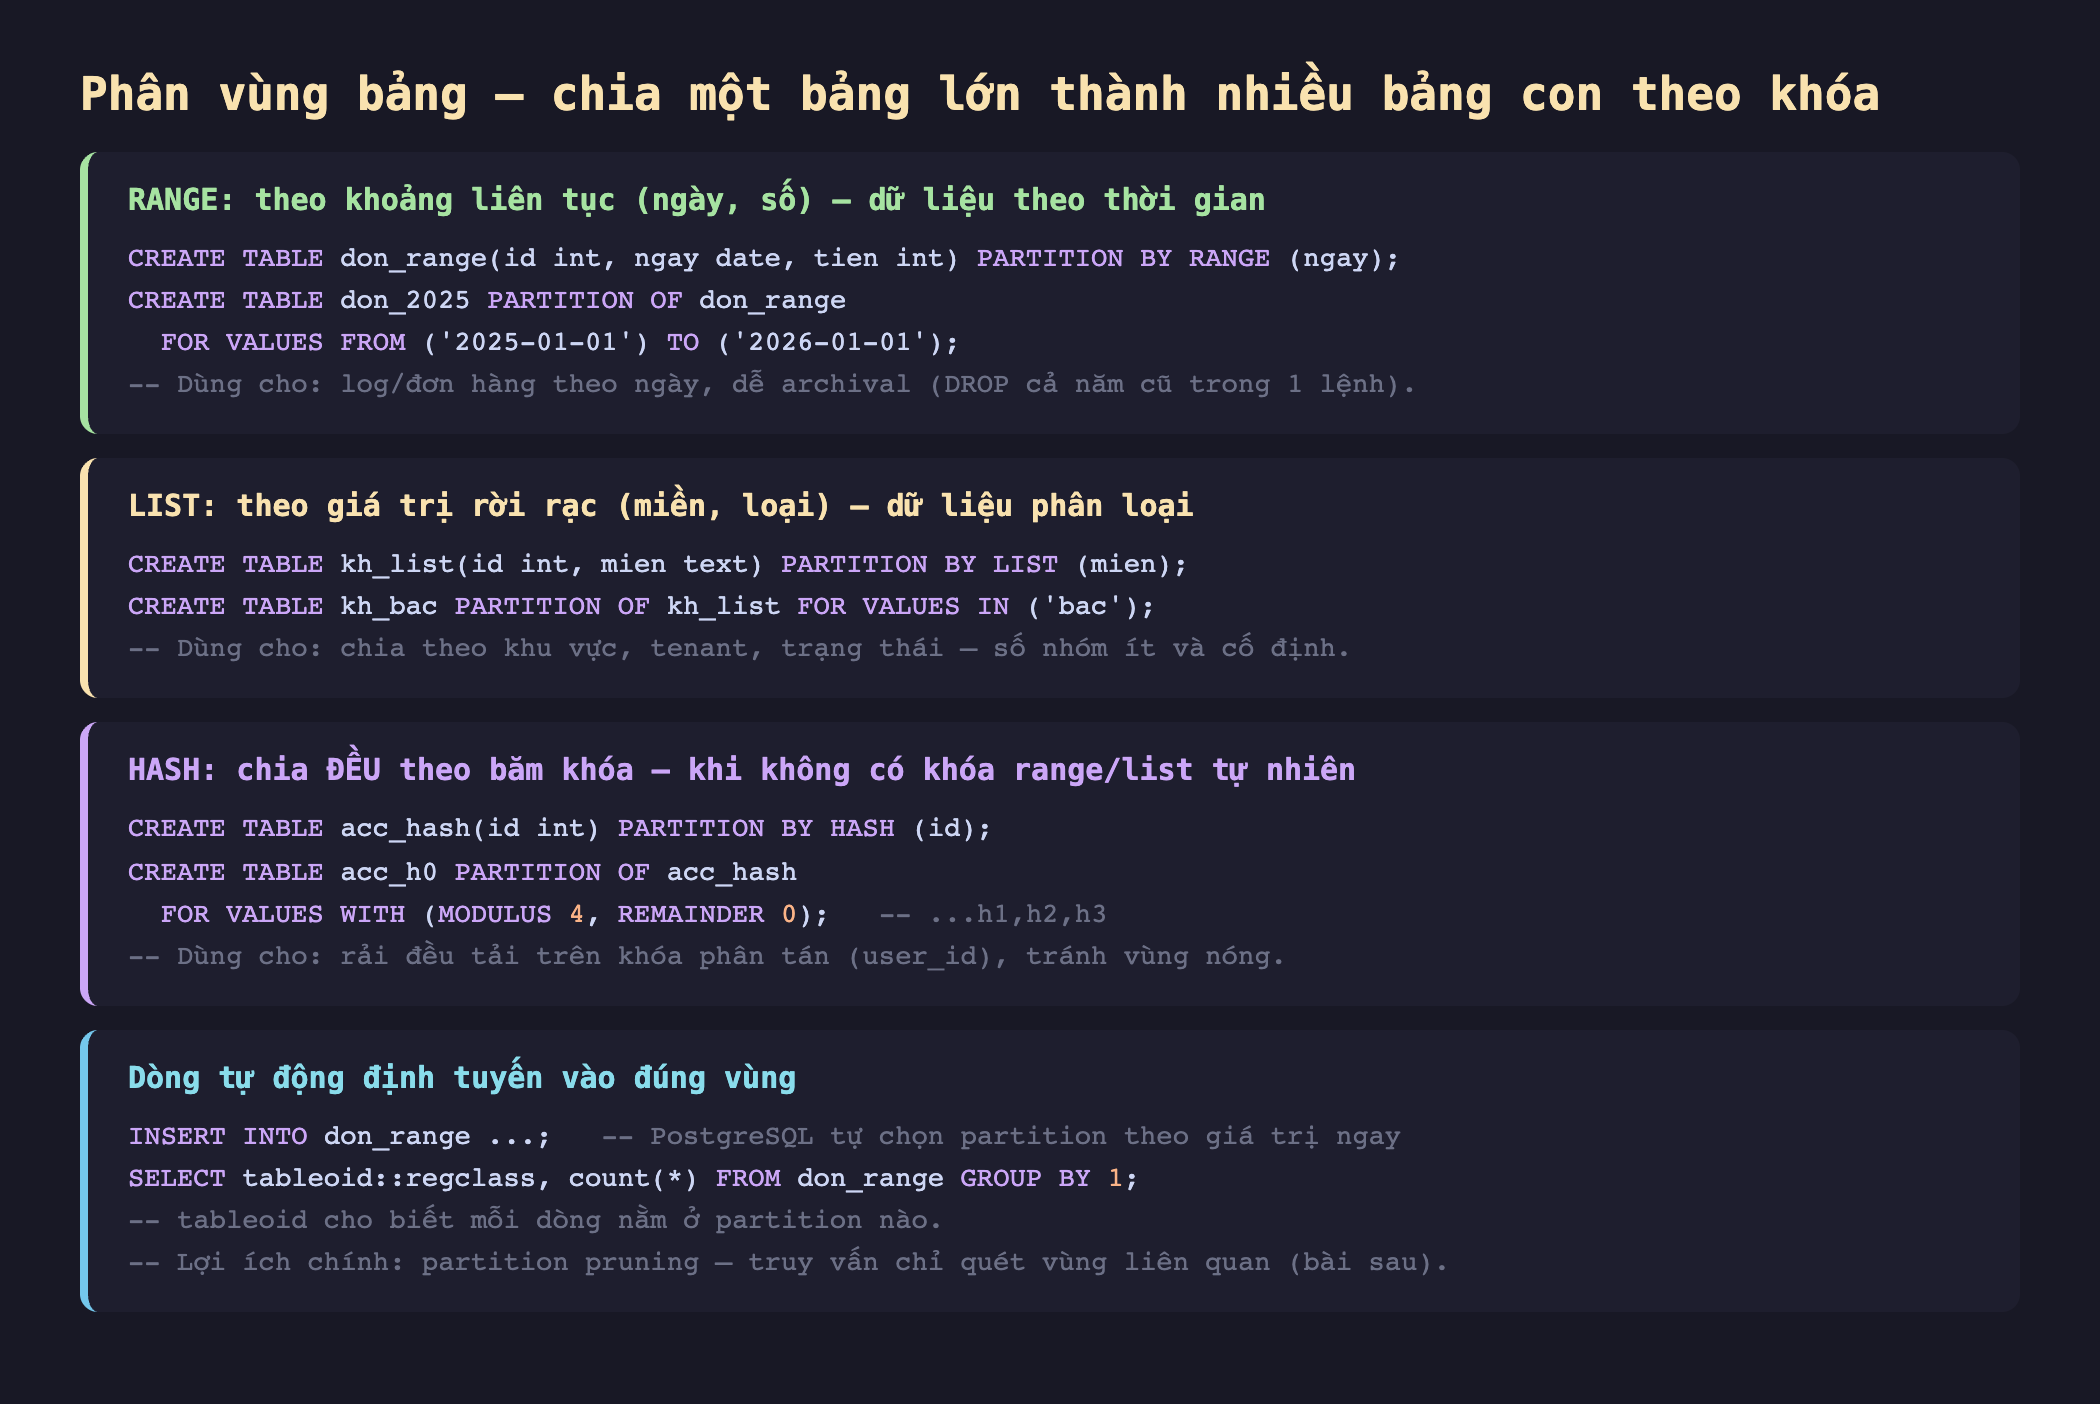
Hình 1: Ba kiểu phân vùng — RANGE (khoảng liên tục, cho dữ liệu thời gian), LIST (giá trị rời rạc, cho dữ liệu phân loại), HASH (chia đều theo băm, cho khóa phân tán). Dòng tự định tuyến vào đúng vùng khi INSERT.
Đo thật: dòng tự định tuyến
Tôi chèn dữ liệu vào cả ba bảng phân vùng và dùng tableoid::regclass để xem mỗi dòng nằm ở partition nào — PostgreSQL tự chọn partition theo giá trị khóa, không cần chỉ định:
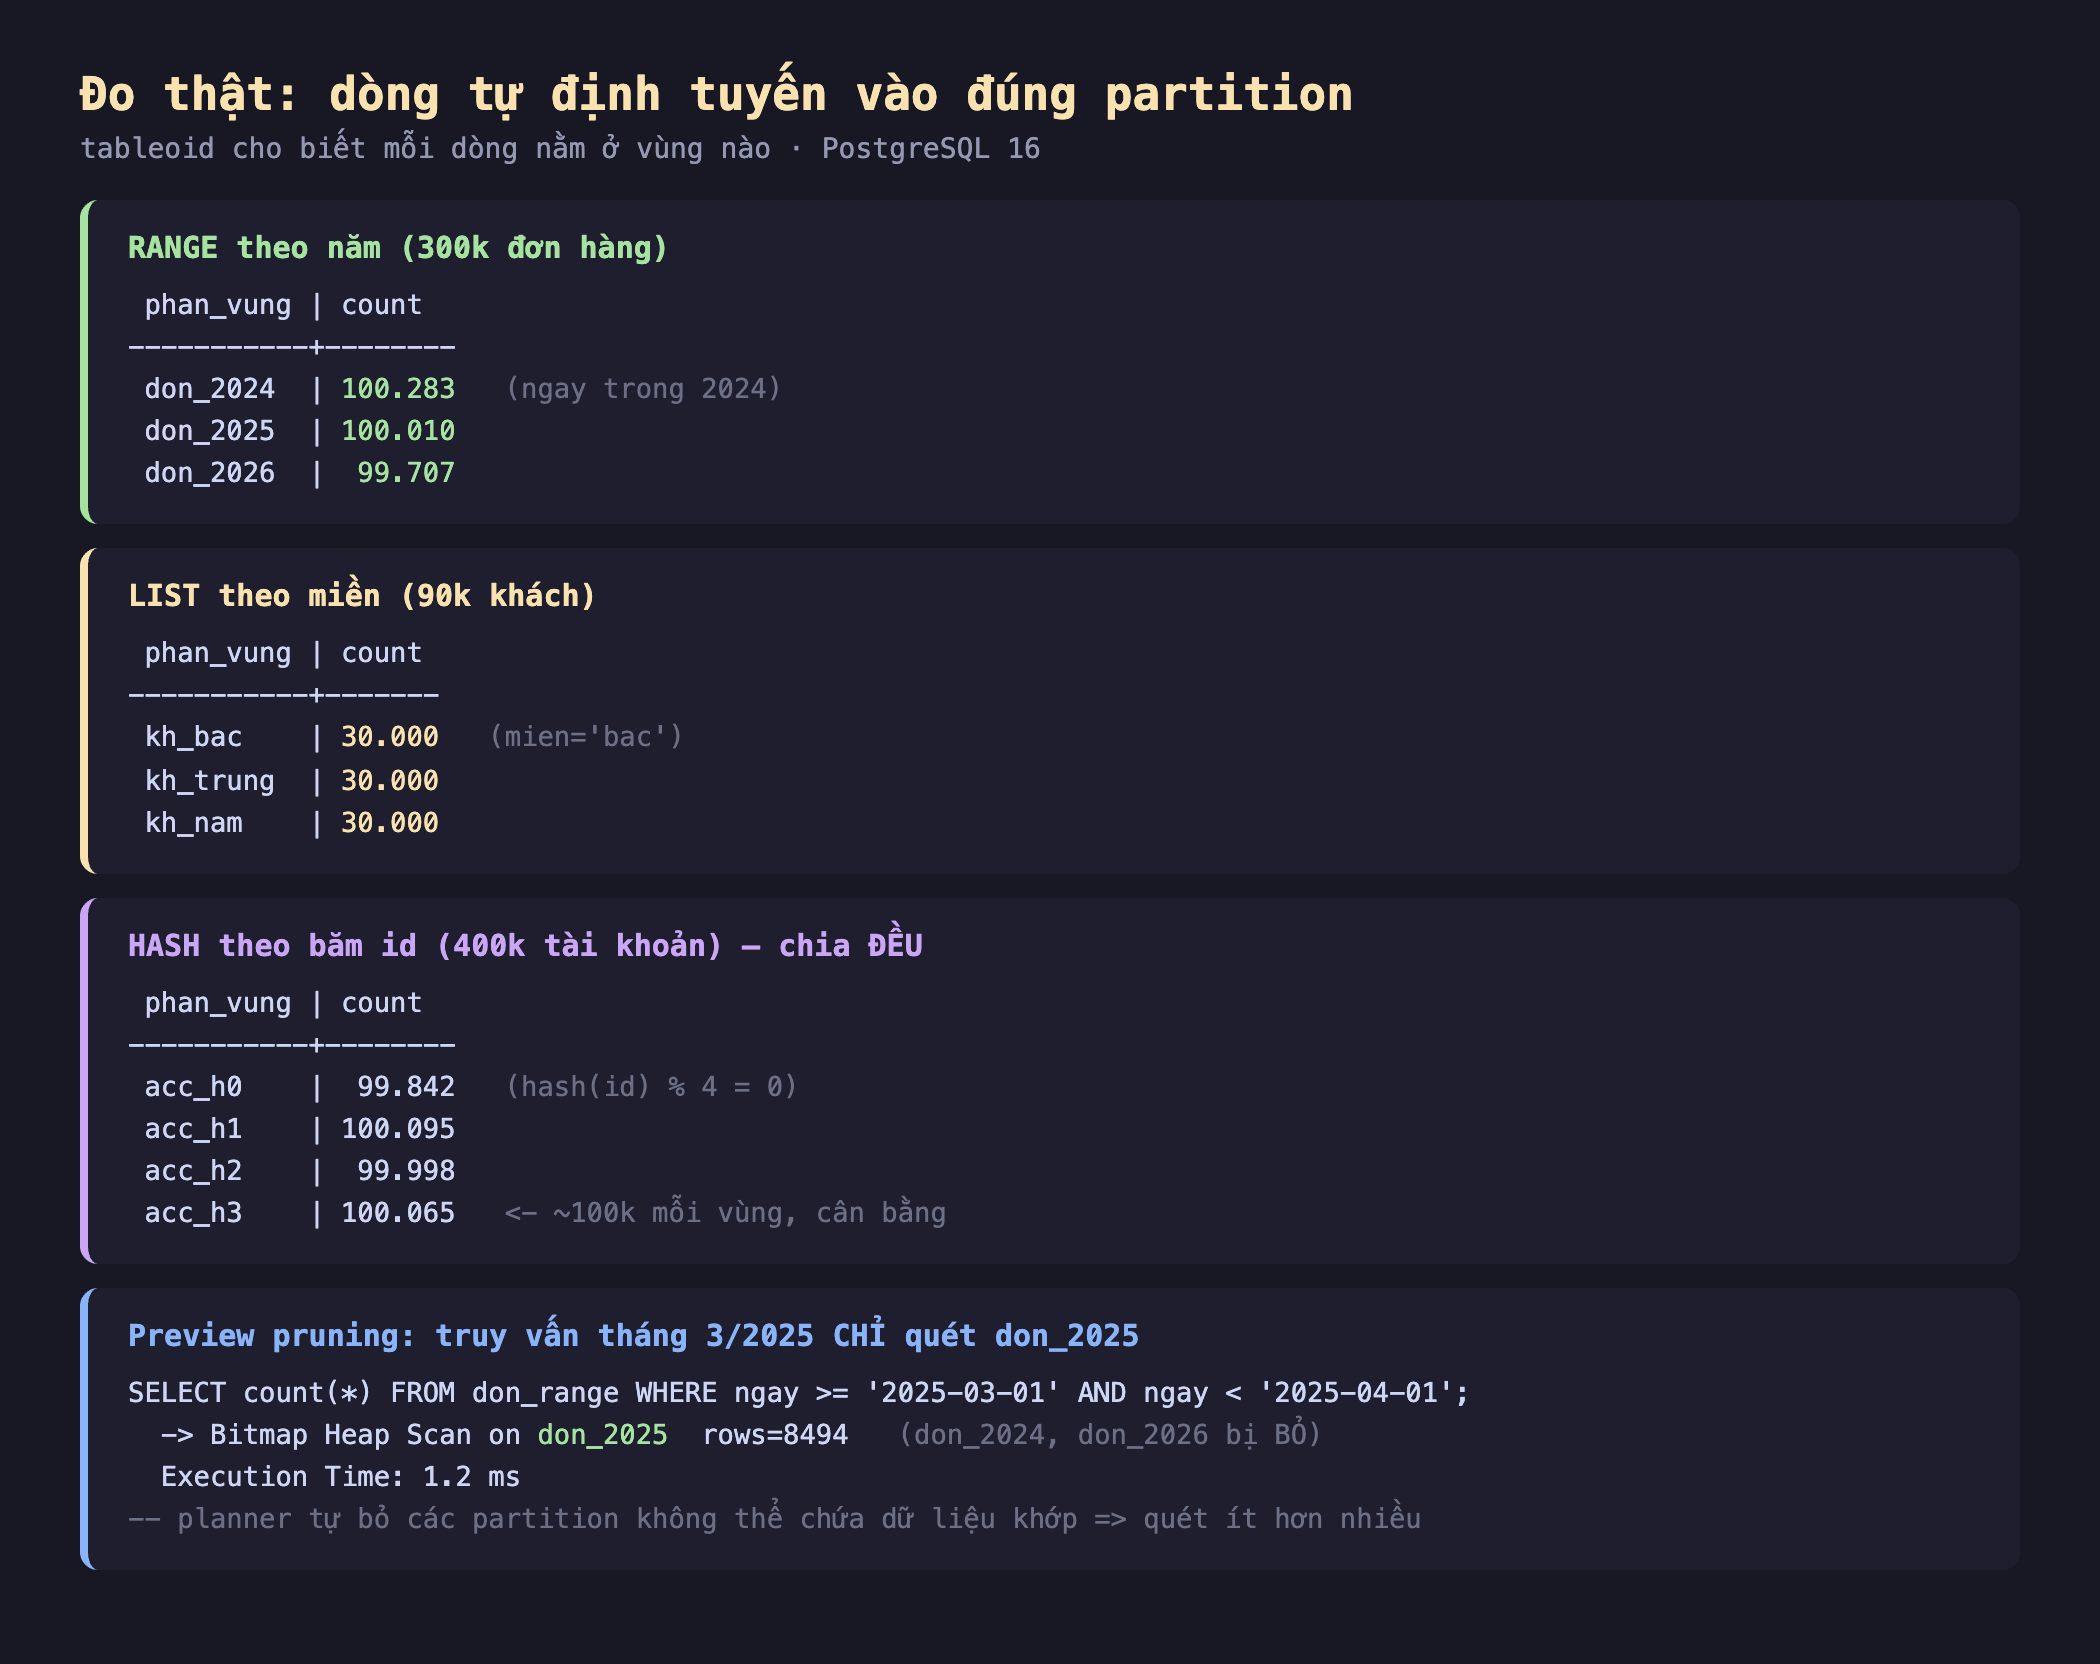
Hình 2: RANGE theo năm: mỗi partition ~100k đơn hàng đúng năm. LIST theo miền: mỗi vùng 30k khách. HASH theo băm id: ~100k mỗi vùng (cân bằng). Truy vấn tháng 3/2025 chỉ quét don_2025 — bỏ qua don_2024 và don_2026.
- RANGE theo năm (300k đơn): don_2024=100.283, don_2025=100.010, don_2026=99.707 — mỗi dòng vào partition của đúng năm
ngay. - LIST theo miền (90k khách): kh_bac=30.000, kh_trung=30.000, kh_nam=30.000 — vào partition của đúng giá trị
mien. - HASH theo băm id (400k tài khoản): acc_h0=99.842, acc_h1=100.095, acc_h2=99.998, acc_h3=100.065 — chia đều ~100k mỗi vùng, đúng mục đích của HASH (cân bằng tải).
Và preview lợi ích chính: truy vấn WHERE ngay >= '2025-03-01' AND ngay < '2025-04-01' chỉ quét don_2025, bỏ qua hoàn toàn don_2024 và don_2026 — đây là partition pruning, chủ đề bài sau.
Chọn kiểu nào
RANGE cho dữ liệu theo thời gian. Log, đơn hàng, sự kiện theo ngày/tháng là ứng dụng kinh điển. Lợi ích lớn nhất ngoài pruning: archival cực rẻ — xóa toàn bộ dữ liệu một năm cũ chỉ là DROP TABLE don_2024 (tức thì, không WAL cho từng dòng), thay vì DELETE hàng triệu dòng (chậm, sinh dead tuple, cần VACUUM).
LIST cho dữ liệu phân loại số nhóm ít, cố định. Chia theo khu vực, tenant, quốc gia, trạng thái. Hợp khi số giá trị phân biệt nhỏ và ổn định; đừng dùng LIST khi số nhóm lên hàng nghìn.
HASH khi không có khóa range/list tự nhiên. Khi bạn chỉ muốn chia một bảng lớn thành N phần đều nhau để giảm kích thước mỗi partition (và song song hóa), HASH theo khóa phân tán (như user_id) là lựa chọn. Nó rải đều, tránh "vùng nóng" — nhưng đổi lại pruning kém hiệu quả hơn với truy vấn khoảng (vì dữ liệu liền kề bị rải khắp các vùng).
Đánh đổi cần cân nhắc
Phân vùng không miễn phí — chỉ đáng khi bảng thật sự lớn. Với bảng vài triệu dòng, phân vùng thường không đáng: overhead quản lý nhiều bảng con, planner phải xét nhiều partition, và một số truy vấn (không lọc theo khóa phân vùng) phải quét tất cả partition. Phân vùng phát huy ở bảng hàng trăm triệu dòng trở lên, hoặc khi cần archival theo thời gian.
Khóa phân vùng phải nằm trong PRIMARY KEY/UNIQUE. PostgreSQL đòi mọi ràng buộc unique trên bảng phân vùng phải chứa cột phân vùng. Nếu bảng cần unique trên một cột không phải khóa phân vùng (ví dụ email khi phân vùng theo ngày), bạn không thể ép unique toàn cục ở tầng bảng — phải xử lý ở tầng ứng dụng hoặc thiết kế lại.
Cần chiến lược tạo partition tương lai. RANGE theo ngày cần partition cho các tháng/năm sắp tới; quên tạo thì INSERT dữ liệu mới sẽ lỗi (không partition nào nhận). Dùng DEFAULT partition làm lưới an toàn, hoặc công cụ tự động tạo partition (pg_partman), hoặc job định kỳ tạo trước.
Ba ý mang về
- PostgreSQL có ba kiểu phân vùng cho ba loại dữ liệu: RANGE (khoảng liên tục — dữ liệu thời gian, dễ archival), LIST (giá trị rời rạc — phân loại theo miền/tenant), HASH (chia đều theo băm — rải tải trên khóa phân tán).
- Dòng tự định tuyến vào đúng vùng theo khóa: đo thật, RANGE ~100k mỗi năm, LIST 30k mỗi miền, HASH cân bằng ~100k mỗi vùng — kiểm bằng
tableoid::regclass; và truy vấn theo khóa chỉ quét partition liên quan (pruning). - Chỉ phân vùng khi bảng thật sự lớn: overhead không đáng với bảng nhỏ; nhớ khóa phân vùng phải nằm trong mọi ràng buộc unique, và cần chiến lược tạo partition tương lai (DEFAULT partition hoặc pg_partman) kẻo INSERT lỗi.
Phần sau ta đo sâu lợi ích cốt lõi vừa xem lướt: Phần sau mổ xẻ partition pruning — cách planner bỏ qua các vùng không thể chứa dữ liệu khớp, pruning lúc lập kế hoạch vs lúc chạy, và vì sao nó là lý do chính để phân vùng.
