Phần 1 và phần 2 đo vì sao Parquet nhỏ và quét nhanh. Nhưng cả hai vẫn giả định đọc toàn bộ file. Phần này đo một cơ chế giúp đọc ít hơn nữa: predicate pushdown. Parquet không lưu dữ liệu thành một khối liền mà chia thành nhiều row group, mỗi khối kèm thống kê min và max của từng cột. Nhờ đó, một truy vấn có điều kiện lọc có thể bỏ qua hoàn toàn những khối mà min/max cho thấy chắc chắn không chứa kết quả, không đọc một byte nội dung nào của chúng. Nhưng cơ chế này có một điều kiện quan trọng mà nhiều người bỏ qua: nó chỉ phát huy khi dữ liệu được sắp xếp theo đúng cột lọc. Bài này đo cả hai mặt bằng cách lọc cùng một phần trăm dữ liệu trên một cột đã sắp xếp và một cột xáo trộn, rồi so số row group phải đọc và thời gian.
Row group kèm min/max cho phép bỏ qua cả khối
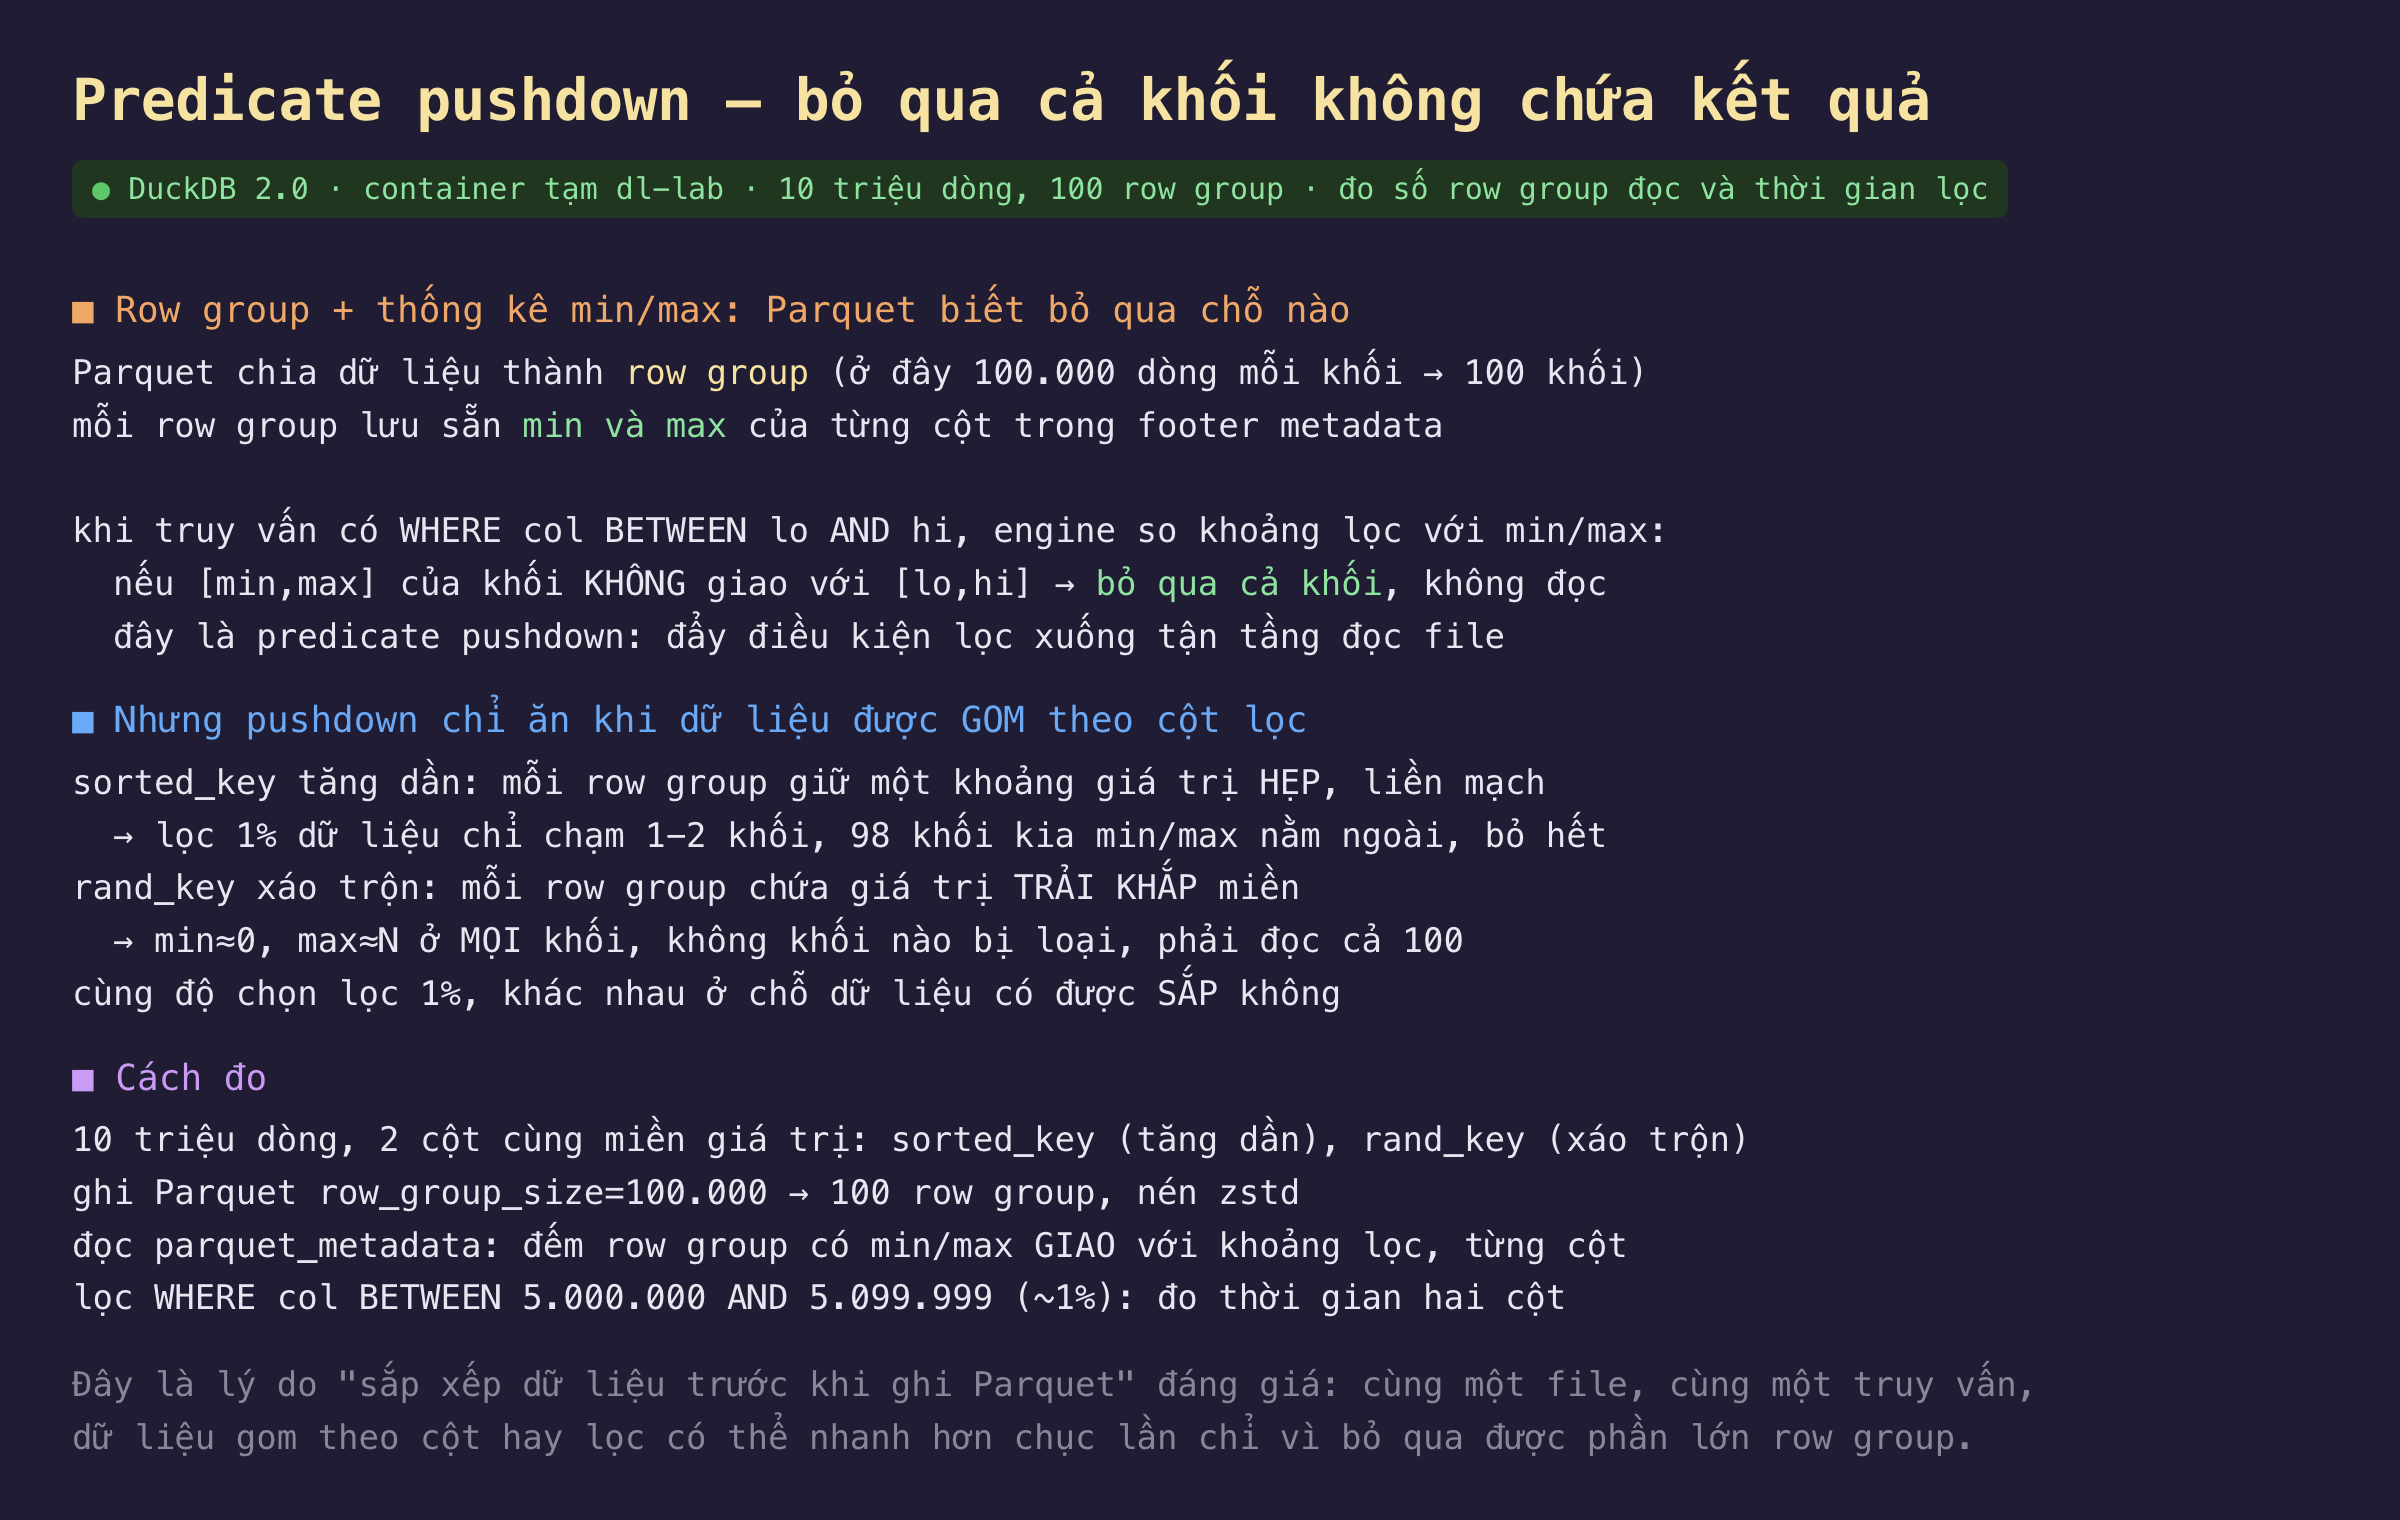
Hình 1: Row group kèm thống kê min/max cho phép bỏ qua khối, nhưng chỉ khi dữ liệu được sắp xếp theo cột lọc.
Parquet chia dữ liệu thành các row group, mỗi khối chứa một số dòng cố định; bài này ghi với kích thước 100.000 dòng mỗi khối, nên mười triệu dòng thành 100 row group. Điều quan trọng là mỗi row group lưu sẵn giá trị min và max của từng cột trong footer metadata của file. Khi một truy vấn có điều kiện dạng WHERE col BETWEEN lo AND hi, engine đọc trước các min/max này và so với khoảng lọc: nếu khoảng [min, max] của một khối không giao với khoảng [lo, hi] của điều kiện, khối đó chắc chắn không chứa dòng nào thỏa mãn, nên engine bỏ qua hoàn toàn, không đọc nội dung. Đây là predicate pushdown: đẩy điều kiện lọc xuống tận tầng đọc file thay vì đọc hết rồi mới lọc ở tầng trên.
Nhưng cơ chế này có một điều kiện mà nhiều người bỏ qua: nó chỉ phát huy khi dữ liệu được gom theo cột lọc. Nếu cột đó được sắp xếp tăng dần, mỗi row group giữ một khoảng giá trị hẹp và liền mạch, ví dụ khối thứ 50 chứa đúng các giá trị từ 5.000.000 đến 5.099.999. Khi đó lọc một phần trăm dữ liệu chỉ chạm một đến hai khối, còn 98 khối kia có min/max nằm ngoài khoảng lọc và bị bỏ hết. Ngược lại, nếu cột bị xáo trộn, mỗi row group chứa giá trị trải khắp miền, nên min xấp xỉ 0 và max xấp xỉ N ở mọi khối; không khối nào bị loại vì khoảng của khối nào cũng giao với khoảng lọc, và engine phải đọc cả 100 khối. Cùng một độ chọn lọc một phần trăm, khác biệt hoàn toàn nằm ở chỗ dữ liệu có được sắp xếp hay không.
Cách đo: tạo mười triệu dòng với hai cột cùng miền giá trị, sorted_key tăng dần và rand_key xáo trộn bằng hash; ghi ra Parquet với row_group_size 100.000 thành 100 row group, nén zstd; đọc parquet_metadata để đếm chính xác số row group có min/max giao với khoảng lọc cho từng cột; rồi chạy WHERE col BETWEEN 5.000.000 AND 5.099.999, tức một phần trăm dữ liệu, và đo thời gian trên cả hai cột.
Đo thật: lọc 1% chỉ đọc 2/100 khối khi đã sắp xếp
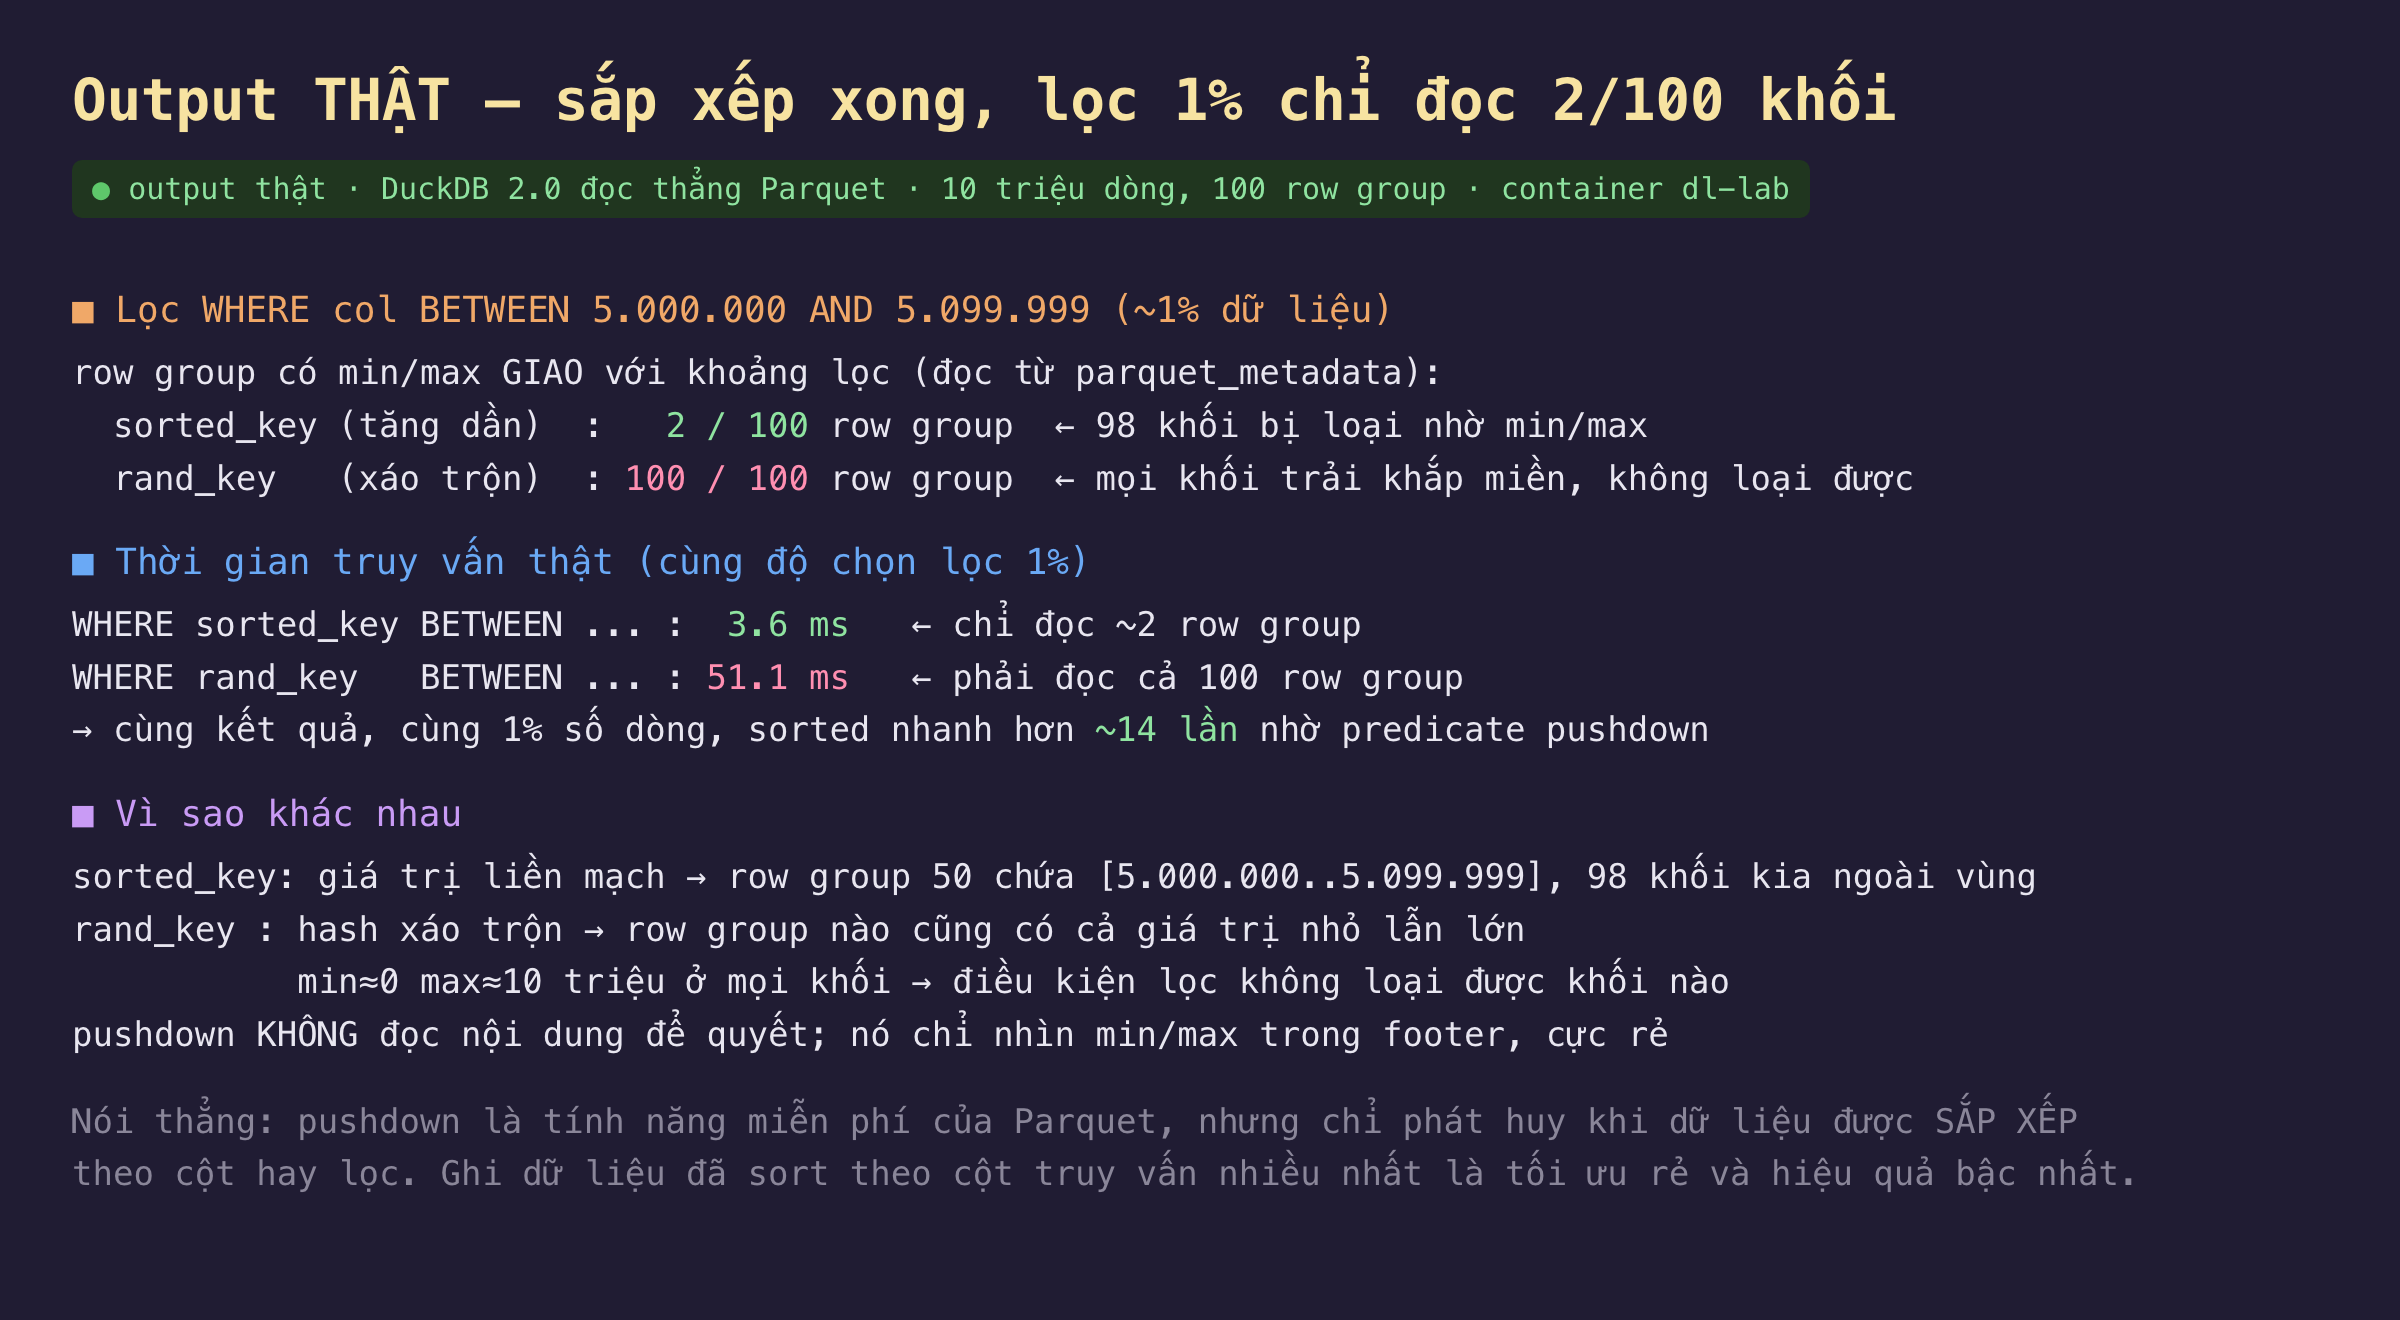
Hình 2: Cùng độ chọn lọc 1%, cột sắp xếp chỉ đọc 2/100 row group và nhanh hơn 14 lần so với cột xáo trộn.
| phép đo | sorted_key (sắp xếp) | rand_key (xáo trộn) |
|---|---|---|
| row group giao với khoảng lọc | 2 / 100 | 100 / 100 |
| thời gian lọc 1% | 3,6 ms | 51,1 ms |
Lọc một phần trăm dữ liệu chỉ chạm 2 trong 100 row group khi dữ liệu đã sắp xếp. Đọc trực tiếp từ parquet_metadata, với cột sorted_key tăng dần, chỉ 2 trong 100 row group có khoảng min/max giao với khoảng lọc 5.000.000 đến 5.099.999. Đúng như kỳ vọng: khoảng lọc rộng 100.000 giá trị, mỗi row group chứa 100.000 giá trị liền mạch, nên khoảng lọc nằm gọn trong một đến hai khối liền kề. 98 khối còn lại có min/max hoàn toàn nằm ngoài khoảng lọc và bị loại. Với cột rand_key xáo trộn, cả 100 trong 100 row group đều giao với khoảng lọc, vì mỗi khối chứa giá trị trải khắp từ gần 0 tới gần mười triệu, nên khoảng của khối nào cũng bao trùm khoảng lọc và không khối nào loại được.
Chênh lệch số khối đọc dẫn thẳng tới chênh lệch thời gian 14 lần. Truy vấn WHERE sorted_key BETWEEN ... mất 3,6 ms, trong khi WHERE rand_key BETWEEN ... mất 51,1 ms, dù cả hai trả về cùng số dòng, đúng một phần trăm dữ liệu. Khác biệt mười bốn lần đến thẳng từ việc truy vấn trên cột sắp xếp chỉ phải đọc và giải mã khoảng hai row group, còn truy vấn trên cột xáo trộn phải đọc cả 100 khối rồi mới lọc bỏ 99 phần trăm số dòng. Điểm đáng chú ý: cùng một file Parquet, cùng một câu lệnh về mặt cú pháp, cùng độ chọn lọc, nhưng hiệu năng chênh nhau cả bậc chỉ vì dữ liệu được sắp xếp hay không theo cột đang lọc.
Pushdown cực rẻ vì chỉ nhìn metadata, không đọc nội dung. Cơ chế này không tốn công đọc dữ liệu để quyết định bỏ khối nào; nó chỉ đọc min/max trong footer của file, một lượng metadata rất nhỏ so với nội dung các cột. Với sorted_key, engine nhìn thấy row group thứ 50 có khoảng chứa trọn khoảng lọc và 98 khối kia nằm ngoài, rồi chỉ đọc nội dung của hai khối giao. Với rand_key, nó thấy mọi khối đều có min gần 0 và max gần mười triệu nên không thể loại khối nào và buộc phải đọc hết. Chi phí quyết định là như nhau trong cả hai trường hợp, gần như bằng không; cái khác là kết quả quyết định cho phép bỏ qua được bao nhiêu.
Đánh đổi cần cân nhắc
Sắp xếp dữ liệu theo cột lọc thường xuyên nhất trước khi ghi. Đây là kết luận thực hành quan trọng nhất. Nếu một bảng hay bị lọc theo thời gian, sắp xếp theo dấu thời gian trước khi ghi Parquet khiến mọi truy vấn khoảng thời gian chỉ đọc đúng các row group trong khoảng đó. Chi phí sắp xếp trả một lần lúc ghi, lợi ích thu về mọi lần đọc. Nhiều hệ thống đi xa hơn bằng cách phân vùng theo một cột thô (ví dụ ngày) rồi sắp xếp theo cột tinh trong mỗi phân vùng, chủ đề của phần về partitioning sau. Điểm cốt lõi: thứ tự ghi dữ liệu là một quyết định hiệu năng, không phải chuyện ngẫu nhiên.
Chỉ sắp xếp được theo một cột; chọn cột lọc nhiều nhất. Dữ liệu chỉ có một thứ tự vật lý, nên pushdown mạnh nhất chỉ cho một cột. Nếu truy vấn lọc theo nhiều cột khác nhau, phải chọn cột nào được lọc thường xuyên và chọn lọc nhất để sắp xếp theo, chấp nhận các cột khác không được hưởng pushdown tốt. Một số định dạng và công cụ hỗ trợ sắp xếp đa cột hoặc đường cong lấp đầy không gian như Z-order để cân bằng nhiều cột, nhưng đó là đánh đổi phức tạp hơn. Với phần lớn trường hợp, xác định đúng một cột lọc chủ đạo và sắp xếp theo nó là đủ cho phần lớn lợi ích.
Phạm vi đo. Bài đo pushdown trên điều kiện khoảng của một cột số, với kích thước row group 100.000. Kích thước row group là một đánh đổi: khối nhỏ cho pushdown mịn hơn nhưng tăng chi phí metadata và giảm hiệu quả nén; khối lớn thì ngược lại. Bài không quét qua các kích thước row group khác nhau để tìm điểm cân bằng. Cũng chưa đo pushdown trên điều kiện bằng với cột chuỗi, nơi min/max vẫn áp dụng nhưng phân bố khác, và chưa đo bloom filter, một cơ chế pushdown bổ sung cho điều kiện bằng trên cột high-cardinality.
Ba ý mang về
- Parquet lưu min/max mỗi cột cho từng row group, cho phép bỏ qua cả khối. Điều kiện lọc so với min/max trong footer; khối không giao bị loại mà không đọc nội dung, cực rẻ.
- Pushdown chỉ mạnh khi dữ liệu được sắp xếp theo cột lọc. Cột sắp xếp: lọc 1% chỉ chạm 2/100 row group, 3,6 ms; cột xáo trộn: chạm 100/100, 51,1 ms, chậm hơn 14 lần.
- Thứ tự ghi dữ liệu là quyết định hiệu năng. Sắp xếp theo cột lọc thường xuyên nhất trước khi ghi; chi phí trả một lần, lợi ích thu mọi lần đọc.
Nguồn
- Apache Parquet — File Format, row group, column chunk và page: https://parquet.apache.org/docs/file-format/
- Apache Parquet — Column Statistics, min/max trong metadata: https://parquet.apache.org/docs/file-format/metadata/
- DuckDB — Parquet Metadata, hàm
parquet_metadatavà pushdown: https://duckdb.org/docs/data/parquet/metadata - DuckDB — Query Optimization, filter pushdown và zonemap: https://duckdb.org/docs/guides/performance/indexing
- Apache Parquet — Bloom Filters, pushdown cho điều kiện bằng: https://parquet.apache.org/docs/file-format/bloomfilter/
Phần sau đo kỹ hơn một lợi thế đã chạm tới ở phần 1: column projection. Khi truy vấn chỉ cần vài cột trong bảng rộng hàng chục cột, định dạng cột chỉ đọc đúng những cột đó. Xem thời gian và I/O thay đổi thế nào theo số cột chọn, và vì sao SELECT * là phản mẫu kinh điển trên dữ liệu cột.
