Cụm từ "dữ liệu lớn" thường gợi tới cụm máy chủ, Spark, Hadoop. Nhưng rất nhiều bài toán phân tích vài triệu tới vài trăm triệu dòng chạy gọn trên một máy, và yếu tố quyết định hiệu năng không phải số máy mà là định dạng lưu dữ liệu. Sê-ri này đo thật từng khía cạnh của việc xử lý dữ liệu lớn bằng định dạng cột Parquet và công cụ phân tích DuckDB, bắt đầu từ câu hỏi nền tảng nhất: vì sao một file Parquet nhỏ hơn nhiều lần và quét nhanh hơn hàng chục lần so với cùng dữ liệu đó ở dạng CSV hay JSON. Không lý thuyết suông: bài này sinh năm triệu dòng sự kiện, ghi ra ba định dạng, rồi đo kích thước file và thời gian truy vấn thật.
Định dạng hàng và định dạng cột xếp byte khác nhau
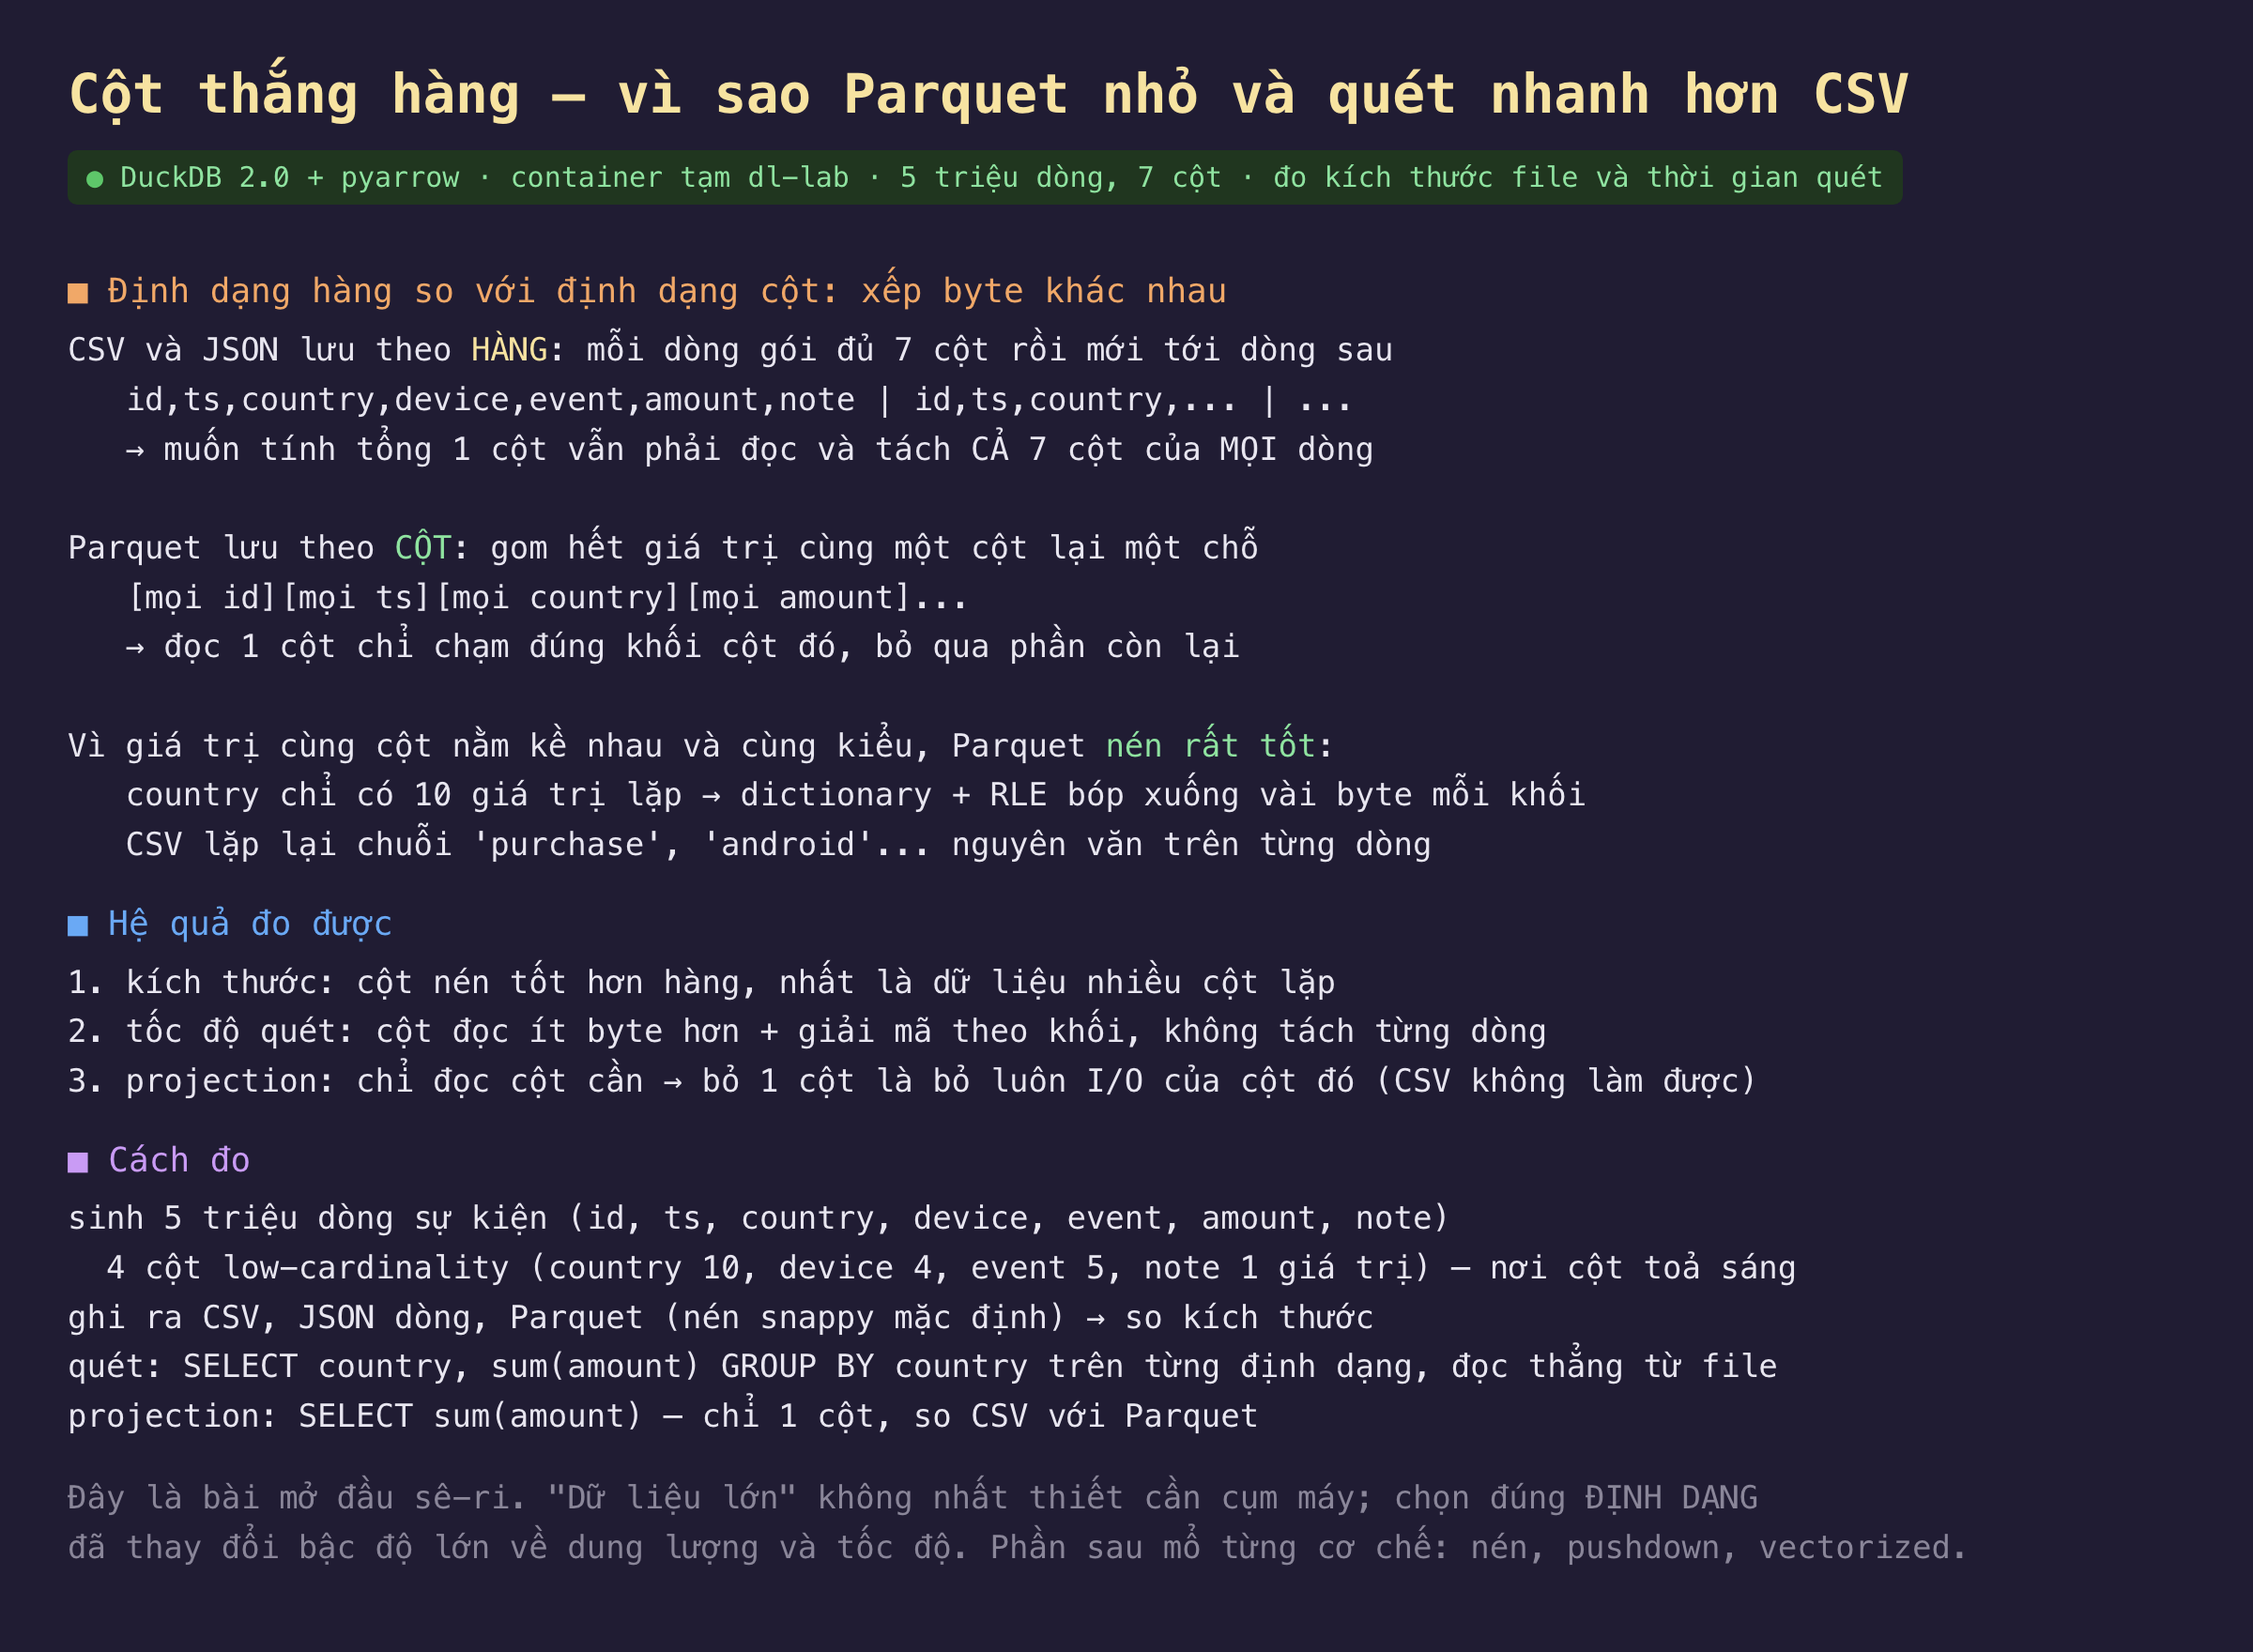
Hình 1: CSV và JSON lưu theo hàng, Parquet lưu theo cột; vì sao cách xếp byte đó khiến Parquet nén tốt và quét nhanh hơn.
CSV và JSON lưu dữ liệu theo hàng: mỗi dòng gói đủ mọi cột lại với nhau rồi mới tới dòng tiếp theo. Một bảng sự kiện bảy cột gồm id, dấu thời gian, quốc gia, thiết bị, loại sự kiện, số tiền và ghi chú sẽ được viết thành từng dòng hoàn chỉnh nối đuôi nhau. Cách này tiện khi ghi và khi đọc nguyên một bản ghi, nhưng dở cho phân tích: muốn tính tổng chỉ một cột, chương trình vẫn phải đọc và tách cả bảy cột của mọi dòng, vì các byte của cột cần nằm rải rác, cách nhau bởi dữ liệu của sáu cột kia.
Parquet lưu theo cột: nó gom hết giá trị của cùng một cột lại một chỗ, hết khối id tới khối dấu thời gian, tới khối quốc gia, tới khối số tiền. Cách xếp này đổi hoàn toàn kinh tế của việc đọc. Khi chỉ cần một cột, chương trình chạm đúng khối của cột đó và bỏ qua toàn bộ phần còn lại, không tốn một byte I/O nào cho các cột không dùng. Quan trọng không kém, vì các giá trị cùng một cột nằm kề nhau và cùng kiểu, Parquet nén chúng rất tốt: cột quốc gia chỉ có mười giá trị lặp đi lặp lại, nên kỹ thuật dictionary và run-length encoding bóp nó xuống còn vài byte cho mỗi khối. CSV thì ngược lại, lặp lại nguyên văn chuỗi "purchase", "android" trên từng dòng, tốn chỗ cho mọi lần xuất hiện.
Ba hệ quả đo được từ khác biệt này. Thứ nhất, kích thước: định dạng cột nén tốt hơn định dạng hàng, nhất là với dữ liệu có nhiều cột lặp giá trị. Thứ hai, tốc độ quét: định dạng cột đọc ít byte hơn và giải mã theo khối thay vì tách từng dòng. Thứ ba, column projection: chỉ đọc đúng cột cần, nên bỏ một cột là bỏ luôn chi phí I/O của cột đó, điều CSV không làm được. Để đo, bài sinh năm triệu dòng sự kiện với bốn cột low-cardinality (quốc gia mười giá trị, thiết bị bốn, loại sự kiện năm, ghi chú một), ghi ra CSV, JSON dòng và Parquet nén snappy mặc định, rồi so kích thước; chạy SELECT country, sum(amount) GROUP BY country đọc thẳng từ từng file; và chạy SELECT sum(amount) chỉ một cột để so CSV với Parquet.
Đo thật: Parquet nhỏ hơn 4,6 lần, quét nhanh hơn 12 lần
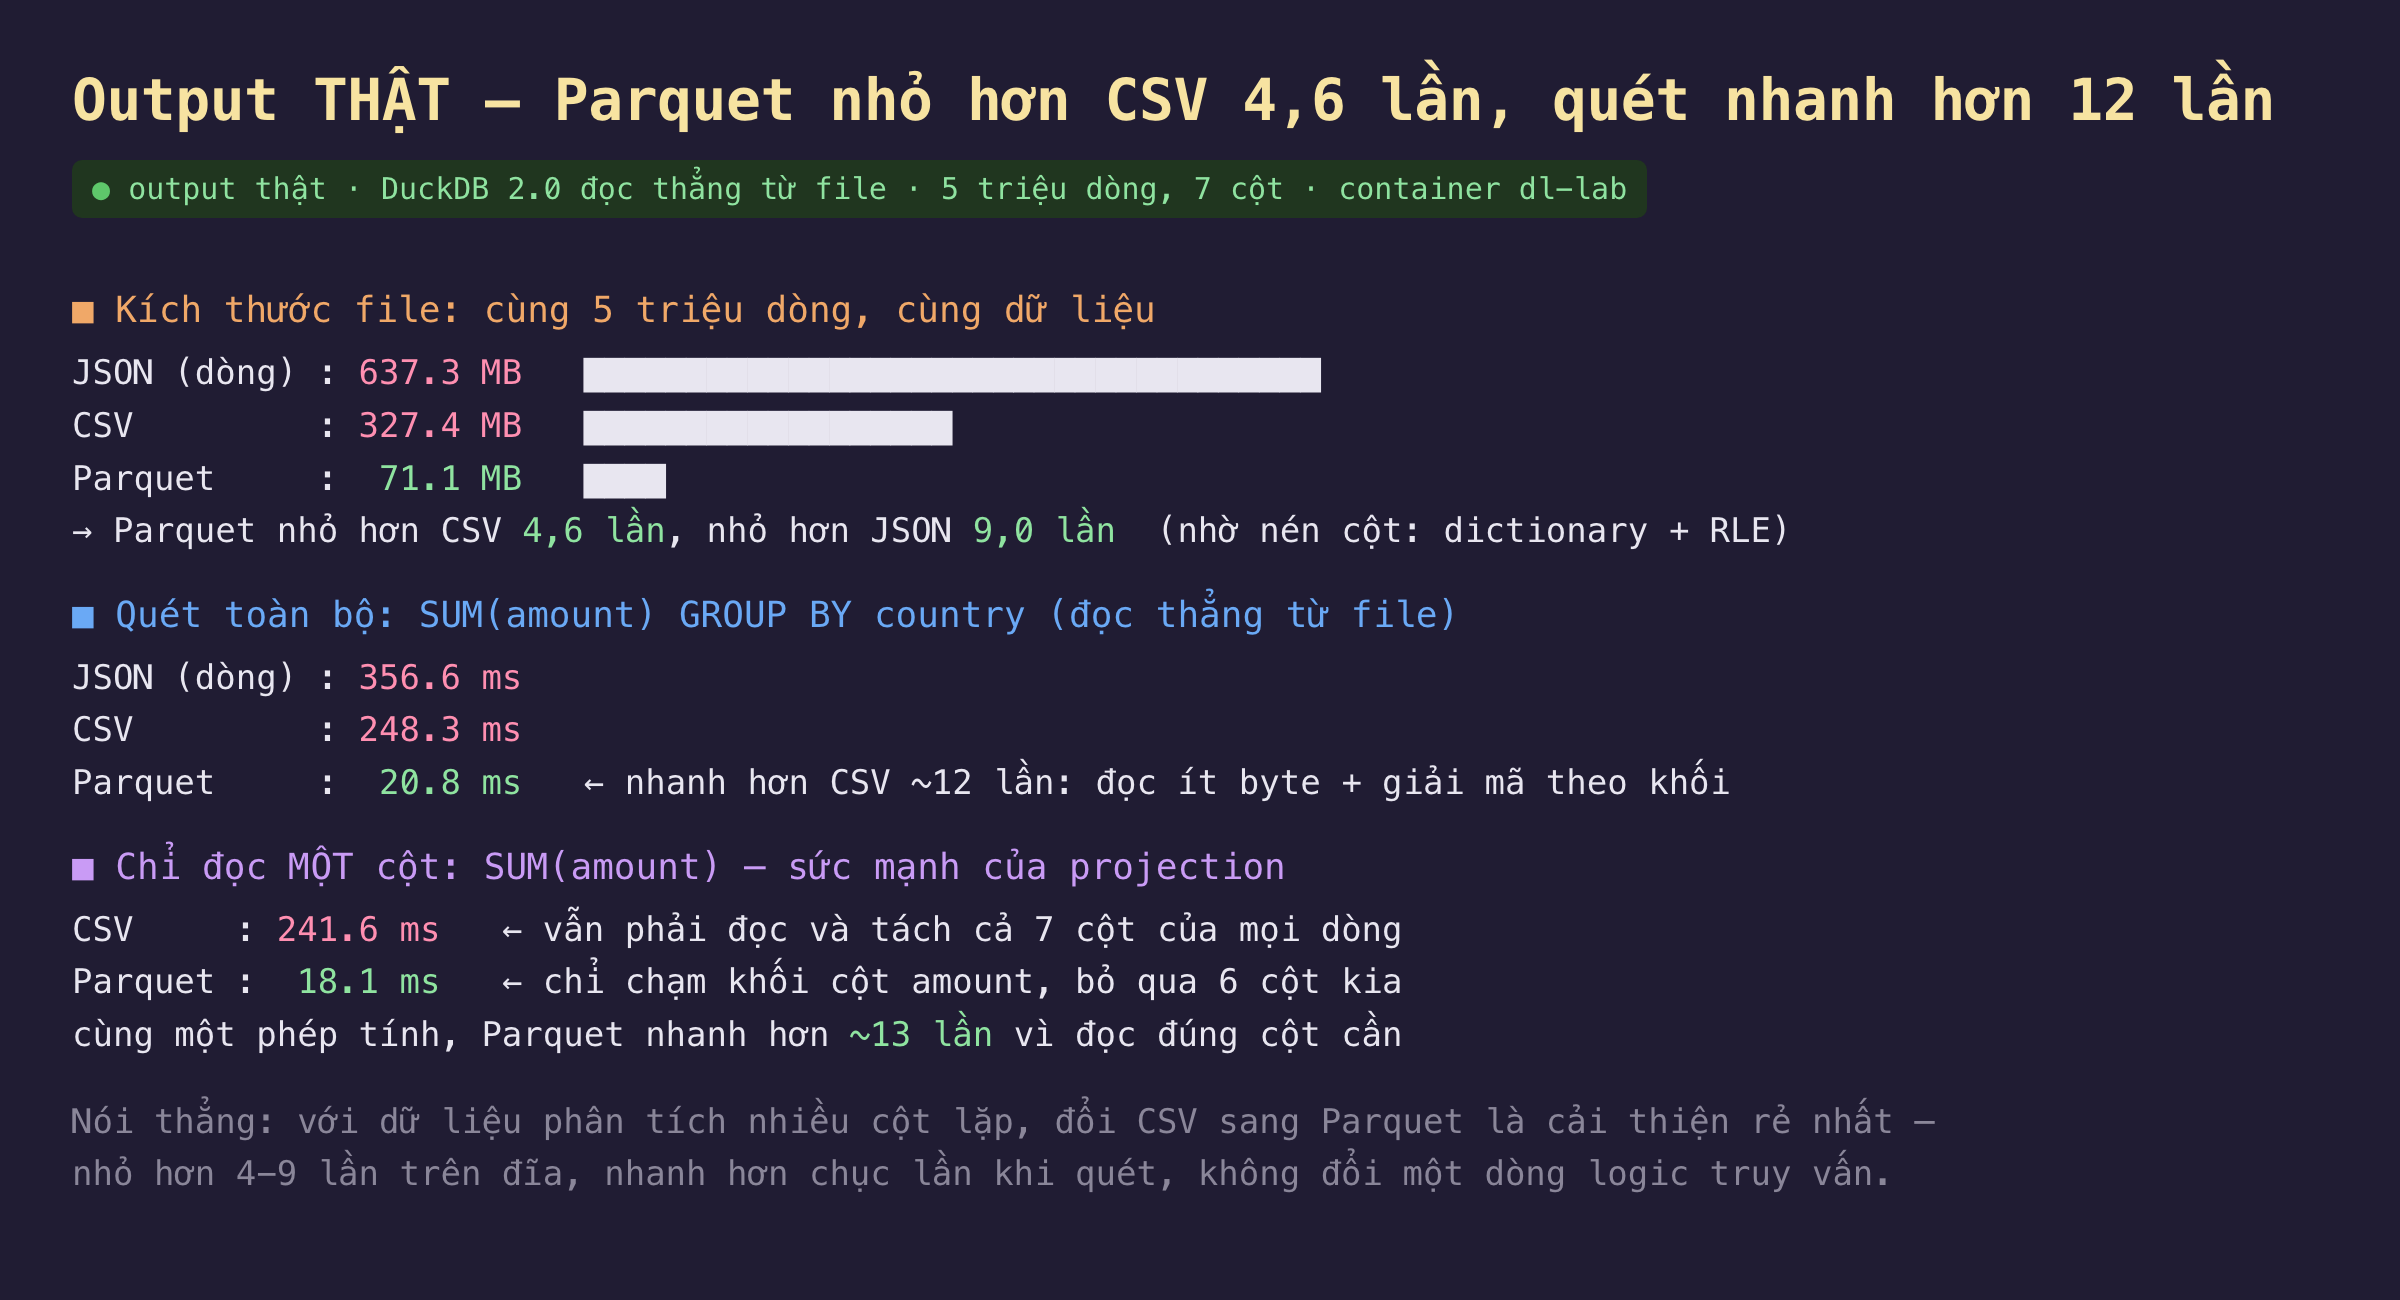
Hình 2: Kích thước và thời gian quét thật trên cùng năm triệu dòng; Parquet thắng cả về dung lượng lẫn tốc độ.
| phép đo | CSV | JSON (dòng) | Parquet |
|---|---|---|---|
| kích thước file | 327,4 MB | 637,3 MB | 71,1 MB |
| quét SUM theo country | 248,3 ms | 356,6 ms | 20,8 ms |
| đọc một cột SUM(amount) | 241,6 ms | — | 18,1 ms |
Cùng năm triệu dòng, Parquet nặng 71 MB còn CSV 327 MB và JSON 637 MB. Ba file chứa đúng cùng dữ liệu, chỉ khác cách xếp byte. Parquet nhỏ hơn CSV 4,6 lần và nhỏ hơn JSON 9 lần. Khác biệt này đến thẳng từ nén theo cột: bốn cột low-cardinality trong dữ liệu, nhất là quốc gia, thiết bị, loại sự kiện và ghi chú, lặp lại rất ít giá trị khác nhau, nên dictionary encoding thay mỗi giá trị bằng một số nhỏ và run-length encoding gộp các giá trị giống nhau liên tiếp. CSV phải viết lại nguyên văn mỗi chuỗi trên từng dòng, và JSON còn tốn hơn vì lặp cả tên trường trong mỗi bản ghi. Với dữ liệu phân tích thật, nơi nhiều cột là hạng mục lặp đi lặp lại, khoảng cách này còn lớn hơn.
Quét tổng theo nhóm trên Parquet mất 20,8 ms, so với 248 ms của CSV. Chạy SELECT country, sum(amount) GROUP BY country đọc thẳng từ từng file, Parquet nhanh hơn CSV khoảng mười hai lần và nhanh hơn JSON mười bảy lần. Lý do kép: Parquet đọc ít byte hơn hẳn vì file nhỏ hơn và vì chỉ cần hai cột quốc gia và số tiền; đồng thời nó giải mã theo khối cột đã nén thay vì phân tích cú pháp từng dòng văn bản như CSV và JSON. Phân tích cú pháp văn bản là phần đắt nhất khi đọc CSV: mỗi dòng phải tách theo dấu phẩy, chuyển chuỗi thành số, xử lý dấu ngoặc. Parquet bỏ qua toàn bộ chuyện đó vì dữ liệu đã ở dạng nhị phân theo cột.
Đọc một cột cho thấy sức mạnh thật của projection. Phép đo cuối chạy SELECT sum(amount), chỉ cần một cột. Parquet mất 18,1 ms, gần như không đổi so với truy vấn hai cột ở trên, vì nó chỉ chạm đúng khối cột số tiền và bỏ qua sáu cột kia hoàn toàn. CSV mất 241,6 ms, gần bằng truy vấn trước, vì dù chỉ cần một cột nó vẫn phải đọc và tách cả bảy cột của mọi dòng để lấy ra được cột cần. Cùng một phép tính, Parquet nhanh hơn khoảng mười ba lần, hoàn toàn nhờ đọc đúng cột cần. Đây là tính chất mà định dạng hàng về bản chất không thể có, và là lý do cốt lõi khiến kho dữ liệu phân tích dùng định dạng cột.
Đánh đổi cần cân nhắc
Parquet cho phân tích, không thay thế hàng cho ghi từng bản ghi. Lợi thế của Parquet đến từ việc đọc nhiều dòng cho một ít cột, đúng hình phân tích. Với workload giao dịch, nơi hệ thống đọc và ghi từng bản ghi đầy đủ một lúc, định dạng hàng của cơ sở dữ liệu quan hệ vẫn phù hợp hơn. Parquet cũng không phải định dạng để ghi thêm liên tục từng dòng: nó ghi theo lô, đóng file thành các row group, và không sửa tại chỗ. Mô hình điển hình là hệ thống giao dịch dùng cơ sở dữ liệu hàng cho ghi, rồi xuất định kỳ sang Parquet cho phân tích, mỗi định dạng làm đúng việc nó giỏi.
Số đo phụ thuộc đặc tính dữ liệu, cột lặp nhiều thì cách biệt càng lớn. Khoảng cách 4,6 lần về kích thước ở đây là do dữ liệu có nhiều cột low-cardinality, nơi nén cột phát huy mạnh nhất. Dữ liệu toàn cột giá trị duy nhất, như id ngẫu nhiên hay văn bản tự do dài, nén kém hơn và khoảng cách thu hẹp lại, dù Parquet vẫn thường thắng nhờ không tốn chi phí phân tích cú pháp. Ngược lại, dữ liệu thật trong kho phân tích thường còn nhiều cột lặp hơn ví dụ này, nên cách biệt thực tế hay lớn hơn con số đo được. Điểm cần nhớ: lợi ích của Parquet không cố định, nó tỉ lệ với mức lặp của dữ liệu.
Phạm vi đo. Bài đo kích thước và thời gian quét trên một máy với DuckDB, không đo chi phí ghi ra Parquet, vốn tốn CPU hơn ghi CSV vì phải nén và sắp xếp theo cột. Dùng snappy mặc định; phần sau sẽ đo từng codec nén. Chưa đo predicate pushdown nhờ thống kê row group, chưa đo đọc Parquet song song nhiều file, và chưa đo trường hợp dữ liệu toàn cột high-cardinality, những chủ đề của các phần tiếp theo trong sê-ri.
Ba ý mang về
- Định dạng cột nhỏ hơn định dạng hàng nhiều lần với dữ liệu phân tích. Cùng năm triệu dòng: Parquet 71 MB so với CSV 327 MB (4,6 lần) và JSON 637 MB (9 lần), nhờ dictionary và RLE nén các cột lặp.
- Quét theo cột nhanh hơn chục lần vì đọc ít byte và không phân tích văn bản. SUM theo nhóm mất 20,8 ms trên Parquet so với 248 ms CSV; Parquet giải mã khối nhị phân thay vì tách từng dòng.
- Column projection là lợi thế định dạng hàng không có. Đọc một cột trên Parquet mất 18 ms so với 242 ms CSV; Parquet chạm đúng cột cần, CSV phải đọc cả bảy cột của mọi dòng.
Nguồn
- Apache Parquet — tài liệu chính thức về định dạng file và mô hình lưu trữ cột: https://parquet.apache.org/docs/
- DuckDB — Reading and Writing Parquet Files, đọc Parquet trực tiếp: https://duckdb.org/docs/data/parquet/overview
- DuckDB — Querying CSV Files và JSON, so sánh đọc các định dạng: https://duckdb.org/docs/data/csv/overview
- Apache Parquet — Encodings, dictionary và RLE: https://parquet.apache.org/docs/file-format/data-pages/encodings/
- Daniel Abadi và cộng sự — The Design and Implementation of Modern Column-Oriented Database Systems: https://www.cs.umd.edu/~abadi/papers/abadi-column-stores.pdf
Phần sau mổ xẻ tầng nén của Parquet: dictionary, run-length encoding, và các codec snappy với zstd. Xem từng tầng đóng góp bao nhiêu vào tỉ lệ nén, đo kích thước file với mỗi codec trên cùng dữ liệu, và khi nào zstd đáng đánh đổi CPU để lấy file nhỏ hơn.
