Phần 1 cho thấy Parquet nhỏ hơn CSV nhiều lần, và quy công cho "nén cột". Nhưng "nén" trong Parquet thực ra là hai cơ chế xếp chồng, không phải một, và hiểu tách bạch chúng là chìa khóa để chọn đúng cấu hình. Tầng thứ nhất là encoding theo cột, tự động theo đặc tính dữ liệu, gồm dictionary và run-length encoding. Tầng thứ hai là codec nén byte, chọn được, như snappy, gzip hay zstd, chạy trên kết quả của tầng một. Bài này đo riêng từng tầng: so bốn codec về kích thước, thời gian ghi và thời gian quét trên cùng năm triệu dòng, rồi tách riêng một cột lặp và một cột duy nhất để thấy dictionary encoding ăn thua thế nào theo cardinality. Kết quả có một người thắng rõ ràng và một hiểu lầm phổ biến được gỡ.
Parquet nén hai tầng, đừng nhầm là một
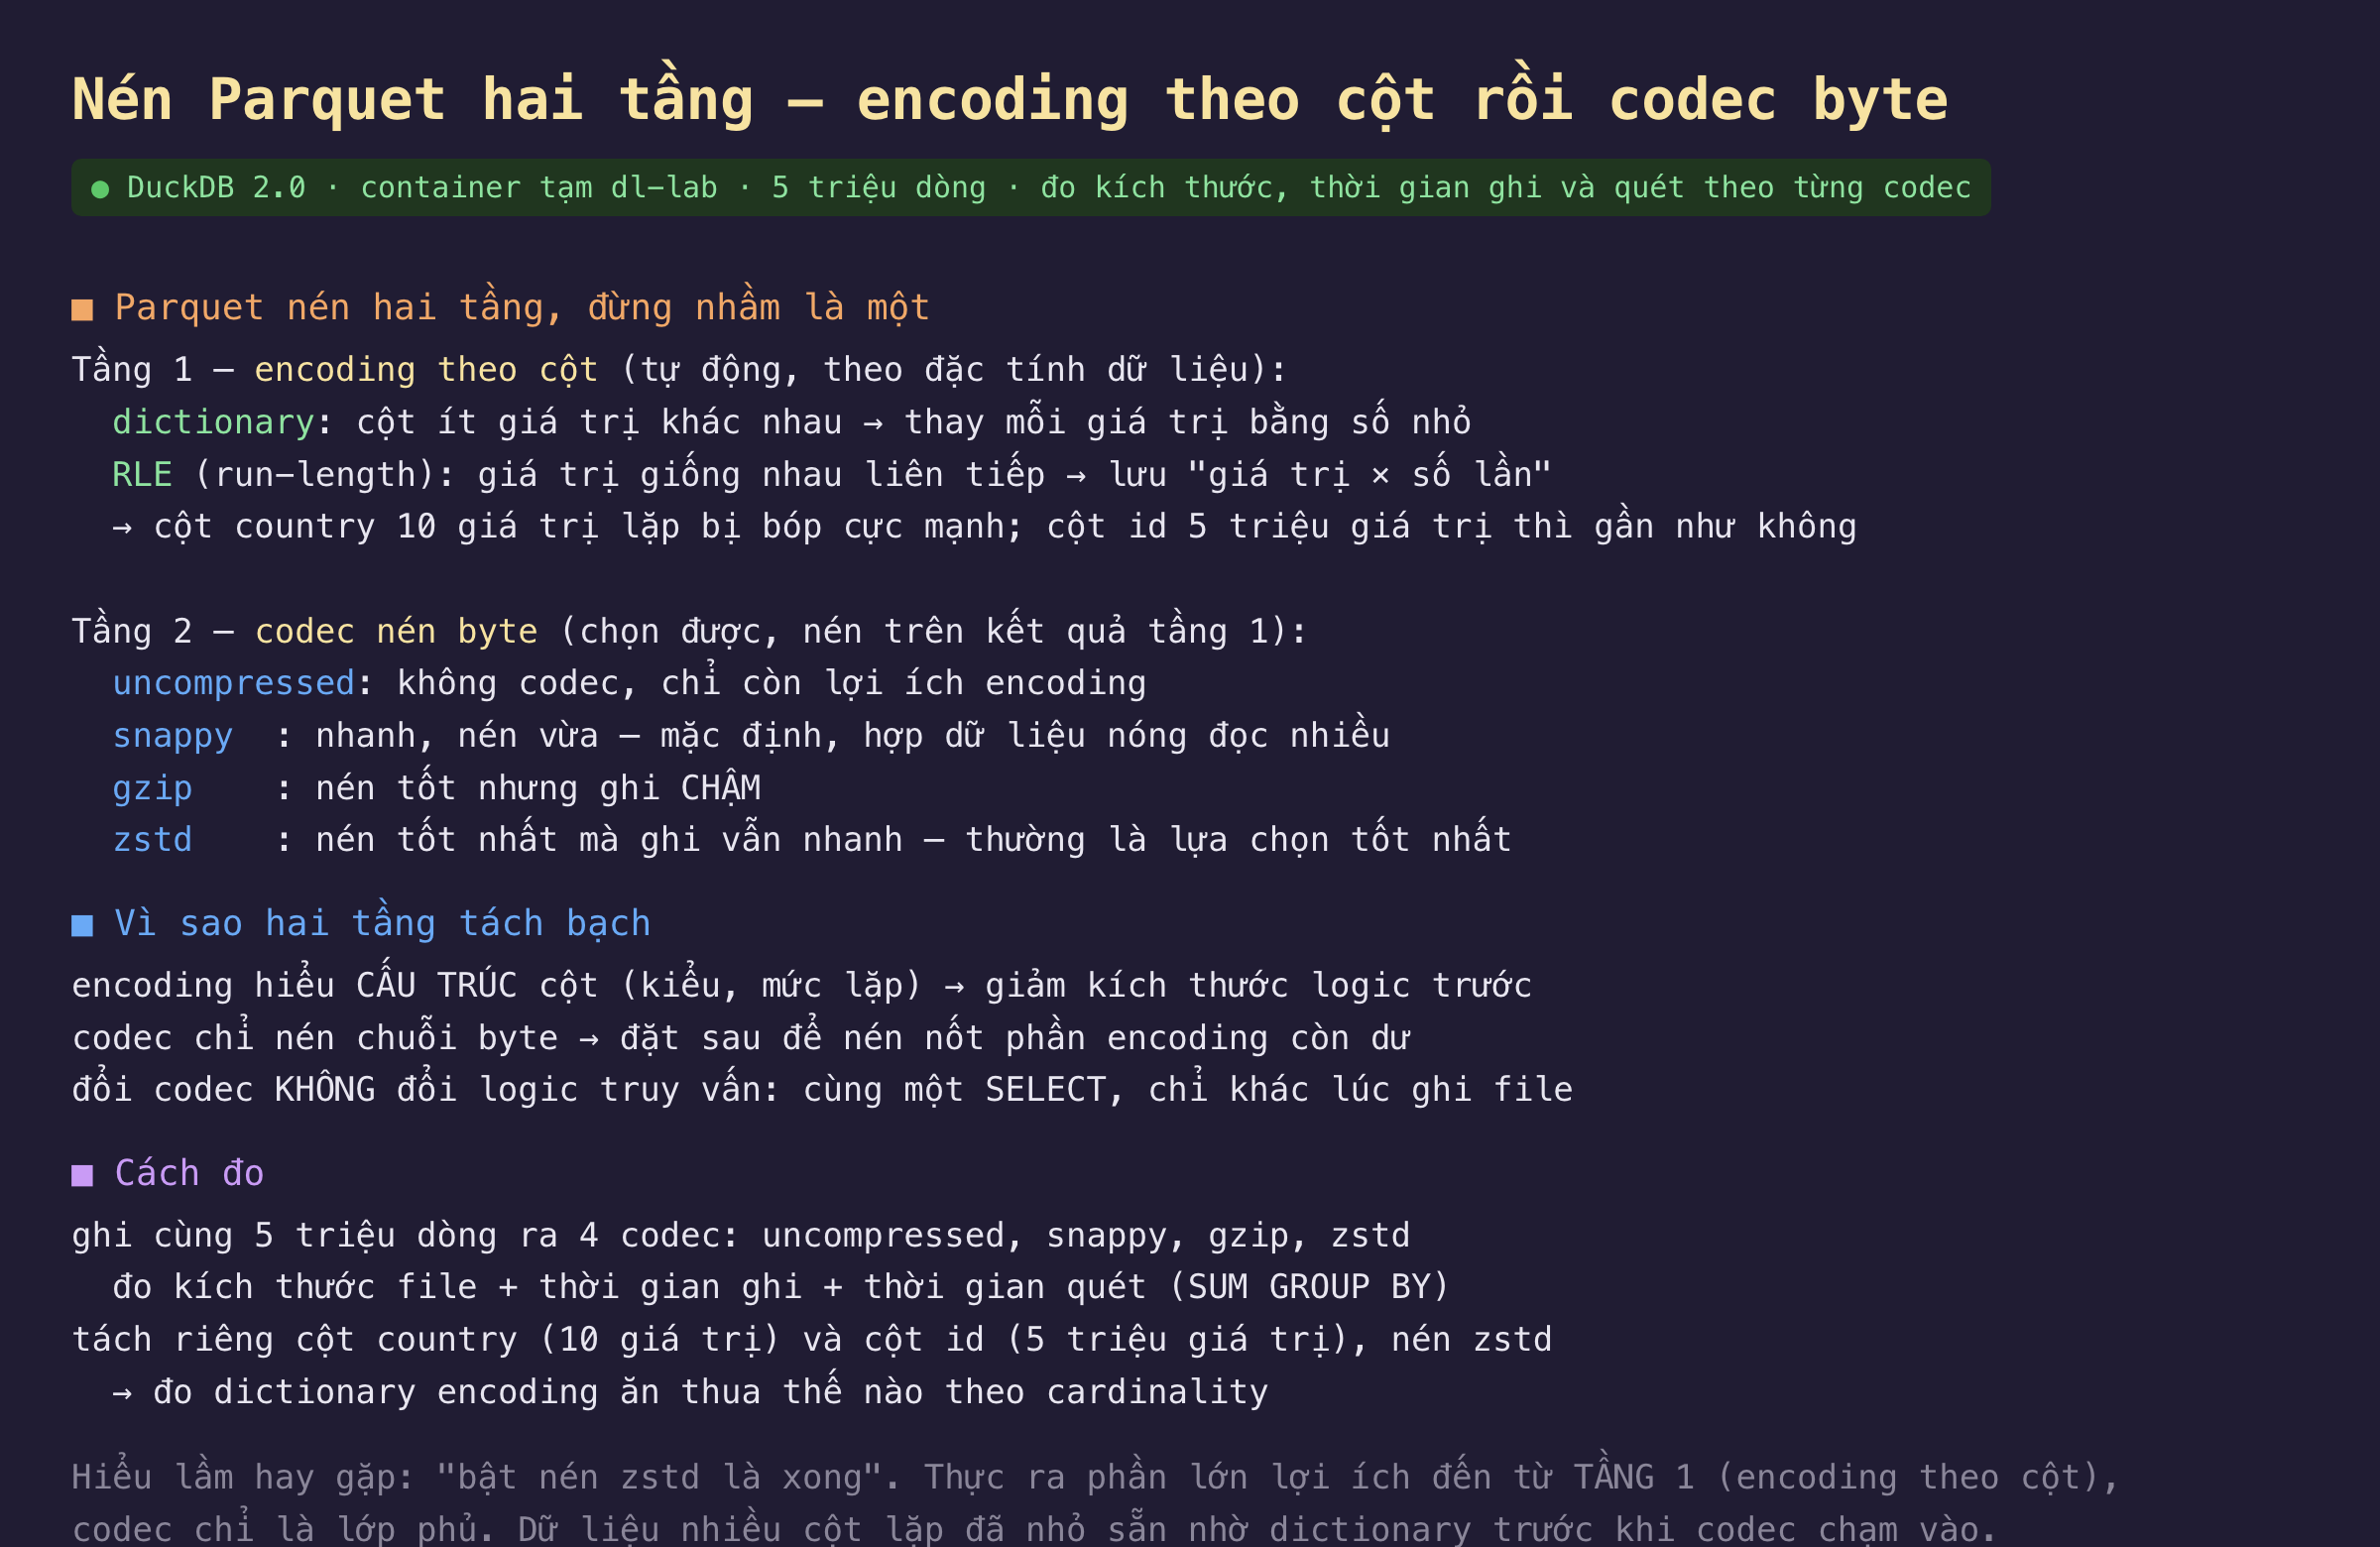
Hình 1: Hai tầng nén của Parquet — encoding theo cột rồi codec byte — và vì sao chúng tách bạch.
Tầng thứ nhất là encoding theo cột, áp dụng tự động dựa trên đặc tính của từng cột. Dictionary encoding dùng cho cột có ít giá trị khác nhau: nó lập một từ điển các giá trị duy nhất rồi thay mỗi ô bằng một số nhỏ trỏ vào từ điển đó, nên cột quốc gia chỉ mười giá trị được lưu bằng những số rất nhỏ thay vì chuỗi đầy đủ. Run-length encoding dùng khi các giá trị giống nhau xuất hiện liên tiếp: thay vì ghi "web, web, web, web", nó ghi "web nhân bốn". Hai kỹ thuật này hiểu cấu trúc của cột, nên cột quốc gia với mười giá trị lặp bị bóp cực mạnh, trong khi cột id với năm triệu giá trị khác nhau thì gần như không được lợi gì vì không có gì lặp để gộp.
Tầng thứ hai là codec nén byte, chọn được khi ghi, chạy trên chuỗi byte đã qua encoding ở tầng một. Uncompressed nghĩa là không dùng codec, chỉ giữ lợi ích của encoding. Snappy nén nhanh và vừa phải, là mặc định, hợp với dữ liệu nóng đọc nhiều lần nơi tốc độ giải nén quan trọng. Gzip nén tốt hơn nhưng ghi chậm. Zstd, codec hiện đại hơn, nén tốt nhất trong nhóm mà ghi vẫn nhanh, thường là lựa chọn tốt nhất. Điểm cần nhớ là codec này chỉ thấy byte, không hiểu đó là cột gì; nó nén nốt phần dư sau khi encoding đã làm việc nặng.
Vì sao hai tầng tách bạch lại quan trọng: encoding hiểu cấu trúc cột, kiểu dữ liệu và mức lặp, nên giảm được kích thước logic trước, thứ mà một codec nén byte thuần không làm nổi vì nó không biết ranh giới cột hay kiểu. Codec đặt sau để nén nốt phần byte còn dư. Và quan trọng cho người dùng: đổi codec không đổi một dòng logic truy vấn, cùng một câu SELECT chạy như nhau, chỉ khác ở lúc ghi file. Cách đo: ghi cùng năm triệu dòng ra bốn codec uncompressed, snappy, gzip, zstd, đo kích thước, thời gian ghi và thời gian quét SUM GROUP BY; rồi tách riêng cột quốc gia mười giá trị và cột id năm triệu giá trị, cùng nén zstd, để đo dictionary encoding theo cardinality.
Đo thật: zstd nhỏ hơn gzip mà ghi nhanh hơn 7 lần
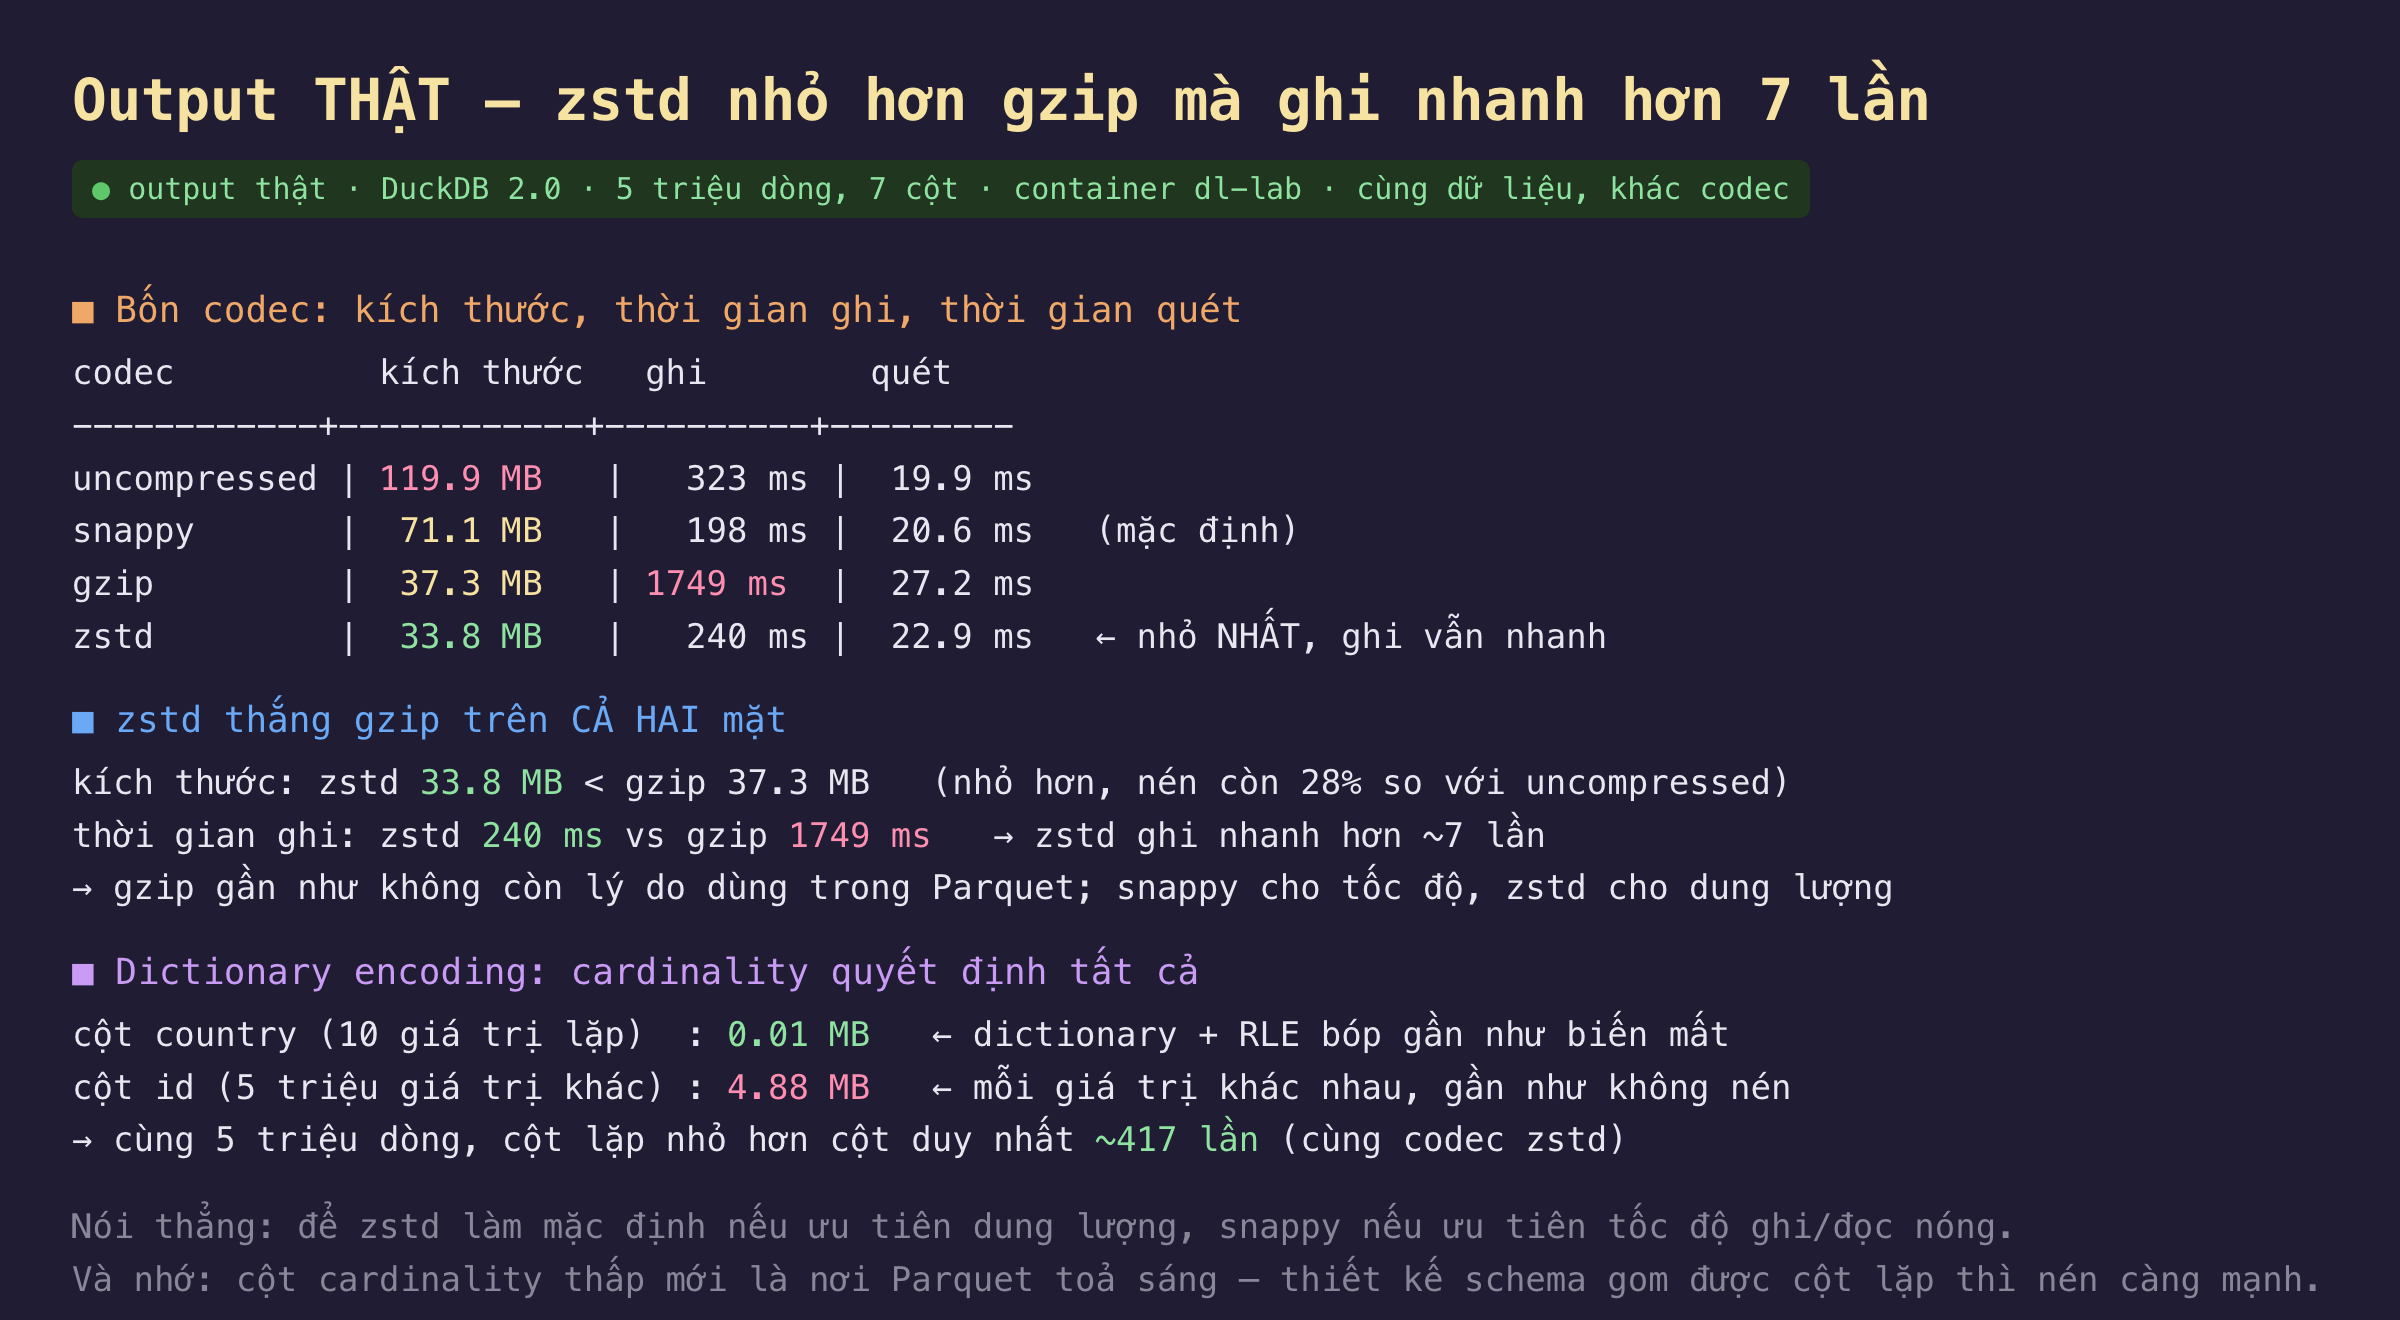
Hình 2: Kích thước, thời gian ghi và quét của bốn codec, cùng tác động của dictionary encoding theo cardinality.
| codec | kích thước | ghi | quét |
|---|---|---|---|
| uncompressed | 119,9 MB | 323 ms | 19,9 ms |
| snappy | 71,1 MB | 198 ms | 20,6 ms |
| gzip | 37,3 MB | 1749 ms | 27,2 ms |
| zstd | 33,8 MB | 240 ms | 22,9 ms |
Bốn codec cho bốn điểm đánh đổi khác nhau giữa kích thước và tốc độ. Uncompressed là 119,9 MB, đã nhỏ hơn CSV nhiều nhờ encoding tầng một dù không có codec. Snappy bóp xuống 71,1 MB với thời gian ghi nhanh nhất, 198 ms. Gzip xuống 37,3 MB nhưng ghi tốn tới 1749 ms. Zstd nhỏ nhất, 33,8 MB, tức nén còn 28 phần trăm so với uncompressed, mà thời gian ghi chỉ 240 ms. Thời gian quét của cả bốn gần nhau, từ 19,9 đến 27,2 ms, vì giải nén khi đọc rẻ hơn nhiều so với nén khi ghi, và phần lớn thời gian quét nằm ở tính toán chứ không ở giải nén.
Zstd thắng gzip trên cả hai mặt, nên gzip gần như không còn lý do dùng. Đây là kết quả rõ ràng nhất. Về kích thước, zstd 33,8 MB nhỏ hơn gzip 37,3 MB. Về thời gian ghi, zstd 240 ms so với gzip 1749 ms, nhanh hơn khoảng bảy lần. Nói cách khác, zstd vừa cho file nhỏ hơn vừa ghi nhanh hơn hẳn; không có chiều nào gzip thắng. Với Parquet, lựa chọn thực tế thu về hai cái tên: snappy khi ưu tiên tốc độ ghi và đọc nóng, zstd khi ưu tiên dung lượng lưu trữ. Gzip, dù phổ biến ở các định dạng khác, là lựa chọn kém cho Parquet vì chi phí ghi cao mà không nén tốt bằng zstd.
Dictionary encoding cho thấy cardinality quyết định tất cả. Tách riêng hai cột, cùng nén zstd, cho con số ấn tượng. Cột quốc gia với mười giá trị lặp chỉ còn 0,01 MB: dictionary thay mỗi giá trị bằng một số từ 0 đến 9, và run-length gộp các số giống nhau liên tiếp, bóp cột năm triệu ô xuống gần như biến mất. Cột id với năm triệu giá trị khác nhau là 4,88 MB: mỗi giá trị duy nhất, không có gì để gộp hay thay thế, nên encoding gần như bất lực và codec cũng không nén được nhiều dữ liệu gần ngẫu nhiên. Cùng năm triệu dòng, cột lặp nhỏ hơn cột duy nhất khoảng 417 lần. Đây là lý do thiết kế schema gom được nhiều cột low-cardinality sẽ nén mạnh hơn hẳn, và là bằng chứng cho hiểu lầm cần gỡ: phần lớn lợi ích đến từ tầng encoding theo cột, không phải từ việc chọn codec.
Đánh đổi cần cân nhắc
Chọn codec theo workload: snappy cho nóng, zstd cho nguội và lưu trữ. Với dữ liệu đọc đi đọc lại liên tục trong truy vấn tương tác, snappy là lựa chọn an toàn vì giải nén cực nhanh và chênh lệch kích thước so với zstd không lớn khi dữ liệu đã nén tốt nhờ encoding. Với dữ liệu lưu trữ lâu dài, bảng lịch sử, hay dữ liệu ghi một lần đọc thỉnh thoảng, zstd đáng giá vì tiết kiệm dung lượng thật trong khi chi phí ghi cao hơn chỉ trả một lần. Nhiều hệ thống dùng zstd mức nén trung bình làm mặc định cân bằng; DuckDB và các công cụ cho chỉnh mức nén zstd nếu cần ép nhỏ hơn nữa, đổi lấy thời gian ghi.
Đừng kỳ vọng codec cứu dữ liệu high-cardinality. Nếu bảng toàn cột giá trị duy nhất, như id ngẫu nhiên, hash, hay văn bản tự do đa dạng, cả encoding lẫn codec đều ít tác dụng, và file Parquet sẽ không nhỏ hơn bao nhiêu. Trong trường hợp đó, cải thiện thật đến từ thiết kế dữ liệu: tách cột high-cardinality ra, sắp xếp dữ liệu để tăng mức lặp liên tiếp cho RLE, hoặc chấp nhận rằng phần đó vốn khó nén. Nhận ra sớm cột nào high-cardinality giúp đặt kỳ vọng đúng và không tốn công thử đủ codec cho một thứ về bản chất không nén được.
Phạm vi đo. Bài đo bốn codec ở mức mặc định của DuckDB, không quét qua các mức nén khác nhau của zstd, vốn đổi thêm thời gian ghi lấy file nhỏ hơn. Thời gian quét đo trên dữ liệu đã nằm trong bộ nhớ đệm hệ điều hành, nên không phản ánh chi phí đọc đĩa lần đầu, nơi file nhỏ hơn còn có lợi thế I/O. Chưa đo tác động của việc sắp xếp dữ liệu trước khi ghi lên tỉ lệ nén, và chưa đo mức nén zstd cao, những yếu tố có thể đẩy khoảng cách xa hơn nữa.
Ba ý mang về
- Parquet nén hai tầng: encoding theo cột rồi codec byte. Dictionary và RLE giảm kích thước logic trước, codec nén nốt byte còn dư; phần lớn lợi ích đến từ tầng encoding, không phải từ codec.
- zstd thắng gzip trên cả kích thước lẫn tốc độ ghi. zstd 33,8 MB và 240 ms so với gzip 37,3 MB và 1749 ms; chọn thực tế là snappy cho tốc độ, zstd cho dung lượng.
- Cardinality quyết định mức nén. Cột mười giá trị lặp nhỏ hơn cột năm triệu giá trị duy nhất 417 lần; thiết kế schema gom được cột low-cardinality thì nén càng mạnh.
Nguồn
- Apache Parquet — Encodings, dictionary (PLAIN_DICTIONARY) và RLE: https://parquet.apache.org/docs/file-format/data-pages/encodings/
- DuckDB — Writing Parquet Files, tùy chọn
COMPRESSION(snappy, gzip, zstd): https://duckdb.org/docs/data/parquet/overview - Facebook — Zstandard, thiết kế codec zstd và so sánh với gzip: https://facebook.github.io/zstd/
- Google — Snappy, codec nén nhanh: https://github.com/google/snappy
- Apache Parquet — File Format, tổng quan page, column chunk và nén: https://parquet.apache.org/docs/file-format/
Phần sau đo một cơ chế khác giúp đọc ít hơn nữa: predicate pushdown nhờ thống kê row group. Parquet chia dữ liệu thành row group kèm min/max mỗi cột, nên truy vấn có điều kiện lọc có thể bỏ qua cả khối không chứa kết quả. Xem số byte đọc giảm bao nhiêu khi lọc trúng và trật phân bố dữ liệu.
