Ta đã có Nested Loop (một-ít) và Hash Join (lớn-lớn không sắp). Thuật toán join thứ ba, Merge Join, tỏa sáng ở một tình huống rất cụ thể: khi cả hai bảng đều lớn và dữ liệu đã được sắp theo khóa join. Trong bài này, một join 3 triệu × 3 triệu cho thấy Merge Join thực sự nhanh hơn Hash Join — nhưng chỉ khi có index để tránh bước sắp xếp. Đo thật để thấy ranh giới.
Merge Join hoạt động thế nào
Ý tưởng giống hệt việc hợp nhất hai danh sách đã sắp: đặt hai con trỏ ở đầu hai luồng (đã sắp theo khóa join), rồi cho chúng chạy song song.
ptr_a, ptr_b ở đầu mỗi luồng (đã sắp theo khóa)
nếu a.id == b.id: xuất kết quả, tiến cả hai con trỏ
nếu a.id <  b.id: tiến ptr_a
nếu a.id >  b.id: tiến ptr_b
Điểm cốt lõi: mỗi bảng đọc đúng một lần, không cần bảng băm khổng lồ trong RAM, không cần index để tra. Chi phí gần như là O(n + m) — chỉ hai lượt quét tuyến tính.
SELECT count(*) FROM a JOIN b ON a.id = b.id; -- 3 triệu × 3 triệu
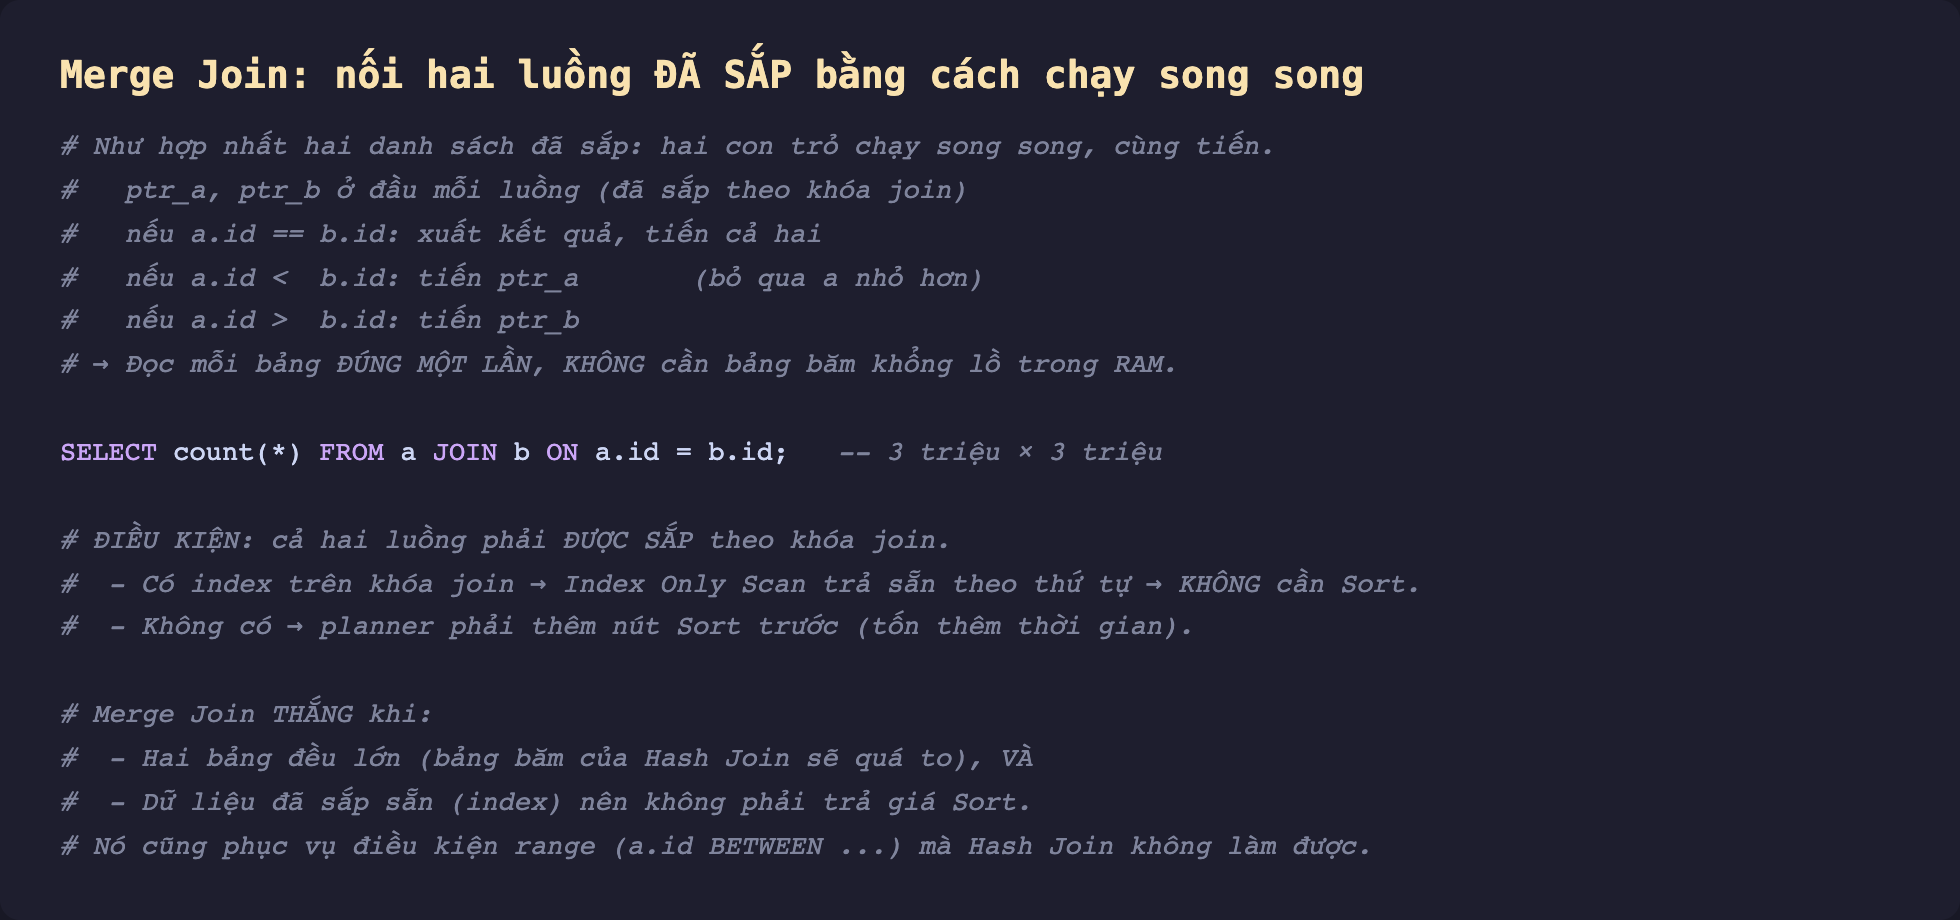
Hình 1: Merge Join hợp nhất hai luồng đã sắp bằng hai con trỏ chạy song song. Điều kiện sống còn: cả hai luồng phải được sắp theo khóa join — có index thì miễn phí, không có thì phải Sort trước.
Đo thật: Merge Join 547 ms vs Hash Join 1.291 ms
Hai bảng a và b, mỗi bảng 3 triệu dòng, đều có index trên id. Join chúng và so ba cách:
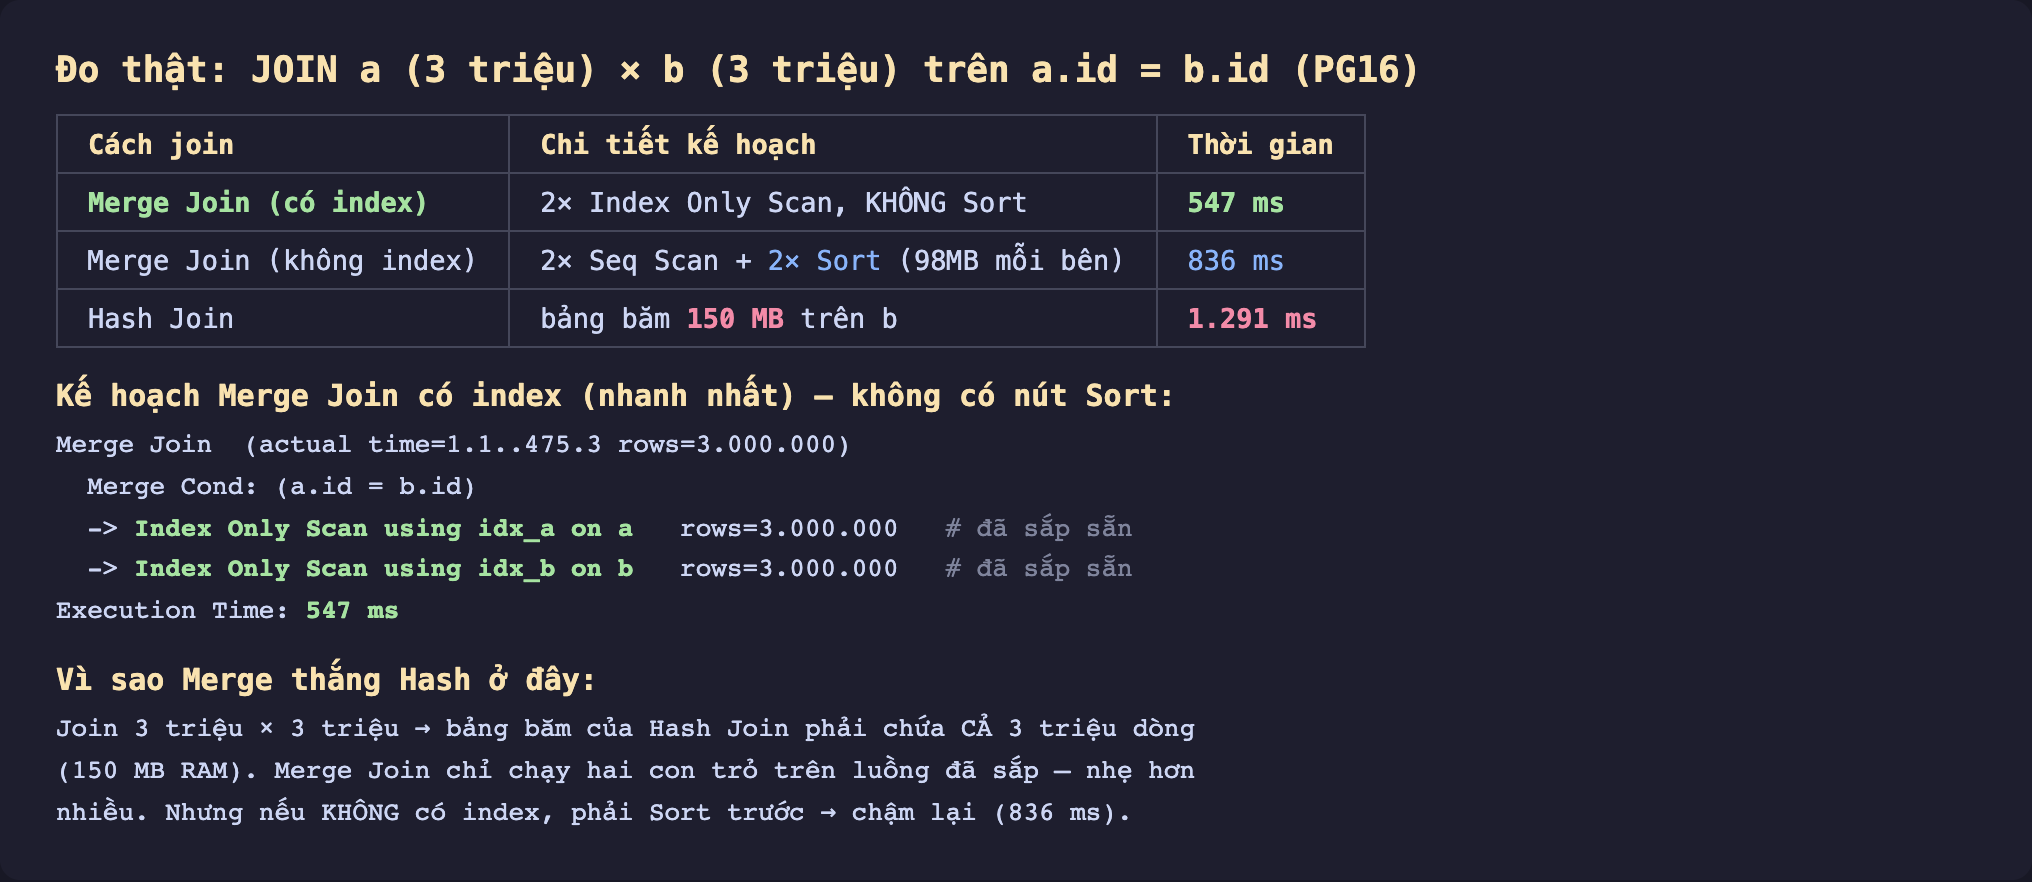
Hình 2: Ba cách join 3 triệu × 3 triệu. Merge Join có index (2 Index Only Scan, không Sort): 547 ms. Merge Join không index (thêm 2 Sort): 836 ms. Hash Join (bảng băm 150 MB): 1.291 ms.
Đọc kế hoạch Merge Join có index: hai Index Only Scan (mỗi cái trả id sẵn theo thứ tự), và nút Merge Join chỉ việc hợp nhất — không có nút Sort nào. Toàn bộ join xong trong 547 ms.
So với Hash Join cùng truy vấn: 1.291 ms — chậm hơn 2,4 lần. Lý do: join 3 triệu × 3 triệu buộc Hash Join dựng một bảng băm chứa cả 3 triệu dòng, chiếm 150 MB RAM (Memory Usage: 149956kB). Dựng và tra bảng băm khổng lồ đó tốn kém, trong khi Merge Join chỉ cho hai con trỏ chạy trên hai luồng đã sắp sẵn — nhẹ hơn nhiều.
Cái giá: khi phải Sort trước
Nhưng lợi thế của Merge Join hoàn toàn phụ thuộc vào việc dữ liệu đã sắp sẵn. Bỏ index đi, planner buộc phải thêm bước sắp xếp: kế hoạch Merge Join không index cho thấy hai nút Sort (mỗi cái quicksort Memory: 98305kB) trước khi hợp nhất. Kết quả chậm lại còn 836 ms — vẫn nhanh hơn Hash Join ở ca này, nhưng đã mất phần lớn ưu thế.
Đây là quy tắc quyết định: Merge Join chỉ thắng khi tránh được bước Sort. Nếu cả hai phía đều đã có thứ tự (index trên khóa join, hoặc kết quả của một node phía dưới vốn đã sắp), Merge Join gần như luôn thắng cho join lớn. Nếu phải Sort cả hai từ đầu, chi phí sắp xếp thường khiến Hash Join trở lại dẫn đầu.
Đánh đổi và khi nào Merge Join là đúng
Merge Join tối ưu cho join lớn trên dữ liệu đã sắp. Điển hình: nối hai bảng đều có index trên khóa join, hoặc nối kết quả của các truy vấn con vốn đã ORDER BY. PostgreSQL nhận ra thứ tự sẵn có và chọn Merge Join.
Nó phục vụ được điều kiện range, khác Hash Join. Hash Join chỉ làm điều kiện bằng (=). Merge Join, nhờ chạy trên luồng đã sắp, xử lý được cả a.id >= b.id trong một số dạng join — một vùng mà Hash Join bó tay.
Đừng ép Merge Join khi dữ liệu không sắp. Nếu bảng không có index phù hợp và không đã sắp sẵn, bắt Merge Join nghĩa là trả giá hai lần Sort tốn kém. Để planner quyết định — nó tính chi phí Sort vào và thường chọn Hash Join khi Sort quá đắt. Ba thuật toán join tồn tại vì mỗi cái thắng ở một vùng khác nhau; ép tay chỉ nên dùng khi thử nghiệm.
Ba ý mang về
- Merge Join hợp nhất hai luồng đã sắp bằng hai con trỏ chạy song song — đọc mỗi bảng một lần, không cần bảng băm — nên nó thắng Hash Join cho join lớn khi dữ liệu đã có thứ tự: đo thật 547 ms so với 1.291 ms (Hash Join dựng bảng băm 150 MB).
- Lợi thế phụ thuộc hoàn toàn vào thứ tự sẵn có: có index trên khóa join thì Merge Join dùng
Index Only Scankhông cần Sort; thiếu index, planner phải thêm hai nútSort(836 ms) và mất phần lớn ưu thế. - Chọn theo dữ liệu, để planner quyết định: Merge Join cho join lớn đã sắp và cả điều kiện range; đừng ép nó khi dữ liệu chưa sắp vì chi phí Sort thường khiến Hash Join thắng lại.
Phần sau ta tổng hợp cả ba thuật toán join: Phần sau mổ xẻ cách planner quyết định chọn Nested Loop, Hash hay Merge — dựa trên kích thước bảng, index, và ước lượng chi phí.
