Ba bài trước ta mổ xẻ ba thuật toán join: Nested Loop, Hash, Merge. Câu hỏi tự nhiên: PostgreSQL quyết định dùng cái nào bằng cách nào? Câu trả lời quan trọng để hiểu vì sao cùng một câu truy vấn đôi khi nhanh, đôi khi chậm. PostgreSQL không có join mặc định — nó tính toán lựa chọn cho từng truy vấn dựa trên ước lượng số dòng. Bài này chứng minh bằng cách giữ nguyên câu JOIN và chỉ đổi bộ lọc WHERE, khiến planner tự chuyển kiểu join.
Planner quyết định theo ba bước
Với mỗi truy vấn có join, PostgreSQL làm ba việc:
- Ước lượng số dòng mỗi bên sẽ tạo ra, dựa trên thống kê trong
pg_statistic(doANALYZEcập nhật). - Tính chi phí dự kiến của từng kiểu join khả dĩ — Nested Loop, Hash, Merge — theo mô hình chi phí (số trang đọc ×
seq_page_cost/random_page_cost, số dòng xử lý ×cpu_tuple_cost...). - Chọn kiểu có chi phí thấp nhất.
Không có ngưỡng cứng "trên X dòng thì Hash Join". Mỗi lần là một phép tính cụ thể.
SELECT count(*) FROM khach k JOIN don d ON d.khach_id = k.id
WHERE k.id = 42;          -- 1 khách   → Nested Loop
WHERE k.vip;              -- 500 khách → Nested Loop
WHERE k.id < 500001;      -- 500k khách → Hash Join
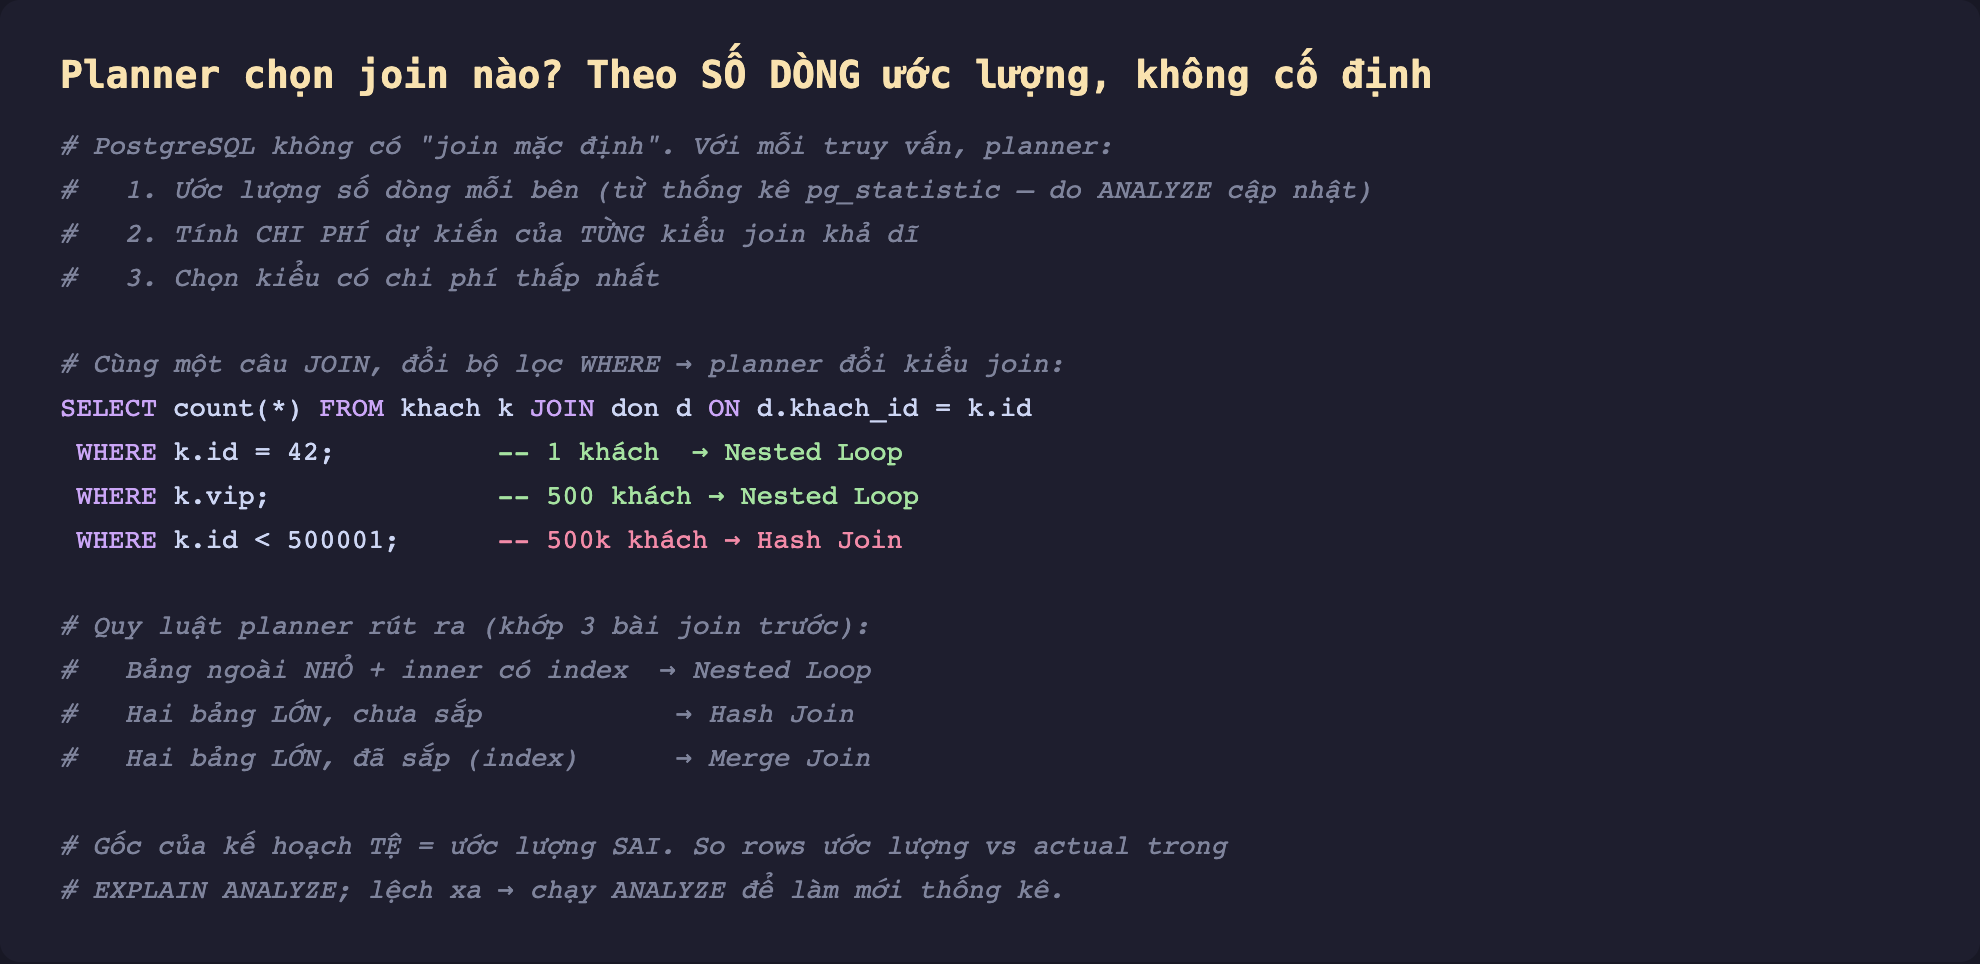
Hình 1: Ba bước planner quyết định join. Nó ước lượng số dòng, tính chi phí mỗi kiểu join, chọn rẻ nhất — không theo luật cứng, mà theo phép tính dựa trên thống kê.
Đo thật: cùng JOIN, ba kế hoạch
Giữ nguyên câu JOIN khach × don (3 triệu đơn), chỉ đổi bộ lọc trên khach để thay đổi số dòng bảng ngoài:
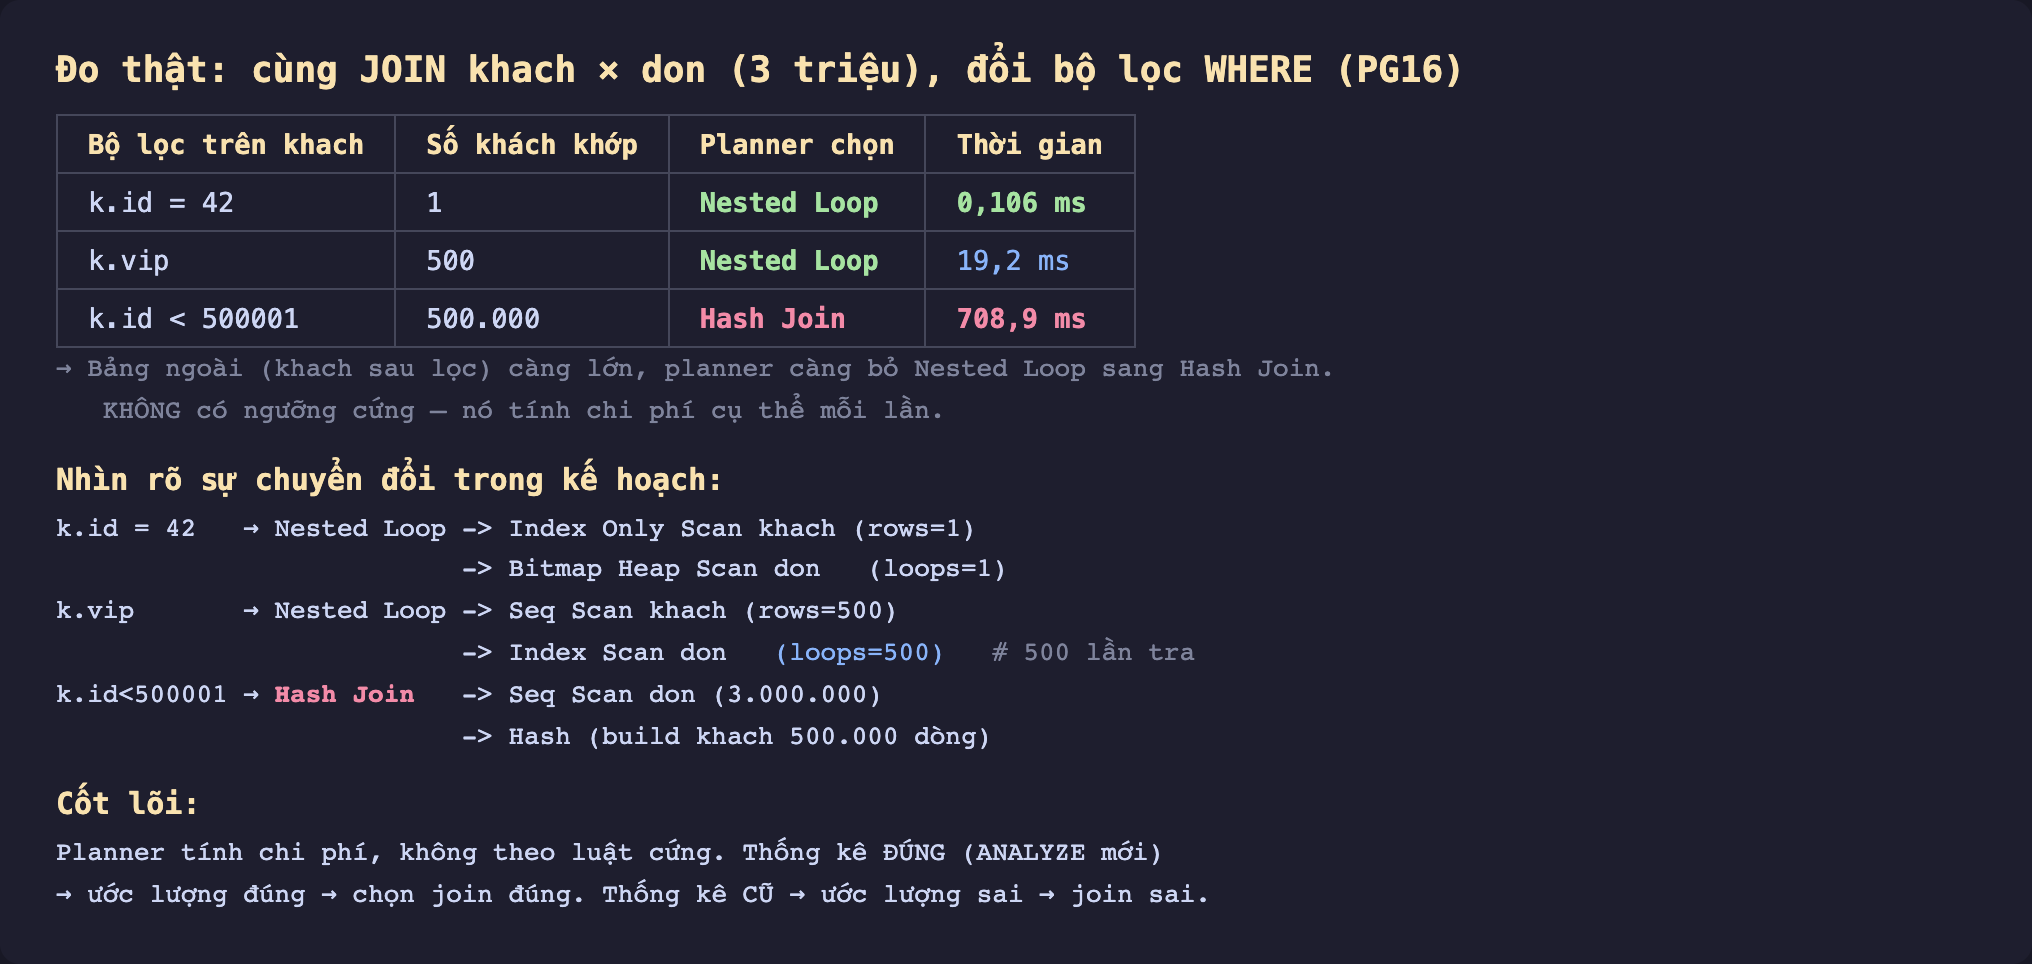
Hình 2: Cùng JOIN, ba bộ lọc. 1 khách → Nested Loop (0,106 ms). 500 khách → Nested Loop (19,2 ms, loops=500). 500.000 khách → Hash Join (708,9 ms). Bảng ngoài càng lớn, planner càng bỏ Nested Loop sang Hash Join.
Đọc sự chuyển đổi trong kế hoạch:
k.id = 42(1 khách): Nested Loop — bảng ngoài chỉ 1 dòng, tradonqua index. 0,106 ms.k.vip(500 khách): vẫn Nested Loop — 500 dòng ngoài, mỗi dòng mộtIndex Scantrêndon(loops=500). 19,2 ms. Planner tính rằng 500 lần tra index vẫn rẻ hơn dựng bảng băm.k.id < 500001(500.000 khách, tức toàn bộ): Hash Join — giờ bảng ngoài quá lớn, 500 nghìn lần tra index sẽ đắt hơn dựng một bảng băm rồi quétdonmột lượt. 708,9 ms. Planner chuyển kiểu join.
Điểm mấu chốt: không có con số ngưỡng nào được viết cứng. Planner tính chi phí Nested Loop (≈ số dòng ngoài × chi phí tra index) và chi phí Hash Join (≈ dựng băm + quét một lượt), rồi chọn cái nhỏ hơn. Khi bảng ngoài đủ lớn, cán cân nghiêng.
Gốc rễ của kế hoạch tệ: ước lượng sai
Vì mọi quyết định dựa trên ước lượng số dòng, chất lượng ước lượng quyết định chất lượng kế hoạch. Đây là nơi mọi thứ hỏng:
So rows ước lượng với actual rows trong EXPLAIN ANALYZE. Mỗi node in ra (cost=... rows=N) (ước lượng) và (actual ... rows=M) (thực tế). Nếu N và M lệch xa — ví dụ ước lượng 5 nhưng thực tế 50.000 — planner đã chọn join dựa trên một thế giới sai. Nó có thể chọn Nested Loop tưởng bảng ngoài 5 dòng, rồi phải lặp 50.000 lần: đúng thảm họa Nested Loop ở bài trước.
Nguyên nhân phổ biến là thống kê cũ. Sau khi nạp lớn, xóa nhiều, hay đổi phân bố dữ liệu, thống kê trong pg_statistic không còn khớp thực tế cho tới lần ANALYZE kế tiếp. Autovacuum thường tự chạy ANALYZE, nhưng sau thao tác lớn nên chạy tay ANALYZE ten_bang; để planner có số liệu mới.
Cột tương quan làm ước lượng lệch. Planner mặc định giả định các điều kiện độc lập; nếu thanh_pho = 'HN' AND quan = 'Ba Đình' (hai cột tương quan chặt), nó nhân xác suất và ước lượng thấp hơn thực tế nhiều. CREATE STATISTICS cho phép khai báo tương quan này — chủ đề của một bài sau.
Đánh đổi: tin planner, nhưng biết khi nào nó sai
Đừng ép join bằng enable_* trên production. SET enable_hashjoin = off hữu ích để thử nghiệm và hiểu, nhưng ép tay trên production nghĩa là bạn khóa một quyết định mà planner lẽ ra sẽ điều chỉnh khi dữ liệu đổi. Cách đúng là giúp planner ước lượng đúng, không phải ghi đè kết luận của nó.
Khi kế hoạch tệ, sửa gốc chứ đừng vá ngọn. Thứ tự kiểm: thống kê có mới không (ANALYZE)? Ước lượng có khớp thực tế không (so rows vs actual)? Có cột tương quan cần CREATE STATISTICS không? Sửa gốc khiến planner tự chọn đúng cho mọi truy vấn tương tự, còn ép join chỉ vá một câu.
Ba ý mang về
- Planner chọn join theo chi phí ước lượng, không theo luật cứng: cùng câu JOIN, đổi bộ lọc
WHEREkhiến nó chuyển từ Nested Loop (1 và 500 khách) sang Hash Join (500.000 khách) — vì cán cân chi phí nghiêng khi bảng ngoài đủ lớn. - Chất lượng kế hoạch = chất lượng ước lượng: so
rows(ước lượng) vớiactual rowstrongEXPLAIN ANALYZE; lệch xa là dấu hiệu planner đang quyết định trên số liệu sai — thường do thống kê cũ. - Sửa gốc, không ép ngọn: giữ thống kê mới bằng
ANALYZE, khai báo cột tương quan bằngCREATE STATISTICS, và chỉ dùngenable_*để thử nghiệm — đừng khóa cứng kiểu join trên production.
Phần sau ta đi sâu vào một thao tác tốn kém mà nhiều kế hoạch phụ thuộc: Phần sau đo Sort và vai trò của work_mem — khi nào PostgreSQL sắp trong RAM, khi nào tràn ra đĩa, và chỉnh thế nào.
