ORDER BY, DISTINCT, một số GROUP BY, và Merge Join — tất cả đều dựa trên một thao tác tốn kém: sắp xếp. Và giống Hash Join, việc Sort chạy nhanh hay chậm phụ thuộc vào một tham số duy nhất: work_mem. Bài này đo thật ba cách PostgreSQL sắp dữ liệu, chỉ ra khi nào nó tràn ra đĩa, và một mẹo còn tốt hơn cả chỉnh work_mem — xóa hẳn bước Sort.
Ba "Sort Method" bạn sẽ thấy
Trong EXPLAIN ANALYZE, node Sort in ra dòng Sort Method cho biết PostgreSQL sắp bằng cách nào. Có ba kiểu chính:
quicksort: toàn bộ dữ liệu vừawork_mem, sắp hết trong RAM. Nhanh nhất.external merge: dữ liệu vượtwork_mem, PostgreSQL ghi từng khối đã sắp ra file tạm trên đĩa rồi trộn (merge) lại. Chậm vì đụng đĩa.top-N heapsort: khi truy vấn chỉ cầnTOP N(dạngORDER BY ... LIMIT N), nó chỉ giữ N phần tử nhỏ nhất trong một heap, không sắp cả bảng. Rất gọn.
SELECT gia FROM sp ORDER BY gia; -- sắp 3 triệu dòng
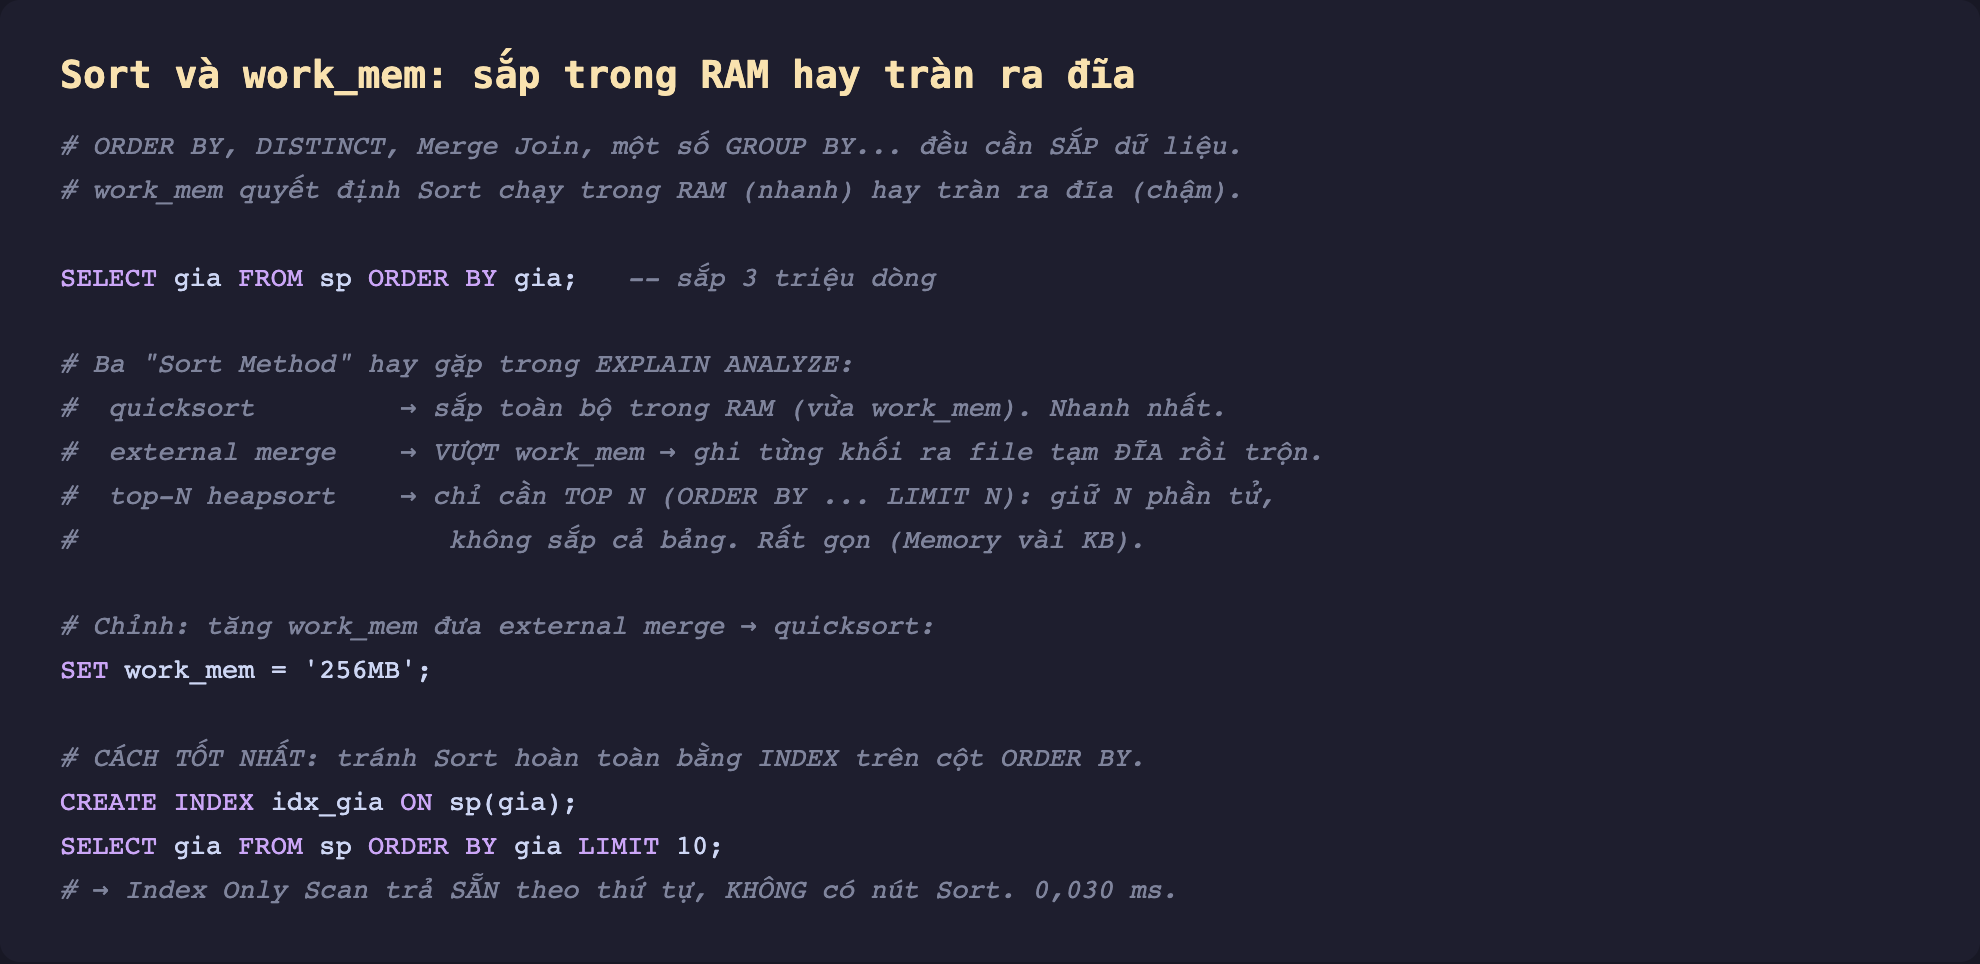
Hình 1: Ba Sort Method và cách chỉnh. quicksort (RAM) nhanh nhất, external merge (đĩa) khi vượt work_mem, top-N heapsort cho LIMIT. Tốt nhất là tránh Sort bằng index.
Đo thật: từ 609 ms xuống 0,030 ms
Sắp 3 triệu dòng theo gia trên bảng 313 MB, đo qua nhiều cấu hình:
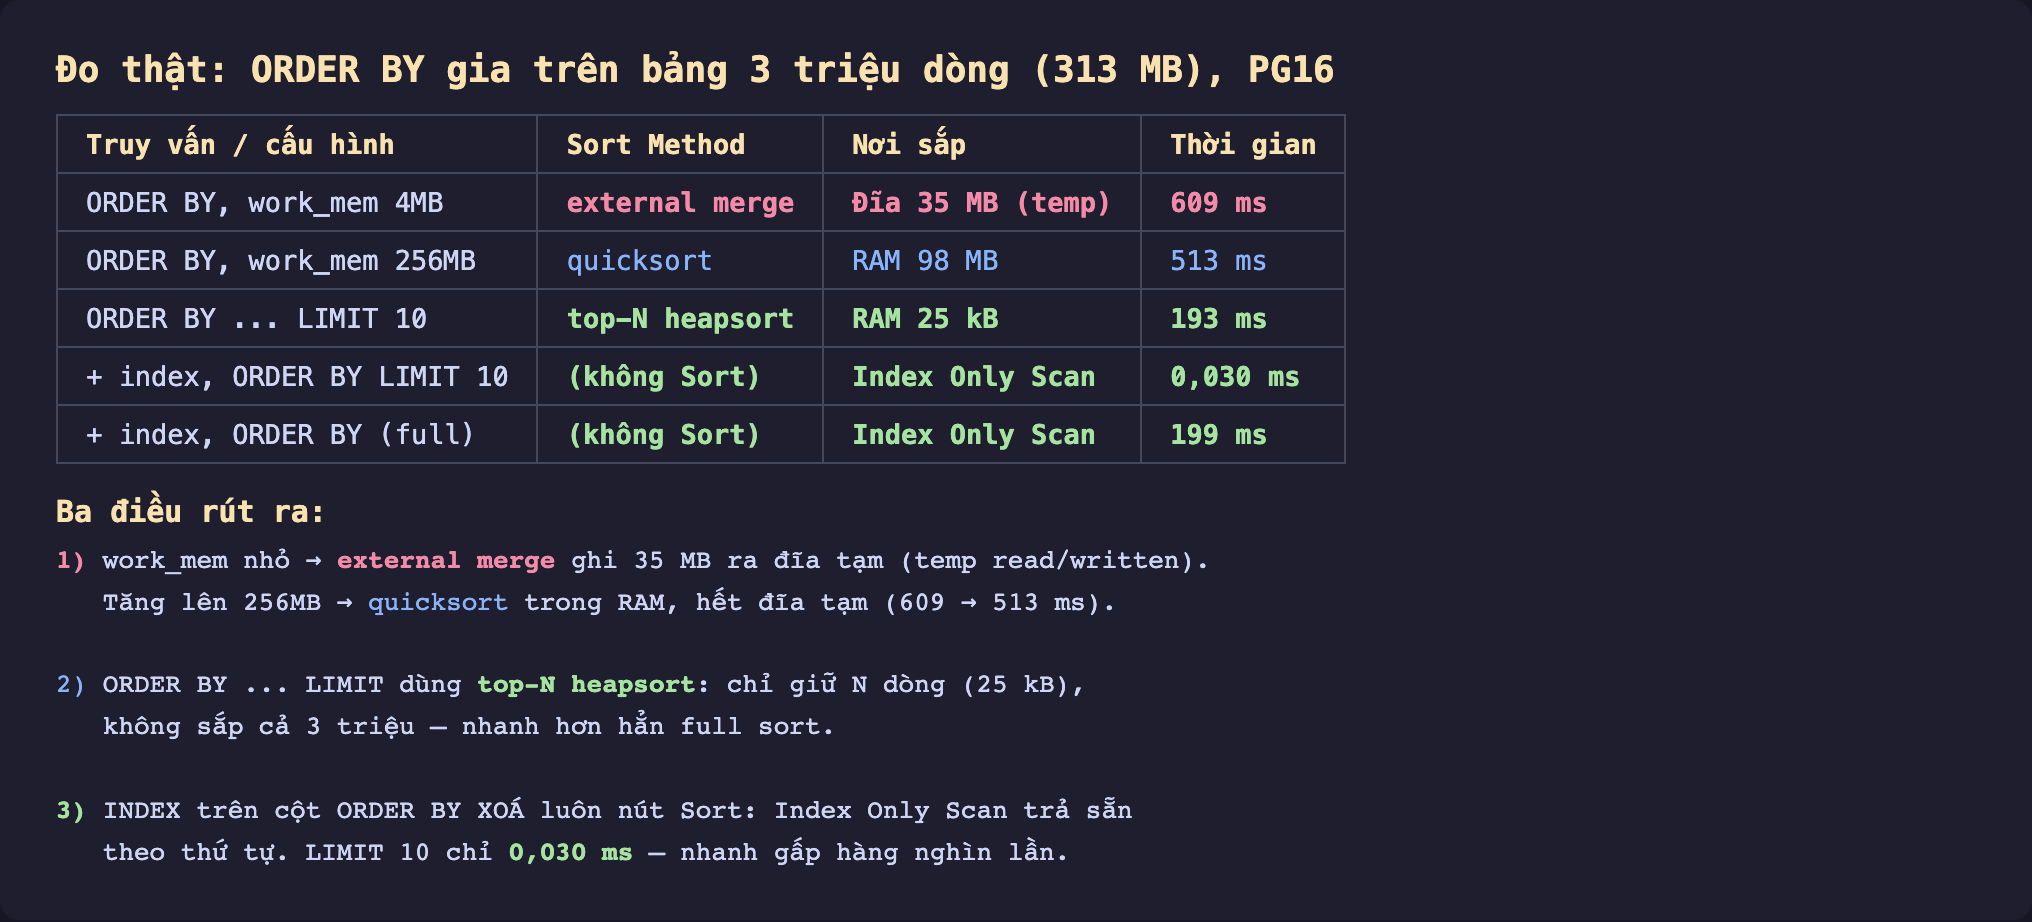
Hình 2: Cùng ORDER BY, nhiều cấu hình. work_mem 4MB → external merge (đĩa 35 MB, 609 ms). 256MB → quicksort (RAM 98 MB, 513 ms). LIMIT 10 → top-N heapsort (25 kB, 193 ms). Có index → không Sort, 0,030 ms.
work_mem quyết định đĩa hay RAM. Với work_mem mặc định 4 MB, sắp 3 triệu dòng (cần ~98 MB) buộc PostgreSQL dùng external merge, ghi 35 MB ra đĩa tạm (temp read/written), mất 609 ms. Tăng work_mem lên 256 MB, toàn bộ vừa RAM: quicksort, 513 ms, không đụng đĩa. Chênh ~100 ms chỉ từ việc tránh đĩa tạm — và trên tập lớn hơn, khoảng cách này giãn rộng.
LIMIT kích hoạt top-N heapsort. ORDER BY gia LIMIT 10 không cần sắp cả 3 triệu dòng — chỉ cần tìm 10 dòng nhỏ nhất. top-N heapsort giữ một heap 10 phần tử (Memory: 25kB), quét một lượt, mất 193 ms. Nhanh hơn full sort mà tốn bộ nhớ không đáng kể. Đây là lý do thêm LIMIT vào truy vấn sắp xếp thường nhanh bất ngờ.
Cách tốt nhất: xóa hẳn bước Sort bằng index
Ba dòng cuối bảng là cú knock-out. Tạo index trên gia, rồi ORDER BY gia:
CREATE INDEX idx_gia ON sp(gia);
SELECT gia FROM sp ORDER BY gia LIMIT 10;   -- 0,030 ms
Kế hoạch giờ là Index Only Scan — không có nút Sort nào cả. Index B-tree đã lưu gia theo thứ tự, nên PostgreSQL chỉ việc đọc index từ đầu, đã sắp sẵn. LIMIT 10 dừng ngay sau 10 dòng: 0,030 ms, nhanh hơn hàng nghìn lần so với sắp trong RAM. Ngay cả ORDER BY toàn bộ với index cũng chỉ 199 ms — đọc tuần tự index, không sắp gì.
Bài học: trước khi chỉnh work_mem cho một truy vấn ORDER BY chậm, hãy hỏi liệu một index trên cột sắp xếp có xóa bỏ bước Sort hoàn toàn không. Index vừa nhanh hơn nhiều, vừa không tốn RAM lúc chạy.
Đánh đổi cần cân nhắc
work_mem áp cho mỗi node và nhân theo kết nối. Như bài Hash Join đã nói, đặt work_mem cao toàn cục rất nguy hiểm: một truy vấn nhiều Sort/Hash × nhiều kết nối có thể ngốn hàng chục GB. Chỉ SET work_mem cao cho phiên/truy vấn phân tích nặng cụ thể, giữ giá trị toàn cục vừa phải.
Index cho ORDER BY không miễn phí. Nó vẫn là một index — tốn chi phí ghi và dung lượng như mọi index (bài trước đã đo). Chỉ tạo khi truy vấn sắp xếp đó chạy đủ thường xuyên để đáng.
Thứ tự cột index phải khớp ORDER BY. Index (a, b) phục vụ ORDER BY a, b nhưng không phục vụ ORDER BY b, a hay ORDER BY a DESC, b ASC (trừ khi khai đúng hướng). Chiều sắp (ASC/DESC) và thứ tự cột phải khớp thì planner mới bỏ được nút Sort.
Ba ý mang về
work_memquyết định Sort chạy trong RAM hay tràn đĩa: đo thật, sắp 3 triệu dòng với work_mem 4MB dùngexternal mergeghi 35 MB ra đĩa (609 ms); tăng lên 256MB thànhquicksorttrong RAM (513 ms) — đọcSort Methodvàtemptrong EXPLAIN để biết.ORDER BY ... LIMITdùngtop-N heapsortchỉ giữ N phần tử (25 kB cho LIMIT 10) thay vì sắp cả bảng — thêmLIMITkhi chỉ cần vài dòng đầu là một tối ưu miễn phí.- Index trên cột sắp xếp xóa hẳn bước Sort:
Index Only Scantrả dữ liệu sẵn theo thứ tự (0,030 ms cho LIMIT 10) — cách này thường tốt hơn mọi lần chỉnhwork_mem, miễn thứ tự và chiều cột index khớpORDER BY.
Phần sau ta xét cách PostgreSQL gom nhóm dữ liệu: Phần sau so sánh HashAggregate và GroupAggregate — hai cách thực thi GROUP BY, mỗi cái nhanh ở đâu.
