GROUP BY là xương sống của mọi truy vấn tổng hợp — doanh thu theo tỉnh, đơn theo khách, lượt xem theo ngày. Nhưng PostgreSQL có hai cách hoàn toàn khác nhau để thực thi nó: HashAggregate và GroupAggregate. Chọn cách nào không do bạn, mà do planner tính toán dựa trên số nhóm. Hiểu sự khác biệt giúp bạn đọc EXPLAIN và biết khi nào một truy vấn tổng hợp sẽ tràn ra đĩa. Bài này đo cả hai trên bảng 5 triệu dòng.
Hai cách gom nhóm
HashAggregate: dựng một bảng băm ánh xạ khóa nhóm → bộ tích lũy (sum, count, avg...). Quét dữ liệu một lượt, mỗi dòng tìm ngăn băm tương ứng và cập nhật bộ tích lũy. Không cần sắp xếp — đọc dữ liệu theo thứ tự nào cũng được.
GroupAggregate: cần đầu vào đã sắp theo cột nhóm. Nó đi tuần tự, gom các dòng cùng nhóm nằm liền nhau, và xuất kết quả mỗi khi đổi sang nhóm mới. Chỉ giữ một nhóm trong bộ nhớ tại một thời điểm — bộ nhớ hằng số.
SELECT tinh_id, sum(tien) FROM ban_hang GROUP BY tinh_id;
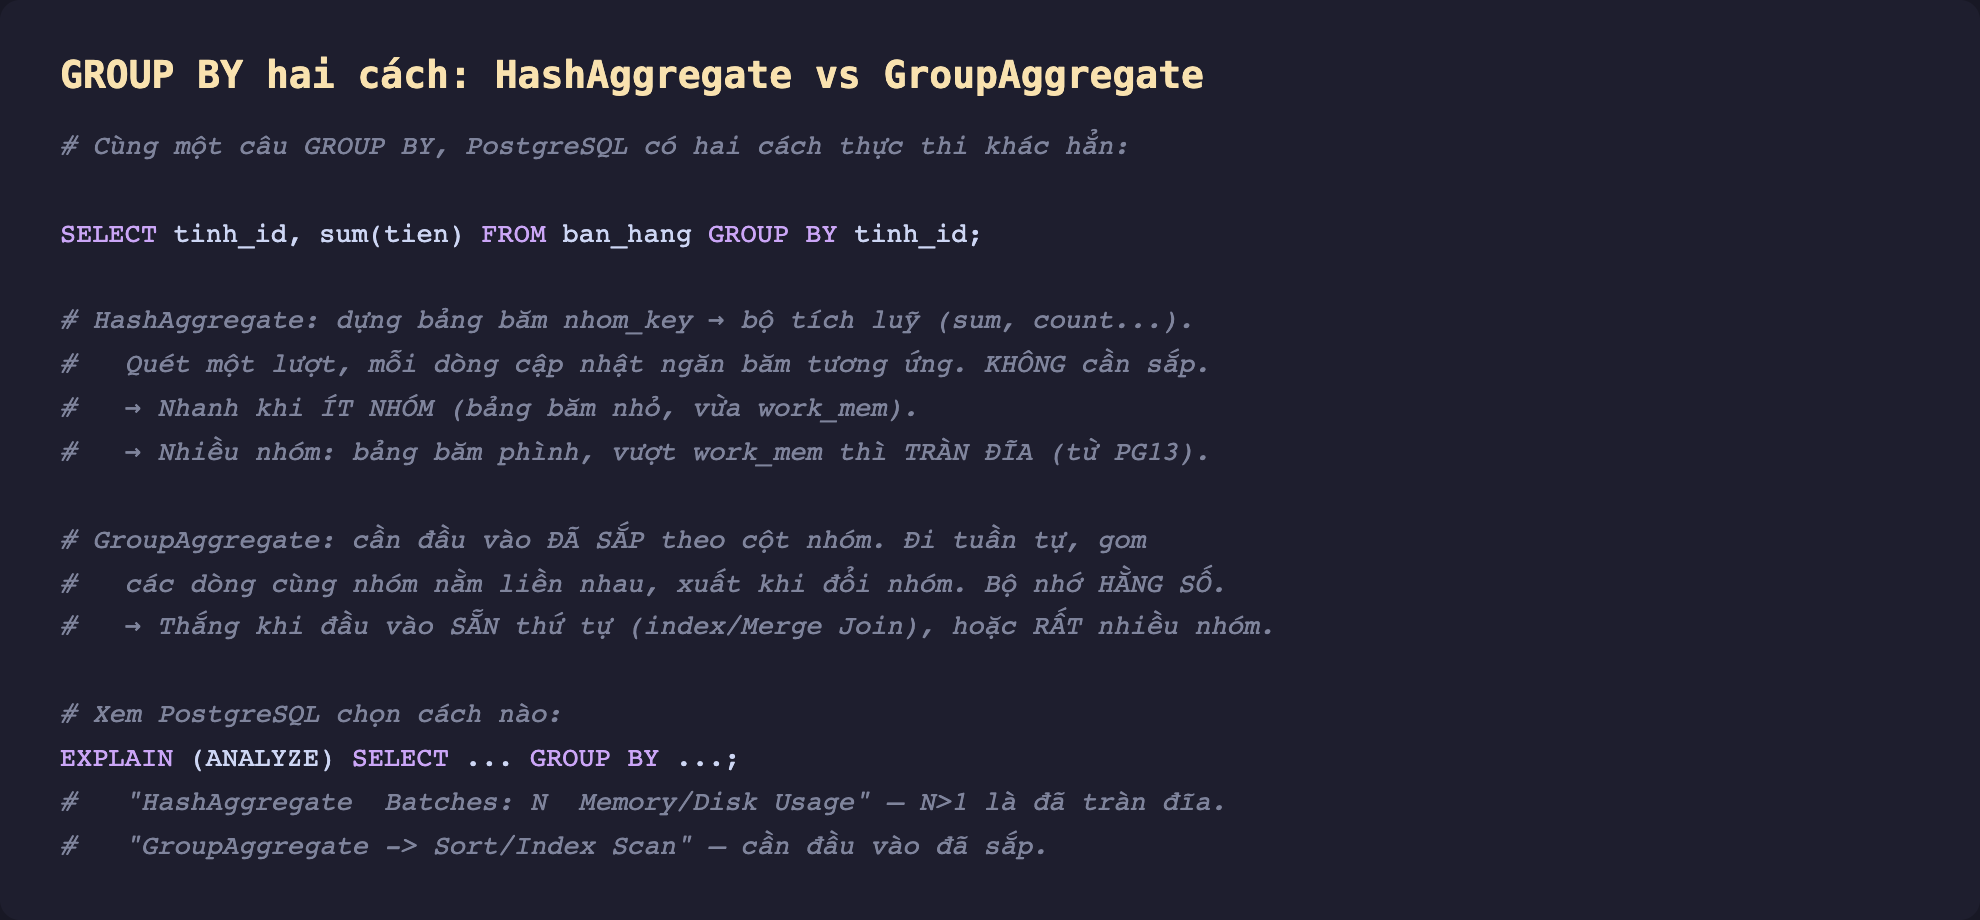
Hình 1: Hai cách gom nhóm. HashAggregate dựng bảng băm, không cần sắp — nhanh khi ít nhóm. GroupAggregate cần đầu vào đã sắp nhưng dùng bộ nhớ hằng số — thắng khi dữ liệu sẵn thứ tự.
Đo thật: ít nhóm, HashAggregate thắng đậm
GROUP BY tinh_id trên 5 triệu dòng chỉ tạo 64 nhóm (64 tỉnh). So HashAggregate (planner chọn) với GroupAggregate (ép):
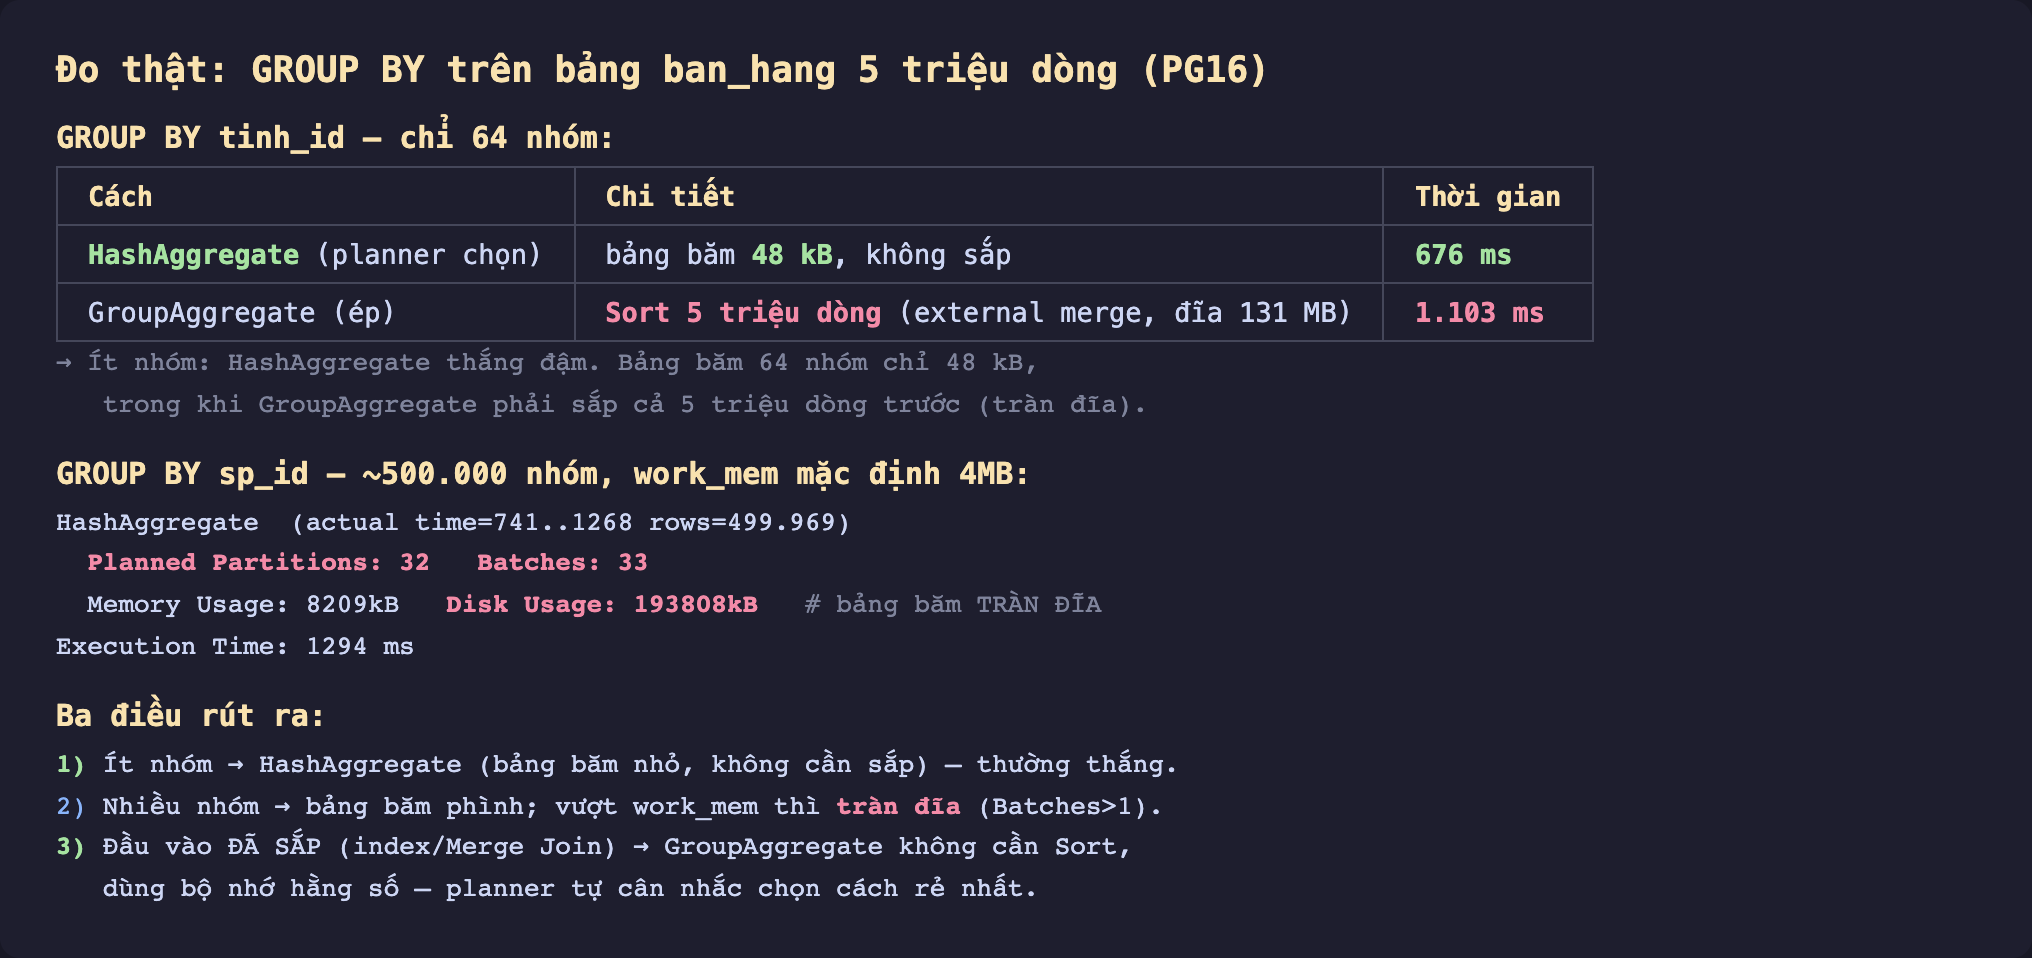
Hình 2: GROUP BY tinh_id (64 nhóm): HashAggregate với bảng băm 48 kB, 676 ms; GroupAggregate ép phải sắp 5 triệu dòng (external merge, đĩa 131 MB), 1.103 ms. GROUP BY sp_id (500k nhóm): bảng băm tràn 193 MB ra đĩa.
Với 64 nhóm, HashAggregate xây một bảng băm chỉ 48 kB — 64 ngăn, mỗi ngăn một sum. Quét 5 triệu dòng một lượt, xong trong 676 ms. Ngược lại, ép GroupAggregate buộc PostgreSQL sắp cả 5 triệu dòng theo tinh_id trước (chỉ để gom 64 nhóm!) — Sort Method: external merge, Disk: 131184kB, mất 1.103 ms. Với ít nhóm, sắp xếp là lãng phí khổng lồ; HashAggregate thắng rõ.
Nhiều nhóm: bảng băm tràn đĩa
Đổi sang GROUP BY sp_id — cột này có ~500.000 giá trị phân biệt, tức 500.000 nhóm. Bảng băm giờ phải chứa nửa triệu bộ tích lũy, vượt xa work_mem mặc định 4 MB. Kế hoạch cho thấy:
HashAggregate (actual time=741..1268 rows=499969)
  Planned Partitions: 32  Batches: 33
  Memory Usage: 8209kB  Disk Usage: 193808kB
Batches: 33 và Disk Usage: 193808kB là dấu hiệu: HashAggregate đã tràn 193 MB ra đĩa. Từ PostgreSQL 13, HashAggregate biết chia bảng băm thành nhiều phần (partition) và ghi bớt ra đĩa khi vượt work_mem — trước đó nó có thể ngốn RAM vô hạn. Đây là lý do một truy vấn GROUP BY trên cột có rất nhiều giá trị phân biệt có thể chậm bất ngờ.
Khi nào GroupAggregate thắng
GroupAggregate không phải kẻ thua cuộc — nó thắng ở hai tình huống:
Đầu vào đã sắp sẵn. Nếu dữ liệu đến từ một Index Scan trên cột nhóm, hay từ một Merge Join phía dưới vốn đã sắp, GroupAggregate không cần bước Sort — nó chỉ việc gom nhóm tuần tự với bộ nhớ hằng số. Khi đó planner thường chọn nó.
Rất nhiều nhóm. Khi số nhóm khổng lồ đến mức bảng băm của HashAggregate sẽ tràn đĩa nặng, GroupAggregate với bộ nhớ hằng số (chỉ giữ một nhóm) có thể rẻ hơn — miễn là chi phí sắp xếp không quá lớn, hoặc dữ liệu đã sắp.
Điểm mấu chốt là để planner quyết định. Nó tính chi phí cả hai — HashAggregate (dựng băm, có thể tràn đĩa) và GroupAggregate (sắp + gom tuần tự) — và chọn cái rẻ hơn dựa trên ước lượng số nhóm.
Đánh đổi cần cân nhắc
Ước lượng số nhóm sai làm hỏng lựa chọn. Planner đoán số nhóm từ thống kê n_distinct của cột. Nếu thống kê cũ hoặc n_distinct bị ước lượng lệch (hay xảy ra với cột phân bố lệch), nó có thể chọn HashAggregate rồi tràn đĩa ngoài dự kiến. ANALYZE giữ n_distinct chính xác — chủ đề bài sau.
work_mem lại quan trọng. Như Sort và Hash Join, HashAggregate tràn đĩa khi vượt work_mem. Nếu một truy vấn tổng hợp quan trọng tràn đĩa, nâng work_mem cho phiên đó có thể đưa Batches về 1. Nhưng nhớ quy tắc: work_mem áp mỗi node × số kết nối, đừng đặt cao toàn cục.
Ba ý mang về
- Ít nhóm → HashAggregate thắng: bảng băm nhỏ (48 kB cho 64 nhóm), không cần sắp — 676 ms so với 1.103 ms khi ép GroupAggregate phải sắp cả 5 triệu dòng.
- Nhiều nhóm → bảng băm tràn đĩa:
GROUP BYtrên cột ~500.000 giá trị phân biệt khiến HashAggregate ghi 193 MB ra đĩa (Batches: 33) — đọcDisk UsagevàBatchestrong EXPLAIN để phát hiện. - GroupAggregate thắng khi đầu vào đã sắp (index/Merge Join) vì không cần Sort và dùng bộ nhớ hằng số — để planner cân nhắc, và giữ thống kê
n_distinctchính xác bằngANALYZEđể nó ước lượng số nhóm đúng.
Phần sau ta đi vào chính cái nền của mọi quyết định planner: Phần sau mổ xẻ thống kê bảng và ANALYZE — PostgreSQL biết gì về dữ liệu, lưu ở đâu, và vì sao thống kê cũ làm hỏng mọi kế hoạch.
