Suốt các bài về scan, join và aggregate, một cụm từ lặp đi lặp lại: "planner ước lượng số dòng". Giờ ta đào tới tận gốc — ước lượng đó đến từ đâu? Câu trả lời là thống kê, dữ liệu mà PostgreSQL thu thập về nội dung mỗi bảng. Khi thống kê đúng, planner chọn kế hoạch tốt; khi thống kê cũ, nó có thể ước lượng sai hàng trăm nghìn lần và chọn kế hoạch thảm họa. Bài này chỉ ra PostgreSQL biết gì, lưu ở đâu, và đo cái bẫy thống kê cũ.
PostgreSQL biết gì về dữ liệu
Với mỗi cột, PostgreSQL lưu một bộ thống kê trong bảng hệ thống pg_statistic, xem thân thiện qua view pg_stats:
SELECT attname, n_distinct, most_common_vals, most_common_freqs
FROM pg_stats WHERE tablename='kh';
n_distinct: số giá trị phân biệt trong cột — dùng để ước lượng độ chọn lọc và số nhóm choGROUP BY.most_common_vals(MCV): các giá trị phổ biến nhất kèm tần suất (most_common_freqs). Ví dụ cộttinhcó MCV{HCM, CT, DN, HN, HP}mỗi giá trị ~0,20.histogram_bounds: phân bố của phần còn lại, dùng ước lượng khoảng (>,<,BETWEEN).correlation: mức tương quan giữa cột và thứ tự vật lý trên đĩa — dùng cho BRIN và mô hình chi phí.
Ở cấp bảng, pg_class giữ reltuples (số dòng ước lượng) và relpages (số trang).
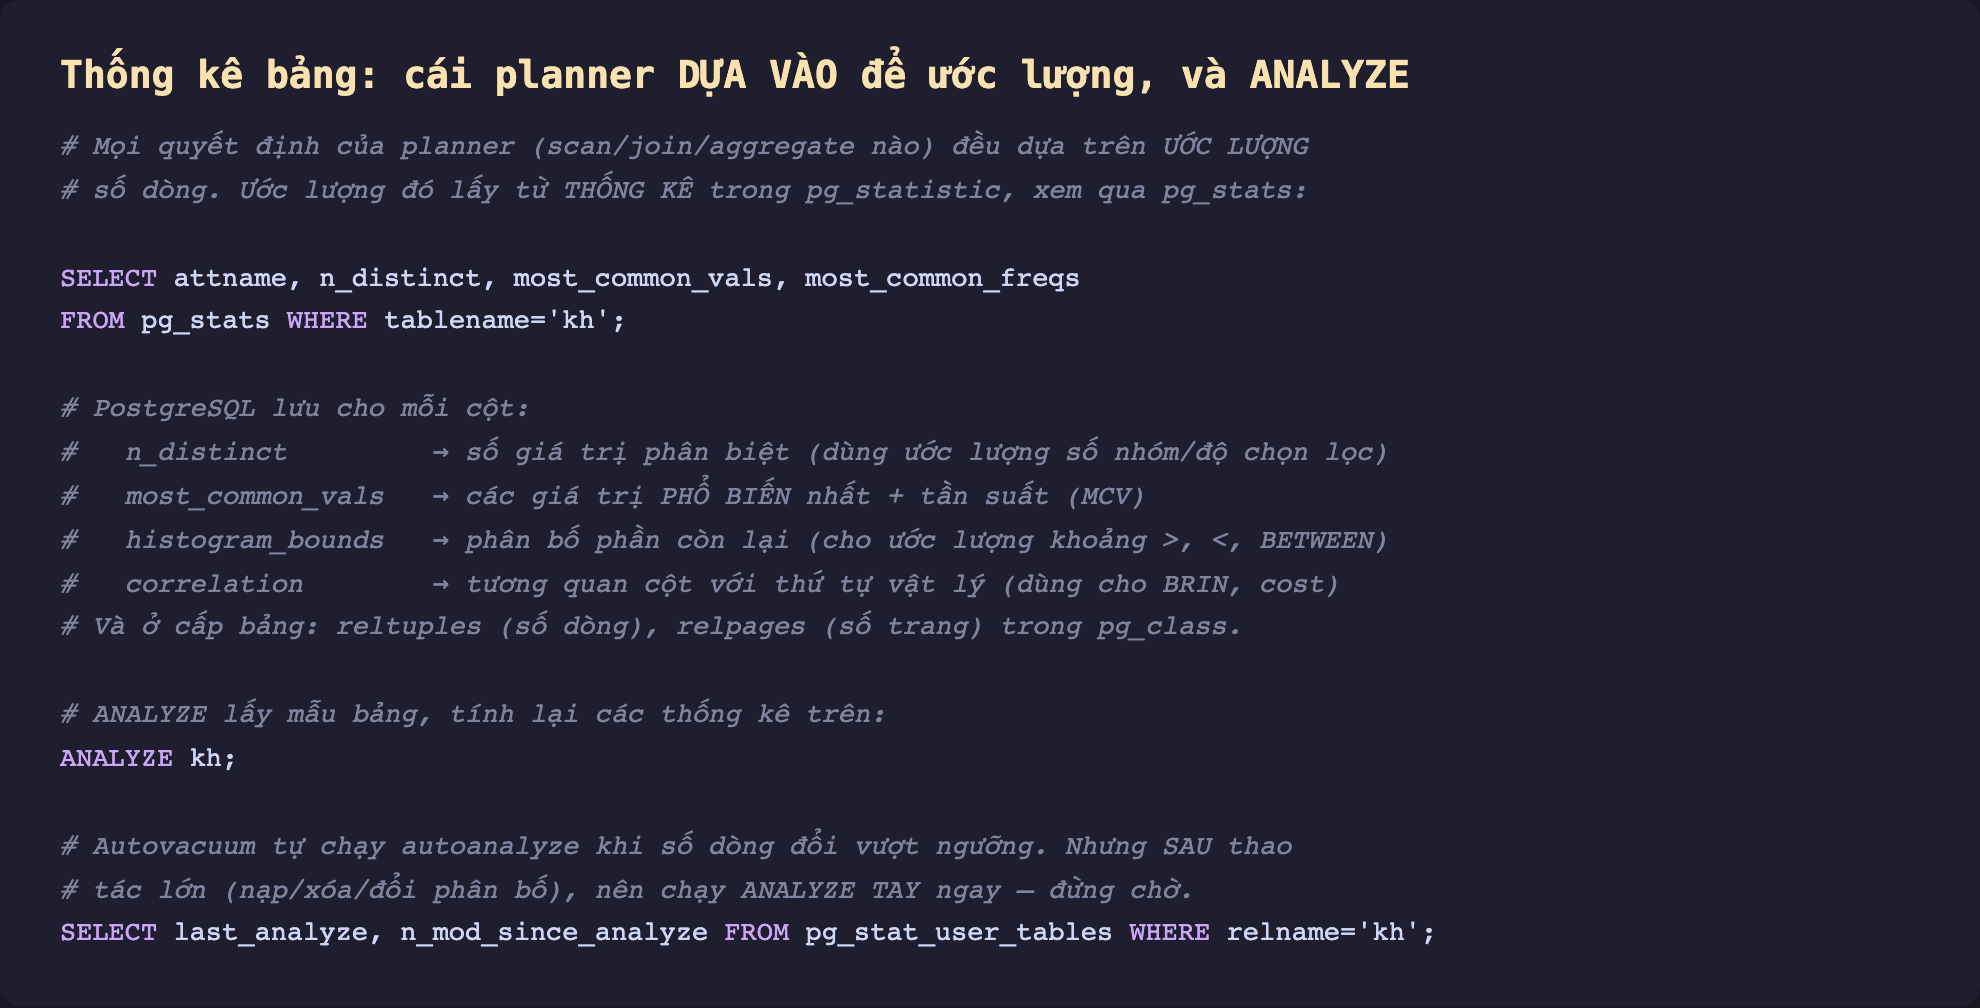
Hình 1: Thống kê PostgreSQL lưu cho mỗi cột (n_distinct, MCV, histogram, correlation) và cấp bảng (reltuples). ANALYZE lấy mẫu và tính lại; autovacuum tự chạy autoanalyze theo ngưỡng.
Đo thật: thống kê cũ, ước lượng sai 900.000 lần
Đây là kịch bản gây sự cố kinh điển. Bắt đầu với bảng kh 100.000 dòng (5 tỉnh), đã ANALYZE. Rồi chèn thêm 900.000 dòng toàn tỉnh mới 'BD' — nhưng chưa chạy ANALYZE. Truy vấn WHERE tinh='BD':
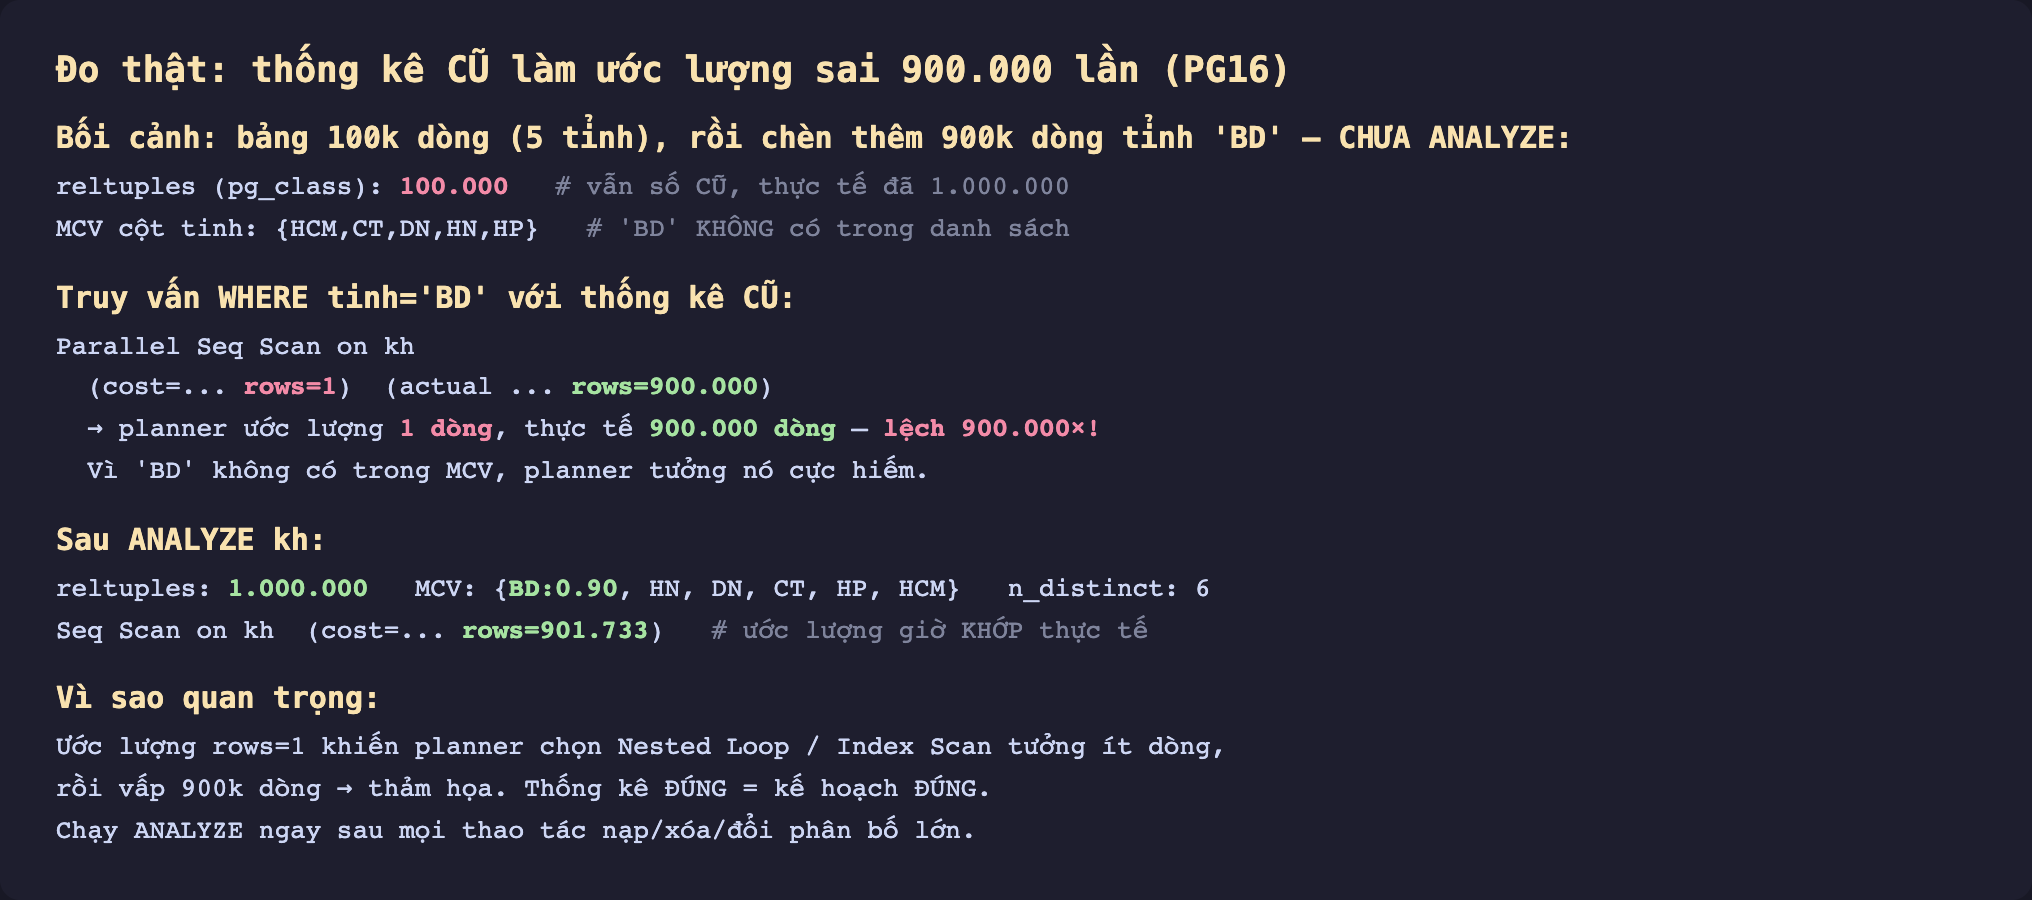
Hình 2: Trước ANALYZE, planner ước lượng rows=1 cho tinh='BD' nhưng thực tế 900.000 dòng — lệch 900.000 lần, vì 'BD' chưa có trong MCV. Sau ANALYZE, ước lượng thành rows=901.733, khớp thực tế.
Kết quả rất rõ:
- Trước ANALYZE:
reltuplesvẫn là 100.000 (số cũ, thực tế đã 1 triệu). MCV không chứa'BD', nên planner cho rằng'BD'là giá trị cực hiếm và ước lượngrows=1. Nhưng thực tế truy vấn khớp 900.000 dòng — lệch 900.000 lần. - Sau
ANALYZE kh:reltuplesthành 1.000.000, MCV cập nhật thành{BD:0.90, HN, DN, CT, HP, HCM},n_distinct=6. Giờ planner ước lượngrows=901.733— khớp thực tế.
Vì sao lệch ước lượng là thảm họa
Ước lượng rows=1 không chỉ là con số sai vô hại — nó dẫn đến kế hoạch sai. Nhớ bài về planner chọn join: nếu planner tin rằng tinh='BD' chỉ trả 1 dòng, nó có thể chọn Nested Loop tưởng bảng ngoài tí hon, rồi thực tế phải lặp 900.000 lần — đúng thảm họa Nested Loop. Hoặc chọn Index Scan cho một truy vấn thực ra lấy 90% bảng, gây 900.000 lần đọc heap ngẫu nhiên.
Nói cách khác: mọi kỹ thuật tối ưu ở các bài trước đều giả định thống kê đúng. Thống kê cũ làm sụp đổ toàn bộ quá trình ra quyết định của planner.
ANALYZE và autovacuum
ANALYZE lấy một mẫu dữ liệu (mặc định 30.000 dòng, điều chỉnh bằng default_statistics_target — bài sau) và tính lại toàn bộ thống kê trên. Nó nhanh và nhẹ so với việc quét cả bảng.
Autovacuum tự chạy autoanalyze. PostgreSQL theo dõi số dòng thay đổi từ lần analyze cuối (n_mod_since_analyze); khi vượt ngưỡng (mặc định ~10% bảng + 50 dòng), autovacuum tự chạy ANALYZE. Với hoạt động bình thường, thống kê được giữ tươi tự động.
Nhưng sau thao tác lớn, đừng chờ autovacuum. Nạp hàng loạt, xóa lớn, TRUNCATE rồi nạp lại, hay đổi phân bố dữ liệu đột ngột — chạy ANALYZE ten_bang; bằng tay ngay. Autovacuum có thể mất vài phút mới kích hoạt, và trong khoảng đó mọi truy vấn chạy trên thống kê sai. Kiểm bằng:
SELECT last_analyze, last_autoanalyze, n_mod_since_analyze
FROM pg_stat_user_tables WHERE relname='kh';
Đánh đổi và lưu ý
Thống kê là ước lượng từ mẫu, không tuyệt đối chính xác. n_distinct đặc biệt khó ước lượng đúng từ mẫu với cột có phân bố lệch. Nếu bạn biết chắc số giá trị phân biệt, có thể ghi đè: ALTER TABLE ... ALTER COLUMN ... SET (n_distinct = ...).
ANALYZE sau khi phục hồi backup. pg_restore không tự chạy ANALYZE — sau khi restore, thống kê trống rỗng và mọi truy vấn chạy kế hoạch tệ cho tới lần autoanalyze đầu. Chạy ANALYZE toàn database ngay sau restore.
Bảng tạm cần ANALYZE tay. Bảng tạm (CREATE TEMP TABLE) không được autovacuum đụng tới; nếu bạn nạp nhiều dữ liệu vào một bảng tạm rồi join/aggregate, hãy ANALYZE nó trước.
Ba ý mang về
- Planner quyết định dựa trên thống kê trong
pg_stats—n_distinct, MCV, histogram, correlation cho từng cột, cùngreltuples/relpagescấp bảng; đây là toàn bộ những gì PostgreSQL "biết" để ước lượng số dòng. - Thống kê cũ làm ước lượng sai thảm khốc: đo thật, sau khi chèn 900.000 dòng mà chưa ANALYZE, planner ước lượng
rows=1cho một truy vấn khớp 900.000 dòng (lệch 900.000 lần) — và ước lượng sai dẫn tới kế hoạch sai. - Chạy
ANALYZEngay sau mọi thao tác lớn (nạp/xóa hàng loạt, restore backup, bảng tạm) thay vì chờ autovacuum; kiểmlast_analyzevàn_mod_since_analyzeđể biết thống kê có tươi không.
Phần sau ta chỉnh chính độ chi tiết của thống kê: Phần sau mổ xẻ default_statistics_target — số mẫu và số MCV/histogram PostgreSQL giữ, khi nào tăng nó để ước lượng chính xác hơn.
