Bài trước ta thấy thống kê gồm danh sách giá trị phổ biến (MCV) và histogram. Nhưng PostgreSQL giữ bao nhiêu mục trong các danh sách đó? Câu trả lời nằm ở một tham số: default_statistics_target. Nó nghe kỹ thuật, nhưng với cột phân bố lệch, nó là ranh giới giữa ước lượng đúng và ước lượng sai vài lần. Bài này đo tác động thật của nó trên cột có 500 giá trị.
Tham số này điều khiển gì
default_statistics_target (mặc định 100) quyết định ba thứ cùng lúc:
- Số mục MCV giữ tối đa — tối đa 100 giá trị phổ biến nhất kèm tần suất.
- Số bucket histogram — độ mịn của phân bố phần còn lại.
- Cỡ mẫu ANALYZE — lấy mẫu
300 × targetdòng (mặc định 30.000).
SHOW default_statistics_target; -- 100
Vấn đề nảy sinh với cột phân bố lệch, nhiều giá trị phân biệt. Một giá trị có tần suất trung bình — không đủ phổ biến để lọt top 100 MCV, nhưng cũng không hiếm — sẽ bị ước lượng từ histogram thay vì từ tần suất chính xác trong MCV. Kết quả: ước lượng lệch.
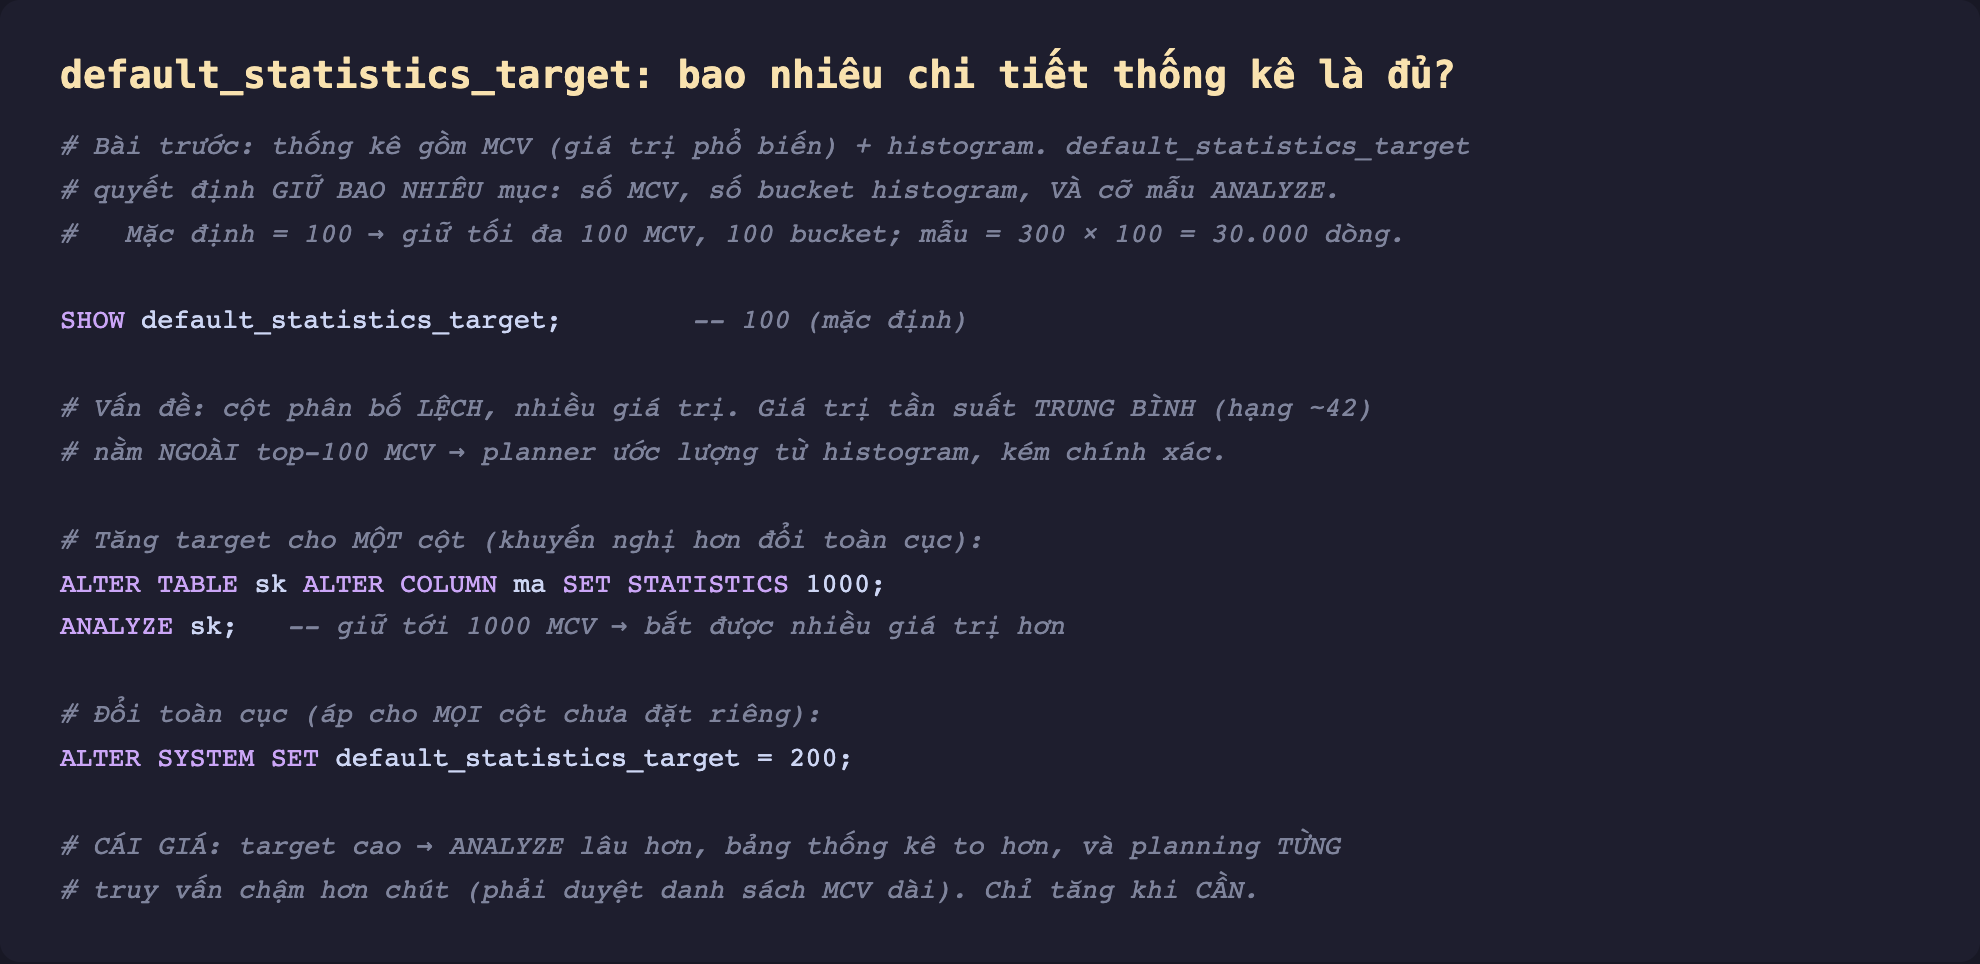
Hình 1: default_statistics_target điều khiển số MCV, số bucket histogram, và cỡ mẫu ANALYZE. Tăng cho một cột bằng ALTER TABLE ... SET STATISTICS; đổi toàn cục bằng ALTER SYSTEM.
Đo thật: từ sai 2,3 lần xuống gần chính xác
Bảng sk có cột ma phân bố lệch mạnh, 500 giá trị phân biệt. Xét giá trị ma=44 — nó là giá trị phổ biến hạng 42, xuất hiện thực tế 6.905 dòng. Đo ước lượng ở ba mức target:
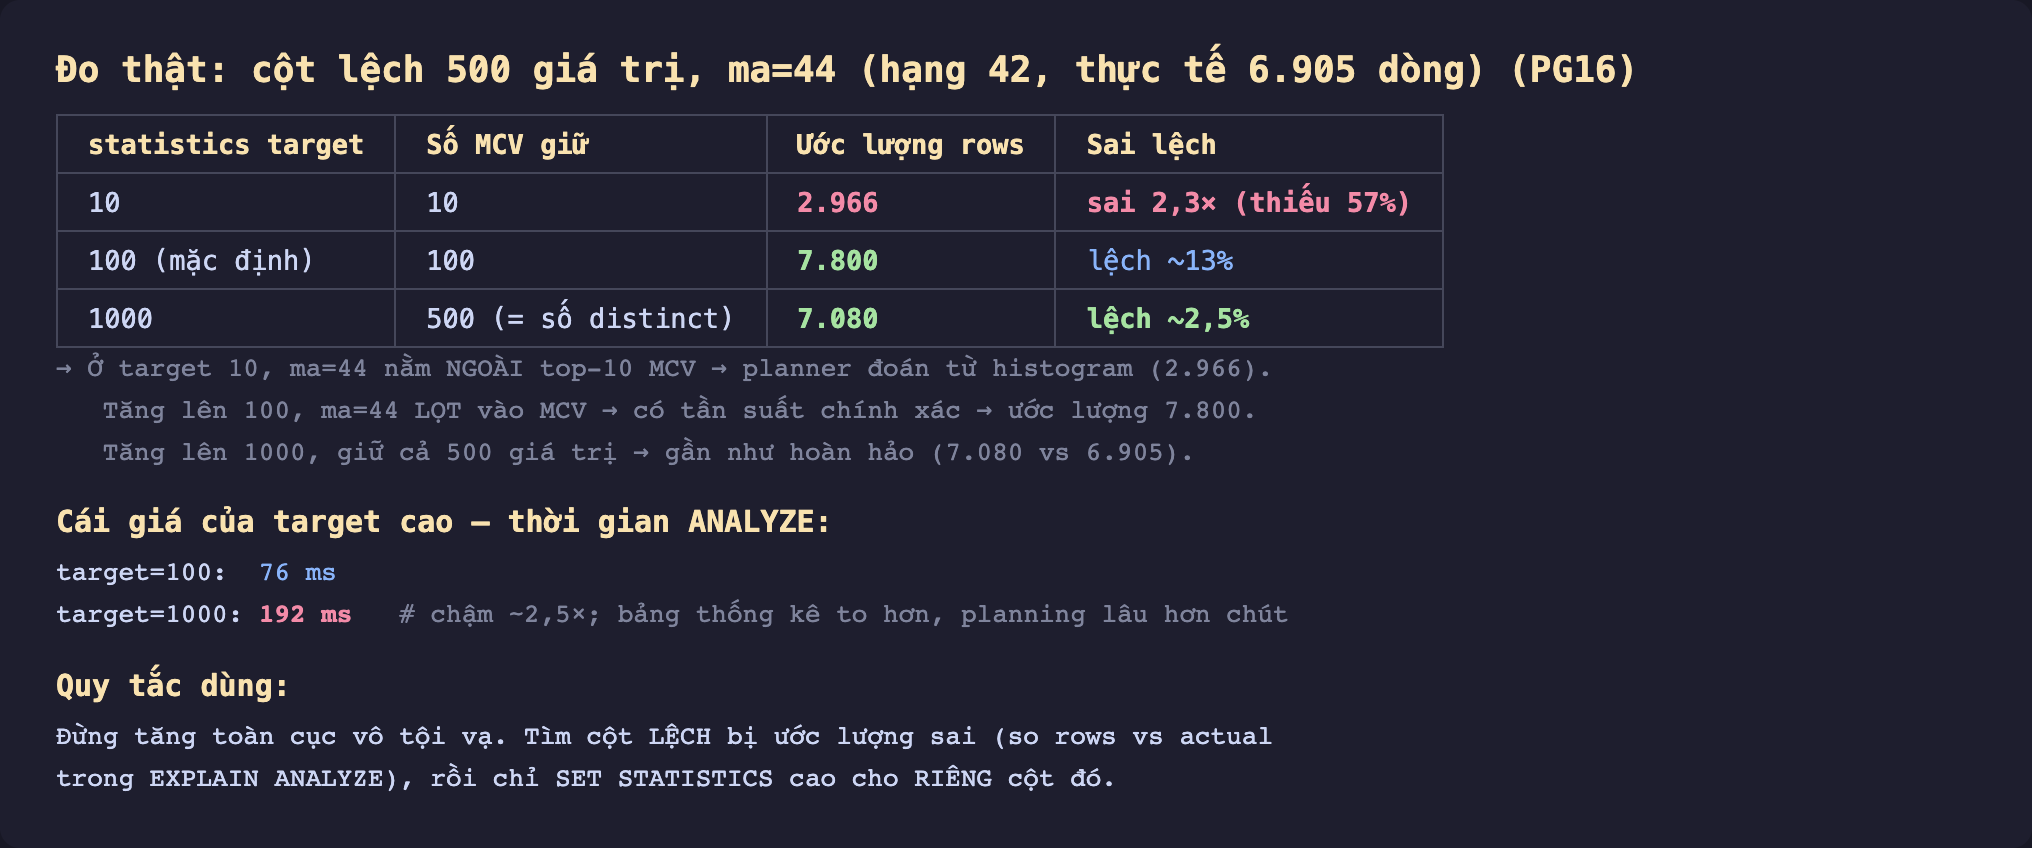
Hình 2: Ước lượng cho ma=44 (thực tế 6.905). target 10 → 2.966 (sai 2,3 lần, vì ma=44 ngoài top-10 MCV). target 100 → 7.800 (lọt MCV, khớp hơn). target 1000 → 7.080 (gần hoàn hảo). ANALYZE chậm hơn: 76 ms lên 192 ms.
Đọc kết quả:
- target 10 (giữ 10 MCV):
ma=44(hạng 42) nằm ngoài top-10 MCV, nên planner phải đoán từ histogram — ước lượng 2.966, sai 2,3 lần so với 6.905. - target 100 (mặc định, giữ 100 MCV):
ma=44giờ lọt vào danh sách MCV, có tần suất chính xác — ước lượng 7.800, lệch chỉ ~13%. - target 1000 (giữ 500 MCV, bằng số giá trị phân biệt): mọi giá trị đều trong MCV — ước lượng 7.080, lệch chỉ ~2,5%.
Sự khác biệt rõ ràng: giá trị nào lọt vào MCV thì có tần suất đo được chính xác; giá trị nào rơi ra ngoài chỉ được suy từ histogram, kém chính xác hơn nhiều với phân bố lệch.
Cái giá của target cao
Tăng target không miễn phí:
ANALYZE chậm hơn. Đo thật: ANALYZE cột với target 100 mất 76 ms, với target 1000 mất 192 ms — chậm ~2,5 lần, vì phải lấy mẫu và xử lý nhiều dữ liệu hơn. Trên bảng lớn với nhiều cột target cao, autoanalyze có thể trở nên đáng kể.
Bảng thống kê to hơn. Nhiều MCV và bucket nghĩa là pg_statistic chiếm nhiều chỗ hơn.
Planning từng truy vấn chậm hơn chút. Mỗi lần lập kế hoạch, planner duyệt danh sách MCV để ước lượng độ chọn lọc. Danh sách dài hơn → planning tốn thêm chút thời gian trên mọi truy vấn dùng cột đó. Với truy vấn chạy hàng nghìn lần mỗi giây, chi phí này cộng dồn.
Đánh đổi: chỉnh đúng cột, đừng chỉnh toàn cục
Đừng tăng default_statistics_target toàn cục vô tội vạ. Đặt nó lên 1000 toàn hệ thống làm mọi ANALYZE chậm và mọi planning nặng hơn, kể cả những cột không cần. Đây là cách tối ưu sai chỗ.
Cách đúng: khoanh vùng cột có vấn đề. Tìm cột bị ước lượng sai bằng cách so rows (ước lượng) với actual rows trong EXPLAIN ANALYZE — như bài trước đã chỉ. Khi tìm ra một cột lệch bị đoán sai, chỉ tăng riêng nó:
ALTER TABLE sk ALTER COLUMN ma SET STATISTICS 1000;
ANALYZE sk;
Cách này cho độ chính xác cần thiết đúng chỗ cần, mà không đánh thuế lên phần còn lại của hệ thống.
Cột đều đặn không cần target cao. Cột phân bố đều (mọi giá trị tần suất gần nhau) hoặc ít giá trị phân biệt (như tinh 5 tỉnh) đã được MCV mặc định phủ tốt — tăng target không giúp gì.
Ba ý mang về
default_statistics_target(mặc định 100) quyết định số MCV, số bucket histogram, và cỡ mẫu ANALYZE — nó là độ chi tiết của bức tranh mà planner có về dữ liệu.- Với cột phân bố lệch, target quyết định độ chính xác ước lượng: đo thật, giá trị hạng 42 bị ước lượng sai 2,3 lần ở target 10 (ngoài MCV), nhưng chỉ lệch ~13% ở target 100 và ~2,5% ở target 1000 (lọt MCV).
- Chỉnh đúng cột, không toàn cục: tìm cột lệch bị đoán sai (so
rowsvsactual), rồiALTER TABLE ... SET STATISTICSriêng cho nó — target cao làm ANALYZE chậm (76 ms lên 192 ms) và planning nặng thêm cho mọi truy vấn.
Phần sau ta giải quyết một loại ước lượng sai mà tăng target không cứu được: Phần sau mổ xẻ extended statistics (CREATE STATISTICS) — cách khai báo tương quan giữa nhiều cột để planner thôi nhân xác suất sai.
